Tất cả bài viết
Trang 5 / 18

UniTacVLA tích hợp tactile chain-of-thought và coarse-to-fine prediction vào VLA để xử lý thao tác tiếp xúc phức tạp — ECCV 2026 với code open-source.

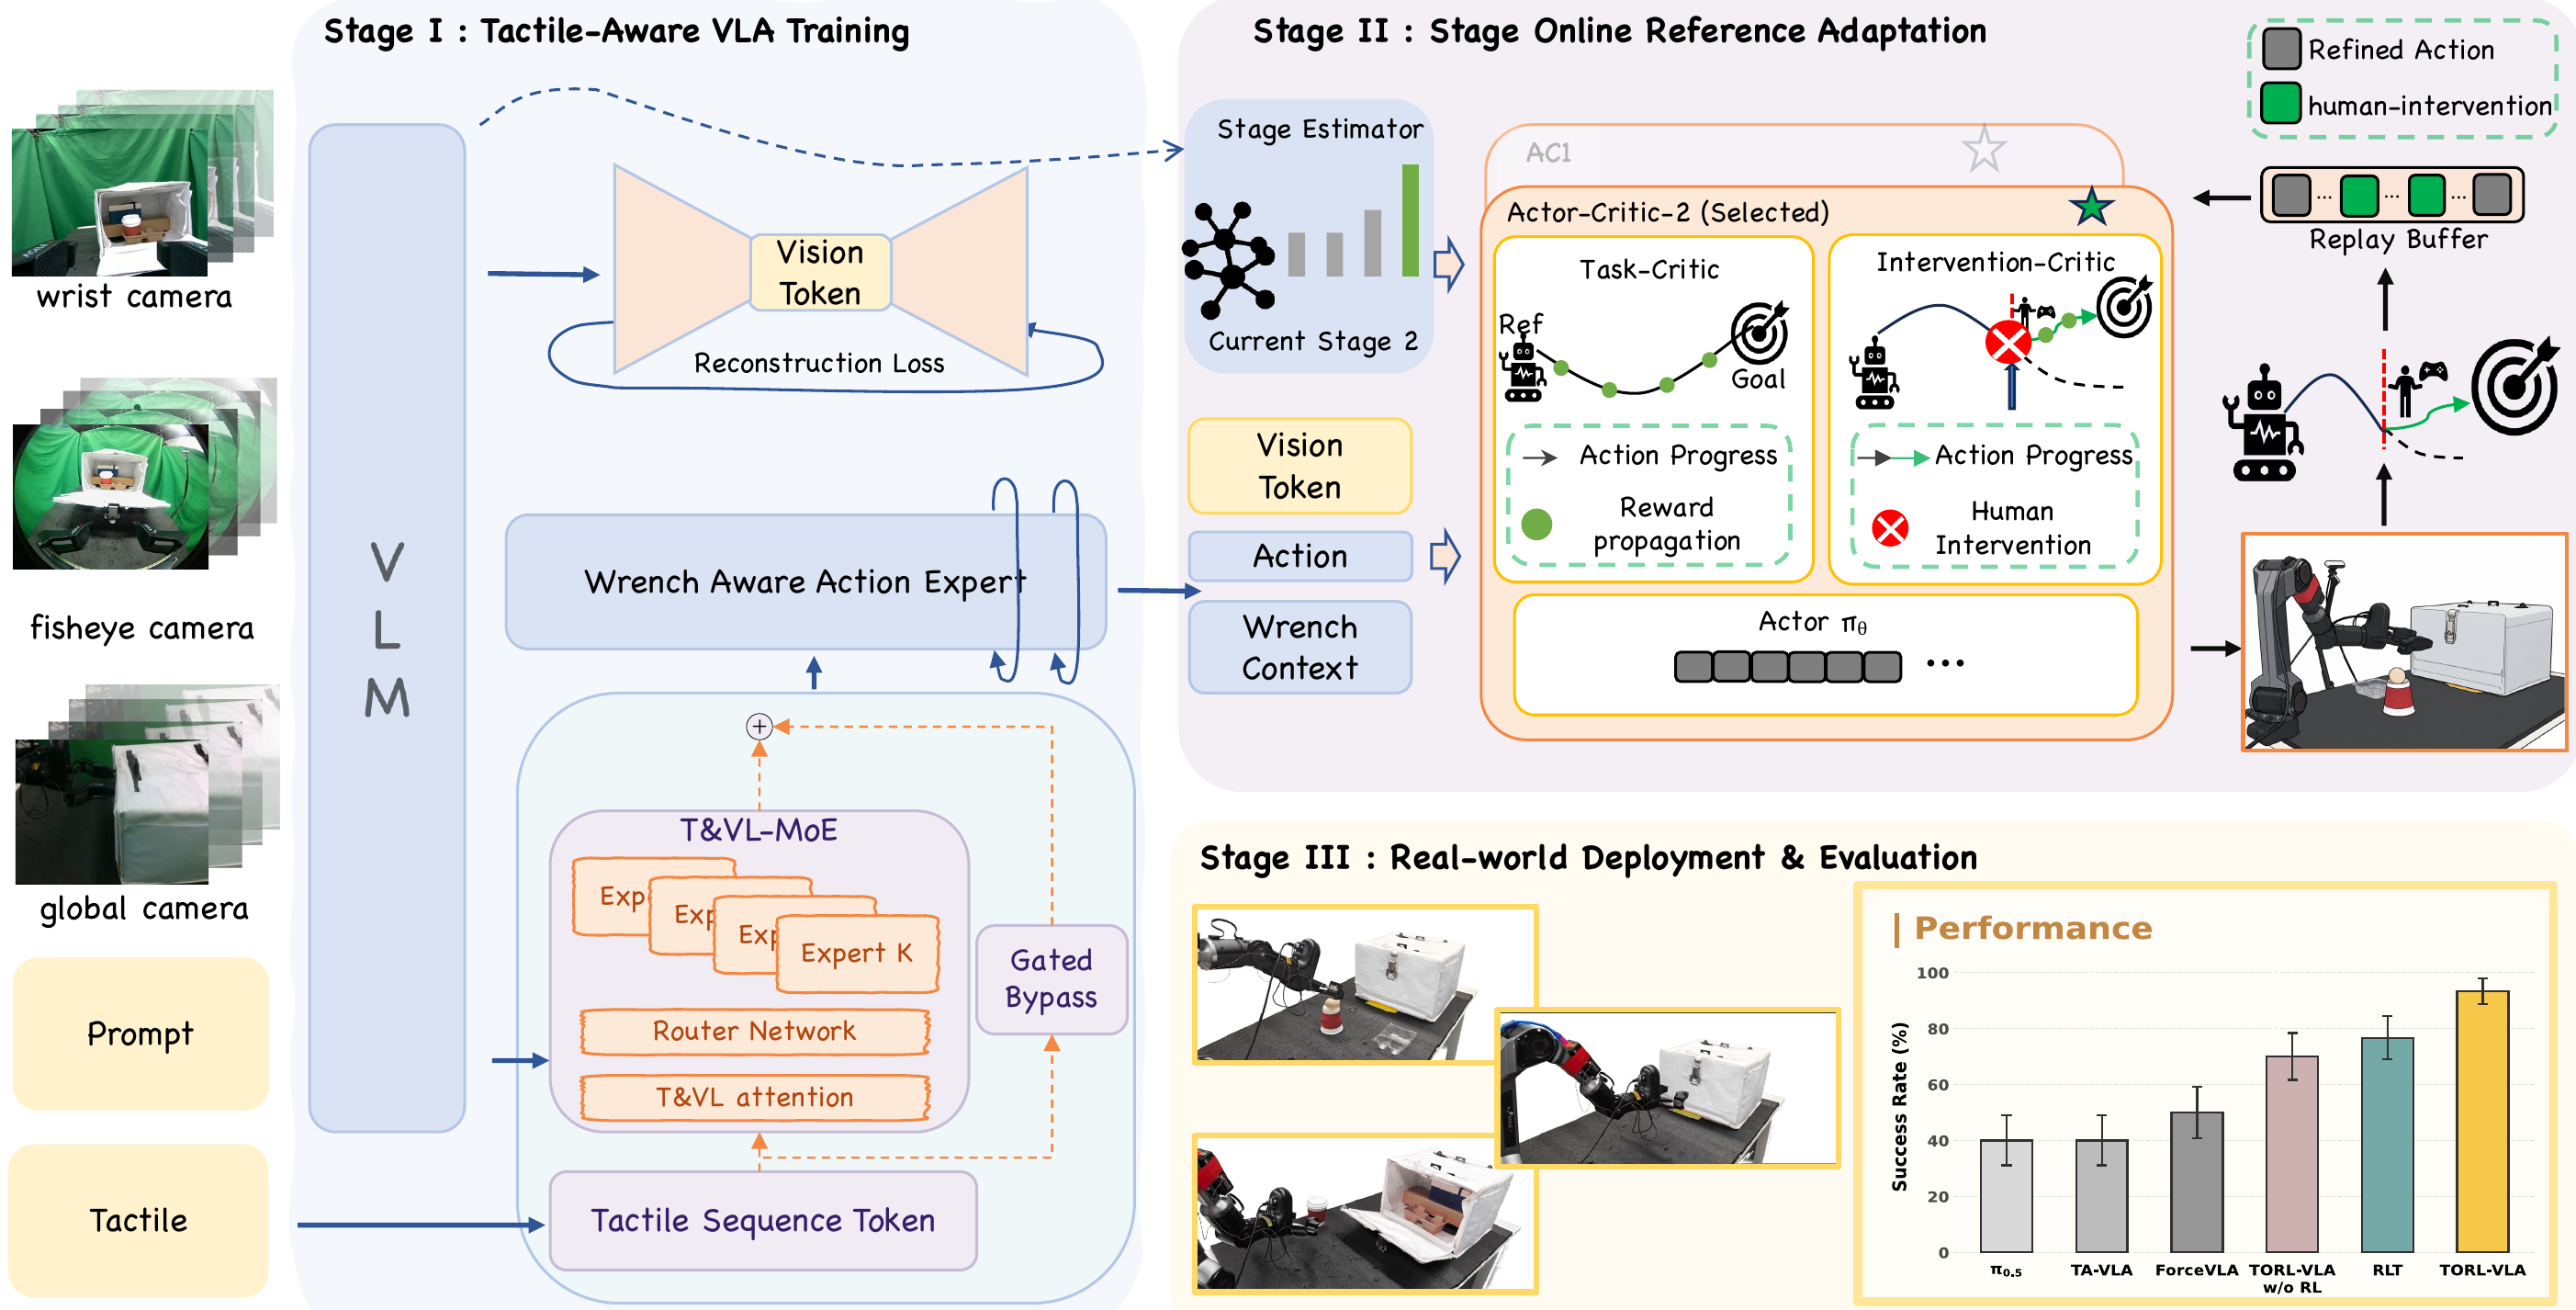
Hướng dẫn TORL-VLA — framework kết hợp cảm biến xúc giác (tactile) và Online RL để fine-tune VLA cho thao tác tiếp xúc chính xác cao: latch, trứng, cốc cà phê.

FORCE giải quyết 2 điểm yếu của RL fine-tune VLA: Q-function bất ổn, exploration kém — qua Value-Calibrated Warm-Up và Self-Distillation, đạt 79% cải thiện.

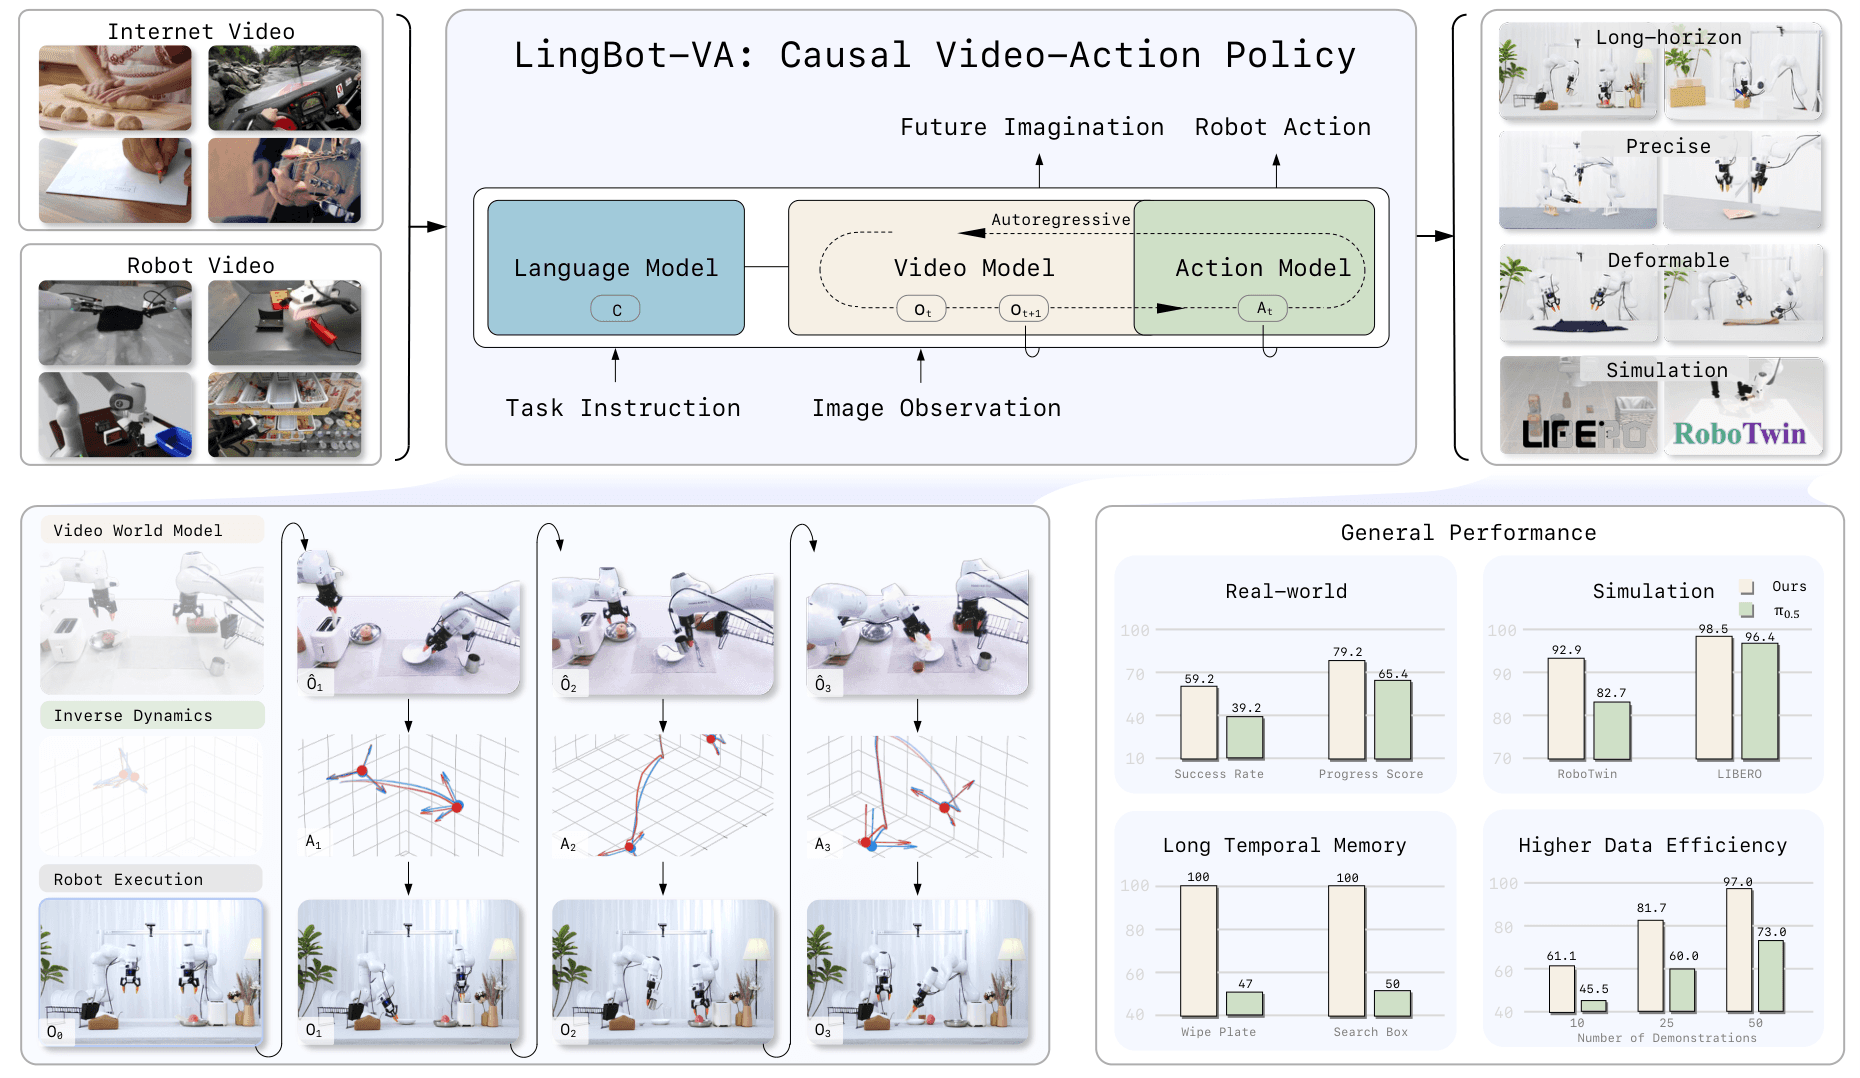
Kiến trúc MoT kết hợp video prediction và policy trong latent space chung — LingBot-VA đạt 98.5% LIBERO và vượt π0.5 trên 6 tác vụ thực tế.

TGRPO kết hợp LLM dense reward với dual-level advantage (step + trajectory) fine-tune OpenVLA-7B trên LIBERO, đạt 91% success rate — vượt SFT 4.6%, PPO 4.4%.
InternVLA-A1 hợp nhất hiểu ngữ nghĩa, dự đoán tương lai, ra lệnh hành động trong kiến trúc Mixture-of-Transformers — đánh bại π0.5 trên benchmark tĩnh lẫn động.
Khám phá Qwen-VLA — VLA generalist Alibaba dùng Qwen3.5-4B + DiT decoder, một bộ weight cho manipulation, navigation và đa robot dị cấu hình.

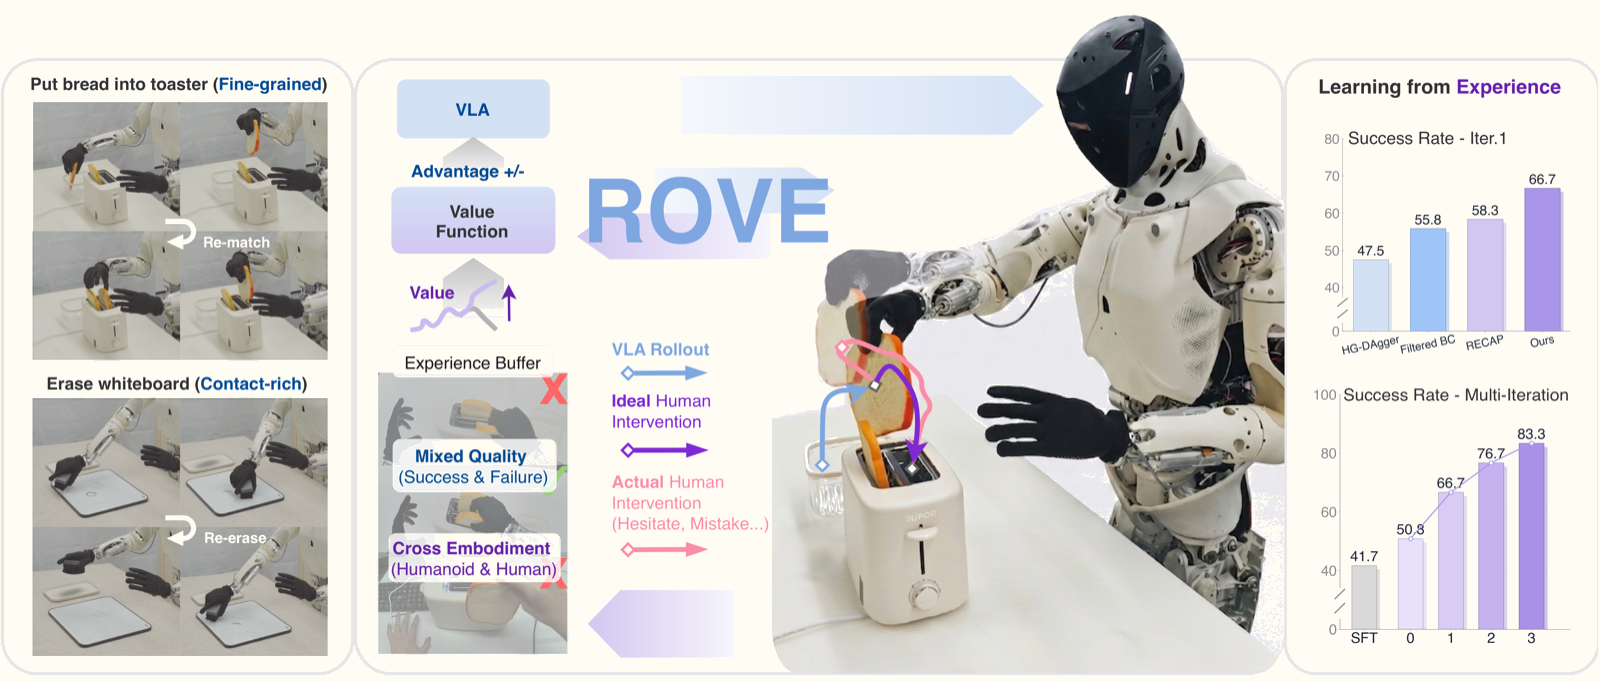
XPENG Robotics giới thiệu ROVE — framework RL post-training VLA tận dụng can thiệp không hoàn hảo của người dùng để cải thiện policy thao tác khéo léo humanoid.

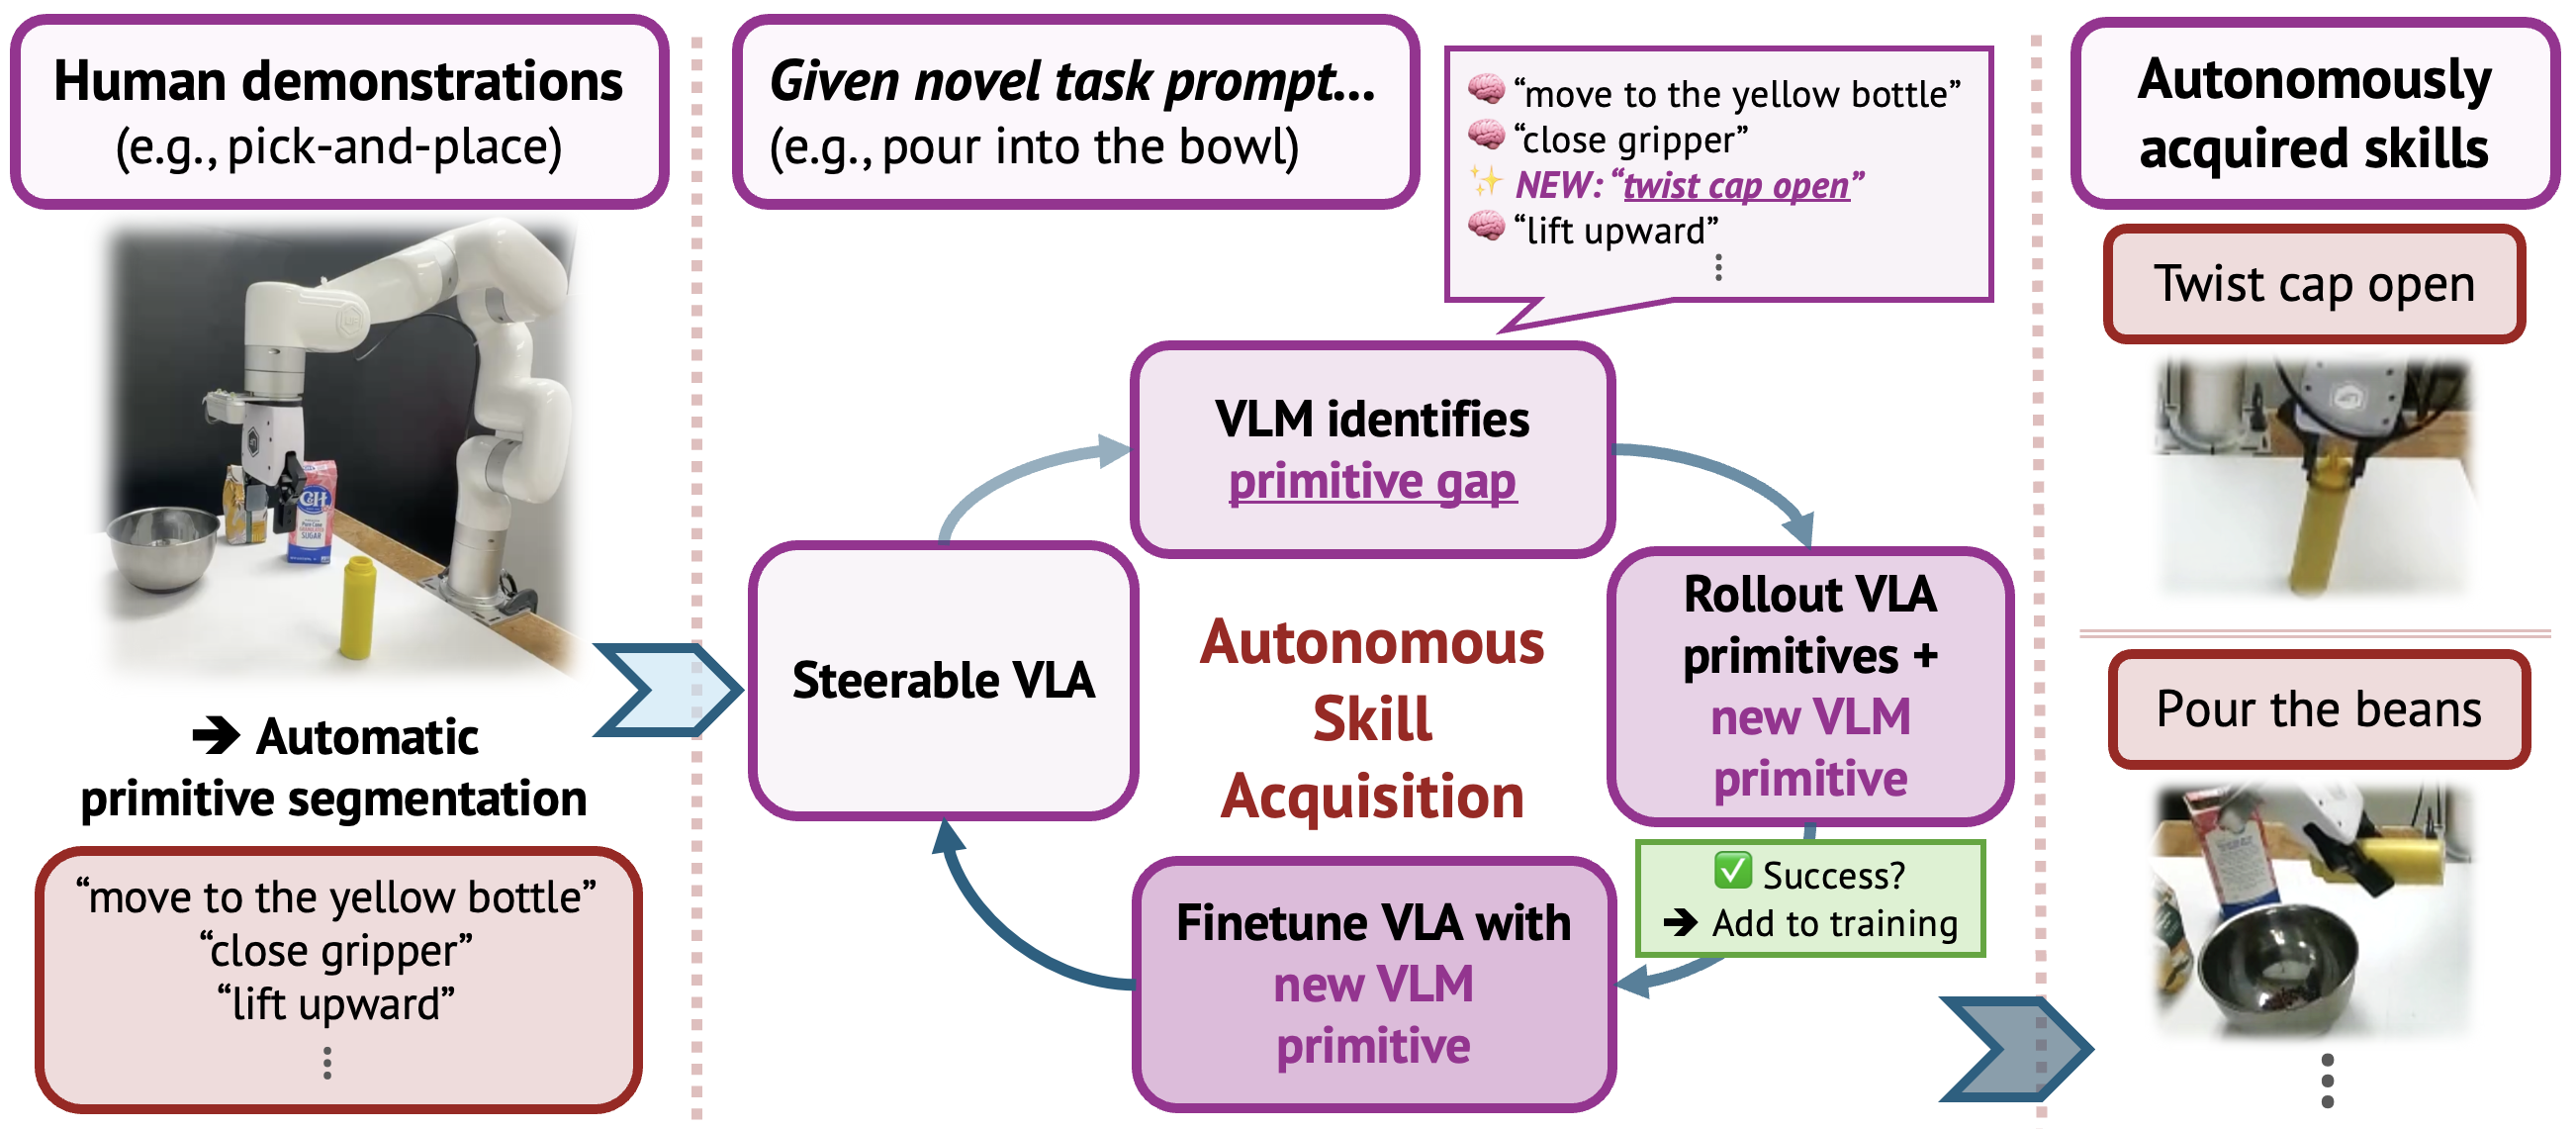
Stanford giới thiệu InSight — framework giúp VLA tự phân tích primitive, nhận diện kỹ năng thiếu, tự học qua vòng lặp VLM-guided flywheel, không cần demo người.

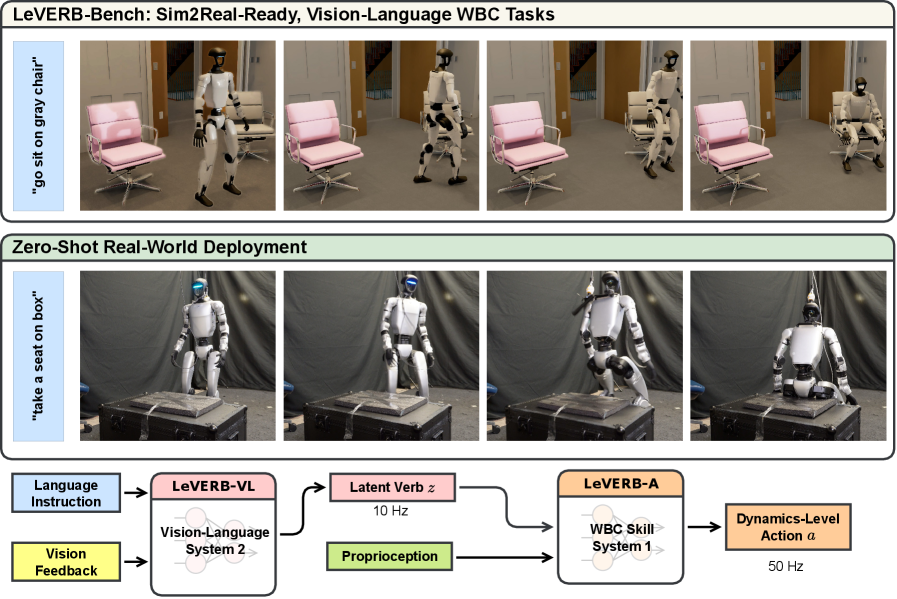
LeVERB (UC Berkeley) — framework và benchmark đầu tiên nối VLA với Whole-Body Control qua latent action space, đạt 58.5% success rate, zero-shot sim-to-real.

LeVERB (UC Berkeley) — framework phân cấp đầu tiên điều khiển toàn thân humanoid bằng latent VLA, zero-shot sim-to-real trên Unitree G1, đạt 58.5% thành công.

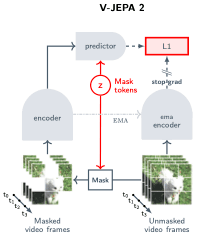
VLA-JEPA kết hợp Qwen3-VL với V-JEPA2 latent world model, chạy 10Hz trên RTX 3080, fine-tune chỉ cần 13 demo. Hướng dẫn cài đặt và training trên LeRobot.