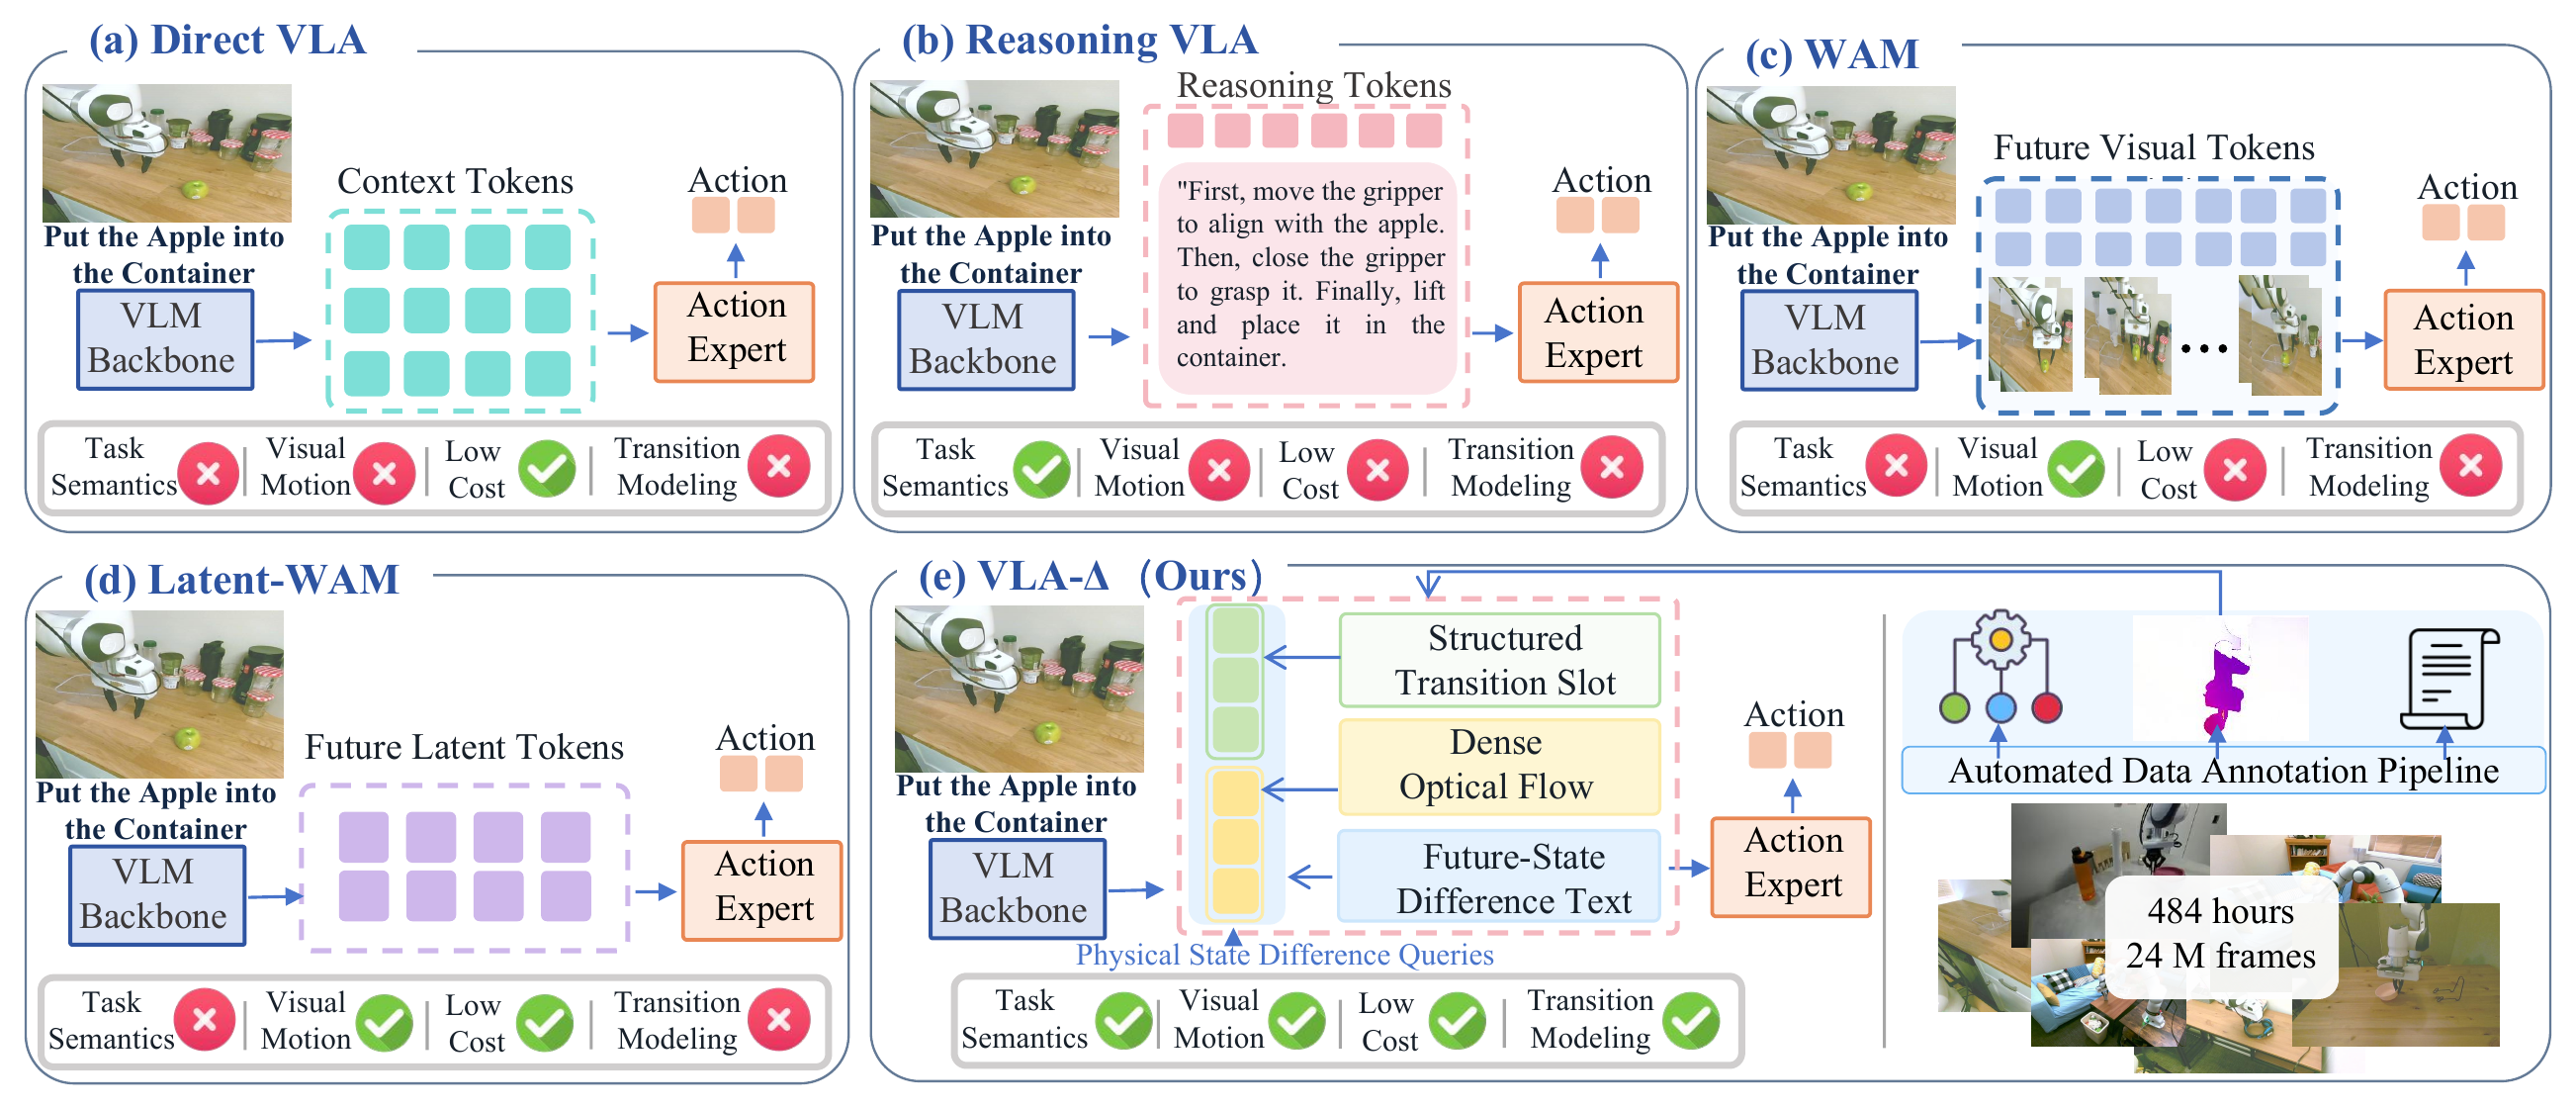
Khi robot đưa gripper tới chiếc cốc, hành động đúng không chỉ phụ thuộc vào vị trí hiện tại. Chiếc cốc cần được giữ chắc, rời khỏi mặt bàn, di chuyển tới đích rồi chuyển sang trạng thái được mặt bàn đỡ. Nếu policy chỉ học liên hệ giữa ảnh và action, những thay đổi trung gian này có thể bị học một cách gián tiếp và thiếu ổn định.
VLA-Δ đặt chính sự thay đổi đó vào mục tiêu học. Tên đầy đủ của công trình là VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models, Qi Lu và cộng sự, arXiv, 2026. Bài hướng dẫn dựa trên repo ZJU-OmniAI/VLA-Delta và project page chính thức, kiểm tra ngày 19/10/2026.
Code và checkpoint base/LIBERO đã công khai. Các lệnh dưới đây là hướng dẫn cho máy thực hành Linux có CUDA, chưa phải log tái lập benchmark của vnrobo. Lộ trình phù hợp cho beginner là chạy checkpoint đã fine-tune, kiểm tra một task, sau đó mới đánh giá đầy đủ và tự training.
1. Hiểu physical state transition bằng một ví dụ
Một state có thể gồm vị trí vật thể, vị trí gripper, trạng thái đóng/mở và quan hệ tiếp xúc. Transition mô tả những gì thay đổi giữa hiện tại và một thời điểm tương lai. Ví dụ minh họa: từ “cốc nằm trên bàn, gripper đang mở” sang “cốc được gripper giữ và nâng lên”. Đây là ví dụ để hiểu khái niệm, không phải annotation trích nguyên văn từ dataset.
VLA nhận ảnh và instruction, rồi xuất action điều khiển robot. Bạn có thể ôn nền tảng qua phân tích OpenVLA. Với VLA-Δ, những mục tiêu phụ trong pretraining buộc representation mang thông tin liên quan đến biến đổi vật lý. Khi triển khai, policy vẫn nhận quan sát hiện tại và tạo action trực tiếp.
Điểm cần nhớ là không cần ảnh tương lai lúc inference. Ảnh tương lai được dùng để xây dựng supervision khi training. Một hệ thống cần biết trước diễn biến tương lai mới điều khiển được robot sẽ không phù hợp với vòng lặp tương tác thực tế.
2. Kiến trúc: từ ảnh tới action chunk
Theo phần Method của paper, mô hình dùng Qwen3-VL-2B-Instruct và action expert dạng Diffusion Transformer chín lớp, theo thiết kế backbone/action expert của GR00T N1. VLM được khởi tạo từ ZR-0 base. Đây là nguồn khởi tạo trong nghiên cứu; người thực hành LIBERO có thể bắt đầu thẳng từ checkpoint VLA-Δ đã phát hành.
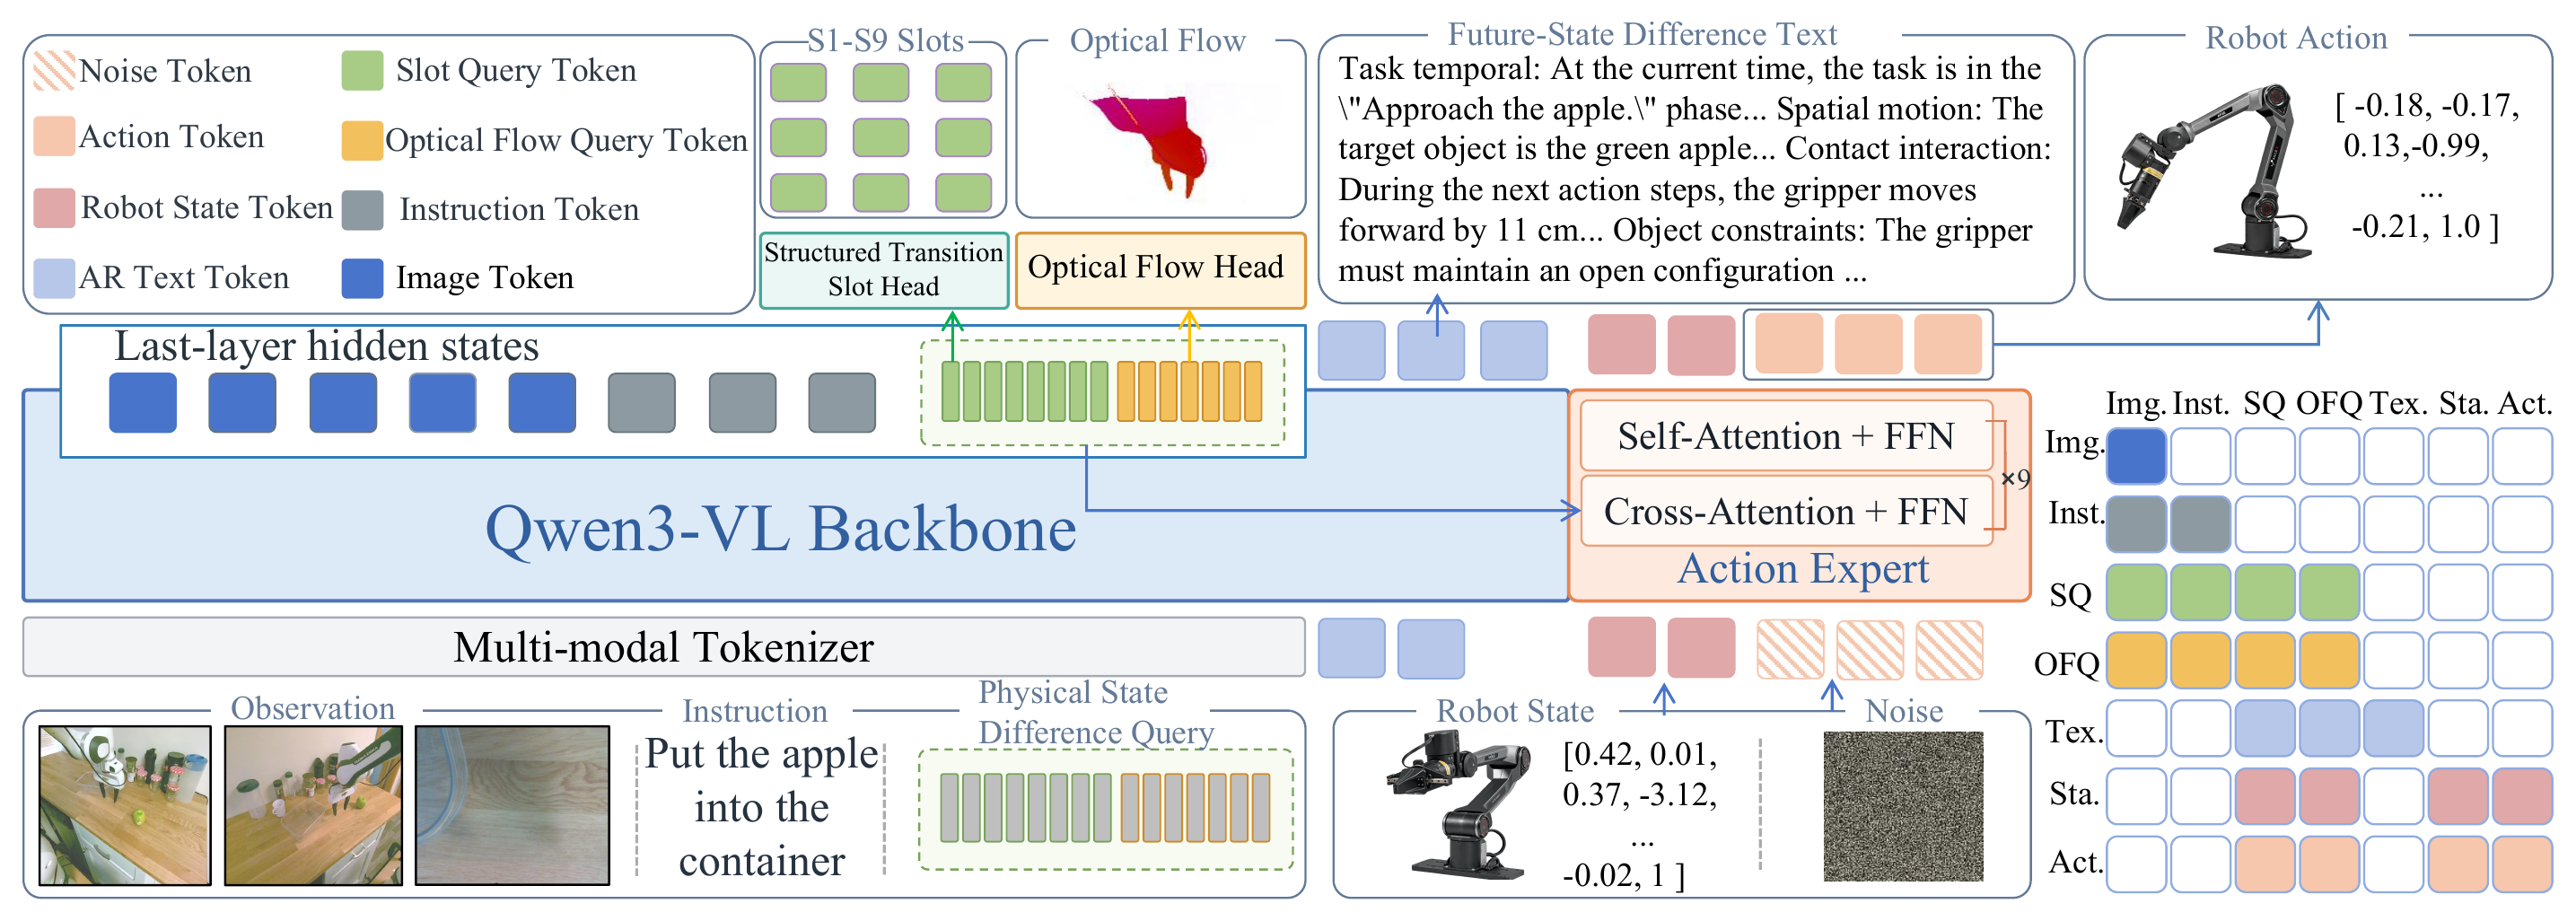
Nguồn: project page VLA-Δ. Nhánh supervision hỗ trợ học representation; đường tạo action được giữ khi triển khai.
Physical State Difference Queries là các vector học được, đóng vai trò gom thông tin từ ngữ cảnh vision-language. Hidden states tại vị trí query tạo thành transition representation. Action expert đọc representation qua cross-attention, kết hợp proprioceptive state rồi sinh một action chunk, tức chuỗi action cho nhiều bước thời gian.
Config fine-tune công khai đặt num_difference_queries: 32, trong đó num_flow_queries: 16. Những query này không tương đương 32 lệnh bằng ngôn ngữ tự nhiên. Chúng là các vector nội bộ được tối ưu cùng model. Robot state cũng không phải instruction: đó là số đo trạng thái cơ thể hoặc cơ cấu chấp hành theo schema dataset.
Action expert dùng flow matching: học trường vector biến noise thành action liên tục. Tên “Diffusion Transformer” mô tả cấu trúc mạng; mục tiêu training ở đây là flow matching. Số bước giải mã, số action dự đoán và số action thực thi trước khi quan sát lại là ba tham số khác nhau.
Ba nguồn supervision bổ sung
Paper tổ chức supervision thành structured slots, optical flow và future-state difference text. Slots diễn tả chín nhóm mục tiêu như tiến trình, giai đoạn, vị trí, chuyển động, gripper, tiếp xúc và nguy cơ vật cản. Optical flow cung cấp chuyển động ở mức pixel. Difference text kết nối biến đổi cục bộ với mục tiêu và ràng buộc của tác vụ. Phần annotation của paper mô tả corpus khoảng 484 giờ, 24 triệu frame từ DROID, MolmoAct và RH20T. Nguồn: Method và Experiments.
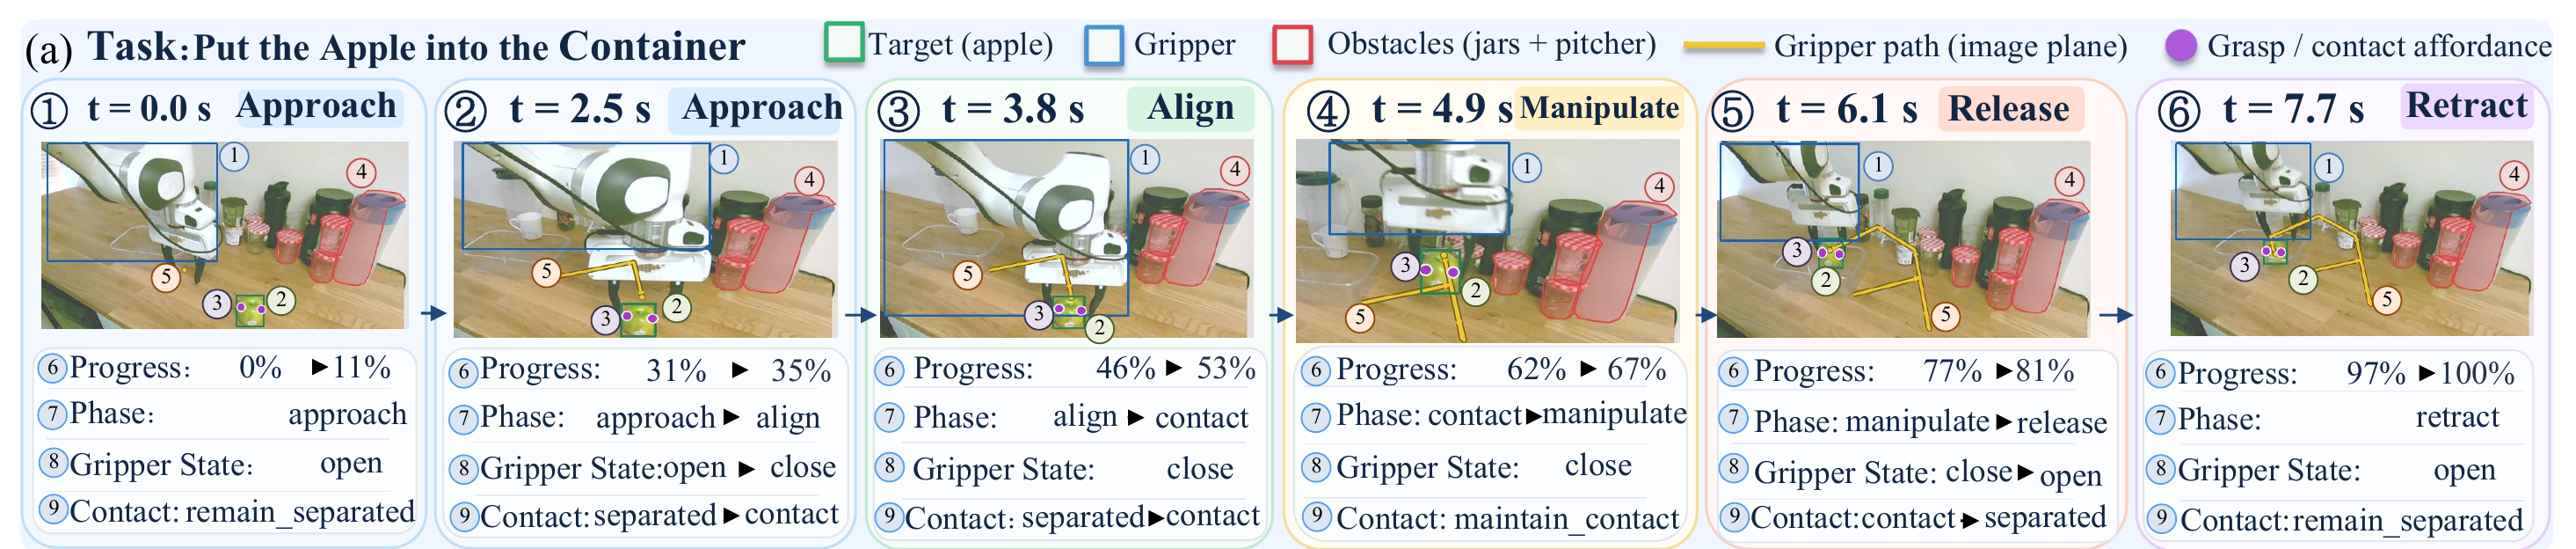
Nguồn: project page VLA-Δ. Hình minh họa sự thay đổi trong một episode, giúp phân biệt state và transition.
Để hình dung tác dụng của từng tín hiệu, hãy tự hỏi ba câu khi xem robot gắp vật: nó đang ở bước nào, vùng ảnh nào đang chuyển động, và chuyển động đó có đưa vật tới mục tiêu không? Một tín hiệu đơn lẻ khó trả lời đủ cả ba câu. Đây là cách giải thích trực quan; optical flow không tự cung cấp lực tiếp xúc hay mô phỏng vật lý chính xác.
3. Chuẩn bị môi trường model
Làm việc trong một thư mục thực hành riêng. Tải ZIP từ nút Code của repo chính thức, giải nén và mở terminal tại thư mục chứa server.py, configs/ và requirements/. Tất cả lệnh tiếp theo giả định thư mục hiện tại là root của repo VLA-Delta, không phải repo website vnrobo.
Bạn cần Conda, Linux, NVIDIA GPU với driver phù hợp CUDA và dung lượng lưu checkpoint/dataset. Repo hướng dẫn PyTorch CUDA 12.4; đừng hiểu đây là cam kết rằng mọi GPU đều chạy được. Kiểm tra GPU trước bằng nvidia-smi; dung lượng VRAM cần đo với cấu hình thực tế, đặc biệt khi fine-tune toàn model.
conda create -n vla-delta -c conda-forge python=3.10 pip libgl libegl ffmpeg -y
conda activate vla-delta
export PYTHONNOUSERSITE=1
export LD_LIBRARY_PATH="$CONDA_PREFIX/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
python -m pip install torch==2.6.0 torchvision==0.21.0 --index-url https://download.pytorch.org/whl/cu124
python -m pip install -r requirements/train.txt
python -c "import torch; print(torch.__version__, torch.cuda.is_available())"
Kết quả CUDA cần là True trước khi chạy model server. PYTHONNOUSERSITE giúp tránh vô tình nạp package từ môi trường người dùng. LD_LIBRARY_PATH đưa thư viện Conda vào đường tìm kiếm; mỗi terminal mới cần thiết lập lại các biến mà nó sử dụng.
Tải đúng checkpoint
Checkpoint VLA-Delta-libero dành cho đánh giá LIBERO. Checkpoint VLA-Delta-base dành cho fine-tune downstream. Không hoán đổi chúng rồi mặc định kết quả sẽ giống nhau.
# Chạy trong môi trường vla-delta tại root repo.
python - <<'PY'
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id="t0rn0d0/VLA-Delta-libero",
    local_dir="checkpoints/VLA-Delta-libero",
)
PY
Tải toàn bộ snapshot thay vì chỉ một file weights. Config, tokenizer, difference queries và action expert đều có thể cần khi khôi phục model. Nếu tải gián đoạn, hoàn tất snapshot trước khi debug lỗi inference. Ghi lại revision checkpoint đã tải để kết quả sau này có thể đối chiếu.
4. Cài LIBERO trong môi trường riêng
Hướng dẫn LIBERO của repo dùng Python 3.8.13 cho simulator, tách khỏi Python 3.10 của model. Cách tách này tránh xung đột dependency giữa simulator cũ và stack VLM mới.
Trước tiên, tải ZIP từ repo Lifelong-Robot-Learning/LIBERO, giải nén mã nguồn vào third_party/libero trong repo VLA-Delta. Kiểm tra không tạo thêm một tầng thư mục như third_party/libero/LIBERO-master.
conda create -n vla-libero -c conda-forge python=3.8.13 pip libgl libegl -y
conda activate vla-libero
export PYTHONNOUSERSITE=1
export LD_LIBRARY_PATH="$CONDA_PREFIX/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
python -m pip install torch==1.11.0+cpu torchvision==0.12.0+cpu --extra-index-url https://download.pytorch.org/whl/cpu
python -m pip install -r requirements/libero.txt
python -m pip install -e ./third_party/libero --no-deps
python scripts/setup_libero.py --libero-root ./third_party/libero --config-dir ./data/libero-config
PyTorch CPU trong môi trường client không có nghĩa model chạy CPU. Model inference chạy trong môi trường vla-delta dùng CUDA; simulator gửi request sang server qua WebSocket. Trong cấu hình local mặc định, cả hai giao tiếp tại 127.0.0.1:8000.
Đánh giá checkpoint có sẵn không yêu cầu tải dataset demonstration để training. Simulator vẫn cần asset và cấu hình đường dẫn. Nếu lỗi xuất hiện trước khi server nhận request, hãy kiểm tra simulator, EGL và asset trước khi nghi ngờ weights.
5. Inference: chạy server và một task thử
Mở terminal A tại root repo. Khởi động model server rồi giữ terminal hoạt động:
conda activate vla-delta
export PYTHONNOUSERSITE=1
export LD_LIBRARY_PATH="$CONDA_PREFIX/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
export VLA_EVAL_CHECKPOINT="$PWD/checkpoints/VLA-Delta-libero"
python server.py --config configs/eval/libero_server.yaml
Config server chọn inference_mode: direct_action, window_size: 1 và num_denoised_steps: 5. Nó cũng trỏ tới stats/demo_libero/meta/stats.json cho checkpoint LIBERO công bố. Không cần tự viết một client gửi JSON đoán schema; client của repo đã xử lý observation và giao thức tương ứng.
Mở terminal B, cũng tại root repo:
conda activate vla-libero
export PYTHONNOUSERSITE=1
export LD_LIBRARY_PATH="$CONDA_PREFIX/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
export LIBERO_CONFIG_PATH="$PWD/data/libero-config"
export MUJOCO_GL=egl
export PYOPENGL_PLATFORM=egl

# Smoke test: một task, hai episode; không phải benchmark đầy đủ.
python scripts/evaluate.py --config configs/eval/libero.yaml \
  --suites libero_spatial --tasks 0 --trials 2 \
  --output-dir outputs/eval/libero-smoke-01 --execute
Một smoke test hữu ích cần hoàn tất episode, lưu kết quả và cho thấy model thực sự điều khiển robot. Chỉ thấy server khởi động chưa đủ. Hai episode cũng quá ít để kết luận policy tốt; bước này chủ yếu kiểm tra toàn tuyến model–network–simulator.
Theo mã scripts/evaluate.py, thư mục output phải chưa tồn tại. Mỗi lần chạy hãy chọn tên mới. Script lưu kế hoạch thí nghiệm, log theo suite và summary.json; nếu group thất bại, báo cáo có thể ở trạng thái incomplete. Đừng lấy tỷ lệ trên những episode còn lại làm điểm benchmark hoàn chỉnh.
Chạy cấu hình đánh giá đầy đủ
python scripts/evaluate.py --config configs/eval/libero.yaml \
  --output-dir outputs/eval/libero-full-01 --execute
Mặc định gồm bốn suite libero_spatial, libero_object, libero_goal, libero_10; mỗi suite có mười task, mỗi task 50 episode, tổng cộng 2.000 episode. Client seed mặc định là 7. Execution horizon bằng 10 nghĩa là client thực thi mười action liên tiếp trước lần dự đoán tiếp theo. Hãy giữ checkpoint, preprocessing, stats và horizon nhất quán khi so sánh.
6. Fine-tune từ base với dữ liệu LIBERO
Tải dataset HuggingFaceVLA/libero về data/libero và base checkpoint về checkpoints/VLA-Delta-base. Dataset registry dùng entry libero_wo_ecot_pt; đường dẫn tương đối trong YAML được tính từ file khai báo trường đó. Đừng đổi tên entry chỉ vì nó khác tên folder.
conda activate vla-delta
python - <<'PY'
from huggingface_hub import snapshot_download
snapshot_download("t0rn0d0/VLA-Delta-base",
                  local_dir="checkpoints/VLA-Delta-base")
snapshot_download("HuggingFaceVLA/libero", repo_type="dataset",
                  local_dir="data/libero")
PY
export PYTHONNOUSERSITE=1
export LD_LIBRARY_PATH="$CONDA_PREFIX/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
export VLA_PRETRAIN_CHECKPOINT="$PWD/checkpoints/VLA-Delta-base"
export VLA_OUTPUT_ROOT="$PWD/outputs"

# Xem lệnh launch và tham số trước khi cấp tài nguyên training.
python scripts/train.py --config configs/finetune/libero.yaml --dry-run
python scripts/train.py --config configs/finetune/libero.yaml --execute
Config hiện tại dùng action horizon 10 và action-only loss. Common config đặt tám epoch, batch mỗi device 16, global batch kỳ vọng 64 và peak learning rate 2e-5; cả VLM lẫn action expert đều được tune. Vì vậy đừng coi đây là preset nhẹ dành chắc chắn cho một GPU cá nhân. Đọc lệnh launch từ dry-run để biết cách repo phân phối training; dry-run không chứng minh dataset hợp lệ hoặc VRAM đủ.
Nếu thay đổi số GPU hoặc batch, kiểm tra lại effective global batch. Một lần chạy ngắn với --max_train_steps có thể xác minh đường dữ liệu và lưu checkpoint, nhưng không đủ để tuyên bố đạt điểm paper. Khi gặp OOM, điều chỉnh có chủ đích và lưu cấu hình mới thay vì âm thầm báo kết quả từ preset khác.
Normalization stats phải đi cùng dữ liệu
Action thường được chuẩn hóa khi training rồi giải chuẩn hóa trước khi simulator thực thi. Stats sai có thể khiến model load bình thường nhưng chuyển động sai biên độ. Với checkpoint tự train, khởi động server bằng đường dẫn checkpoint thật và stats của chính training dataset:
export VLA_EVAL_CHECKPOINT="/absolute/path/to/your/checkpoint"
python server.py --config configs/eval/libero_server.yaml \
  --stats_file /absolute/path/to/your/training_dataset/meta/stats.json
Đây là chỗ cần đối chiếu camera, state/action dimension và cách chuẩn hóa. Không tự sao chép stats demo để “chữa” lỗi schema của một robot khác. Nếu muốn mở rộng kiến thức về quy trình policy training, xem hướng dẫn π0-FAST.
7. Pretraining khác fine-tuning thế nào?
Fine-tune phía trên tận dụng representation đã học. Repo còn cung cấp ba stage pretraining: học difference text, học auxiliary slots/optical flow, rồi joint action prediction. Người muốn nghiên cứu lại pipeline cần ZR-0, dữ liệu tương ứng, annotation và cấu hình chuẩn bị; chỉ tải LIBERO không thay thế được toàn bộ đầu vào này.
# Chỉ chạy sau khi đã chuẩn bị dữ liệu và annotation theo registry.
export VLA_BASE_MODEL="$PWD/checkpoints/ZR-0"
export VLA_PREPARED_ROOT="$PWD/data/prepared"
export VLA_OUTPUT_ROOT="$PWD/outputs/pretrain"
python scripts/prepare_pretraining.py --config configs/pretrain/prepare.yaml
python scripts/train.py --config configs/pretrain/stage1_ar.yaml --execute
export VLA_STAGE1_CHECKPOINT="$VLA_OUTPUT_ROOT/stage1_ar/model-final"
python scripts/train.py --config configs/pretrain/stage2_aux.yaml --execute
export VLA_STAGE2_CHECKPOINT="$VLA_OUTPUT_ROOT/stage2_aux/model-final"
python scripts/train.py --config configs/pretrain/stage3_joint.yaml --execute
Đừng bỏ qua bước kiểm tra annotation có tồn tại và khớp trajectory. Việc repo có entry point không chứng minh mọi dataset lớn, annotation phụ và dịch vụ tạo nhãn đều được đóng gói sẵn. Với beginner, checkpoint base giúp tách bài toán học policy khỏi bài toán xây corpus tiền huấn luyện.
8. Kết quả và giới hạn cần đọc đúng
Bảng dưới trích các hàng liên quan trong README chính thức. Đơn vị là phần trăm success rate; cột “2B” trong repo nói về kích thước VLM, không nên tự diễn giải thành tổng tham số toàn hệ thống.
| Mô hình | Spatial | Object | Goal | Long | Trung bình |
|---|---|---|---|---|---|
| π₀.₅ | 98,8 | 98,2 | 98,0 | 92,4 | 96,9 |
| VLA-Adapter | 97,8 | 99,2 | 97,2 | 95,0 | 97,3 |
| ZR-0 | 97,4 | 99,4 | 97,8 | 96,4 | 97,8 |
| VLA-Δ | 98,8 | 99,8 | 98,6 | 96,4 | 98,4 |
VLA-Δ hơn ZR-0 0,6 điểm phần trăm trung bình, đồng hạng ở Long. Trên RoboTwin 2.0, repo báo cáo 90,06% Clean và 89,74% Random. Đây là các benchmark khác nhau; không trộn chúng thành một điểm chung hoặc suy ra tỷ lệ thành công cho robot thật.
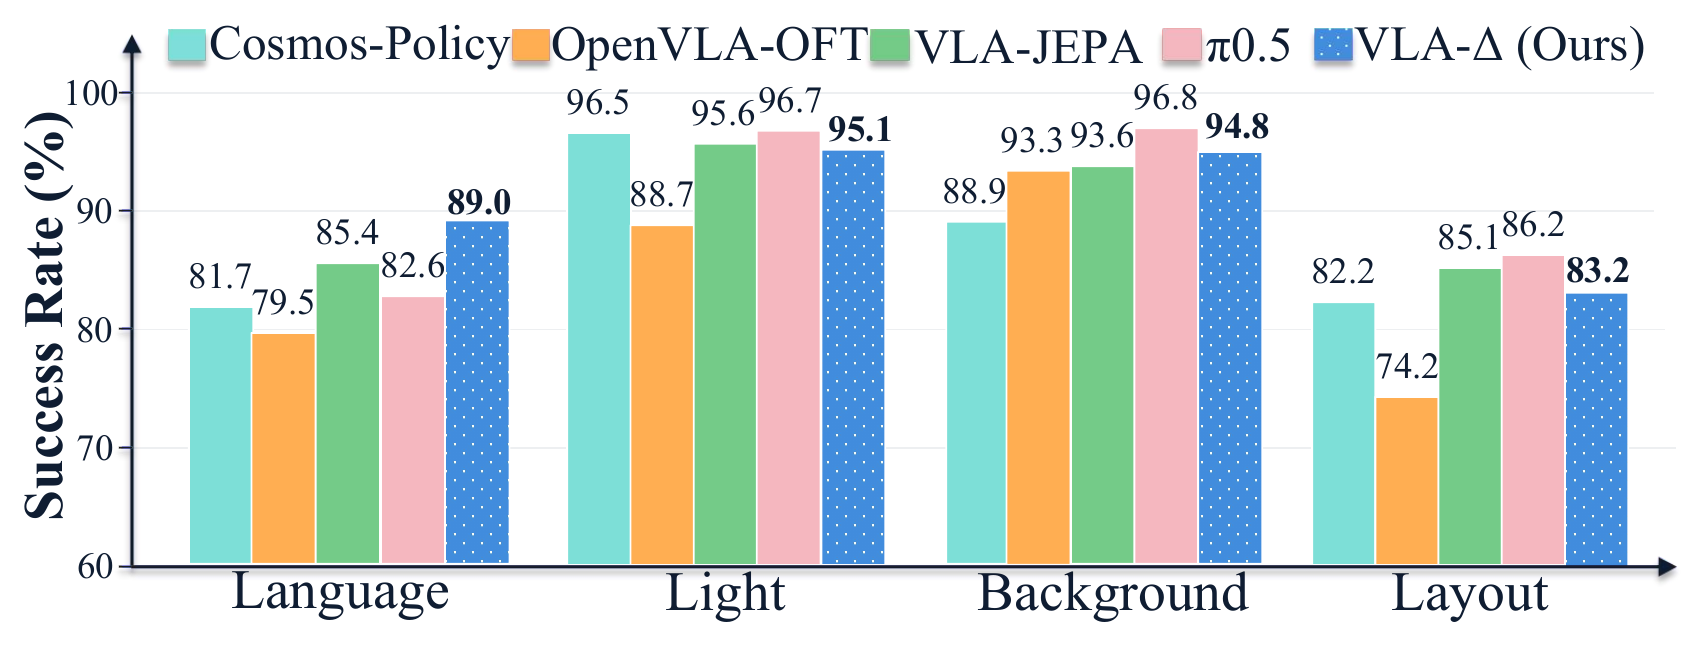
Nguồn: project page VLA-Δ. Robustness cần được đo riêng với benchmark chuẩn, không suy ra từ một video thành công.
Paper báo cáo trung bình robot thật 68,0%, cao hơn π₀.₅ 5,5 điểm phần trăm trên năm task của thí nghiệm. Điều đó không phải cam kết 98,4% ngoài đời. Cũng không nên diễn giải “không thêm inference overhead” thành zero latency: model vẫn cần chạy backbone và action expert; phần được bỏ là giải mã các mục tiêu phụ. Nguồn: paper gốc.
9. Gỡ lỗi theo vị trí hỏng
| Biểu hiện | Việc nên kiểm tra đầu tiên |
|---|---|
| Model không thấy CUDA | Đúng Conda env, driver và bản PyTorch CUDA |
| Simulator lỗi EGL | Thư viện EGL, biến rendering và quyền truy cập GPU |
| Client không kết nối | Server còn chạy, host/port khớp, đúng terminal |
| Robot di chuyển sai biên độ | Stats, action dimension và checkpoint tương ứng |
| Không chạy lại được output | Đặt thư mục output mới, giữ log cũ để đối chiếu |
| Điểm khác paper | Đủ episode, đủ suite, seed, horizon và checkpoint |
Khi xem rollout, ghi lại thời điểm tiếp cận, đóng gripper, nâng vật và đặt vật. Cách chia này giúp phân biệt lỗi nhận diện mục tiêu với lỗi điều khiển hoặc sai normalization. Nếu muốn đối chiếu một hướng tận dụng dự đoán tương lai khác, đọc PLaW-VLA với V-JEPA 2.
Mốc hoàn thành thực hành hợp lý là một lượt smoke test đầy đủ, một báo cáo benchmark có cấu hình rõ ràng và một checkpoint fine-tune được đánh giá bằng stats đúng. Từ đó bạn mới có cơ sở quyết định tăng tài nguyên training hay chuyển sang dữ liệu robot riêng.