MambaAct giải quyết nút thắt nào?
Một robot nhận lệnh “đặt chiếc bát vào ngăn kéo” phải xử lý ảnh, hiểu ngôn ngữ rồi sinh chuyển động. Với Vision-Language-Action model, gọi tắt VLA, ba bước này nằm trong cùng một policy học từ dữ liệu. Tuy nhiên, model hiểu cảnh nhanh chưa chắc sinh hành động nhanh: trong flow matching, action expert phải được gọi nhiều lần để biến noise thành một đoạn hành động liên tục.
MambaAct: Efficient Mamba Action Experts for Flow-Matching Vision-Language-Action Models của Khuyen Pham, Tran Nguyen Le, Edoardo Fazzari và Cesare Stefanini, công bố dưới dạng arXiv preprint tháng 10/2026, nhắm trực tiếp vào phần tính toán lặp này. Nhóm giữ visual-language backbone pretrained của π0.5, thay Transformer action expert bằng Mamba3 nhỏ hơn, rồi fine-tune trên tác vụ downstream. Mã nguồn chính thức nằm tại giakhuyendihoc/MambaAct.
Con số cần nhớ là giảm 64,8% độ trễ của mười bước denoising trên H100, từ 160,26 ms xuống 56,40 ms. Toàn bộ policy query giảm từ 228,6 ms xuống 107,6 ms, tương ứng 52,9%. Hai tỷ lệ mô tả hai phạm vi đo khác nhau. Bài này hướng dẫn theo mã nguồn công khai và tài liệu tái lập; các kết quả được trích từ tác giả, không phải số đo do vnrobo tự chạy.
Ba khái niệm trước khi bắt đầu
Action chunk là một dãy hành động tương lai sinh ra trong một truy vấn. Thay vì dự đoán từng lệnh riêng lẻ, model có thể sinh mười bước, thực thi năm bước đầu rồi quan sát lại. Cách này giảm số lần gọi policy nhưng vẫn cho phép sửa sai bằng quan sát mới.
Flow matching học một trường vận tốc đưa dữ liệu nhiễu về hành động hợp lệ. “Vận tốc” ở đây là hướng thay đổi trong không gian biểu diễn action, không đồng nghĩa trực tiếp với vận tốc khớp robot. Khi inference, hệ thống bắt đầu từ Gaussian noise và dùng Euler integration để cập nhật action chunk.
Mamba là sequence mixer dựa trên selective state-space model. Thay vì tạo mọi tương tác cặp token bằng self-attention, nó truyền thông tin qua trạng thái chọn lọc dọc chuỗi. Trong MambaAct, chuỗi này là các action token trong một chunk; không nên hiểu đây mặc nhiên là bộ nhớ dài hạn xuyên suốt nhiều episode.
Nếu chưa quen cách dữ liệu ảnh, ngôn ngữ và hành động đi vào policy, bạn có thể đọc hướng dẫn SmolVLA và policy training trước, rồi quay lại quy trình tái lập dưới đây.
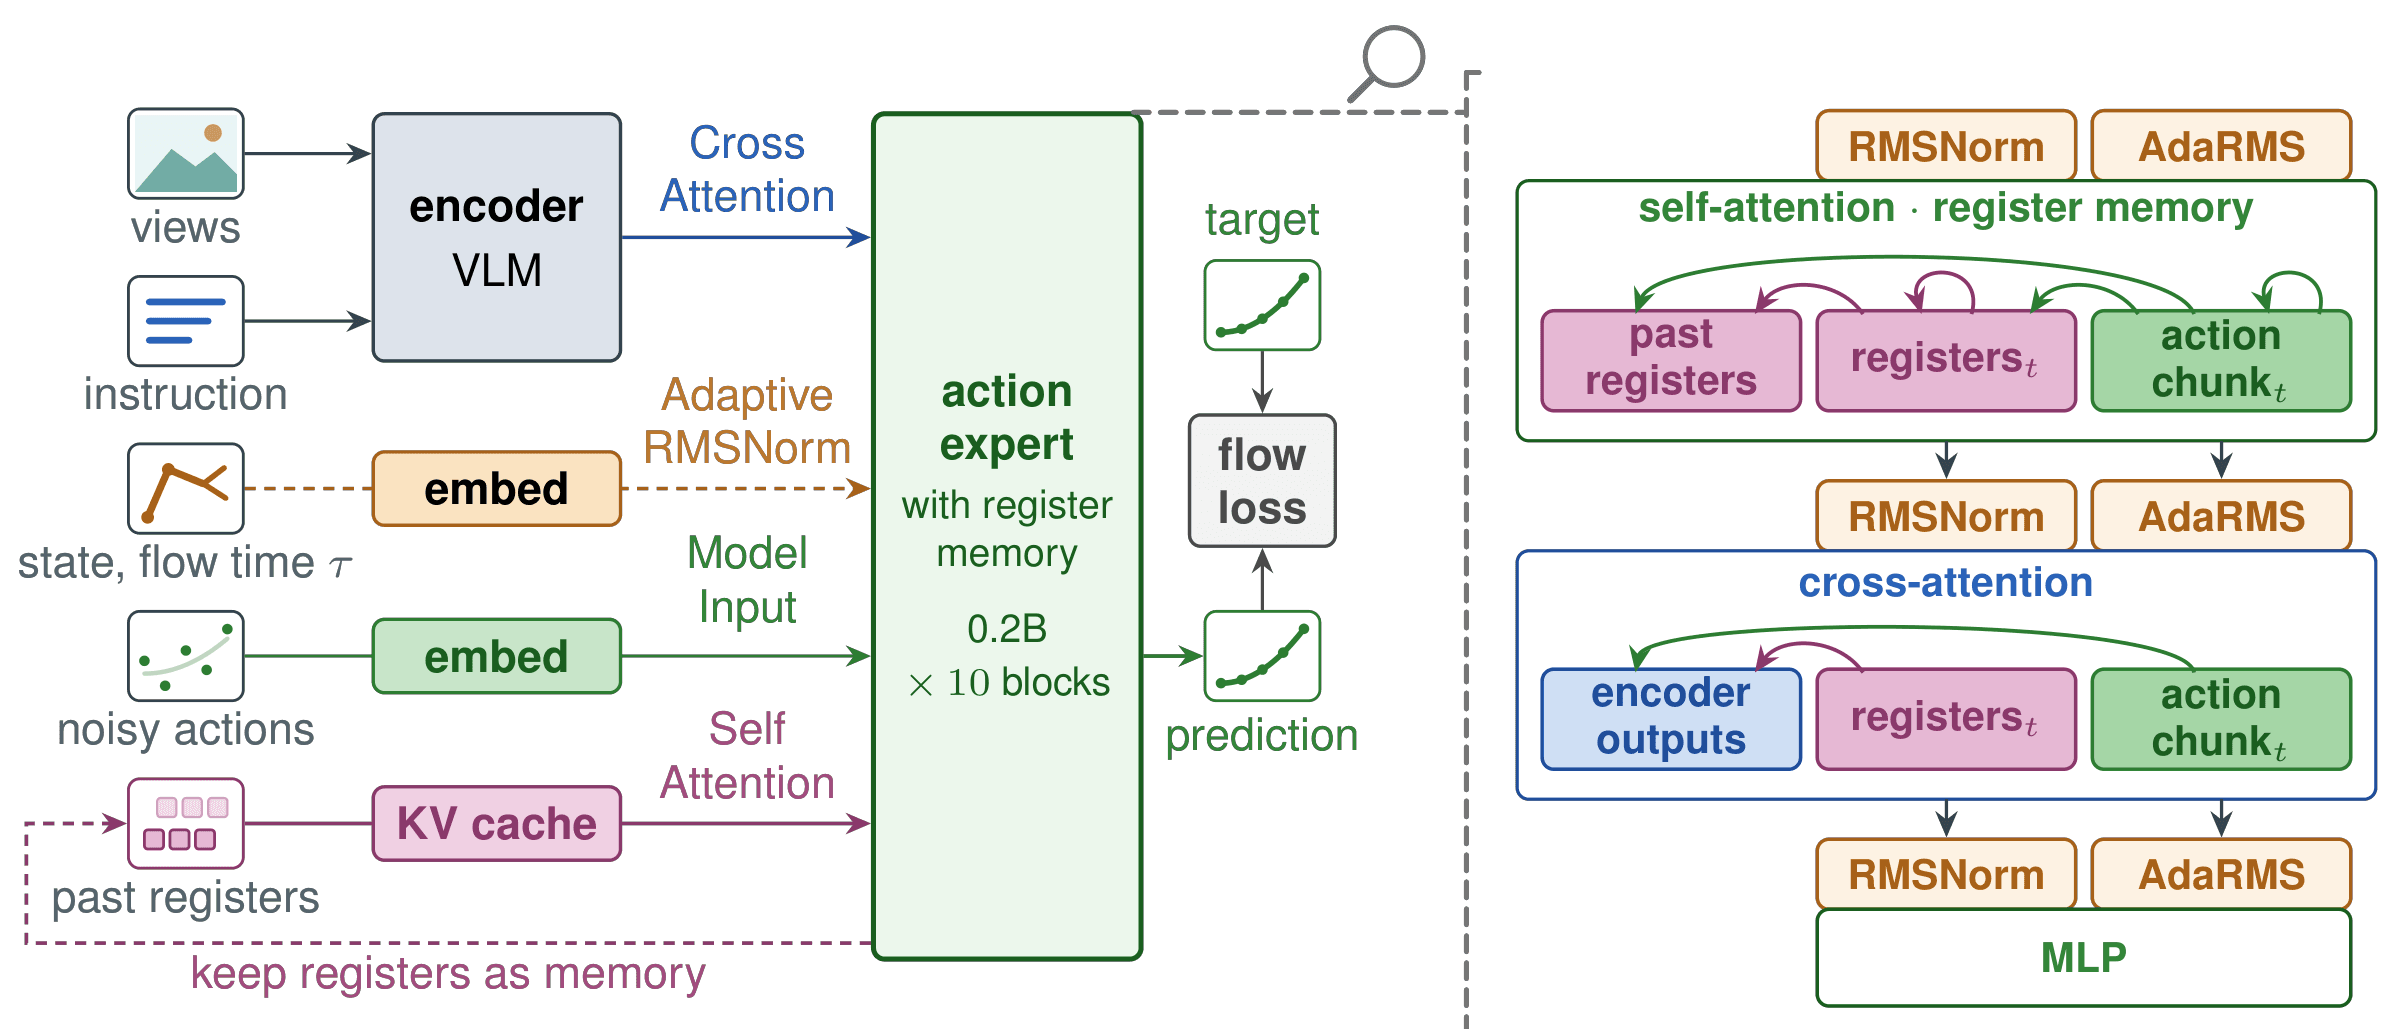
Kiến trúc: giữ backbone, thay đường sinh action
Nguồn hình: Figure 2 trong paper gốc. Đây là sơ đồ kỹ thuật của mô hình, không phải ảnh robot minh họa chung.
Visual-language prefix được xử lý một lần
Hai ảnh RGB, gồm wrist view và third-person view, cùng instruction được đưa qua PaliGemma backbone của π0.5: SigLIP mã hóa ảnh và Gemma xử lý visual-language prefix. Bản MambaAct chính chạy đủ 18 VLM layers.
Từ “giữ backbone” nói đến kiến trúc và khởi tạo pretrained. Trong recipe công bố, backbone vẫn được fine-tune, bao gồm vision encoder và các VLM layers được thực thi. Đây không phải cách chỉ huấn luyện một head nhỏ trên VLM đóng băng.
Context Compressor tạo 64 context tokens
Các prefix token được project về chiều rộng action expert. Visual tokens được gom theo các đoạn liên tiếp bằng masked pooling; language tokens được nén tương tự. Bốn learned queries dùng attention để trích global summaries. Đầu ra gồm:
| Nhóm context | Số token | Vai trò |
|---|---|---|
| Visual | 44 | Tóm tắt thông tin hình ảnh |
| Language | 16 | Giữ điều kiện từ instruction |
| Global | 4 | Tổng hợp học được trên prefix |
| Tổng | 64 | Giao diện gọn giữa VLM và expert |
Modality embeddings phân biệt các nhóm token. Sau bước refinement, masked mean pooling tạo condition vector z. Mỗi action block có MLP riêng biến z thành FiLM scale, shift và residual gate. Như vậy, không phải mọi attention đều biến mất: learned global queries vẫn dùng attention ở bước nén context. Điểm tiết kiệm nằm ở việc không lặp token-level cross-attention trong mỗi lần denoising.
Bốn Mamba3 blocks xử lý action sequence
Expert chính dùng SISO Mamba3 với hidden width 512, state size 64, expansion factor 1, head dimension 64, chunk size 64 và FFN width 2048. Core có 29,7 triệu parameters, so với 311,5 triệu của expert π0.5 gốc. Đây là số đo core, không phải toàn bộ policy chỉ còn 29,7 triệu parameters.
Action được pad lên 32 chiều nội bộ rồi project thành đúng H action tokens. Paper mô tả không thêm robot-state token riêng vào chuỗi action này. Flow time được embedding riêng và đưa vào từng block. Đừng suy ra robot thật có 32 bậc tự do: padding chỉ phục vụ giao diện model.
Context và FiLM parameters được tính một lần cho mỗi query rồi dùng lại trong mười bước. Ngược lại, action tokens và time conditioning thay đổi theo từng bước Euler. Cuối expert, RMSNorm và linear head dự đoán flow velocity.
Flow matching được huấn luyện như thế nào?
Có thể đọc công thức theo dạng văn bản sau, với A0 là action chunk sạch, eps là Gaussian noise:
u ~ Beta(1.5, 1.0)
t = 0.001 + 0.999 * u
Xt = t * eps + (1 - t) * A0
velocity_target = eps - A0
loss = mean_squared_error(predicted_velocity, velocity_target)

Inference, 10 bước:
X(t - 0.1) = X(t) - 0.1 * predicted_velocity(X(t), t, observation)
Đây là mô tả thuật toán, không phải API Python của repo. Nó giúp tránh một lỗi phổ biến: đổi dấu Euler update hoặc nhầm target thành A0 - eps. Noise lớn ứng với đầu quá trình; sau các update, chunk tiến về hành động có cấu trúc.
FiLM gates cũng có chi tiết đáng chú ý: scale/shift và time projections được zero-initialize; residual multiplier ban đầu là 0,2. Nhánh Mamba mới vì thế có ảnh hưởng ban đầu vừa phải nhưng vẫn hoạt động để nhận gradient. Tác giả không khẳng định 0,2 là một giá trị tối ưu đã được tìm kiếm toàn diện.
Bước 1: chuẩn bị máy và môi trường policy
Theo Reproducibility Guide, thí nghiệm π0.5 dùng Linux, Python 3.11, PyTorch 2.7.1, CUDA 12.8, bfloat16 và một NVIDIA H100. Chuẩn bị driver NVIDIA hoạt động, uv, đủ dung lượng cho checkpoint, dataset và cache trước khi chạy.
# Thực hiện trên máy thí nghiệm của bạn.
git clone https://github.com/giakhuyendihoc/MambaAct.git
cd MambaAct
bash scripts/setup.sh

export MAMBAACT_OUTPUT_ROOT="$PWD/artifacts"
export MAMBAACT_PI05_CHECKPOINT="$MAMBAACT_OUTPUT_ROOT/checkpoints/pi05_base_pytorch"

nvidia-smi
cd openpi
uv run python -c 'import torch; print(torch.__version__, torch.cuda.is_available())'
cd ..
Setup sử dụng openpi/uv.lock, cài Mamba vendored trong repo rồi áp dụng các Transformers replacements đi kèm. Vì vậy, hãy dùng môi trường riêng của dự án thay vì cài đè vào môi trường đang phục vụ model khác. Không thay Mamba3 bằng một package Mamba bất kỳ chỉ vì tên gần giống nhau.
H100 là phần cứng tham chiếu, không phải bằng chứng rằng mọi GPU nhỏ đều chạy được cùng batch size. Giảm batch hoặc dùng gradient accumulation là thay đổi thí nghiệm; nếu làm vậy, phải ghi lại và không gọi đó là tái lập nguyên trạng.
Bước 2: chuyển checkpoint π0.5 sang PyTorch
Từ thư mục gốc MambaAct, chạy:
cd openpi
uv run python examples/convert_jax_model_to_pytorch.py \
  --checkpoint-dir gs://openpi-assets/checkpoints/pi05_base \
  --config-name pi05_libero_baseline \
  --output-path "$MAMBAACT_PI05_CHECKPOINT" \
  --precision bfloat16
cd ..

test -s "$MAMBAACT_PI05_CHECKPOINT/model.safetensors"
Baseline và MambaAct phải khởi tạo từ cùng base checkpoint. Không dùng một π0.5 đã fine-tune LIBERO làm initializer cho riêng một bên, vì điều đó thay đổi điều kiện so sánh. Khi launcher báo thiếu model.safetensors, kiểm tra conversion và biến môi trường trước, thay vì tạo file rỗng để vượt kiểm tra.
Dữ liệu training mặc định trong config LIBERO là physical-intelligence/libero, dạng LeRobot đã chuyển đổi. Dataset để học và bộ simulator dùng đánh giá có vai trò khác nhau. Có dữ liệu training không có nghĩa là máy đã cài xong LIBERO, assets và trạng thái khởi tạo để rollout.
Bước 3: cài LIBERO trong môi trường riêng
LIBERO chính thức có hướng dẫn dependency riêng, khác môi trường policy Python 3.11. Cài benchmark theo README của LIBERO trong một môi trường tách biệt; hoàn tất các assets và cấu hình đường dẫn mà benchmark yêu cầu. Không cài chồng bộ dependency simulator cũ vào openpi/.venv.
Ví dụ dưới đây giả định bạn đã có môi trường Conda tên libero theo hướng dẫn benchmark. Chạy từ thư mục MambaAct sau khi cài xong:
export MAMBAACT_LIBERO_ROOT="$PWD/third_party/LIBERO"
export MAMBAACT_LIBERO_PYTHON="$(conda run -n libero python -c 'import sys; print(sys.executable)')"

"$MAMBAACT_LIBERO_PYTHON" -c 'from libero.libero import benchmark; print(sorted(benchmark.get_benchmark_dict()))'
Đặt biến root theo vị trí checkout LIBERO thực tế; nếu bạn cài nơi khác, sửa đường dẫn này. Lệnh import cần chạy thành công trước khi tiêu tốn thời gian training. Kiểm tra tiếp việc tạo môi trường offscreen bằng ví dụ chính thức của LIBERO, vì import thành công chưa bảo đảm EGL và MuJoCo render hoạt động trên máy headless.
Bước 4: fine-tune hai model theo cùng recipe
Launcher chính tính normalization statistics trước khi gọi trainer. Recipe công bố được tóm tắt trong bảng:
| Tham số | Giá trị |
|---|---|
| Optimizer steps | 30.000 |
| Batch / gradient accumulation | 16 / 1 |
| Optimizer | AdamW |
| Learning rate | Cosine, 5e-5 về 5e-6 |
| Warmup | 0 |
| Weight decay / gradient clipping | 1e-10 / 1,0 |
| Data workers | 8 |
| Precision / gradient checkpointing | bfloat16 / bật |
| LoRA / EMA | Không dùng / không dùng |
| Trainable modules | Vision, VLM, compressor, gates, expert |
| Checkpoint | Chỉ lưu weights ở bước cuối |
bash scripts/train_libero.sh mambaact
bash scripts/train_libero.sh pi05
Hai lệnh chạy tuần tự trên cùng máy giúp tránh cạnh tranh GPU. Checkpoint MambaAct mặc định nằm ở artifacts/checkpoints/mambaact_libero/mambaact_l18/30000; baseline nằm dưới pi05_libero_baseline/pi05_l18/30000. Nếu đổi output root, dùng đường dẫn tương ứng.
Theo kết quả seed 42, training MambaAct đầy đủ mất khoảng 13,78 giờ trên hệ thống tham chiếu. Đây là mốc lập kế hoạch, không phải cam kết thời gian cho máy của bạn. Vì chỉ lưu model weights cuối cùng, đừng giả định checkpoint có optimizer state để resume training chính xác sau gián đoạn.
Bước 5: chạy inference và đánh giá
Cách dễ nhất để chạy inference đúng benchmark là dùng evaluator đi kèm. Nó tự mở policy server trong môi trường OpenPI, rồi gọi simulator client bằng Python LIBERO bạn đã khai báo:
bash scripts/eval_libero.sh mambaact \
  "$MAMBAACT_OUTPUT_ROOT/checkpoints/mambaact_libero/mambaact_l18/30000"

bash scripts/eval_libero.sh pi05 \
  "$MAMBAACT_OUTPUT_ROOT/checkpoints/pi05_libero_baseline/pi05_l18/30000"
Cấu hình chuẩn là ảnh 224×224, horizon 10, mười denoising steps, thực thi năm environment actions rồi replan. Bốn suites Spatial, Object, Goal và LIBERO-10 có tổng 40 tasks. Với 50 trials/task, mỗi checkpoint cần 2.000 rollout. Xem JSON từng suite và summary.md trong artifacts/reports/libero/, thay vì chỉ nhìn loss training.
Muốn mở server riêng để tích hợp client, dùng config name, không phải alias model:
bash scripts/serve_checkpoint.sh mambaact_libero \
  "$MAMBAACT_OUTPUT_ROOT/checkpoints/mambaact_libero/mambaact_l18/30000"
Server mặc định nghe cổng 8000. Client cần giữ đúng mapping ảnh, instruction, normalization và action representation của LIBERO. Lệnh serve chỉ mở model service; nó không tự điều khiển một UR5 hay tự chuyển action sang giao thức robot của bạn.
Kết quả LIBERO và cách đọc đúng
Bảng kết quả công khai dùng ba training seeds 42, 17, 27; tất cả giữ evaluation seed 7. Dấu ± là population standard deviation giữa ba lần fine-tune, không phải confidence interval.
| Model | Spatial | Object | Goal | L-10 | Trung bình |
|---|---|---|---|---|---|
| π0.5 | 98,00 ± 0,43 | 98,33 ± 0,66 | 97,73 ± 0,84 | 92,80 ± 0,43 | 96,72 ± 0,14 |
| MambaAct | 98,73 ± 0,34 | 99,60 ± 0,43 | 98,60 ± 0,28 | 94,27 ± 1,52 | 97,80 ± 0,43 |
Mức tăng trung bình là 1,08 điểm phần trăm. Riêng seed 42, MambaAct đạt 98,40%; không dùng số tốt nhất này thay cho trung bình 97,80%. L-10 có độ biến thiên lớn hơn ở MambaAct, nên một seed đẹp chưa đủ mô tả độ ổn định.
Muốn tái lập multi-seed, đổi TRAIN_SEED và RUN_NAME khi train, đồng thời đổi RUN_ID khi eval để không ghi chồng báo cáo. Ví dụ một run độc lập:
TRAIN_SEED=17 RUN_NAME=mambaact_trainseed17 \
  bash scripts/train_libero.sh mambaact

RUN_ID=mambaact_trainseed17_eval50_seed7 EVAL_SEED=7 TRIALS=50 \
  bash scripts/eval_libero.sh mambaact \
  "$MAMBAACT_OUTPUT_ROOT/checkpoints/mambaact_libero/mambaact_trainseed17/30000"
Lặp lại cho cả hai model và đủ ba seeds theo guide chính thức. Khi tổng hợp, tính trung bình bốn suites của từng run trước, rồi mới lấy mean/std giữa các run. Không lấy trung bình các standard deviation theo suite để tạo standard deviation toàn bài.
Đo latency: đừng cộng nhầm các phạm vi
| Thành phần, seed 42 trên H100 | π0.5 | MambaAct |
|---|---|---|
| Prefix | 40,76 ms | 46,61 ms |
| Mười bước denoising | 160,26 ms | 56,40 ms |
| Toàn policy query | 228,6 ms | 107,6 ms |
| Model size theo báo cáo | 3,62B | 2,96B |
Prefix chậm hơn một chút vì có compressor, nhưng phần lặp nhanh hơn nhiều. E2E còn bao gồm I/O, truyền CPU–GPU, serialization, communication và scheduling. Vì vậy, cộng riêng hai component không nhất thiết ra số E2E được báo cáo.
bash scripts/profile_checkpoint.sh mambaact \
  "$MAMBAACT_OUTPUT_ROOT/checkpoints/mambaact_libero/mambaact_l18/30000"
Profiler dùng ba warmup queries và mười measured queries trên một observation chuẩn. Khi so sánh hai model, giữ cùng GPU, software, số denoising steps và tải nền. Tỷ lệ 228.6 / 107.6 xấp xỉ 2,12× cho policy query; không chuyển trực tiếp thành tần số control của cả robot, vốn còn phụ thuộc chunk execution và hạ tầng điều khiển.
Generalization, robot thật và các giới hạn

Nguồn hình: Figure 3 trong paper MambaAct. Hai camera cung cấp wrist view và third-person view cho policy.
Trên LIBERO-Plus, MambaAct đạt tổng 79,7% so với 78,7% của baseline khi không fine-tune thêm trên benchmark này. Tuy nhiên, nhóm Noise giảm từ 77,4% xuống 73,5%; Camera gần như ngang nhau. Tăng trung bình không có nghĩa là mọi loại perturbation đều được cải thiện.
Với UR5, mỗi task có 112 demonstrations từ 28 cấu hình training. Inference dùng RTX 5090, horizon 50, thực thi 30 actions ở 30 Hz rồi replan. Nut pouring đạt final score 96,9% so với 91,3%; tube placing đạt 88,8% so với 85,0%. Đây là normalized scores có partial credit: hoàn thành một bước trung gian có thể được 0,5 điểm. Không diễn giải chúng thành tỷ lệ hoàn thành toàn bộ task theo tiêu chí nhị phân.
Ablation cũng giúp hiểu giới hạn thông điệp “Mamba nhanh hơn Transformer”. Transformer nhỏ với gated conditioning có E2E 74,22 ms, nhanh hơn MambaAct 107,61 ms, nhưng chỉ đạt 85,7% so với 98,4% ở seed 42. Giá trị chính là giữ chất lượng dưới ngân sách expert nhỏ. Biến thể MambaAct L12 giảm VLM depth, đạt 97,5% và 102,91 ms trên LIBERO, tạo thêm lựa chọn đánh đổi accuracy–latency.
Khi chuyển sang robot riêng, hãy đánh giá lại action units, delta-joint convention, camera order và normalization trước khi gửi lệnh. Benchmark LIBERO không tự xác nhận giới hạn workspace, va chạm hoặc emergency stop. MambaAct là kết quả thuyết phục cho một đường tối ưu VLA cụ thể: giảm chi phí expert ở mỗi bước mà vẫn giữ mười bước flow matching và kiến thức pretrained của backbone.