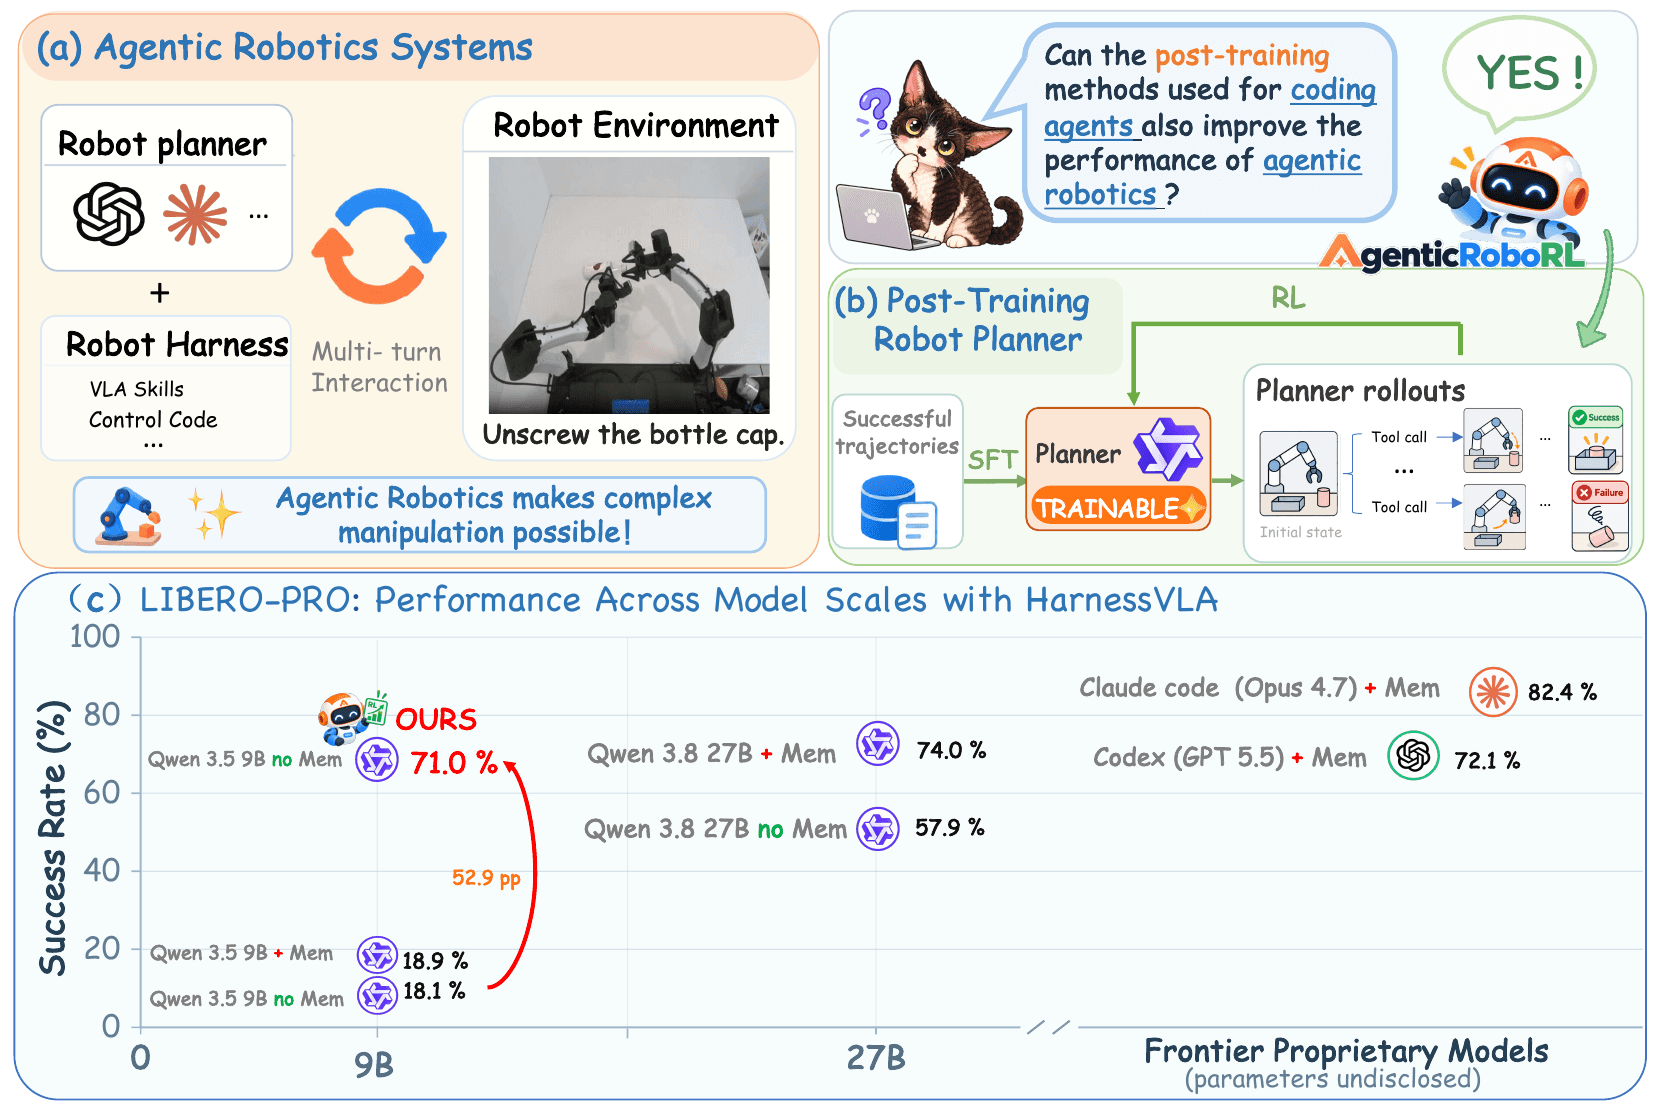
Một robot có thể gắp vật thể tốt nhưng vẫn thất bại khi được yêu cầu chọn đúng chiếc bát, chuyển sang vị trí khác hoặc xử lý một lần gắp hụt. Khi đó, vấn đề có thể nằm ở planner quyết định gọi công cụ nào, chứ không chỉ ở policy điều khiển cánh tay. AgenticRoboRL nghiên cứu cách cải thiện tầng quyết định này bằng supervised fine-tuning (SFT) và multi-turn reinforcement learning (RL).
Theo paper AgenticRoboRL, planner Qwen3.5-9B đạt 18,1% success rate ban đầu trên LIBERO-PRO, tăng lên 65,1% sau SFT và 71,0% sau RL. VLA bên dưới vẫn được giữ cố định. Đây là kết quả mô phỏng do tác giả báo cáo, không phải kết quả thực nghiệm trên robot thật của bài hướng dẫn này.
Bài viết đi từ khái niệm đến quy trình chạy checkpoint mở. Người mới có thể bắt đầu với demo không cần GPU để hiểu controller, rồi mới chuẩn bị môi trường mô phỏng và GPU. Các lệnh là hướng dẫn dựa trên mã nguồn công khai tại ngày viết; chúng chưa được chạy training trong phiên biên soạn này.
1. Ý tưởng: học cách điều phối một robot harness
Harness là phần mềm bao quanh model: nó xây dựng prompt, cung cấp tool, thực thi yêu cầu và đưa quan sát mới trở lại planner. Hãy hình dung planner là người phụ trách công việc, còn harness là bàn thao tác với các dụng cụ đã lắp sẵn. Có dụng cụ tốt chưa đủ; người phụ trách phải chọn đúng dụng cụ và biết khi nào cần kiểm tra lại.
Trong nhánh RPent của AgenticRoboRL, planner có thể dùng công cụ perception, gọi một VLA như một skill và sử dụng các primitive chuyển động. Model không phải tự sinh toàn bộ tín hiệu điều khiển khớp. Một ví dụ mang tính minh họa là: xác định vật thể, gắp bằng VLA, di chuyển tới vùng đích, thả và quan sát lại. Đây là mô tả quy trình, không phải tên một API Python mới để sao chép trực tiếp.
Điểm cần phân biệt khi đọc kết quả là planner policy và VLA policy. RL trong bài này cập nhật planner tạo token và tool call. Nó không fine-tune lại VLA để thay đổi phản xạ gắp. Vì vậy, một thí nghiệm kiểm chứng tốt phải giữ nguyên executor, perception và protocol, rồi thay checkpoint planner.
2. Kiến trúc từ quan sát đến bản cập nhật RL
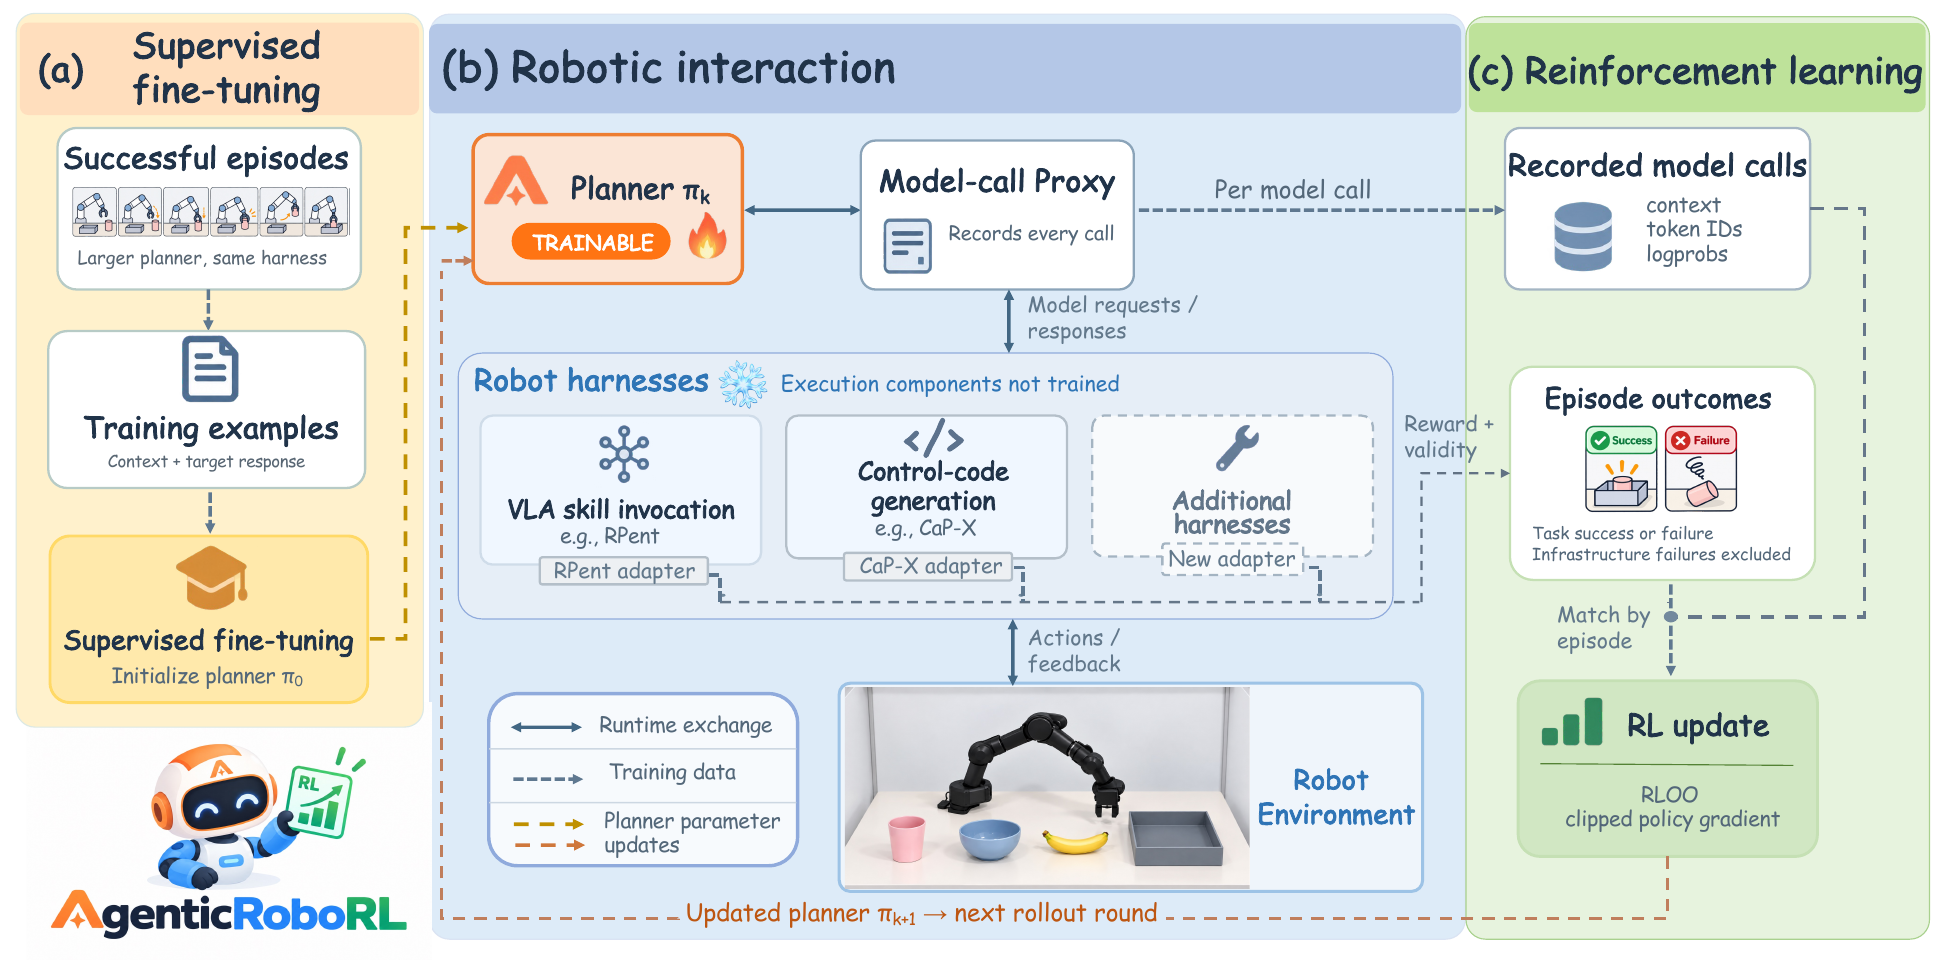
Trong mã nguồn AgenticRoboRL, đường đi chính gồm harness, recording proxy, model server vLLM, adapter và trainer. Proxy ghi lại token đầu vào, token đầu ra và log-probability. Adapter nối các lần gọi model với kết quả episode; trainer dùng dữ liệu đó để cập nhật planner cho vòng tiếp theo.
Tại sao cần lưu từng request thay vì chỉ lưu một đoạn hội thoại cuối cùng? Harness có thể bỏ bớt ảnh cũ, lược reasoning hoặc thay đổi lịch sử trước lượt kế tiếp. Nếu tự dựng lại prompt từ transcript cuối, trainer có thể tối ưu trên context khác với context đã sinh hành động. Đây giống việc chấm bài dựa trên một đề thi đã bị sửa sau khi học sinh làm xong.
Một adapter cần biết task, initial state, attempt, reward và cờ validity. Gắp sai là thất bại nhiệm vụ và phải được giữ lại với reward bằng 0. Server model mất kết nối là lỗi hạ tầng; biến nó thành một thất bại robot sẽ làm nhiễu tín hiệu học. Khi debug, hãy đọc cả kết quả simulator lẫn trạng thái tiến trình.
Ngoài RPent gọi VLA, dự án còn kết nối CaP-X, nơi planner viết Python qua robot API. Hai harness không cần chung biểu diễn action cấp thấp. Phần dùng chung nằm ở biên request–response của model; đây là lý do một pipeline training có thể phục vụ hai cơ chế thực thi khác nhau.
3. Chuẩn bị: chọn đúng mức thử nghiệm
Có ba mức thực hành hợp lý:
| Mức | Mục tiêu | Tài nguyên cần chuẩn bị |
|---|---|---|
| Minimal harness | Hiểu vòng rollout–build–train | Python và CPU; model/trainer giả |
| Inference RPent | Chạy checkpoint planner với simulator | GPU, vLLM, RPent, VLA và SAM 3 |
| RL đầy đủ | Thu thập rollout rồi cập nhật planner | Tài nguyên rollout và training nhiều GPU |
Đừng dùng kết quả minimal để kết luận robot đã học thao tác. Demo này kiểm tra cách các thành phần phối hợp. Ngược lại, không cần thuê cluster ngay chỉ để xem controller tạo thư mục gì hoặc cơ chế resume hoạt động ra sao.
Repo liệt kê Python 3.11; môi trường serving dùng vLLM 0.28.0; training dùng torch 2.13.0, transformers 5.17.0 và flash-linear-attention 0.5.2; RPent dùng transformers 4.57.6 và pydantic-ai-slim 2.49.0. Những phiên bản này thuộc các môi trường tách biệt, không nên cài tất cả vào một virtualenv. Xem bảng prerequisites hiện hành trước khi chuẩn bị CUDA và package binary.
Cấu hình training RPent được phát hành gọi torchrun --nproc_per_node 8. Controller chạy trên một máy không có nghĩa là training chỉ cần một GPU. Serving cũng phải chứa planner, KV cache, VLA và SAM 3 theo cấu hình. Dự án không cung cấp trong README một mức VRAM tối thiểu đã bảo đảm cho mọi GPU; đừng suy ra khả năng chạy chỉ từ số tham số 9B.
4. Cài mã nguồn và thử pipeline bằng CPU
Để người đọc không cần thao tác Git, có thể tải archive. Chạy các lệnh sau trong thư mục thực nghiệm riêng, không phải bên trong mã nguồn website:
mkdir -p ~/robot-lab
cd ~/robot-lab
curl -L https://github.com/xinxinliu-ai/AgenticRoboRL/archive/refs/heads/main.tar.gz \
  -o agenticroborl.tar.gz
tar -xzf agenticroborl.tar.gz
cd AgenticRoboRL-main
python3.11 -m venv .venv-minimal
source .venv-minimal/bin/activate
pip install pyyaml fastapi uvicorn httpx requests pytest
python rl/local_ctl.py train \
  --config harnesses/minimal/harness.yaml \
  --run-dir /tmp/agenticroborl-minimal \
  --weights w0 --rounds 2 --groups 6
python -m pytest -q tests
Quan sát controller hoàn tất hai vòng và kiểm tra state.json trong run directory. File này cho biết controller đang ở phase nào. Một lỗi ở đây nên được xử lý trước khi thêm simulator, vì lúc này chưa có CUDA, segmentation hoặc physics làm phức tạp việc tìm nguyên nhân.
Archive main có thể thay đổi theo thời gian. Với một thực nghiệm nghiêm túc, hãy lưu ngày tải, SHA256 của archive và bản cấu hình được sử dụng. Làm như vậy giúp đối chiếu kết quả sau này mà không nhầm một thay đổi code mới với tác dụng của RL.
5. Chuẩn bị RPent và checkpoint thực thi
AgenticRoboRL yêu cầu RPent tại revision f70d720 cùng patch đi kèm. Không bỏ qua patch: nó bổ sung các lựa chọn planner, profile kiến thức và trường verdict mà adapter đọc. Tài liệu patch mô tả phạm vi thay đổi.
Ví dụ dưới đây dùng archive đúng revision và công cụ patch. Nó giả định bạn đang ở thư mục AgenticRoboRL vừa giải nén:
export AGENTICROBORL_DIR="$PWD"
cd ..
curl -L https://github.com/RLinf/RPent/archive/f70d720.tar.gz -o rpent.tar.gz
mkdir -p RPent-f70d720
tar -xzf rpent.tar.gz --strip-components=1 -C RPent-f70d720
cd RPent-f70d720
patch --dry-run -p1 < "$AGENTICROBORL_DIR/patches/rpent/rpent_f70d720.patch"
patch -p1 < "$AGENTICROBORL_DIR/patches/rpent/rpent_f70d720.patch"
python3.11 -m venv .venv
source .venv/bin/activate
pip install -e ".[full]"
liberopro-download-assets --skip-existing
export RPENT_DIR="$PWD"
export RPENT_ENV="$PWD/.venv"
Gói .[full] là stack đầy đủ theo README RPent tại revision yêu cầu. Quá trình cài còn phụ thuộc CUDA, driver và các dependency của simulator. Nếu wheel không tương thích, xử lý môi trường theo tài liệu upstream trước khi tiếp tục; một virtualenv được tạo thành công chưa chứng minh simulator chạy được.
Tải VLA cố định; SAM 3 cũng cần checkpoint riêng:
pip install -U huggingface_hub modelscope
hf download RLinf/RLinf-Pi05-LIBERO-130-fullshot-SFT \
  --exclude optimizer.pt \
  --local-dir "$RPENT_DIR/checkpoints/pi05"
modelscope download facebook/sam3 \
  --local-dir "$RPENT_DIR/checkpoints/sam3"
export PI05_CHECKPOINT="$RPENT_DIR/checkpoints/pi05"
export SAM3_CHECKPOINT="$RPENT_DIR/checkpoints/sam3/sam3.pt"
Controller dùng hai biến PI05_CHECKPOINT và SAM3_CHECKPOINT, rồi truyền chúng thành biến đường dẫn phù hợp cho các service. Kiểm tra file sam3.pt thực sự tồn tại và việc tải model đáp ứng điều kiện truy cập của nhà cung cấp. Không cần API key của một planner thương mại khi planner được phục vụ cục bộ.
6. Tải planner mở và chạy inference qua evaluation
Kho checkpoint chính thức chứa hai thư mục sft/ và rl-v006/. Đường dẫn đưa vào --weights phải trỏ tới thư mục con chứa model, tokenizer và processor, không chỉ thư mục gốc của lần tải.
hf download ciciciciliu/AgenticRoboRL-Qwen3.5-9B \
  --include "sft/*" "rl-v006/*" \
  --local-dir "$RPENT_DIR/checkpoints/agenticroborl"
export SFT_WEIGHTS="$RPENT_DIR/checkpoints/agenticroborl/sft"
export RL_WEIGHTS="$RPENT_DIR/checkpoints/agenticroborl/rl-v006"
Chuẩn bị môi trường vLLM riêng theo phiên bản đã nêu và đặt đường dẫn tuyệt đối. Các giá trị /absolute/path/... dưới đây là placeholder phải thay, không phải thư mục được tạo tự động:
export PLANNER_ENV=/absolute/path/to/vllm-env
export TRAIN_ENV=/absolute/path/to/training-env
cd "$AGENTICROBORL_DIR"
python rl/local_ctl.py eval \
  --config harnesses/rpent_libero/harness.yaml \
  --run-dir runs/rpent-rl-validation \
  --weights "$RL_WEIGHTS" --tag rl_validation \
  --init-key val_init_ids \
  --var gpu=0 --var model_port=18100 --var proxy_port=18200 \
  --var vla_port=18300 --var sam3_port=18400
Lệnh eval chạy inference của cả hệ thống: controller khởi động model server và service, sau đó planner tương tác với simulator. Đây không phải một HTTP request hỏi model mô tả kế hoạch bằng chữ. Report sẽ nằm dưới eval/rl_validation/report.json trong run directory.
Validation đầy đủ vẫn có thể tốn nhiều thời gian. Để thử một phần task, có thể thêm --shard 0/8; đây là một shard, không phải kết quả toàn benchmark. Dùng port và run directory khác khi chạy nhiều worker cùng lúc. Trước khi đánh giá hàng trăm episode, nên kiểm tra log một episode để xác nhận ảnh quan sát, tool call và verdict đều xuất hiện.
7. SFT: vì sao không sao chép nguyên hội thoại teacher?
Teacher của RPent là Qwen3.8-27B có external memory; student Qwen3.5-9B không truy cập memory đó. Một câu reasoning viện dẫn thông tin chỉ có trong memory sẽ thành target khó học đúng nếu student chưa từng nhận thông tin ấy. Pipeline dựng lại context theo cấu hình student, bỏ tool call memory và sửa phần reasoning phụ thuộc memory, trong khi giữ nguyên đối số tool call. Chi tiết nằm trong phần phương pháp SFT của paper.
Về mặt thực hành, teacher trajectories chưa được phát hành. Bạn có thể đọc sft/rpent/replay_build.py, teacher_rewrite/, sft/rpent/build_index.py và sft/rpent/train_fsdp.py, nhưng không thể tái tạo dataset gốc chỉ bằng tải repo. Đường bắt đầu khả dụng là dùng checkpoint SFT đã phát hành để tiếp tục RL. Nếu tự thu thập teacher data, hãy ghi rõ đó là dataset mới.
8. Tiếp tục multi-turn RL từ SFT
Một group gồm cùng task và initial state, chạy nhiều attempt. Với reward nhị phân, leave-one-out advantage so sánh một attempt với trung bình các attempt còn lại. Ví dụ tự tính dưới đây giúp hiểu tín hiệu học; nó không thay thế code trainer:
rewards = [1, 0, 1, 0, 0, 1]
advantages = []
for i, reward in enumerate(rewards):
    others = rewards[:i] + rewards[i + 1:]
    advantages.append(reward - sum(others) / len(others))
print(advantages)  # [0.6, -0.6, 0.6, -0.6, -0.6, 0.6]
Nếu tất cả attempt đều thành công hoặc đều thất bại, advantage bằng 0 và group không cung cấp policy gradient. Vì vậy, controller có thể dùng validation report để chọn task còn khả năng cải thiện. Với người mới, đây là cách hiểu vì sao việc thu thập thêm rollout không luôn đồng nghĩa có thêm dữ liệu học hữu ích.
Sau khi chuẩn bị môi trường training và đủ tài nguyên theo YAML, dùng checkpoint SFT và report validation của chính checkpoint SFT:
python rl/local_ctl.py eval \
  --config harnesses/rpent_libero/harness.yaml \
  --run-dir runs/rpent-sft --weights "$SFT_WEIGHTS" --tag sft_val \
  --init-key val_init_ids \
  --var gpu=0 --var model_port=18100 --var proxy_port=18200 \
  --var vla_port=18300 --var sam3_port=18400
python rl/local_ctl.py train \
  --config harnesses/rpent_libero/harness.yaml \
  --run-dir runs/rpent-training --weights "$SFT_WEIGHTS" \
  --rounds 6 --groups 64 \
  --pool-report runs/rpent-sft/eval/sft_val/report.json \
  --var gpu=0 --var model_port=18100 --var proxy_port=18200 \
  --var vla_port=18300 --var sam3_port=18400
Mỗi round mặc định có 64 group × 6 attempt, tức 384 episode trước các loại trừ. Có thể có tối đa 16 model call được chọn cho mỗi episode. Đọc cấu hình RPent gốc trước khi chạy: YAML hiện hành bật các bộ lọc độ dài và post-success, trong khi README ghi chúng được dùng từ round thứ sáu của thực nghiệm. Chạy sáu round bằng cấu hình hiện tại là một lần tiếp tục training hợp lệ, nhưng không tự động tái tạo chính xác toàn bộ lịch sử tạo v006.
Trainer dùng dual-clip PPO với learning rate 1e-6, global batch 128, hai ngưỡng clipping 0,2/0,28, dual clip 3,0 và truncated importance sampling cap 2,0. Cấu hình báo cáo không thêm KL penalty hoặc entropy bonus. Mỗi episode có trọng số được chia theo số lượt được chọn, tránh để episode dài lấn át chỉ vì có nhiều model call. Các giá trị này được ghi trong thiết lập RL của repo; không nên thay nhiều giá trị cùng lúc khi đang kiểm tra pipeline.
Để resume, chạy lại cùng lệnh với cùng run directory. Muốn dừng có kiểm soát, tạo file STOP trong run directory; controller kiểm tra giữa episode và phase. Đừng đổi checkpoint đầu vào của một run đang resume, vì state và policy version cần nhất quán.
9. Đọc kết quả và chẩn đoán lỗi
Theo bảng kết quả chính thức:
| Planner trong RPent | LIBERO-PRO | LIBERO-Plus |
|---|---|---|
| Qwen3.5-9B gốc | 18,1% | 19,2% |
| Sau SFT | 65,1% | 66,7% |
| Sau SFT + RL | 71,0% | 72,2% |
LIBERO-PRO gồm 800 episode; LIBERO-Plus gồm 10.030 cấu hình, dùng checkpoint đã train trên PRO mà không training thêm. RL tăng 5,9 điểm phần trăm trên PRO so với SFT. Phần cải thiện lớn nhất của cả quy trình đến từ SFT. Đừng diễn đạt thành RL đơn độc đưa model từ 18,1% lên 71,0%.
Giữ training initial states 11–44, validation 45–49 và evaluation 1–10 tách biệt theo protocol. Khi đo kết quả cuối, đổi sang --init-key eval_init_ids, dùng tag và run directory mới, và bao phủ đủ task thay vì chỉ một shard. Validation dùng để chọn checkpoint; evaluation dùng để báo cáo kết quả sau khi lựa chọn đã hoàn tất.
Nếu simulator không khởi tạo, kiểm tra EGL và các asset đã tải. Nếu planner không gọi tool, kiểm tra tool-call parser cùng đúng RPent patch. Nếu CUDA hết bộ nhớ, xem riêng log vLLM, SAM 3 và VLA; giảm mức concurrency tạo một cấu hình khác và phải ghi lại. Nếu training không tiến triển, kiểm tra group có reward khác nhau hay không, số mẫu hợp lệ và kiểm tra prompt-token matching trước khi thay learning rate.
Kết quả hiện có hỗ trợ việc học planner trong hai harness và môi trường mô phỏng được nghiên cứu. Nó chưa chứng minh thành công trên task hoàn toàn mới, robot khác hoặc deployment thời gian thực. Với người triển khai, bài học thực tế là đo tầng quyết định riêng với tầng thực thi: một executor giữ nguyên vẫn có thể trở nên hữu ích hơn khi planner học cách sử dụng nó.