Một robot có thể nhìn đúng chiếc cốc nhưng vẫn đưa tay sai khi gần chạm vật. Với Vision-Language-Action, hay VLA, nhận biết vật thể ở đầu mạng chưa bảo đảm thông tin đó còn ảnh hưởng đủ mạnh đến hành động ở cuối mạng. STAR — STeering Action Representations nghiên cứu khoảng cách này và đề xuất can thiệp ngay trong inference, giữ nguyên trọng số của policy.
Bài viết hướng dẫn nhánh mã được phát hành của STAR trên GitHub: OpenPI π0.5 trên LIBERO-PRO. Bạn sẽ hiểu cơ chế, dựng hai môi trường Python, chạy baseline, bật STAR và đọc kết quả. Không cần huấn luyện thêm để thử phương pháp với checkpoint tương thích đã có.
Nguồn được đối chiếu ngày 03/11/2026 gồm repository, project page và paper arXiv v1. Có khác biệt giữa số liệu và hyperparameter của các nguồn; phần kết quả sẽ tách rõ. Các con số dưới đây do tác giả công bố, không phải benchmark chúng tôi đã chạy lại.
1. Bạn cần biết gì trước khi bắt đầu?
VLA nhận ảnh, chỉ dẫn ngôn ngữ và trạng thái robot để sinh hành động. Trong π0.5, phần vision-language tạo biểu diễn đa phương thức; action expert dùng flow matching để sinh một action chunk, tức chuỗi nhiều hành động tương lai. Bộ điều khiển thực hiện một phần chuỗi, chụp observation mới rồi lập kế hoạch lại.
Proprioception là thông tin về chính robot, chẳng hạn vị trí và hướng end-effector cùng trạng thái gripper. Nó khác ảnh camera: camera cho biết robot đang nhìn thấy gì; proprioception cho biết robot đang ở tư thế nào và vừa di chuyển ra sao.
LIBERO-PRO kiểm tra khả năng tổng quát hóa khi thay đổi câu lệnh, thuộc tính vật thể, vị trí, mục tiêu nhiệm vụ hoặc bối cảnh. Đừng nhầm điểm LIBERO gốc với LIBERO-PRO. Một checkpoint làm tốt cảnh quen thuộc vẫn có thể suy giảm mạnh khi vị trí và mục tiêu thay đổi.
Mục tiêu hợp lý cho lần đầu là hoàn thành một episode ở cả native inference và STAR. Sau đó mới chạy đủ năm split. Bạn cần Linux, NVIDIA GPU, driver tương thích CUDA và dung lượng để tải checkpoint. README ghi ước lượng upstream cho inference là hơn 8 GB VRAM, với môi trường đã thử là Ubuntu 22.04. Đây không phải cam kết mọi GPU 8 GB sẽ chạy được.
Chi phí cần tính trước là GPU cho inference, thời gian tải weights và hàng nghìn rollout nếu đánh giá đầy đủ. Chưa cần thuê tài nguyên cho fine-tuning khi mục tiêu chỉ là kiểm tra STAR.
2. Ý tưởng paper: thông tin vật thể bị suy yếu ở đâu?
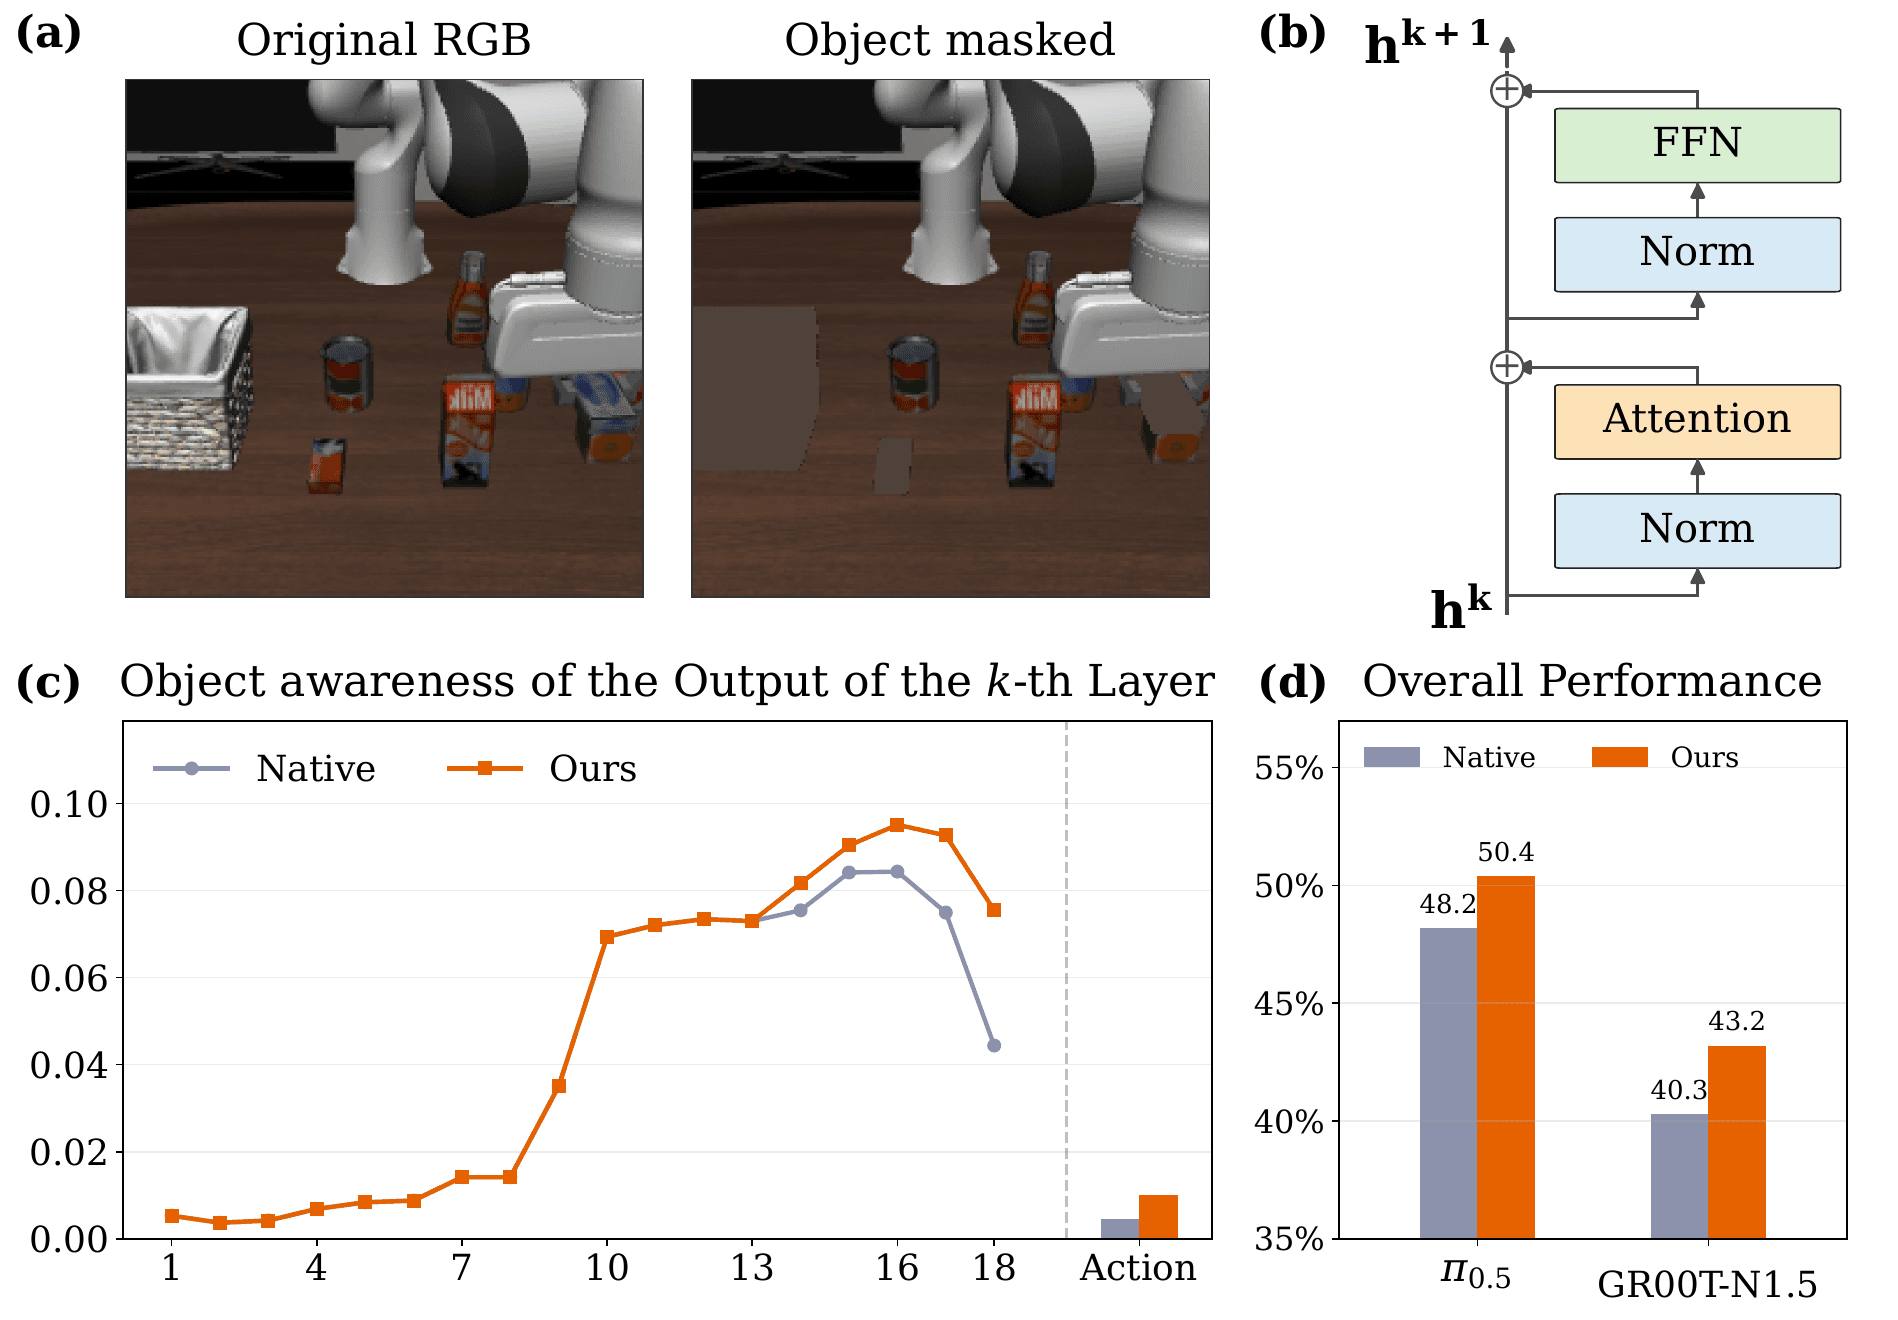
Tác giả thực hiện một phép thử đơn giản về mặt ý tưởng: lấy cùng observation, tạo thêm phiên bản mà vùng vật thể quan trọng bị thay bằng màu RGB trung bình của ảnh. Sau đó so sánh action hidden states giữa ảnh gốc và ảnh đã che ở từng lớp.
Nếu biểu diễn hành động phụ thuộc vào vật thể đó, việc xóa thông tin vật thể sẽ làm biểu diễn thay đổi. Paper dùng độ chênh L2 được chuẩn hóa làm chỉ số object awareness. Với π0.5 được kiểm tra, độ nhạy này tăng ở các lớp đầu đến giữa rồi giảm ở các lớp cuối. Đây là bằng chứng thực nghiệm về late-layer grounding gap, chưa phải định lý áp dụng cho mọi VLA.
STAR giữ lại xu hướng residual update từ các lớp trước trong vùng can thiệp. Có thể hình dung mỗi lớp đang đề xuất một bước chỉnh sửa cho biểu diễn. Thay vì nhận toàn bộ đề xuất mới ngay lập tức, STAR kết hợp nó với xu hướng chỉnh sửa tích lũy từ các lớp trước đó.
Điểm quan trọng: phép che vật thể là công cụ phân tích của paper. Khi chạy STAR bình thường, bạn không phải cung cấp segmentation mask, detector hay nhãn vật thể cho từng frame.
3. Kiến trúc: EMA theo chiều sâu, điều chỉnh bằng chuyển động
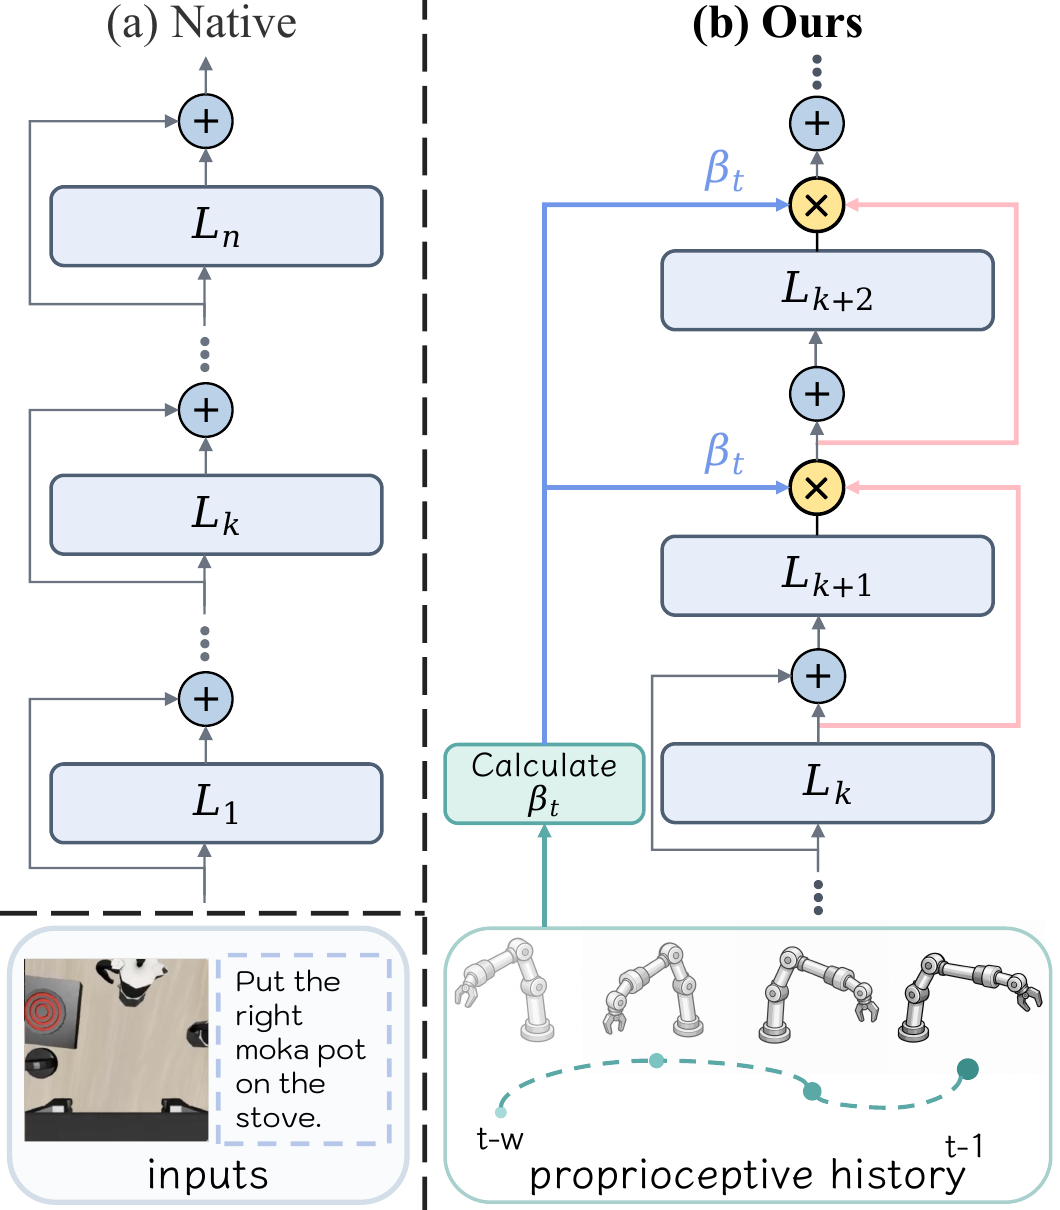
Một residual block thông thường nhận hidden state và cộng thêm một update. STAR thay update tại các lớp cuối bằng exponential moving average, viết gọn như sau:
delta_k = output_k - input_k
momentum_k = beta_t * momentum_previous_layer
             + (1 - beta_t) * delta_k
corrected_output_k = input_k + momentum_k
EMA ở đây chạy qua các lớp trong một forward pass, không phải bộ lọc làm mượt chuỗi lệnh motor theo thời gian. Momentum của residual và lịch sử proprioception là hai loại trạng thái khác nhau. Không nên tự thay cơ chế này bằng cách lấy trung bình các action đầu ra rồi gọi đó là STAR.
Thiết kế chung trong paper giữ nguyên hai phần ba số lớp đầu và trộn residual ở phần ba cuối. Recipe π0.5 được phát hành chỉ rõ sáu lớp cuối của action expert. Mã controller warm-start momentum bằng delta của lớp can thiệp đầu tiên; vì vậy update đầu tiên trong vùng này vẫn bằng update gốc, tránh khởi đầu với một vector zero làm giảm biên độ ngoài ý muốn. Có thể kiểm tra tại controller_core_v2.py.
Hệ số beta_t quyết định mức giữ xu hướng từ lớp trước. Beta lớn hơn giữ nhiều momentum hơn. Beta nhỏ hơn để update hiện tại đóng vai trò lớn hơn, phù hợp lúc robot đổi hướng, xoay cổ tay hoặc tinh chỉnh gần tiếp xúc.
Bốn tín hiệu cho scheduler
| Tín hiệu | Cách hiểu | Vai trò trong recipe README |
|---|---|---|
c_t |
Cosine giữa hai displacement liên tiếp | Chuyển động cùng hướng ủng hộ trộn mạnh |
v_t |
Độ lớn displacement end-effector | Chuyển động tịnh tiến đóng góp dương |
j_t |
Độ chênh giữa hai displacement | Thay đổi đột ngột đóng góp âm |
w_t |
Mức thay đổi orientation | Xoay nhiều đóng góp âm |
Tên j_t có thể khiến người đọc nghĩ đến jerk vật lý. Công thức phát hành thực tế là độ lớn sai phân displacement, một đại lượng giống thay đổi gia tốc theo cách mô tả của paper; không nên diễn giải nó thành jerk với đơn vị vật lý đã chuẩn hóa theo thời gian.
Scheduler chuẩn hóa các tín hiệu bằng lịch sử quá khứ, cộng chúng theo trọng số rồi chuẩn hóa score bằng median và interquartile range. Cuối cùng sigmoid ánh xạ score vào khoảng beta. Trong scheduler.py, các giá trị chuẩn hóa riêng còn được clip; khi chưa đủ lịch sử, chúng có cơ chế fallback. Thuật toán không đọc trajectory tương lai và không cần oracle cho biết nhiệm vụ đang ở pha nào.
4. Cài policy server π0.5
Các lệnh dưới đây dành cho máy của bạn. Cài uv theo tài liệu chính thức và kiểm tra nvidia-smi trước. Nếu driver chưa nhìn thấy GPU, hãy sửa môi trường GPU trước khi cài model.
git clone --recurse-submodules https://github.com/PKU-VaLuE-Lab/STAR.git
cd STAR
GIT_LFS_SKIP_SMUDGE=1 uv sync
GIT_LFS_SKIP_SMUDGE=1 uv pip install -e .
Đây là recipe trong README. Biến GIT_LFS_SKIP_SMUDGE=1 liên quan dependency LeRobot; không nên bỏ đi chỉ vì không dùng robot thật. Project server yêu cầu Python 3.11 trở lên theo pyproject.toml, trong khi evaluator LIBERO kế thừa bộ dependency Python 3.8. Vì vậy đừng cài tất cả vào một môi trường.
Ở terminal dành cho server, giữ working directory tại gốc STAR và dùng uv run. Lần chạy đầu có thể tải checkpoint hoặc compile JAX, nên thời gian khởi động chưa đại diện cho latency ổn định.
uv run scripts/serve_policy.py \
  --env LIBERO \
  --inference-mode NATIVE
Với --env LIBERO, server chọn config pi05_libero và weights công khai tại gs://openpi-assets/checkpoints/pi05_libero. Checkpoint không nằm sẵn trong repo. Native và STAR phải dùng cùng checkpoint, transforms và normalization statistics để phép so sánh có ý nghĩa.
5. Cài evaluator LIBERO-PRO và dữ liệu task
Mở terminal khác tại gốc STAR. Ví dụ sau điều chỉnh recipe evaluator trong repo để cài LIBERO-PRO, thay vì chỉ cài submodule LIBERO gốc:
git clone https://github.com/Zxy-MLlab/LIBERO-PRO.git ../LIBERO-PRO
uv venv --python 3.8 examples/libero/.venv
source examples/libero/.venv/bin/activate
uv pip sync examples/libero/requirements.txt \
  third_party/libero/requirements.txt \
  --extra-index-url https://download.pytorch.org/whl/cu113 \
  --index-strategy=unsafe-best-match
uv pip install -e packages/openpi-client
uv pip install --no-deps -e ../LIBERO-PRO
export PYTHONPATH="$PWD/../LIBERO-PRO${PYTHONPATH:+:$PYTHONPATH}"
Recipe điều chỉnh này giữ bộ dependency evaluator của STAR, rồi cài mã LIBERO-PRO bằng --no-deps. Lý do là requirements LIBERO-PRO ghim robosuite==1.4.0, còn evaluator STAR ghim 1.4.1; ghép trực tiếp hai bộ requirements sẽ xung đột. Đây là bước tích hợp cần kiểm chứng bằng smoke test, không phải môi trường chúng tôi đã chạy benchmark lại. Không chuyển các dependency torch cũ của evaluator sang môi trường server. Đối chiếu hướng dẫn evaluator STAR với hướng dẫn LIBERO-PRO khi xử lý lỗi. Hai môi trường giao tiếp qua WebSocket nên không cần dùng cùng phiên bản torch.
Tiếp theo, tải bddl_files và init_files từ dataset LIBERO-PRO chính thức. BDDL mô tả task và điều kiện thành công; init files cung cấp trạng thái khởi tạo. Theo cấu trúc upstream, dữ liệu phải nằm trong libero/libero/bddl_files/ và libero/libero/init_files/ của checkout LIBERO-PRO. Ví dụ nếu đã tải về thư mục libero_data ở gốc STAR:
cp -a libero_data/bddl_files/. ../LIBERO-PRO/libero/libero/bddl_files/
cp -a libero_data/init_files/. ../LIBERO-PRO/libero/libero/init_files/
Kiểm tra đường dẫn cấu hình LIBERO nếu lần import đầu yêu cầu thiết lập. Đừng trỏ nhầm sang dữ liệu của checkout LIBERO gốc. Sau đó xác nhận Python import đúng package và có đủ suite:
python - <<'PY'
import libero
from libero.libero import benchmark
print("Package:", libero.__file__)
required = {
    "libero_10_lan", "libero_10_object", "libero_10_swap",
    "libero_10_task", "libero_10_env",
}
registered = benchmark.get_benchmark_dict()
missing = required.difference(registered)
assert not missing, f"Missing suites: {sorted(missing)}"
print("All five LIBERO-PRO suites are registered")
PY
Đăng ký suite thành công mới kiểm tra được phần registry. Nếu thiếu BDDL hoặc initial states, rollout vẫn sẽ lỗi. Cần kiểm tra cả việc tạo task và nạp dữ liệu trong smoke test tiếp theo.
6. Chạy smoke test, sau đó bật STAR
Khi native server đang nghe cổng 8000, chạy trong terminal evaluator:
MUJOCO_GL=egl python examples/libero/main.py \
  --args.task-suite-name libero_10_lan \
  --args.host 127.0.0.1 \
  --args.port 8000 \
  --args.env-control-hz 10 \
  --args.replan-steps 5 \
  --args.max-tasks 1 \
  --args.num-trials-per-task 1 \
  --args.video-out-path data/libero/native-smoke
Một episode giúp phát hiện lỗi import, rendering, checkpoint và kết nối. Thành công hay thất bại của một episode chưa cho biết phương pháp nào tốt hơn. Nếu EGL lỗi, xem hướng dẫn GLX trong repo; GLX cần display phù hợp, không phải cách sửa tự động cho mọi server headless.
Dừng native server bằng Ctrl+C, rồi khởi động STAR trong terminal server bằng recipe README:
uv run scripts/serve_policy.py \
  --env LIBERO \
  --inference-mode STAR \
  --star.beta-min 0.25 \
  --star.beta-max 0.55 \
  --star.beta-kappa 4.25 \
  --star.phase-coeff-c 1.0 \
  --star.phase-coeff-v 1.0 \
  --star.phase-coeff-j -0.375 \
  --star.phase-coeff-w -2.0 \
  --star.correction-last-n-layers 6 \
  --star-env-control-hz 10 \
  --star-replan-steps 5
Chạy lại smoke test, đổi output path thành data/libero/star-smoke. Tránh chỉ bật --inference-mode STAR rồi tưởng đã dùng đủ cấu hình: default của một số tham số trong script khác recipe README.
Tần số môi trường là 10 Hz, còn policy replan sau năm action. Vì vậy tần số gọi inference danh nghĩa là 2 Hz, chưa tính độ trễ tính toán. Client gửi lịch sử trạng thái của các bước đã thực hiện để scheduler không bỏ mất chuyển động giữa hai lần replan. Đừng đổi một bên thành 20 Hz mà quên cập nhật bên còn lại. Giữ reset policy mỗi episode để lịch sử của lần thử trước không ảnh hưởng lần sau.
Với checkpoint cục bộ, README hỗ trợ subcommand policy:checkpoint, cùng --policy.config pi05_libero và --policy.dir /path/to/checkpoint. Thư mục cần cả params/ lẫn assets/ tương thích; chỉ có weights mà thiếu normalization assets chưa đủ.
7. Training: bước nào thực sự cần thiết?
Không có bước training STAR trong quy trình trên. Không optimizer, không backward pass và không cập nhật weights. Bạn đang thay cách lan truyền residual trong một policy đã học. Tuy nhiên, “training-free” không có nghĩa π0.5 chưa từng được huấn luyện: checkpoint LIBERO đã được chuẩn bị trước.
Trong thí nghiệm robot thật của paper, nhóm thu thập 100 episodes và fine-tune π0.5 15.000 steps, rồi so native với STAR trên cùng checkpoint đó. Phần fine-tuning là công việc chuẩn bị backbone cho nhiệm vụ pear-to-bowl; STAR chỉ được bật ở inference. Repo hiện chưa phát hành implementation robot thật, OpenVLA, GR00T-N1.5 hoặc SimplerEnv, nên không thể lấy hướng dẫn LIBERO này làm recipe tái lập đầy đủ các thí nghiệm ấy.
Nếu muốn chuyển sang robot riêng, trước tiên cần pipeline observation, action convention và checkpoint chạy native ổn định trên robot đó. Sau đó mới đánh giá residual steering. STAR không thay thế thu thập demonstration hoặc adaptation khi policy nền chưa biết nhiệm vụ.
8. Kết quả: phân biệt README và paper v1
Tại thời điểm đối chiếu, project page và README công bố π0.5 tăng từ 48,2% lên 50,4%, tức 2,2 điểm phần trăm. Bảng chi tiết trên project page như sau:
| Split LIBERO-PRO | Native | STAR trên project page |
|---|---|---|
| Language | 92,8% | 92,8% |
| Object | 66,2% | 68,6% |
| Swap | 9,2% | 13,0% |
| Task | 6,8% | 7,6% |
| Environment | 65,8% | 70,2% |
| Trung bình | 48,2% | 50,4% |
Nhưng Table 2 của bản HTML arXiv v1 ghi STAR lần lượt 92,6 / 67,0 / 7,2 / 18,8 / 65,0, trung bình 50,1%. Appendix B cũng khác README: cấu hình π0.5 ghi c=0.25, v=1.0, j=-0.125, w=-0.25, kappa=2.30; README dùng 1.0, 1.0, -0.375, -2.0, 4.25. Khoảng beta vẫn là 0.25–0.55.
Không có đủ thông tin công khai để quy kết khác biệt này cho một nguyên nhân cụ thể. Vì thế, bài dùng recipe README cho thực hành và ghi riêng số liệu từng nguồn. Khi báo cáo tái lập, hãy lưu phiên bản mã, nguồn cấu hình và toàn bộ tham số thay vì chỉ ghi “STAR theo paper”.
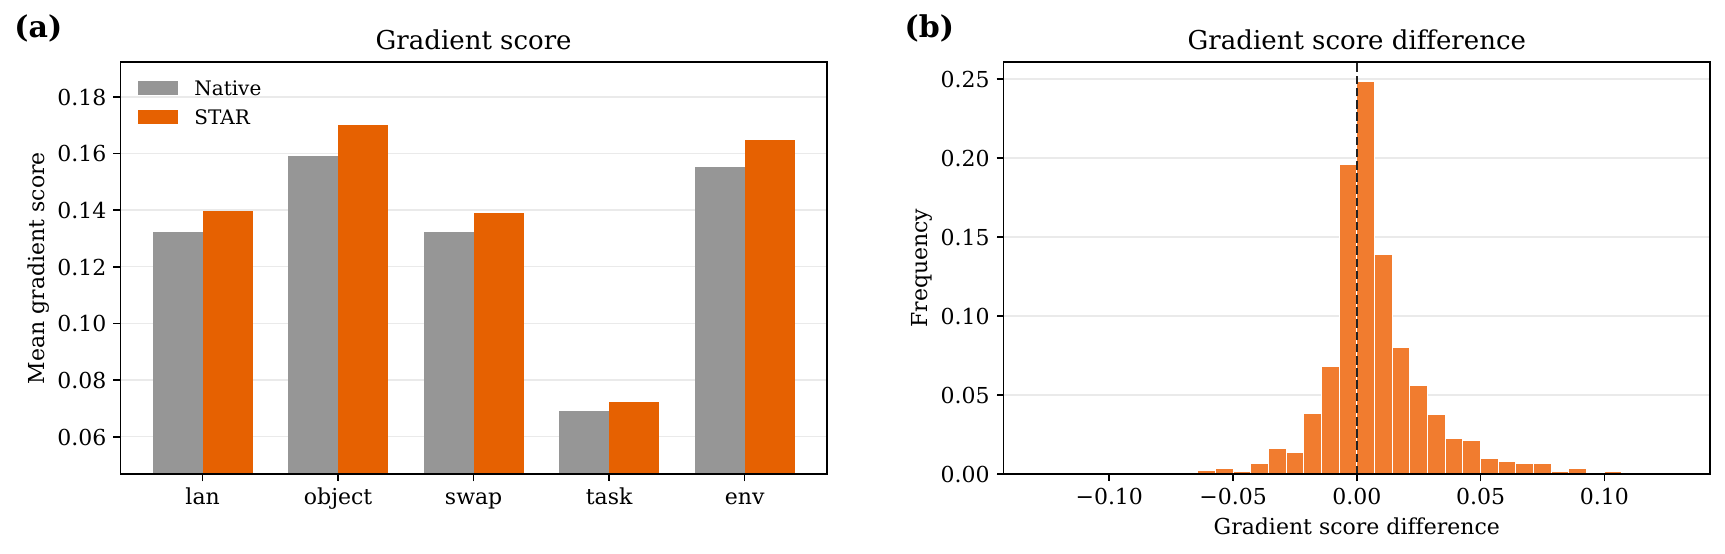
Project còn phân tích input-gradient saliency để kiểm tra ảnh hưởng của pixel vật thể lên action cuối. Attention map có thể gần như giữ nguyên dù hidden states thay đổi; do đó không nên chỉ nhìn heatmap attention để kết luận STAR không tác dụng. Đồng thời, saliency tốt hơn không tự động chứng minh từng task đều thành công hơn.
Các mốc khác tác giả công bố: GR00T-N1.5 trên LIBERO-PRO 40,3% → 43,2%; trên SimplerEnv, GR00T-N1.5 41,0% → 46,3%, OpenVLA 30,3% → 36,0%. Robot thật đạt 17/40 → 19/40 lần thành công. Overhead latency 3,3% được đo trên hệ robot thật với RTX 3090; không nên gán con số đó cho mọi máy chạy LIBERO.
9. Đánh giá công bằng và xử lý lỗi
Sau smoke test, bỏ --args.max-tasks 1, đặt --args.num-trials-per-task 50 và --args.seed 7, rồi chạy lần lượt năm suite. Protocol π0.5 trong paper gồm 10 task mỗi split, 50 episodes mỗi task: 2.500 episodes cho mỗi phương pháp, tổng 5.000 nếu so native và STAR đầy đủ.
Giữ cùng initial states, camera preprocessing, action horizon và điều kiện rendering. Tách thư mục video cho từng mode và suite. Đọc log để phân biệt task thất bại thật với episode bị exception. Một batch dừng sớm không tương đương một benchmark đã hoàn thành.
Nếu mất kết nối, kiểm tra server đã khởi động xong và host/port khớp. Nếu thiếu suite, xem libero.__file__ để phát hiện import nhầm LIBERO gốc. Nếu rollout báo thiếu file, kiểm tra dataset và đường dẫn cấu hình. Nếu GPU hết bộ nhớ, kiểm tra tiến trình khác và yêu cầu thực tế của checkpoint trước khi đổi thuật toán.
Cuối cùng, STAR cần truy cập hidden states bên trong transformer; API black-box chỉ trả action không đủ. Tín hiệu scheduler hiện tập trung vào một end-effector. Việc mở rộng sang whole-body hoặc bimanual control cần nghiên cứu riêng, dù cả hai đều thuộc hệ sinh thái VLA. Kết quả đáng tin cậy nhất bạn có thể tự tạo là một so sánh native–STAR có cùng checkpoint, protocol rõ ràng và log đủ để kiểm tra lại.