Không có camera cổ tay, robot lấy chi tiết ở đâu?
Một cánh tay robot nhìn toàn bộ bàn qua camera ngoài thường biết chiếc bát nằm ở đâu, nhưng chưa chắc nhìn rõ đầu bút giữa hai ngón kẹp. Nguyên nhân không chỉ nằm ở camera: ảnh gốc có thể đạt 1280×720 pixel, trong khi policy chỉ nhận phiên bản 224×224. Sau resize, vùng tiếp xúc giữa gripper và vật thể chỉ còn vài pixel. Camera cổ tay giải quyết bằng cách đưa cảm biến đến gần vật, nhưng góc nhìn đó lại gắn với chuyển động của bàn tay và có thể bỏ lỡ đích đặt ở xa.
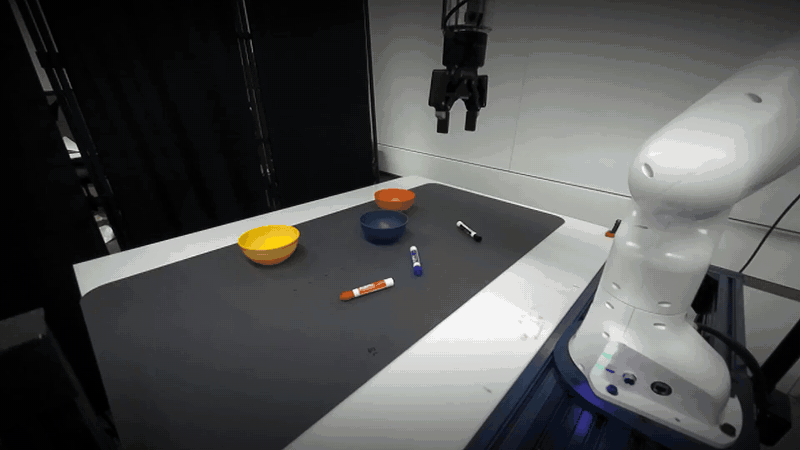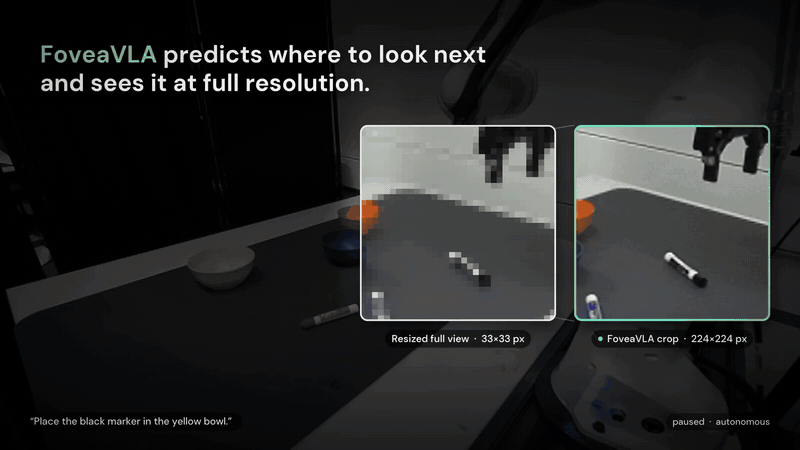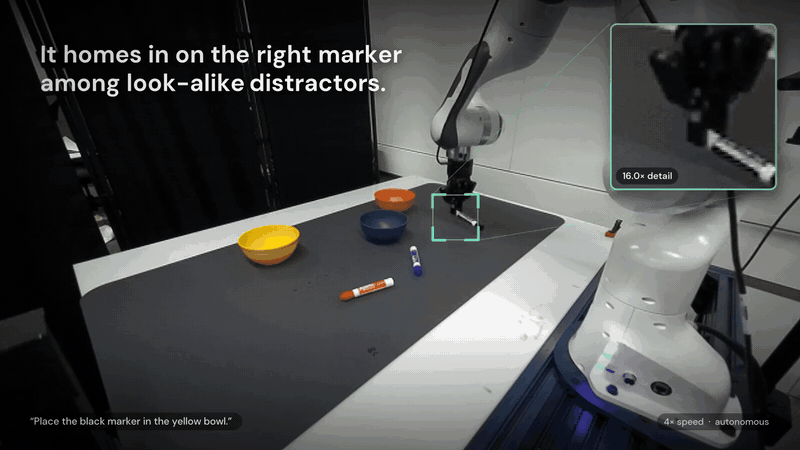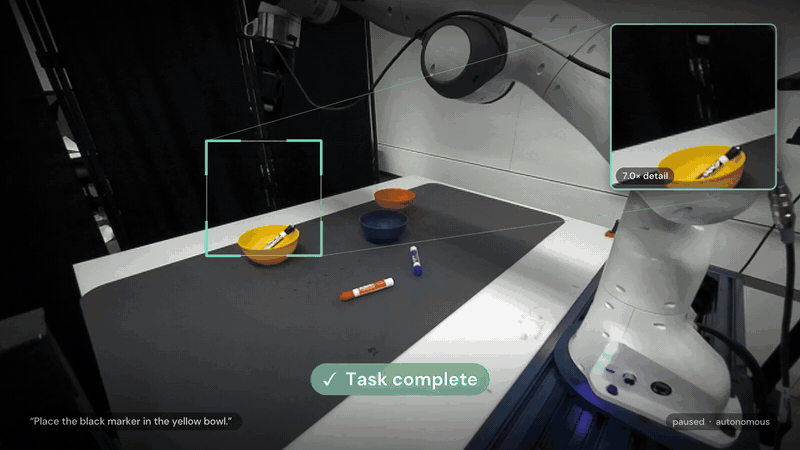
FoveaVLA: Foveation Actions Replace the Wrist Camera in VLAs, của Bingao Chen, Lihan Zha, C. Karen Liu và Guy Tevet, là preprint năm 2026 đề xuất một lựa chọn khác: policy học cả cách hành động lẫn vùng cần quan sát ở lần truy vấn tiếp theo. Vùng đó được crop trực tiếp từ ảnh camera ngoài ở độ phân giải gốc, rồi đưa vào model cùng ảnh toàn cảnh.
Repo Stanford-TML/FoveaVLA công khai code, checkpoint, pipeline chuẩn bị dữ liệu và hướng dẫn chạy robot thật. Bài này đi từ nguyên lý đến inference bằng checkpoint, sau đó giải thích cách tái lập post-training. Các lệnh bên dưới được đối chiếu với tài liệu repo tại thời điểm viết; đây không phải báo cáo đã chạy thử trên phần cứng của vnrobo.
Nếu chưa quen observation, action và demonstration, bạn có thể đọc hướng dẫn thực hành LeRobot trước. FoveaVLA dùng stack OpenPI/DROID riêng; hiểu LeRobot giúp đọc khái niệm, nhưng không có nghĩa checkpoint này chạy trực tiếp trên mọi robot được LeRobot hỗ trợ.
1. Hiểu đúng chữ “không cần camera cổ tay”
FoveaVLA không biến một webcam thường thành hệ thống manipulation hoàn chỉnh. Cấu hình công bố vẫn cần camera stereo ZED bên ngoài, ảnh RGB, metric depth, robot state và GPU chạy policy. Single dùng một camera ZED ngoài; Dual dùng hai camera ZED ngoài. Mỗi thiết bị stereo có hai mắt ảnh để suy ra depth, vì vậy “Single” không đồng nghĩa “monocular RGB”.
Trong triển khai được hướng dẫn, robot là Franka/DROID. Một hệ SO-101, một robot công nghiệp khác hoặc một humanoid sẽ cần adapter cho observation, action space, normalization và thường cả dữ liệu fine-tuning. Không nên tải checkpoint rồi gửi thẳng output vào bộ điều khiển khác.
| Thành phần | FoveaVLA-Single | FoveaVLA-Dual |
|---|---|---|
| Camera ngoài | Một ZED stereo | Hai ZED stereo |
| Camera cổ tay | Không dùng | Không dùng |
| Input mỗi góc nhìn | Full RGB, crop RGB, full depth, crop depth | Giống Single |
| Tổng luồng ảnh vào model | Bốn | Tám |
| Config | foveavla_single |
foveavla_dual |
Nếu mục tiêu là làm quen pipeline, hãy bắt đầu từ Single và checkpoint có sẵn. Bạn sẽ kiểm tra ít luồng camera hơn và chưa cần tải toàn bộ DROID. Training đầy đủ là một dự án dữ liệu nhiều TB, không phải điều kiện để chạy inference.
2. Foveation: crop ảnh gốc thay vì phóng to ảnh đã mờ
Hãy tưởng tượng bạn cần đọc nhãn trên một linh kiện trong ảnh chụp cả bàn. Phóng to bản thumbnail không khôi phục chữ đã mất. Cách đúng là quay lại ảnh gốc, cắt vùng chứa nhãn, rồi dùng vùng đó làm input riêng. FoveaVLA áp dụng nguyên tắc tương tự cho robot.
Full view giữ vị trí tương đối giữa các vật. Foveal crop dành nhiều pixel hơn cho vùng tương tác, có thể bao gồm gripper, vật cần gắp và vùng đích. Crop được chuẩn hóa về 224×224 để dùng cùng visual encoder. Nó không tạo góc nhìn mới và không nhìn xuyên vật che khuất; chi tiết phải tồn tại trong ảnh gốc.
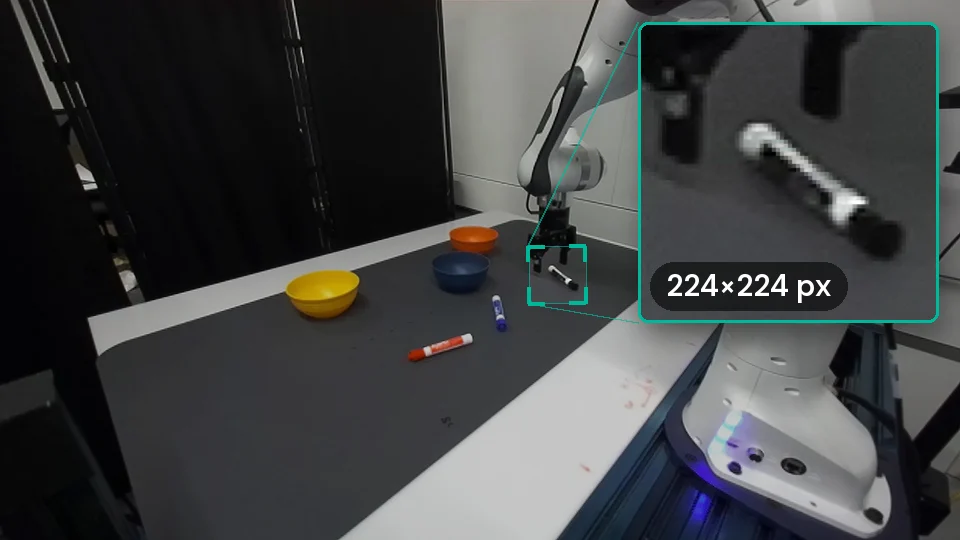
Hình từ project minh họa cách giữ cả bối cảnh lẫn chi tiết cục bộ. Điểm cần chú ý là vùng crop không bị cố định quanh bàn tay. Khi nhiệm vụ chuyển từ tiếp cận vật sang đưa vật tới bát, vùng hữu ích cũng có thể đổi theo.
Ở cấu hình paper, ảnh 224×224 tạo lưới 16×16 visual patch tokens. Một vật nhỏ trong toàn cảnh có thể chỉ chiếm vài token, trong khi crop dành phần lớn lưới cho vùng đó. Đây là phân bổ lại độ phân giải quan sát, không phải tăng độ phân giải của tất cả input lên ảnh gốc.
3. Kiến trúc: một observation, hai nhánh output
FoveaVLA xây trên π0.5, giữ backbone PaliGemma với SigLIP visual encoder và Gemma language model. Một action expert riêng sinh action liên tục bằng flow matching. Phần bổ sung quan trọng là dùng language-model output head để sinh bounding box thông qua location tokens đã có trong vocabulary của PaliGemma.
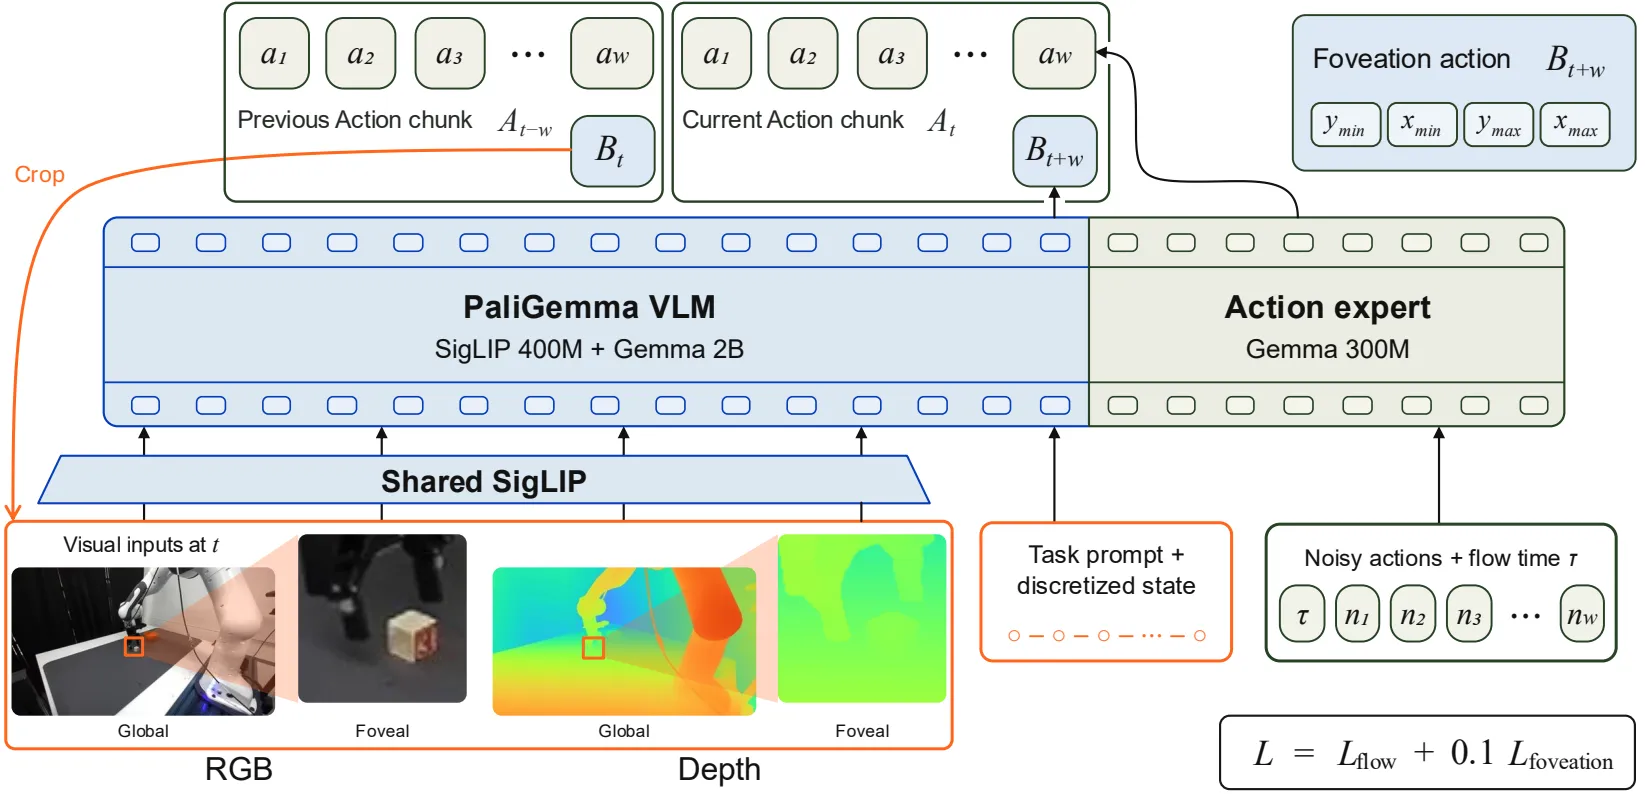
Một observation gồm joint positions, gripper state, các luồng RGB-D và task instruction. Tất cả tạo shared input prefix. Từ đó:
- Action expert dự đoán một action chunk gồm 16 actions.
- Language-model head dự đoán bounding box cho 8 control steps sau.
- Controller chỉ thực thi 8 actions đầu, rồi lấy observation mới.
- Bounding box vừa dự đoán được áp lên ảnh mới để tạo crop cho lần truy vấn kế tiếp.
Box có thứ tự tọa độ (y_min, x_min, y_max, x_max), mỗi tọa độ được lượng tử hóa thành 1.024 bins trên full view đã resize và padding. Single sinh bốn location tokens; Dual sinh tám, với camera trái vật lý đi trước camera phải vật lý. Đảo thứ tự hai camera hoặc dùng thứ tự tọa độ quen thuộc từ một object detector khác có thể làm pipeline sai dù kích thước tensor vẫn hợp lệ.
Hai nhánh output dùng chung observation nhưng được mask khỏi nhau. Action chunk được trả trước; box tokens được decode từ cached prefix trong khi robot thực thi chunk. Nhờ vậy bước chọn vùng nhìn không phải đợi ảnh tiếp theo mới bắt đầu chạy detector. Điều này không có nghĩa inference hoặc depth estimation có latency bằng không.
Lần truy vấn đầu chưa có box dự đoán, nên full view được dùng làm foveal input. Nếu box không hợp lệ, implementation dùng lại box hợp lệ gần nhất của góc nhìn đó, hoặc full view nếu chưa có. Full view luôn quan trọng để robot không mất bối cảnh khi crop chưa tốt.
4. Depth đóng vai trò gì?
Một ảnh crop rõ cho biết ngón kẹp đang ở cạnh vật, nhưng ảnh 2D vẫn có thể mơ hồ về khoảng cách theo chiều sâu. Repo sử dụng Fast-FoundationStereo để ước lượng disparity từ cặp ảnh stereo đã rectification, rồi chuyển sang metric depth bằng focal length và stereo baseline.
Depth và RGB phải cùng hình học: crop RGB ở đâu thì crop depth tương ứng ở đó. Paper mã hóa depth bằng thang logarithmic cố định trong khoảng tham chiếu 0,2–3,0 m và color map để đưa qua visual encoder. Patch có quá ít depth hợp lệ bị mask. Không nên tự normalize depth theo min/max riêng của từng frame, vì như vậy cùng một màu sẽ mang khoảng cách vật lý khác nhau theo thời gian.
Paper không yêu cầu extrinsic calibration camera ngoài sang robot trong protocol benchmark. Tuy nhiên, điều đó không loại bỏ stereo calibration: pipeline tính metric depth vẫn cần thông số camera, đặc biệt baseline và intrinsics. Đây là hai loại calibration khác nhau mà người mới dễ nhầm.
5. Cài môi trường policy server
Theo hướng dẫn cài đặt chính thức, chuẩn bị Linux, Python 3.11, NVIDIA GPU và uv. Môi trường server cần khoảng 8 GB ổ đĩa, mỗi checkpoint khoảng 12,4 GB, còn serving model dùng khoảng 13 GB GPU memory. Cần chừa thêm dung lượng cho cache và runtime; con số inference này không phải yêu cầu VRAM cho training.
Chạy các lệnh sau trong terminal trên GPU server:
git clone https://github.com/Stanford-TML/FoveaVLA.git
cd FoveaVLA
uv venv --python 3.11
uv sync --locked
scripts/setup_fast_foundation_depth.sh
uv sync --locked cài dependency theo lockfile của dự án. Script cuối chuẩn bị stack depth mà inference cần. Hãy đọc lỗi đầu tiên nếu installation thất bại, thay vì nâng hàng loạt package lên bản mới rồi tiếp tục: các môi trường robotics thường nhạy với phiên bản CUDA, Python và SDK.
Tải và serve Single:
MODEL=foveavla_single
uv run scripts/download_checkpoint.py --model="$MODEL"
XLA_PYTHON_CLIENT_MEM_FRACTION=0.70 \
  uv run scripts/serve.py --model="$MODEL"
Checkpoint mặc định nằm ở checkpoints/foveavla_single; server dùng port 8000. Biến XLA_PYTHON_CLIENT_MEM_FRACTION điều chỉnh phần bộ nhớ GPU cho XLA; nó không làm model nhỏ đi. Nếu có tiến trình khác chiếm GPU, kiểm tra bằng nvidia-smi trước khi kết luận checkpoint hỏng.
Để chạy Dual, đổi MODEL=foveavla_dual rồi tải checkpoint tương ứng. Server và client phải chọn cùng biến thể; thêm camera thứ hai ở client không tự chuyển Single thành Dual.
6. Cài robot client riêng với Python 3.10
Deployment guide tách môi trường robot client khỏi policy server. Client dùng Python 3.10, ZED SDK 5.1.2, Python API của ZED và DROID. Hai môi trường có thể nằm trên cùng workstation, nhưng không trộn dependency của chúng.
Trước hết hoàn thành DROID host setup, bao gồm Franka, NUC, workstation và cấu hình IP, robot type, serial trong droid/misc/parameters.py. Riêng checkout DROID và Python environment phải theo phiên bản repo FoveaVLA đã thử nghiệm:
# Chạy từ thư mục gốc FoveaVLA.
git clone https://github.com/droid-dataset/droid.git .runtime/droid
git -C .runtime/droid checkout 33ae6a67274f36d2e29525b86f23a56616ef43a7
git -C .runtime/droid submodule update --init --recursive
conda create -n foveavla_droid python=3.10
conda activate foveavla_droid
Sau khi cài ZED SDK 5.1.2, Python API và các dependency còn lại theo DROID guide, chạy:
scripts/setup_droid_client_env.sh
Script cài client, pin numpy<2 để tương thích OpenCV của DROID và áp các patch được repo cung cấp. Script từ chối checkout sai commit hoặc môi trường đang import DROID từ vị trí khác. Nếu gặp lỗi này, kiểm tra môi trường đang activate và đường dẫn import; bỏ qua kiểm tra phiên bản sẽ làm việc debug khó hơn.
7. Chạy inference và đọc debug rollout
Xác nhận robot có thể reset bằng DROID, camera đúng serial, GPU server đã sẵn sàng và workstation truy cập được port 8000. Dọn workspace cho lượt thử đầu, chuẩn bị emergency stop; lệnh client bên dưới sẽ reset robot rồi bắt đầu chuyển động.
LD_LIBRARY_PATH=/usr/local/zed/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH} \
  python examples/droid/main.py \
  --left-camera-id=YOUR_LEFT_ZED_SERIAL \
  --instruction="Place the blue block in the box" \
  --remote-host=SERVER_IP --remote-port=8000 \
  --debug
Thay YOUR_LEFT_ZED_SERIAL bằng serial thực và SERVER_IP bằng địa chỉ GPU server. Với Dual, thêm --right-camera-id=YOUR_RIGHT_ZED_SERIAL, theo thứ tự trái vật lý rồi phải vật lý. Dùng instruction rõ vật và đích; đừng bắt đầu bằng cảnh quá nhiều vật giống nhau.
Ctrl+C dừng client. Debug mặc định ghi vào outputs/rollouts/, gồm rollout.mp4, thư mục crops/ và queries.jsonl. Video ghi một frame cho mỗi policy query, không phải mọi control step. Bạn có thể nhìn full view, box, crop, depth, gripper state và timing để xác định lỗi thuộc perception hay control.
Nếu robot chọn sai vật, xem crop có chứa đúng màu hoặc đặc điểm phân biệt không. Nếu chọn đúng nhưng thường xuyên gắp hụt, kiểm tra depth alignment và calibration trước. Nếu chunk bị khựng, xem timing và kết nối mạng. Client còn có --max-timesteps mặc định 900 và --gripper-timeout-s mặc định 2,0 giây; tăng timeout không sửa được một gripper không phản hồi.
8. Chuẩn bị dữ liệu để post-training
Phần này dành cho người muốn tái lập phương pháp, không cần làm nếu chỉ dùng pretrained checkpoint. Theo data preparation guide, dữ liệu gồm DROID RLDS 1.0.1, raw DROID có metadata, trajectory, MP4/SVO của camera ngoài, RoboInter annotations và bộ lọc non-idle của OpenPI. Hãy dự trù nhiều TB cho nguồn dữ liệu và thêm dung lượng cho crop/depth.
RoboInter cung cấp thông tin các thành phần liên quan tới primitive skill. Pipeline tạo rectangle nhỏ nhất bao quanh thành phần cần thiết, ví dụ gripper, vật thao tác và vùng đích. Nó ghép observation tại thời điểm hiện tại với box ở t+8 làm supervision. Đây là học vùng tương tác tương lai từ demonstration, không phải chạy object detector ngẫu nhiên để lấy một nhãn gần đúng.
Thực hiện download và bước chọn complete episodes trong mục 1–2 của data guide trước. Bước chọn này tạo data/keys_foveavla_single.txt, kiểm tra các view và SVO cần thiết; chỉ có RLDS là chưa đủ. Sau đó, trong môi trường server Python 3.11:
uv sync --locked --group rlds
MODEL=foveavla_single
PREPARED_DIR="data/processed/${MODEL}"

uv run --no-sync scripts/prepare_data.py \
  --model="$MODEL" \
  --qsheet=data/RoboInter-Data/RoboInter_Data_Qsheet.json \
  --annotation-lmdb=data/RoboInter-Data/Annotation_pure/annotations \
  --raw-droid-root=data/raw \
  --keys-file="data/keys_${MODEL}.txt" \
  --rlds-filter=data/droid_sample_ranges.json \
  --output-dir="$PREPARED_DIR" --workers=8
Tiếp theo cài ZED SDK 5.1.2 và Python API cho Python 3.11 trên máy chuẩn bị depth. Làm bước tải calibration theo từng serial trong mục 4 của data guide, tạo data/zed_settings/SN<serial>.conf, rồi chạy:
uv run --no-sync scripts/prepare_depth.py \
  --model="$MODEL" \
  --foveal-repack-dir="${PREPARED_DIR}/foveal" \
  --output-dir="${PREPARED_DIR}/depth" \
  --zed-settings=data/zed_settings
Kết quả cần có annotations/, foveal/, depth/left/ và bộ lọc depth/paired_rlds_sample_ranges.json. Dual có thêm depth/right/ và phải được chuẩn bị trong output directory riêng. Không ghép crop của frame này với depth của frame khác chỉ vì hai file có cùng kích thước.
9. Training: học action và future box cùng lúc
Paper dùng loss flow matching cho action và cross-entropy với teacher forcing cho location tokens. Tổng loss là L_flow + 0.1 * L_foveation. Cả hai cập nhật shared backbone. Training còn perturb vị trí/kích thước crop, đôi khi thay crop bằng full view, và drop từng depth stream với xác suất 0,1 để giảm phụ thuộc vào input hoàn hảo.
Theo training guide, mặc định là tám GPU, global batch size 256, 100.000 steps và learning rate 5e-5. Paper dùng tám NVIDIA H100. Tài liệu cho phép đổi số thiết bị, nhưng không cam kết training đầy đủ vừa trong GPU có đủ VRAM cho inference.
export FOVEAVLA_DATA_ROOT="$(pwd)/${PREPARED_DIR}"
export FOVEAVLA_RLDS_DIR="$(pwd)/data/rlds"
export WANDB_API_KEY="YOUR_WANDB_API_KEY"

uv run --no-sync scripts/train.py "$MODEL" \
  --exp-name=my_run --batch-size=256 --fsdp-devices=8
Thay W&B key trong môi trường shell, không ghi vào source code. Dùng đường dẫn tuyệt đối cho hai data roots. Repo tải base π0.5 weights và DROID normalization statistics ở lần chạy đầu; thống kê được lưu trong checkpoint training. Đừng tự tính lại statistics trên dữ liệu khác mà vẫn xem đó là tái lập recipe gốc.
Checkpoint lưu mỗi 5.000 steps dưới checkpoints/<model>/<exp-name>/<step>/. Muốn resume, giữ experiment name và cấu hình rồi thêm --resume. Khi serve checkpoint tự train, truyền thư mục step thực sự đã tồn tại:
XLA_PYTHON_CLIENT_MEM_FRACTION=0.70 \
  uv run --no-sync scripts/serve.py \
  --model="$MODEL" \
  --checkpoint="checkpoints/$MODEL/my_run/99999"
99999 là ví dụ checkpoint cuối trong tài liệu; hãy thay nếu run của bạn dừng ở step khác. Với một GPU, tài liệu hướng dẫn --fsdp-devices=1 và batch size phù hợp, nhưng thay cấu hình có thể ảnh hưởng optimization, thời gian chạy và khả năng tái lập kết quả.
10. Kết quả: thắng ở đâu, giới hạn ở đâu?
Bảng I của paper dùng bốn task suites, mỗi suite 12 tình huống chung giữa các model. Tổng cộng là 48 trials cho mỗi policy, trên DROID thật. Các tỷ lệ dưới đây là phần trăm thành công, không phải kết quả đo riêng của bài hướng dẫn.
| Task suite | π0.5 có camera cổ tay | FoveaVLA-Single | FoveaVLA-Dual |
|---|---|---|---|
| Pick-and-Place đơn giản | 100,0 | 100,0 | 100,0 |
| Pick-and-Place có distractors | 25,0 | 58,3 | 50,0 |
| Fold/Unfold | 41,7 | 50,0 | 75,0 |
| Move với vật ở xa | 41,7 | 75,0 | 83,3 |
| Overall | 52,1 | 70,8 | 77,1 |
Single tăng 18,7 điểm phần trăm, Dual tăng 25,0 điểm phần trăm so với baseline theo số làm tròn trong bảng. Dual không tốt hơn ở mọi suite: Single đạt cao hơn trong nhóm distractors. Với chỉ 12 trials mỗi suite, một lần thành công đã tương đương khoảng 8,3 điểm phần trăm; không nên coi chênh lệch nhỏ là bảo đảm tổng quát.
Ablation cho thấy chỉ che camera cổ tay của baseline khiến success xuống 0%. Retrain một external RGB view đạt 6,3%; thêm depth nhưng không crop vẫn 6,3%. Single có crop mà thiếu depth đạt 20,8%, còn đủ crop và depth đạt 70,8%. Vì vậy bài học thực hành là phối hợp chi tiết cục bộ và thông tin hình học, không phải chỉ tháo camera đi.
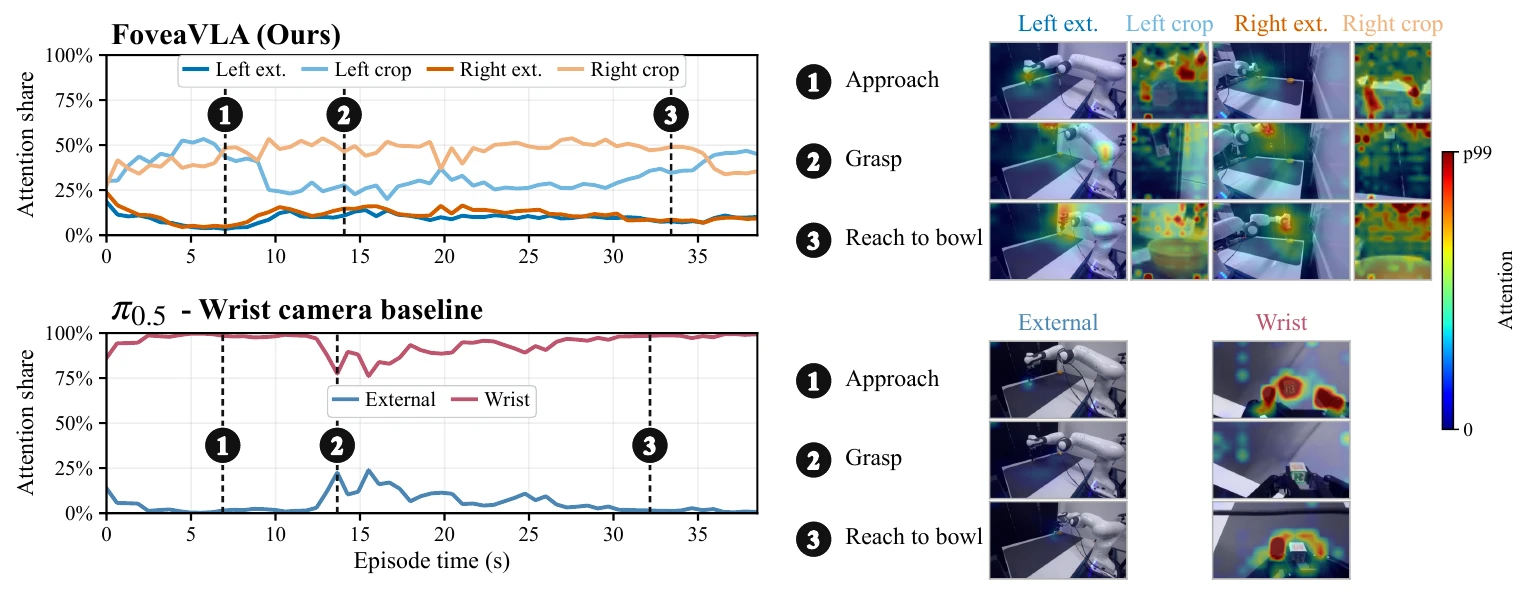
Hình attention minh họa một Move episode: baseline tập trung nhiều vào wrist view, trong khi FoveaVLA vẫn khai thác toàn cảnh cùng crop. Độ sáng được chuẩn hóa riêng theo từng model, nên không so trực tiếp cường độ màu giữa hai panel để kết luận model nào “chú ý mạnh hơn”.
Paper còn báo cáo zero-shot MolmoSpaces: Dual đạt trung bình 22,4%, so với 17,8% của π0.5-DROID trên leaderboard tham chiếu. Protocol FoveaVLA dùng hai external views được điều chỉnh và simulator depth; camera, resolution và depth khác protocol tham chiếu. Đây là bằng chứng chuyển giao ban đầu, không phải phép so sánh kiểm soát chỉ thay foveation.
11. Checklist cho lượt thử đầu
Bắt đầu bằng checkpoint Single, một ZED ngoài đúng serial và một task đơn giản với vật dễ phân biệt. Xem debug crop có giữ được vùng tương tác qua các giai đoạn tiếp cận, gắp và đặt hay không. Sau đó kiểm tra depth còn hợp lệ khi gripper tiến gần vật, rồi mới tăng distractors hoặc thử Dual.
Nếu cần đánh giá model trên bàn của bạn, ghi lại scene, instruction, timeout, tiêu chí success và số trials trước khi chạy. So sánh các cấu hình trên cùng điều kiện; một video thành công chỉ chứng minh policy làm được một episode. Code mở giúp tái lập pipeline, còn độ tin cậy triển khai phải được đo trên phần cứng và tác vụ thực tế.
Nguồn gốc và tài liệu thực hành
- Paper FoveaVLA trên arXiv: phương pháp, kết quả, ablation và appendix đánh giá.
- Project page của Stanford TML: rollout, visualizations và media kỹ thuật sử dụng trong bài.
- Repo mã nguồn chính thức: installation, pretrained checkpoints và code. Code mang Apache-2.0; xem thêm NOTICE và Gemma notices khi sử dụng các thành phần nền.
- Data guide, training guide và deployment guide: các bước đầy đủ và yêu cầu phiên bản.