Trong nghiên cứu robotics, có một nghịch lý quen thuộc: bạn đọc paper về Pi0 và cảm thấy hứng khởi, rồi khi thực sự ngồi xuống để chạy nó trên robot của mình, bạn nhận ra mình phải viết lại hàng nghìn dòng code chỉ để xử lý format dữ liệu. Mỗi model VLA — Pi0, GR00T, OpenVLA, SmolVLA — đều có codebase riêng, convention riêng, deployment stack riêng. Muốn so sánh hai model trên cùng task? Bạn đang maintain hai training infrastructure song song. Đây là "fragmentation problem" mà cộng đồng VLA đang gặp phải.
FluxVLA Engine — ra mắt tuần này từ LimX Dynamics cùng Nankai University và University of Hong Kong (arXiv:2609.17210) — đặt mục tiêu giải quyết đúng vấn đề này. Không phải một model mới, không phải một thuật toán mới, mà là một nền tảng kỹ thuật chuẩn hóa kết nối toàn bộ vòng lặp từ raw data đến real-robot deployment.
Bài này sẽ walkthrough toàn bộ pipeline thực hành: cài đặt, chuẩn bị data, training, evaluation trên simulation, accelerated inference, và deploy lên robot thực.
Vấn đề mà FluxVLA giải quyết
Hãy tưởng tượng bạn đang xây nhà nhưng mỗi nhà thầu — điện, nước, xây, nội thất — dùng bản vẽ theo format khác nhau và không ai chịu nói chuyện với ai. Đó chính xác là trạng thái của VLA ecosystem hiện tại năm 2026.
Ba bottleneck cụ thể mà FluxVLA nhắm vào:
1. Fragmented data formats — RLDS, LeRobot v2.1, HDF5, custom pickle... mỗi dataset dùng một format khác nhau. Mỗi lần đổi model là phải viết lại data loader từ đầu. Không phải vì thuật toán thay đổi — chỉ vì format khác.
2. Tightly-coupled codebases — Code Pi0 không phải code GR00T, code GR00T không phải code OpenVLA. Muốn so sánh ba model trên cùng task, bạn phải maintain ba training stack riêng biệt, ba evaluation harness khác nhau, và ba deployment pipeline phân kỳ dần theo thời gian.
3. Sim-to-real gap engineering — Một model đạt 95% trong LIBERO sim có thể thất bại hoàn toàn trên Franka arm thật nếu pipeline inference không xử lý đúng latency, sensor noise, và hardware timing. Khoảng cách này không nằm ở algorithm — nó nằm ở infrastructure.
Kiến trúc 5 lớp của FluxVLA
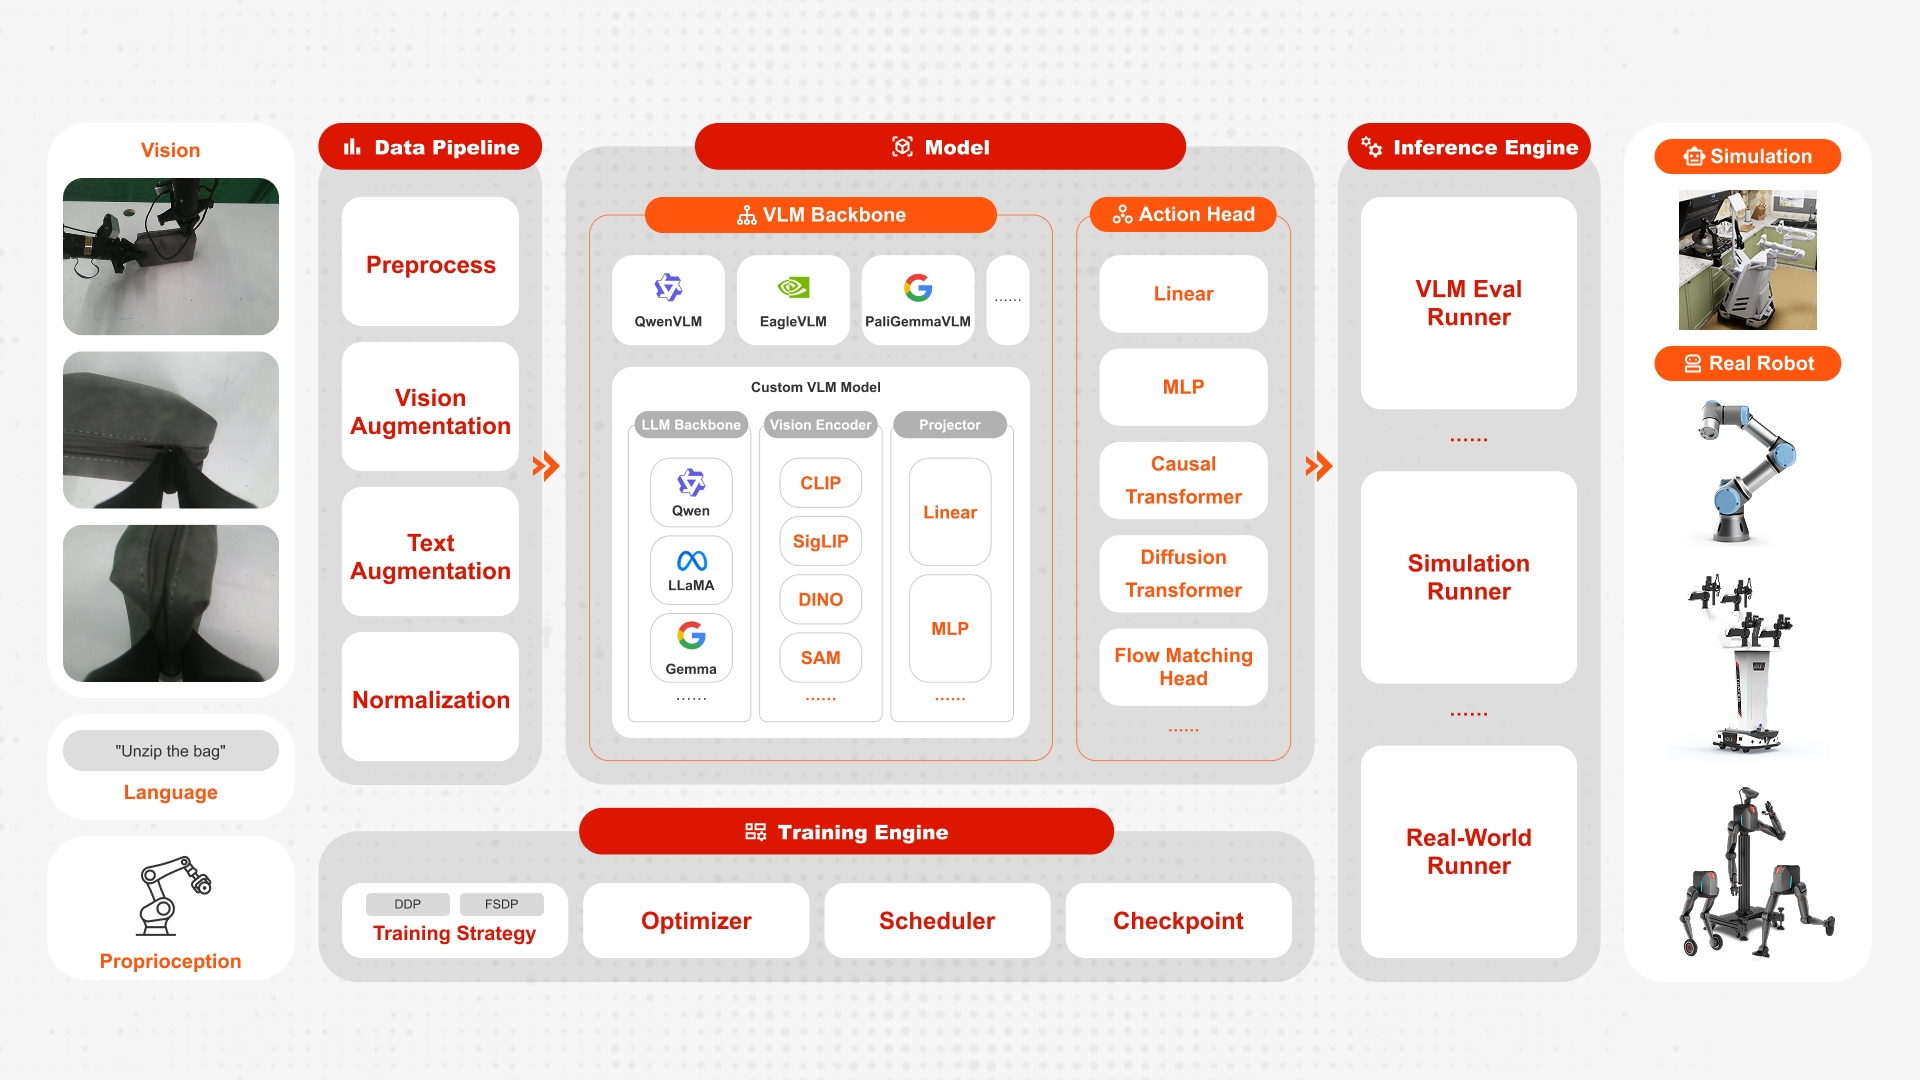
FluxVLA được tổ chức theo kiến trúc phân lớp rõ ràng — mỗi lớp có "contracts" (hợp đồng giao diện) được định nghĩa tường minh, cho phép swap components mà không phá vỡ phần còn lại:
Lớp 1: Data Layer
Ánh xạ episodes sang canonical sample dictionaries qua các composable transforms. Dataset phải ở định dạng LeRobot v2.1/v3.x (Parquet chunks) với metadata trong meta/episodes.jsonl.
Điểm mạnh quan trọng: các transforms compose thành pipeline (crop ảnh → normalize → temporal stack) và được shared giữa training và inference. Đây là điểm giải quyết một bug kinh điển trong VLA deployment — preprocessing drift, nơi training pipeline và serving pipeline dần dần khác nhau mà không ai nhận ra.
Lớp 2: Model Layer
Registry-based construction cho phép swap từng component độc lập:
- Vision encoders: CLIP ViT-B/32, DINOv2 ViT-Large, SigLIP ViT-SO400M, PaliGemma
- Language models: Qwen 2.5 (3B/7B), Llama 2 (7B), Gemma-family
- Action heads: token prediction (OpenVLA style), continuous flow-matching (Pi0 style), DiT
- Projectors: MLP hoặc Linear bridge từ visual tokens sang language space
Mọi model đều kế thừa từ BaseVLA, đảm bảo consistent interface cho action prediction và distributed training.
Lớp 3: Execution Layer
DDP (Distributed Data Parallel) và FSDP (Fully Sharded Data Parallel) qua scripts/train.py. Checkpoint format self-contained kèm resolved configuration — bạn luôn biết chính xác config nào đã sinh ra checkpoint đó, không còn tình trạng "không nhớ đã train với setting gì".
Lớp 4: Serving Layer
ZMQ-based transport cho observation/action I/O. Model có thể chạy trên dedicated GPU server riêng và serve inference qua network, hoặc local inference trực tiếp. Kiến trúc này đặc biệt quan trọng cho các setup nơi robot controller và inference backend chạy trên hardware khác nhau — ví dụ robot arm Franka với NUC nhỏ kết nối qua Ethernet đến GPU server.
Lớp 5: Operator Layer
Bridge giữa framework abstractions và simulator/robot SDK cụ thể. Hiện hỗ trợ: Franka dual-arm, ALOHA, UR3, TRON 2, và Oli humanoid (whole-body manipulation).
Bảng model được hỗ trợ
| Model | Tham số | Kiến trúc | Phù hợp cho |
|---|---|---|---|
| OpenVLA | 7B | Token prediction (SigLIP + LLaMA) | Research, benchmark |
| GR00T N1.5 | 3B | Cross-attention DiT head | Humanoid WBC |
| GR00T N1.7 | 3B | Cải tiến N1.5 | Humanoid WBC |
| Pi0/Pi0.5 | 3B | Flow-matching, dual Gemma experts | ALOHA, UR3, LIBERO |
| FastWAM | 5B | World-action model | Multi-task |
| SmolVLA | 450M | Lightweight, edge-friendly | Jetson Orin, inference nhanh |
| DiT4DiT | varies | Diffusion-in-tokenizer | High-dexterity tasks |
| DreamZero | varies | World model integration | Sim-augmented training |
Ngoài ra: Qwen2.5-VL (3B) và Qwen3-VL (30B) làm VLM backbones, SmolVLM2 (500M) cho lightweight deployment.
Cài đặt môi trường
FluxVLA cung cấp script cài đặt tự động với ba chế độ — chọn chế độ phù hợp để tránh install những dependency không cần thiết:
# Tạo conda environment
conda create -n fluxvla python=3.10 -y
conda activate fluxvla

# Chế độ 1: Chỉ simulation (LIBERO, RoboCasa, MuJoCo)
bash scripts/install_env.sh sim-only

# Chế độ 2: Chỉ real robot (nhẹ hơn, không có sim dependencies)
bash scripts/install_env.sh real-only

# Chế độ 3: Đầy đủ (sim + real + tất cả features)
bash scripts/install_env.sh full
Script tự động xử lý các dependency phức tạp: PyTorch + CUDA, FlashAttention (wheel build), FFmpeg + av, và toàn bộ FluxVLA package.
Lưu ý EGL cho server headless: Nếu train/eval trên server không có màn hình, cần configure EGL GPU rendering:
export MUJOCO_GL=egl
export EGL_DEVICE_ID=0  # index của GPU muốn dùng
Chuẩn bị dữ liệu
FluxVLA dùng LeRobot v2.1/v3.x Parquet format làm chuẩn. Datasets pre-processed sẵn có trên Hugging Face dưới organization FluxVLA:
FluxVLA/libero-spatial-lerobot   — LIBERO Spatial (10 tasks)
FluxVLA/libero-object-lerobot    — LIBERO Object
FluxVLA/libero-goal-lerobot      — LIBERO Goal
FluxVLA/libero-10-lerobot        — LIBERO 10 (long-horizon)
FluxVLA/robocasa-gr1-lerobot     — RoboCasa GR1 tabletop tasks
FluxVLA/franka-realrobot-lerobot — Real-robot Franka demonstrations
Nếu bạn có dữ liệu tự thu thập (HDF5 từ ACT/ALOHA, RLDS từ Open X-Embodiment), dùng conversion scripts:
# Convert từ RLDS sang LeRobot format
python scripts/convert_rlds_to_lerobot.py \
  --data-dir /path/to/rlds \
  --output-dir /path/to/lerobot_dataset

# Verify dataset structure
python scripts/verify_dataset.py --data-dir /path/to/lerobot_dataset
Structure dataset mong đợi:
dataset/
├── meta/
│   └── episodes.jsonl       # metadata từng episode
├── data/
│   ├── chunk-000/
│   │   ├── episode_000000.parquet
│   │   └── episode_000001.parquet
│   └── chunk-001/
│       └── ...
└── videos/                  # tuỳ chọn: compressed video observations
Training
FluxVLA dùng Python config files (mmengine-style) — một file config quản lý toàn bộ lifecycle: model architecture, data loading, training hyperparameters, evaluation protocol, và deployment interfaces. Đây là điểm cốt lõi của "configuration-as-code" approach.
Training Pi0.5 trên LIBERO-10:
torchrun --standalone --nnodes 1 --nproc-per-node 2 \
  scripts/train.py \
  --config configs/pi05/pi05_paligemma_libero_10_full_finetune.py \
  --work-dir ./work_dirs/pi05_libero_10_full_finetune \
  --cfg-options train_dataloader.per_device_batch_size=2
--nproc-per-node 2 tương ứng với 2 GPU. Đổi thành 1 nếu chỉ có single GPU.
Training GR00T N1.5 trên RoboCasa GR1:
torchrun --standalone --nnodes 1 --nproc-per-node 4 \
  scripts/train.py \
  --config configs/groot/groot_n15_robocasa_gr1_full_finetune.py \
  --work-dir ./work_dirs/groot_n15_robocasa_gr1 \
  --cfg-options train_dataloader.per_device_batch_size=4 \
                model.freeze_vision_encoder=True
Multi-node training (khi cần scale lên cluster):
# Trên node 0 (master):
torchrun --nnodes 2 --nproc-per-node 8 \
  --node-rank 0 --master-addr <NODE0_IP> --master-port 29500 \
  scripts/train.py --config configs/fastwam/fastwam_5b_libero.py

# Trên node 1:
torchrun --nnodes 2 --nproc-per-node 8 \
  --node-rank 1 --master-addr <NODE0_IP> --master-port 29500 \
  scripts/train.py --config configs/fastwam/fastwam_5b_libero.py
LimX Dynamics tuyên bố "full training pipeline under 30 minutes" cho các model nhỏ hơn trên LIBERO — nhờ FSDP và checkpoint design tối ưu.
Đánh giá trên Simulation
torchrun --standalone --nnodes 1 --nproc-per-node 2 \
  scripts/eval.py \
  --config configs/pi05/pi05_paligemma_libero_10_full_finetune.py \
  --ckpt-path checkpoints/step-028548-epoch-18-loss=0.0111.safetensors
Kết quả LIBERO benchmark (trung bình 4 task suites):
| Model | Avg Success Rate |
|---|---|
| FastWAM-Joint | 98.35% |
| Pi0.5 | ~92% |
| GR00T N1.5 | ~87% |
| OpenVLA | ~81% |
| SmolVLA | ~72% |
FastWAM-Joint (5B) dẫn đầu với 98.35% — con số ấn tượng nhất trong nhóm. (Xem paper để có breakdown đầy đủ theo từng task suite.)
Kết quả RoboCasa GR1 — benchmark khó hơn LIBERO đáng kể:
| Model | Success Rate |
|---|---|
| DiT4DiT | 57.25% |
| FastWAM | ~48% |
| Pi0.5 | ~41% |
| GR00T N1.5 | ~35% |
| SmolVLA | 8.75% |
Số liệu RoboCasa thấp hơn LIBERO nhiều vì độ phức tạp của task — đây là benchmark phản ánh trung thực khó khăn của real-world manipulation.
Accelerated Inference — 5-10x Nhanh Hơn
Đây là điểm kỹ thuật đặc biệt của FluxVLA. Platform tích hợp nhiều optimization layer để đạt tốc độ inference cao hơn 5-10x so với baseline:
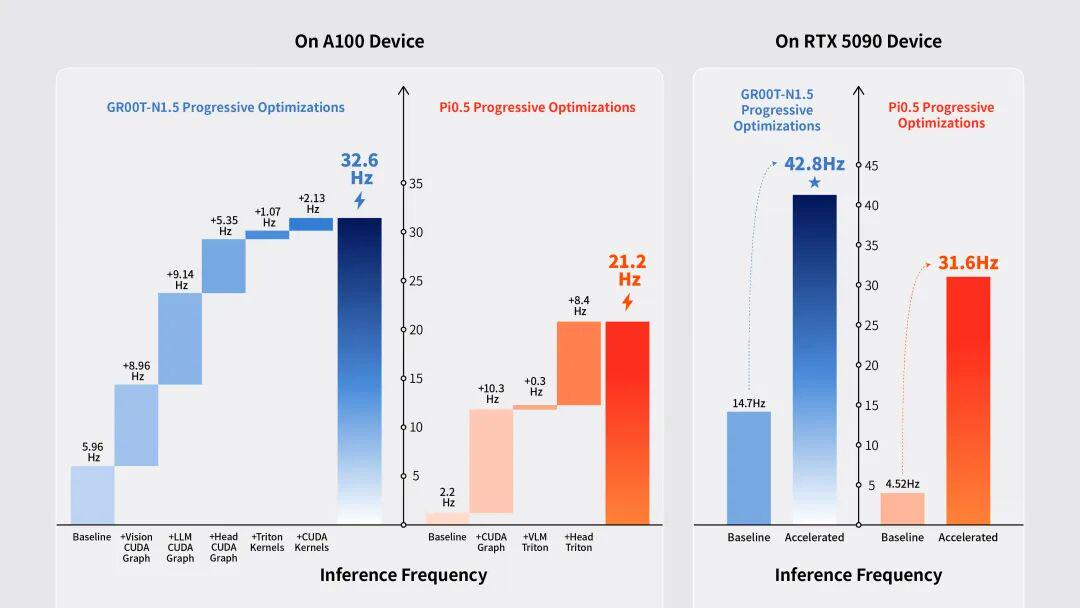
- CUDA Graph capture — Capture computation graph một lần rồi replay, loại bỏ CPU overhead trên mỗi inference step
- Triton kernel fusion — Merge nhiều CUDA kernels nhỏ thành kernel lớn hơn, giảm memory bandwidth pressure
- Real-Time Chunking (RTC) — Training-time prefix conditioning kết hợp test-time guidance để action chunks liền mạch, tránh jerk artifacts giữa các chunk
- Trajectory post-processing — Joint-space optimization với jerk-limited filtering cho chuyển động robot mượt mà hơn trong thực tế
Trên NVIDIA Jetson Orin (edge deployment):
- GR00T-N1.5 đạt 7.4 Hz — đủ cho manipulation real-time (cần tối thiểu 5-10 Hz)
- SmolVLA (450M) đạt tốc độ cao hơn, phù hợp cho ứng dụng cần latency thấp
Remote inference qua ZMQ (khi robot không đủ compute để chạy model trực tiếp):
# Trên GPU server:
python scripts/serve_inference.py \
  --config configs/groot/groot_n15_serving.py \
  --port 5555

# Trên robot controller (NUC hoặc Jetson):
python scripts/run_robot.py \
  --operator configs/operators/franka_operator.py \
  --inference-server tcp://192.168.1.100:5555
Whole-Body Manipulation với Oli Humanoid
FluxVLA hỗ trợ Oli humanoid — robot hình người của LimX Dynamics — với whole-body manipulation policy. Đây là điểm phân biệt quan trọng so với các framework chỉ tập trung vào robot arm thông thường.
Arm Reward Modeling (ARM) với reweighting:
# Reward-Adjusted Behavioral Cloning (RA-BC)
torchrun --standalone --nnodes 1 --nproc-per-node 4 \
  scripts/train.py \
  --config configs/sarm/sarm_oli_wholebody.py \
  --cfg-options model.reweighting_method=ra_bc

# Advantage-Weighted Behavioral Cloning (AW-BC)
torchrun --standalone --nnodes 1 --nproc-per-node 4 \
  scripts/train.py \
  --config configs/sarm/sarm_oli_wholebody.py \
  --cfg-options model.reweighting_method=aw_bc
SARM (Segmented ARM) segment demonstrations theo chất lượng rồi reweight gradient contributions — model học nhiều hơn từ high-quality demos mà không bỏ hoàn toàn low-quality ones. Điều này đặc biệt có giá trị trong real-robot data collection nơi chất lượng demo không đồng đều.
Để tìm hiểu sâu hơn về Pi0.5 fine-tuning trong context teleop, xem hướng dẫn AXIS Browser teleop với Pi0.5. Nếu bạn đang benchmark OpenVLA vs Pi0.5 trên cùng task set, bài so sánh DexVerse có nhiều số liệu thực chiến. Còn nếu mục tiêu là deploy GR00T N1 trên G1 robot từ đầu đến cuối, pipeline GR00T N1 finetune đầy đủ là nơi bắt đầu tốt nhất.
Kết luận
FluxVLA Engine giải quyết đúng vấn đề mà cộng đồng VLA đang gặp: không phải thiếu model tốt, mà thiếu infrastructure chuẩn hóa để chạy và so sánh chúng một cách reproducible.
Bốn điểm nổi bật đáng đầu tư thời gian:
- Unified config — một file Python quản lý toàn bộ lifecycle, từ data đến deployment
- Module decoupling — swap vision encoder, LLM, hoặc action head mà không rebuild infrastructure
- 5-10x inference speedup — CUDA Graphs + Triton kernels, thiết thực cho real-robot deployment
- Cross-embodiment — từ Franka arm đến Oli humanoid whole-body manipulation
Với license Creative Commons BY 4.0 và codebase public trên GitHub, đây là nền tảng đáng để đưa vào toolchain nghiên cứu của bạn trong năm 2026.