Bài Toán Whole-Body Mobile Manipulation
Hãy tưởng tượng một robot phải tự di chuyển qua căn phòng, nhận ra chiếc cốc trên bàn bất kể ánh đèn trên đầu đang ở góc nào, với tay vào đúng tư thế, cầm lên và đặt vào đúng vị trí được yêu cầu — tất cả trong một chuỗi hành động liên tục duy nhất. Đây là whole-body mobile manipulation: bài toán khó bậc nhất trong robot thao tác vì nó kết hợp đồng thời ba thử thách lớn.
Thứ nhất, không gian hành động quá lớn: robot di động hai tay có thể có tới 25–37 bậc tự do (base + torso + cả hai cánh tay + gripper + đầu), và mọi khớp phải phối hợp nhịp nhàng. Một policy sinh ra hành động không nhất quán ở 37 chiều cùng lúc sẽ tạo ra chuyển động giật cục, thậm chí nguy hiểm.
Thứ hai, môi trường thực luôn thay đổi: ánh sáng, màu vật, vị trí, thậm chí căn phòng hoàn toàn mới. Policy học trong lab nhưng phải hoạt động trong nhà kho, trong nhà bếp, hay văn phòng thực.
Thứ ba, đánh đổi giữa hình học và ngữ nghĩa: robot cần vừa biết chính xác vật ở đâu trong không gian 3D (để tiếp cận đúng), vừa nhận ra đó là "cái gì" (để không nhầm vật thể khi màu sắc thay đổi).
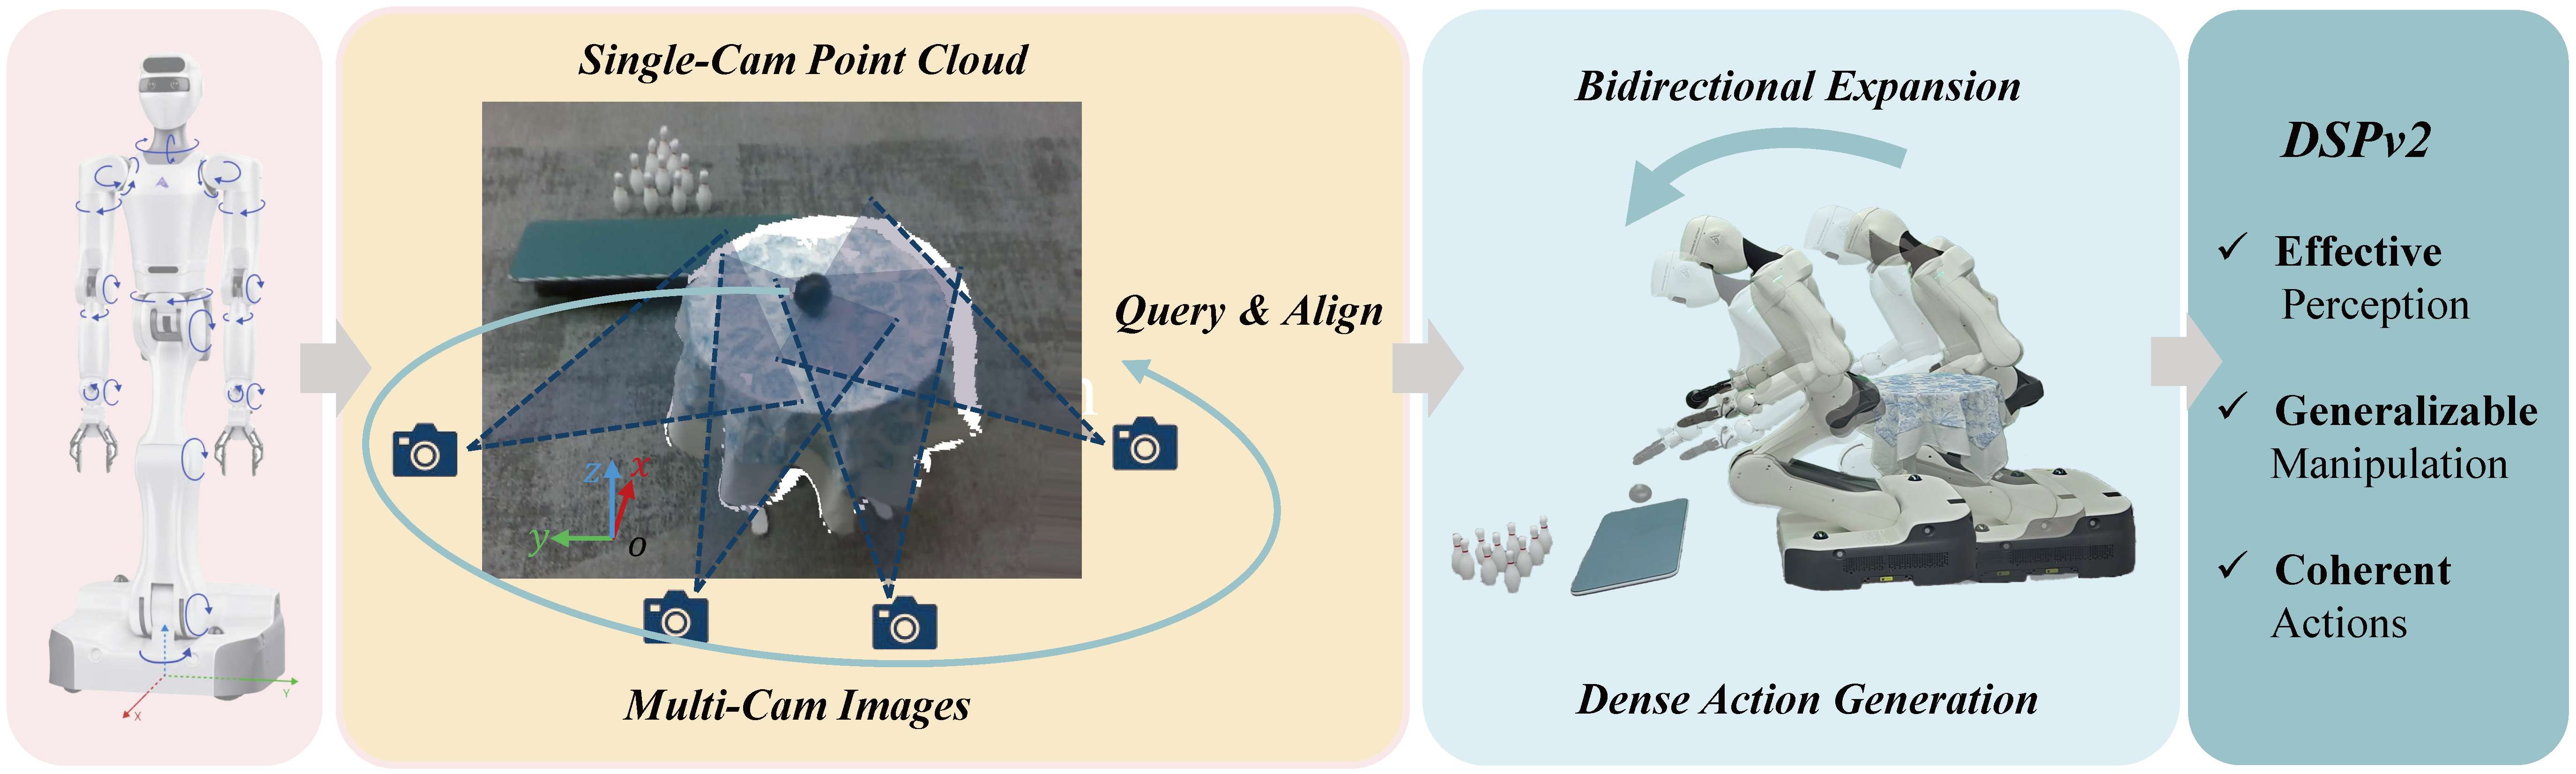
DSPv2 (Dense Policy version 2), được chấp nhận tại ICRA 2026 bởi nhóm nghiên cứu từ Đại học Hồng Kông, Astribot và Đại học Thanh Hoa, đề xuất một kiến trúc giải quyết đồng thời tất cả ba thử thách trên bằng cách dung hợp thông tin 3D hình học với đặc trưng ngữ nghĩa 2D từ vision foundation model.
Paper: DSPv2: Improved Dense Policy for Effective and Generalizable Whole-body Mobile Manipulation — Yue Su, Chubin Zhang, Sijin Chen et al., ICRA 2026
GitHub: Selen-Suyue/DSPv2
Project page: selen-suyue.github.io/DSPv2Net
DSPv2 system overview — nguồn: DSPv2Net project page
DSPv2 Là Gì Và Tại Sao Nó Quan Trọng?
DSPv2 là phiên bản cải tiến của Dense Policy (DSP) — policy học từ demo dùng sinh hành động tự hồi quy hai chiều (bidirectional autoregressive generation), được công bố tại ICCV 2025. Trong khi DSP gốc tập trung vào thao tác cánh tay gắn cố định, DSPv2 mở rộng phương pháp này sang robot di động toàn thân, đồng thời giải quyết vấn đề generalization một cách có hệ thống.
Ba đóng góp chính của DSPv2:
-
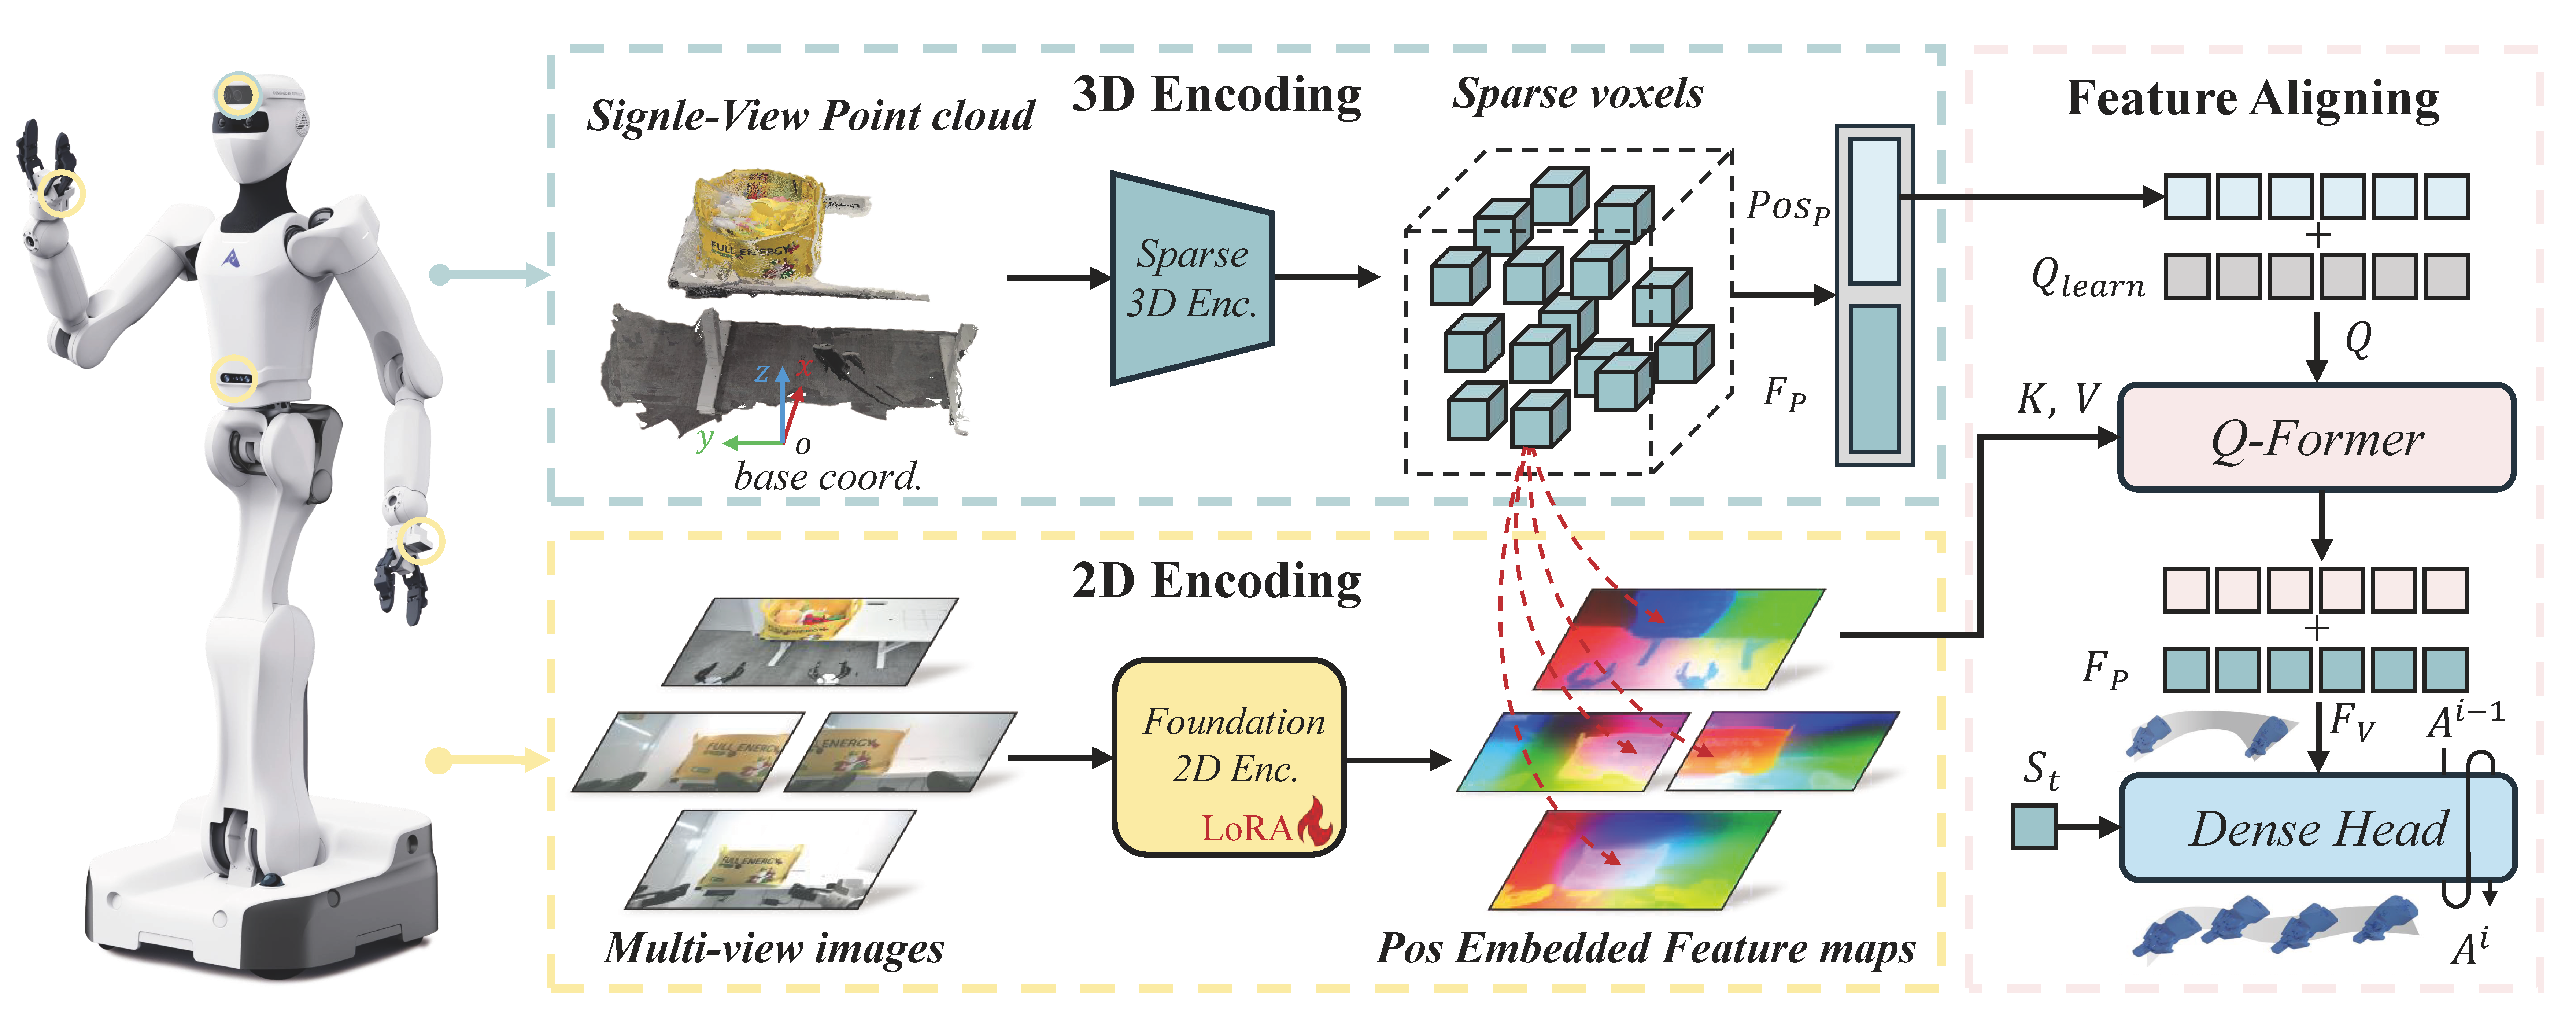
Mã hóa 2D-3D dung hợp hiệu quả: Thay vì chọn một trong hai (chỉ 3D point cloud như DP3, hoặc chỉ RGB 2D như DP), DSPv2 dùng cả hai song song và căn chỉnh chúng qua Q-Former — giữ được ưu điểm của từng loại mà không mang theo nhược điểm.
-
Tổng quát hóa có hệ thống: Lần đầu tiên một policy whole-body mobile manipulation được thiết kế và kiểm nghiệm cụ thể với bốn điều kiện generalization: thay đổi ánh sáng, thay đổi màu vật thể, thay đổi vị trí không gian, và cảnh hoàn toàn mới.
-
Dense Action Head cho whole-body: Đầu sinh hành động autoregressive hoạt động ổn định trên không gian hành động 37 chiều, nhanh hơn diffusion đáng kể.
Kiến Trúc Kỹ Thuật Chi Tiết
1. Thiết Lập Camera Đa Góc Nhìn
Robot Astribot-S1 — nền tảng thực nghiệm chính của bài báo — được trang bị ba loại camera phối hợp:
- Camera đầu (head): Orbbec Femto Bolt, sinh cả ảnh RGB lẫn depth map. Đây là camera "nhìn xa" cung cấp cái nhìn tổng thể về workspace.
- Camera thân (torso): Orbbec Gemini 335, quan sát workspace từ góc trung gian — hỗ trợ khi đầu robot quay đi hướng khác.
- Camera cổ tay (wrist × 2): Intel Realsense D401 trên mỗi cánh tay, cung cấp quan sát cận cảnh lúc gripper tiếp xúc vật thể.
Ngoài camera, robot state bao gồm pose hợp nhất 37 chiều:
- Chassis: 3 DOF (x, y, góc quay)
- Torso: 1 DOF (nâng hạ thân)
- Cánh tay trái: 7 DOF
- Cánh tay phải: 7 DOF
- Gripper trái + phải: mỗi 1 DOF
- Đầu: 2 DOF
Trong quá trình training, robot state được mask ngẫu nhiên 30% — nghĩa là đôi khi một phần proprioception bị che khỏi model. Điều này buộc policy học cách suy luận từ thông tin visual là chính, không phụ thuộc quá vào feedback khớp, tăng robustness khi sensor thực tế bị nhiễu.
2. Nhánh 3D: Sparse Encoder Trên Point Cloud Không Màu
Camera đầu sinh ra point cloud dày từ depth map. DSPv2 thực hiện một lựa chọn quan trọng: loại bỏ thông tin màu sắc khi xử lý point cloud.
Tại sao bỏ màu? Màu trong point cloud phụ thuộc vào ánh sáng, màu bề mặt vật thể, và điều kiện camera — tất cả thay đổi liên tục trong môi trường thực. Nếu Sparse 3D Encoder học dựa vào màu để nhận dạng vật, nó sẽ thất bại khi ánh sáng thay đổi hoặc vật thể có màu khác. Bằng cách dùng uncolored point cloud (chỉ tọa độ XYZ thuần), nhánh này chỉ học hình học không gian: vị trí, khoảng cách, hình dạng bề mặt — những thứ không phụ thuộc vào điều kiện ánh sáng.
Point cloud được chuyển về frame robot base trước khi xử lý. Điều này đảm bảo rằng bất kể robot đang quay hướng nào, tọa độ vật thể trong cảnh luôn nhất quán so với thân robot.
Sparse 3D Encoder (kiến trúc sparse convolution) xử lý point cloud đã voxelized (kích thước voxel ~1cm) và xuất ra đặc trưng hình học $F_{3D}$ kèm tọa độ 3D của mỗi voxel đặc trưng.
3. Nhánh 2D: DINOv2 Với LoRA Fine-Tuning
Song song với nhánh 3D, ảnh RGB từ cả bốn camera (head, torso, wrist-left, wrist-right) được xử lý qua DINOv2-base — vision foundation model được Facebook Research pre-train trên 142 triệu ảnh với self-supervised learning (DINO: self-DIstillation with NO labels). DINOv2 nổi tiếng vì tạo ra các đặc trưng ngữ nghĩa rất mạnh: hai ảnh của cùng một loại vật thể (dù góc chụp, ánh sáng khác nhau) sẽ có feature vector gần nhau.
Vấn đề: DINOv2 pre-train trên ảnh tự nhiên, không phải dữ liệu robotics. Nếu đóng băng hoàn toàn (frozen), các đặc trưng vẫn tốt nhưng thiếu domain-specific knowledge về robot manipulation. Nếu fine-tune toàn bộ, sẽ tốn kém và có thể phá vỡ tính tổng quát đã học.
Giải pháp: LoRA (Low-Rank Adaptation) — thêm các ma trận rank thấp vào mỗi attention layer của DINOv2, chỉ train khoảng 1% tổng tham số. LoRA cho phép model thích nghi với robotics domain mà không quên kiến thức tổng quát đã có.
Kết quả trong paper (Bảng III): DINOv2 + LoRA đạt 80% success rate ở cảnh hoàn toàn mới, trong khi DINOv2 frozen chỉ đạt 60% — cải thiện 20 điểm phần trăm nhờ một kỹ thuật rất nhỏ.
Output: đặc trưng ngữ nghĩa đa-view ${F_{2D}^{head}, F_{2D}^{torso}, F_{2D}^{wrist_l}, F_{2D}^{wrist_r}}$.
4. Q-Former: Cầu Nối Hình Học Và Ngữ Nghĩa
Đây là module sáng tạo nhất của DSPv2. Q-Former (Query Former) có 300 learnable query token. Thách thức cần giải quyết: nhánh 3D biết "ở đâu" nhưng không biết "là gì"; nhánh 2D biết "là gì" nhưng thông tin vị trí không chính xác trong 3D. Làm sao kết hợp chúng?
Ý tưởng của DSPv2: dùng tọa độ 3D của mỗi voxel làm positional embedding cho query token. Khi một query token mang positional embedding tương ứng với tọa độ 3D của điểm $P$ trong scene, nó sẽ "biết mình đang hỏi về điểm nào trong không gian" và cross-attend vào vùng feature 2D tương ứng trên các ảnh camera — nơi mà điểm $P$ được project vào.
Quá trình cụ thể:
- Sparse 3D Encoder xuất ra $(F_{3D}, \text{coords}_{3D})$ — đặc trưng kèm tọa độ từng voxel.
- Tọa độ 3D của mỗi voxel được embed thành positional encoding.
- 300 learnable query token + positional encoding thực hiện cross-attention vào đặc trưng 2D của cả bốn camera.
- Output: 300 token hợp nhất — mỗi token mang thông tin ngữ nghĩa (DINOv2) của điểm tương ứng trong 3D.
Cơ chế này cho phép hai nhánh "hoạt động hoàn toàn độc lập" trong forward pass — không cần chia sẻ weights hay học không gian feature chung — nhưng vẫn được căn chỉnh (aligned) qua Q-Former. Đây là lý do DSPv2 giữ được ưu điểm của cả hai nhánh mà không bị "kéo" về phía nhược điểm của nhau.
5. Dense Action Head: Sinh Hành Động Toàn Thân
Output của Q-Former (300 token) cùng với robot state được đưa vào Dense Action Head — phần thừa hưởng trực tiếp từ Dense Policy gốc (ICCV 2025).
Thay vì diffusion model (cần nhiều bước denoising, latency cao, khó kiểm soát), Dense Head dùng bidirectional autoregressive transformer để sinh chuỗi hành động. Cơ chế "coarse-to-fine":
- Coarse pass (forward): Sinh các keyframe hành động, phác thảo quỹ đạo tổng thể từ trạng thái hiện tại đến trạng thái mục tiêu.
- Fine pass (backward): Điền vào các bước hành động trung gian bằng cách "nhìn" cả keyframe trước lẫn keyframe sau — tạo interpolation mượt và nhất quán.
Bidirectional attention giúp giảm đáng kể error accumulation: trong autoregressive một chiều, lỗi ở bước $t$ khuếch đại sang bước $t+1, t+2, \ldots$; bidirectional attention cho phép bước $t$ được điều chỉnh dựa trên ngữ cảnh tương lai, hạn chế drift.
Output cuối cùng: chuỗi hành động 37 chiều cho chunk 20 bước tiếp theo.
Hướng Dẫn Cài Đặt Và Sử Dụng
Yêu Cầu Phần Cứng Và Phần Mềm
- GPU: NVIDIA với ít nhất 16GB VRAM (để chứa DINOv2-base + Sparse 3D Encoder)
- CUDA 11.8 trở lên
- Python 3.9+
- RAM: 32GB trở lên (xử lý point cloud tốn bộ nhớ)
Cài Đặt Môi Trường
# Clone repo DSPv2
git clone https://github.com/Selen-Suyue/DSPv2.git
cd DSPv2

# Tạo conda environment riêng (tránh conflict với môi trường khác)
conda create -n dspv2 python=3.9 -y
conda activate dspv2

# Cài PyTorch với CUDA
pip install torch==2.1.0 torchvision==0.16.0 --index-url https://download.pytorch.org/whl/cu118

# Cài dependencies (theo INSTALL.md trong repo)
# assets/docs/INSTALL.md chứa hướng dẫn chi tiết
pip install -r requirements.txt
Cấu Hình Cho Robot Cụ Thể
Trước khi bất cứ điều gì khác, bắt buộc điều chỉnh constants cho robot của bạn:
# dataset/constants.py — thông số data
ROBOT_DOF = 37          # Số chiều action của robot
CONTROL_HZ = 20         # Tần số điều khiển (Hz)
ACTION_CHUNK = 20       # Số bước action mỗi inference
CAMERA_NAMES = ['head', 'torso', 'wrist_left', 'wrist_right']
DATA_DIR = '/path/to/your/data'

# utils/constants.py — thông số utils
JOINT_LIMITS_MIN = [...]   # Giới hạn dưới mỗi khớp (rad hoặc m)
JOINT_LIMITS_MAX = [...]   # Giới hạn trên mỗi khớp
POINT_CLOUD_VOXEL = 0.01   # Kích thước voxel (mét)
Nếu bạn không dùng Astribot-S1, cần điều chỉnh thêm policy/policy.py để khớp số chiều input/output với robot của bạn. Kiến trúc Q-Former và Dense Head không phụ thuộc vào robot cụ thể — chỉ các lớp đầu và cuối cần thay đổi.
Chuẩn Bị Dữ Liệu
DSPv2 dùng định dạng dữ liệu tương tự RH20T. Mỗi episode là một thư mục:
episode_000/
├── metadata.json          # Task info, robot info, timestamps
├── cam_head_rgb/          # Ảnh RGB camera đầu (174 frames/episode)
├── cam_head_depth/        # Depth maps camera đầu
├── cam_torso_rgb/         # Ảnh RGB camera thân
├── cam_wrist_left_rgb/    # Ảnh RGB cổ tay trái
├── cam_wrist_right_rgb/   # Ảnh RGB cổ tay phải
└── robot_state.h5         # HDF5: joint positions + TCP coords + gripper state
Sau khi thu thập demo (100 episodes mỗi task qua VR teleoperation), tiền xử lý như sau:
# Bước 1: Tiền xử lý — voxelization point cloud
python dataset/preprocess_data.py \
    --data_dir /path/to/raw_episodes \
    --output_dir /path/to/processed \
    --task pick_and_place \
    --voxel_size 0.01

# Bước 2: Tính normalization — BẮT BUỘC trước training
# Tính 5th-95th percentile của actions, lưu vào dataset/pose.json
python dataset/compute_normalization.py \
    --processed_dir /path/to/processed \
    --task pick_and_place

# Bước 3: Kiểm tra dữ liệu
python utils/hdf5_view.py --file /path/to/processed/episode_000/robot_state.h5
Lưu ý: Bước tính normalization thường bị bỏ qua nhưng rất quan trọng. DSPv2 normalize actions về range [-1, 1] trước khi đưa vào model. Nếu bỏ bước này, training sẽ không hội tụ hoặc hội tụ rất chậm.
Training
conda activate dspv2

# Training với default settings
bash train.sh

# Hoặc custom:
python train.py \
    --task pick_and_place \
    --data_dir /path/to/processed \
    --batch_size 32 \
    --lr 1e-4 \
    --epochs 200 \
    --use_lora True \
    --lora_rank 16 \
    --mask_prob 0.3 \
    --checkpoint_dir checkpoints/
Các tham số training quan trọng:
| Tham số | Giá trị DSPv2 gốc | Ghi chú |
|---|---|---|
batch_size |
32 | Tăng nếu VRAM cho phép |
lr |
1e-4 | Adam optimizer |
lora_rank |
16 | Rank LoRA cho DINOv2 |
mask_prob |
0.3 | Xác suất mask robot state |
action_chunk |
20 | Bước action mỗi inference |
query_tokens |
300 | Số Q-Former tokens |
voxel_size |
0.01m | Kích thước voxel point cloud |
epochs |
200 | Thường converge ở 80–120 epoch |
Theo dõi training qua TensorBoard:
tensorboard --logdir logs/ --port 6006
# Mở http://localhost:6006 trong browser
Quan sát ba loss chính:
action_loss: Loss chính — phải giảm đều đặn.3d_feat_loss: Loss nhánh 3D — quan trọng cho spatial understanding.kl_loss: Regularization của Q-Former — nếu tăng bất thường là dấu hiệu overfitting.
Inference
conda activate dspv2

# Đánh giá trên robot thật
python eval.py \
    --checkpoint checkpoints/best_model.pt \
    --task pick_and_place \
    --num_episodes 10 \
    --record_video True

# Hoặc dùng eval.sh (preset sẵn)
bash eval.sh
Xem demo robot thực hiện pick-and-place trên Astribot-S1:
DSPv2 dùng action chunking: mỗi inference sinh 20 bước hành động cùng lúc thay vì từng bước một. Kỹ thuật này giảm overhead network đáng kể và tạo quỹ đạo mượt hơn vì các bước trong chunk được sinh cùng ngữ cảnh.
Kết Quả Thực Nghiệm
Hiệu Suất Trên Các Task Chính
Tất cả thực nghiệm được thực hiện trên Astribot-S1 với 100 demo mỗi task, thu thập qua VR teleoperation.
| Task | Kết quả |
|---|---|
| Pick and Place | Pick: 80%, Place: 60% |
| Sort (phân loại vật thể) | 100% |
| Deliver (giao hàng) | Pick: 80%, Place: 60% |
| Bowling (đẩy bóng) | Grasp: 90%, Hit: 50% |
| Cart Push (đẩy xe) | 90% |
Sort đạt 100% vì task này chỉ yêu cầu nhận dạng và đặt vật — không cần precision cao như pick-and-place. Cart pushing đạt 90% vì đây là task "pushing" không yêu cầu grasp chính xác.
Khả Năng Tổng Quát Hóa — Điểm Mạnh Nhất
| Điều kiện thay đổi | DSPv2 | WB-WIMA | DP3 | DP (2D) |
|---|---|---|---|---|
| Thay đổi ánh sáng | 80% | 65% | 30% | 50% |
| Thay đổi màu vật thể | 80% | 60% | 10% | 50% |
| Thay đổi vị trí không gian | 85% | 45% | 35% | 35% |
| Cảnh hoàn toàn mới | 60% | 40% | 15% | 20% |
Con số quan trọng nhất: DP3 chỉ đạt 10% khi màu vật thể thay đổi. DP3 là phương pháp 3D-only (chỉ dùng point cloud có màu); khi màu vật thay đổi, point cloud trông khác đi hoàn toàn và policy không nhận ra. Đây là bằng chứng trực tiếp cho thấy tại sao DSPv2 chọn uncolored point cloud cho nhánh 3D và dùng DINOv2 cho semantic — hai nhánh bù đắp điểm yếu của nhau.
DSPv2 đạt 80% trong cùng điều kiện — gấp 8 lần DP3.
Ablation Studies
Paper thực hiện ablation để xác nhận từng thành phần:
| Variant | Cảnh mới (%) |
|---|---|
| DSPv2 đầy đủ (DINOv2 + LoRA + Q-Former + Dense Head) | 80% |
| DINOv2 frozen (không LoRA) | 60% |
| Concat thẳng thay Q-Former | 65% |
| Diffusion Head thay Dense Head | 70% (nhưng 3× chậm hơn) |
Mỗi thành phần đóng góp: LoRA (+20%), Q-Former (+15% so với concat thô), Dense Head (nhanh hơn 3×, ít tệ hơn diffusion 10%).
So Sánh Với Các Phương Pháp Liên Quan
Nếu bạn đang tìm phương pháp phù hợp cho project, đây là bức tranh tổng thể:
| Phương pháp | Whole-body | Generalization | Tốc độ inference | Độ phức tạp setup |
|---|---|---|---|---|
| DSPv2 | ✅ | ⭐⭐⭐⭐ | Nhanh | Trung bình |
| DP3 | Giới hạn | ⭐⭐ | Chậm (diffusion) | Cao |
| WB-WIMA | ✅ | ⭐⭐⭐ | Trung bình | Cao |
| DP (2D) | Giới hạn | ⭐⭐⭐ | Chậm (diffusion) | Thấp |
| DSP gốc (ICCV 2025) | ❌ | ⭐⭐⭐ | Nhanh | Thấp |
DSPv2 là lựa chọn duy nhất đạt được đồng thời: whole-body control, generalization cao, và inference nhanh.
Để hiểu thêm về dense model approach trong robotics, xem Dense Models cho Robotics: So Sánh Toàn Diện. Nếu bạn đang làm việc với LeRobot và mobile manipulation, xem VLA cho Mobile Manipulation với LeRobot.
Giới Hạn Và Hướng Phát Triển
DSPv2 thẳng thắn về những gì chưa làm được:
1. Cross-robot generalization còn hạn chế: Policy được train trên Astribot-S1 (25 DOF) — khi test trên robot khác với tỉ lệ khớp khác, hiệu suất giảm đáng kể. Đây vẫn là bài toán mở cho whole-body manipulation.
2. Data collection vẫn tốn công: 100 demo mỗi task qua VR teleoperation là hợp lý nhưng không phải ai cũng có setup VR + Astribot. Scaling lên nhiều task hơn đòi hỏi đầu tư lớn.
3. Inference latency trong điều kiện thực: Dense Head nhanh hơn diffusion nhưng với 37 DOF và action chunking, vẫn cần GPU tốt để đạt ≥10Hz control frequency.
Hướng nghiên cứu tiếp theo mà nhóm tác giả gợi ý: tích hợp world model để tự sinh synthetic demonstrations, giảm phụ thuộc vào teleoperation thực, và mở rộng cross-embodiment transfer.
Để tìm hiểu về training pipeline toàn diện cho whole-body VLA, đọc thêm Whole-Body VLA Training Pipeline: Từ Data đến Deploy. Và nếu bạn quan tâm đến RL-based dense reward cho manipulation, xem ProcVLM: Dense Reward VLA với Reinforcement Learning.
Kết Luận
DSPv2 là một bước tiến có ý nghĩa trong whole-body mobile manipulation. Điểm mạnh cốt lõi không phải là một kỹ thuật đột phá duy nhất mà là thiết kế modular được kết hợp đúng cách: uncolored point cloud cho robustness hình học, DINOv2 + LoRA cho semantic generalization, Q-Former cho alignment linh hoạt, Dense Head cho inference nhanh. Mỗi thành phần giải quyết đúng một thách thức cụ thể.
Nếu bạn đang xây dựng policy cho robot di động toàn thân và cần một baseline có generalization thực tế — không chỉ hoạt động trong điều kiện lab — DSPv2 là điểm khởi đầu đáng tin cậy.