Vì sao một demo gắp vật chưa đủ?
Bạn thấy robot nhận câu lệnh, nhấc chiếc cốc và đặt lên giá. Demo đẹp, nhưng nếu đổi ánh sáng, che vật bằng nắp hoặc yêu cầu làm liên tiếp nhiều bước, policy còn hoạt động không? Để chọn Vision-Language-Action model, chúng ta cần một quy trình đo lường có điều kiện đầu vào rõ ràng, có thất bại được ghi lại và có khả năng chạy lại.
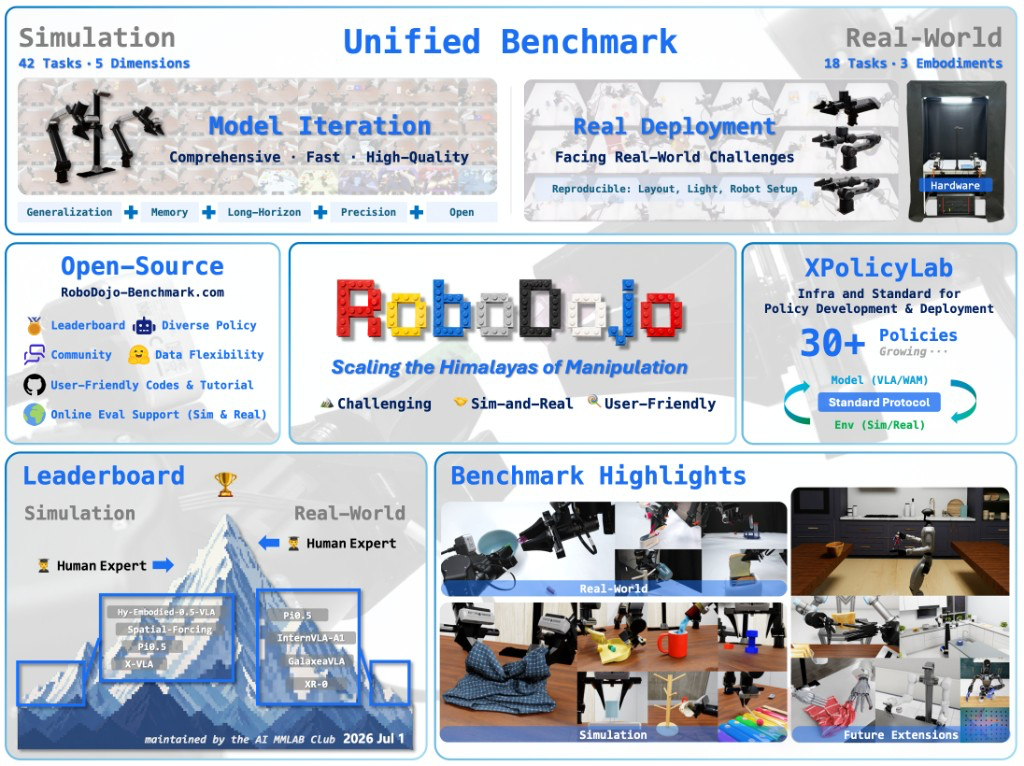
RoboDojo cung cấp bộ đánh giá manipulation gồm 42 tác vụ mô phỏng và 18 tác vụ thực tế. XPolicyLab là lớp nối policy với môi trường: mỗi model giữ dependencies riêng nhưng dùng chung hợp đồng observation/action. Bài này hướng dẫn xây một benchmark cục bộ cho π0.5, SmolVLA và GR00T-N1.7, phiên bản xuất hiện trong bảng kết quả được đối chiếu.
Các lệnh dưới đây được đối chiếu với tài liệu và script công khai ngày 11/10/2026. Đây là hướng dẫn triển khai; các con số kết quả là số liệu tác giả công bố, không phải benchmark do VnRobo tự chạy. Đặc biệt, hàng SmolVLA của paper là Single Task. Đừng diễn giải nó thành một checkpoint đa nhiệm đã được training giống hệt hai model còn lại.
1. Ý tưởng nghiên cứu: đánh giá từng năng lực
Một benchmark chỉ thay màu vật hoặc đổi vị trí trên bàn có thể bỏ sót nhiều điểm yếu. RoboDojo chia tác vụ thành năm nhóm năng lực, giúp người đọc biết policy thất bại ở đâu. Bạn có thể xem thông số từng tác vụ trong danh mục simulation chính thức.
| Nhóm | Số tác vụ | Câu hỏi kiểm tra | Ví dụ |
|---|---|---|---|
| Generalization | 12 | Kỹ năng có chịu được thay đổi cảnh không? | stack_bowls, fold_clothes |
| Memory | 6 | Policy có dùng thông tin từng nhìn thấy không? | cover_blocks, swap_T |
| Precision | 8 | Điều khiển có đủ chính xác khi tiếp xúc không? | insert_tubes, deposit_coin |
| Long-Horizon | 8 | Nhiều bước có nối thành công việc hoàn chỉnh không? | organize_table, fill_egg_holder |
| Open | 8 | Có xử lý yêu cầu chưa có demonstration tác vụ không? | solve_equation, pour_by_language |
Ở cover_blocks, robot phải nhớ màu dưới các nắp sau khi che chúng. Một model chỉ nhìn frame hiện tại sẽ thiếu thông tin cần thiết. Ở insert_tubes, nhận diện đúng ống chưa đủ: hướng và vị trí cuối cùng phải phù hợp giá đỡ. Ở organize_table, sai ở bước đầu có thể làm toàn bộ chuỗi sau thất bại.
Open là nhóm evaluation-only theo thiết kế dữ liệu tác vụ. Không đưa demonstration của chính các tác vụ Open vào tập fine-tune rồi gọi kết quả là open generalization. Ngược lại, các tác vụ còn lại cho phép học từ demonstration được phát hành theo protocol.

Nguồn ảnh: paper RoboDojo, hình tổng hợp tác vụ mô phỏng. Ảnh bìa sử dụng teaser khác từ README của dự án.
2. Kiến trúc: simulator và policy chạy riêng
Hãy hình dung simulator là nơi dựng bàn, vật và robot; policy server là nơi chạy model. Simulator gửi ảnh, trạng thái robot và instruction. Server chuyển chúng sang định dạng model, dự đoán action chunk rồi trả về. Simulator thực thi các action và tiếp tục quan sát.
Isaac Sim / Isaac Lab
  scene + robot + cameras + task success checker
                 |
       observation / instruction
                 v
XPolicyLab client <--- WebSocket ---> policy server
                                      |
                               model adapter
                                      |
                         π0.5 / SmolVLA / GR00T
                                      |
                               action chunk
                 <--------------------+
XPolicyLab chuẩn hóa các phương thức như update_obs, get_action, các phiên bản batch và reset. reset() xóa trạng thái model giữa các episode. Nếu memory của episode trước lọt sang episode sau, phép đo không còn độc lập.
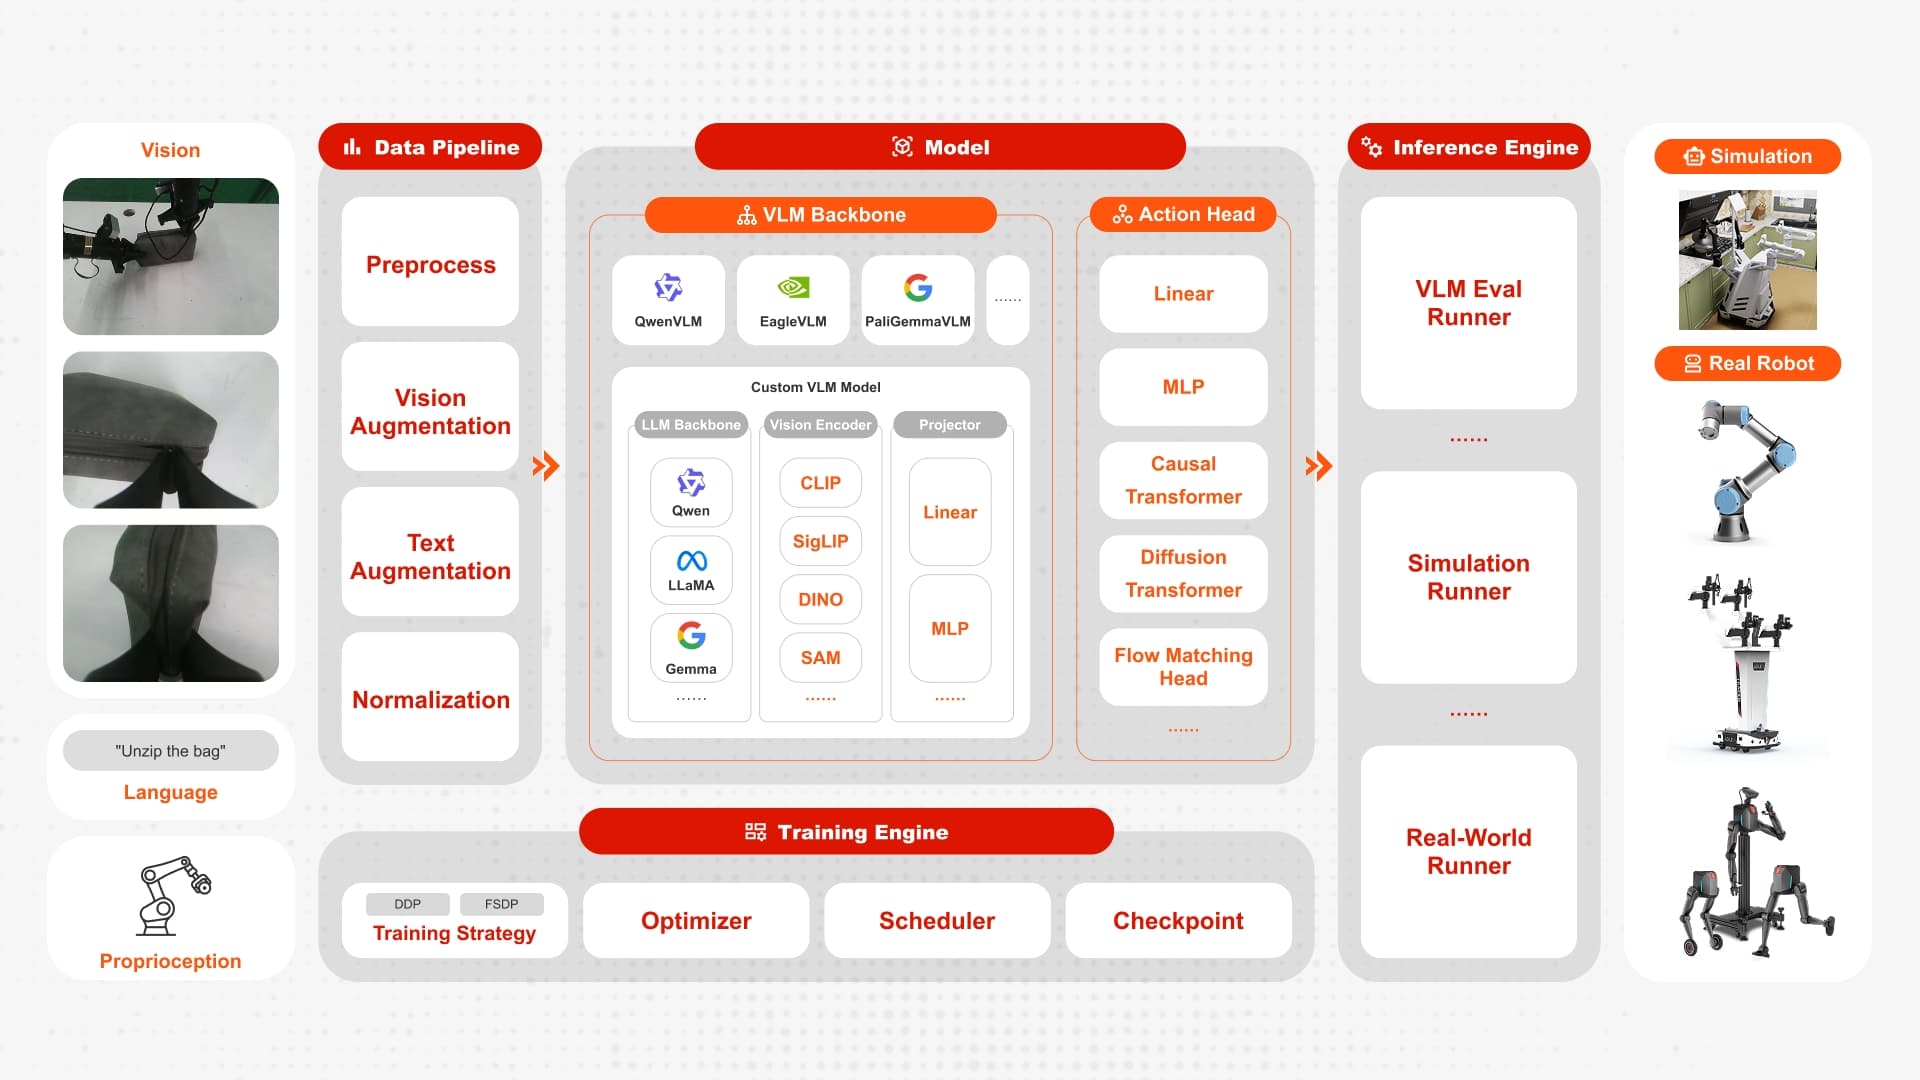
Tách môi trường cũng giải quyết xung đột dependencies. π0.5 dùng OpenPI với môi trường uv; SmolVLA dùng LeRobot và conda; adapter GR00T-N1.7 cũng có stack uv riêng. Không cài cả ba vào conda environment của Isaac Sim rồi kỳ vọng mọi phiên bản thư viện tương thích.
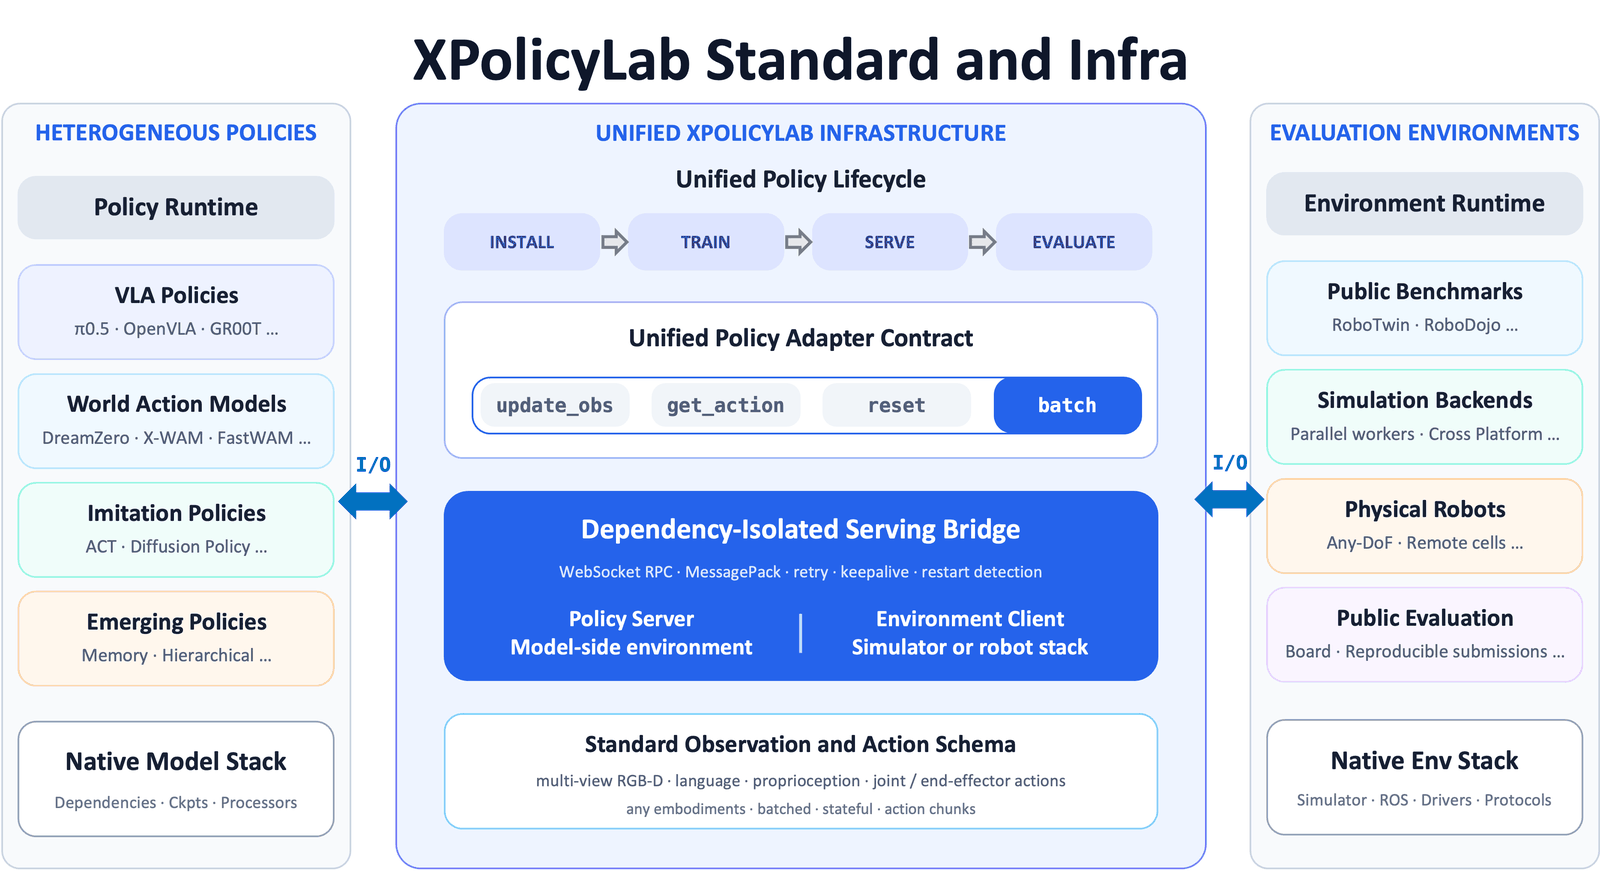
Nguồn ảnh: assets/infra.png trong repo XPolicyLab.
Ba policy khác nhau ở điểm nào?
π0.5 kết hợp hiểu ảnh/ngôn ngữ với sinh action liên tục. Bản OpenPI công khai hỗ trợ flow matching head cho training và inference. Điều này có nghĩa model học cách biến một mẫu action nhiễu thành chuỗi action có điều kiện theo observation; nó không chỉ sinh câu trả lời văn bản. Xem OpenPI chính thức.
SmolVLA hướng tới giảm chi phí model, dùng vision-language backbone nhỏ và action expert để sinh action chunk. Thiết kế có các lựa chọn tăng hiệu quả như giảm số visual token và xử lý suy luận bất đồng bộ. Tuy nhiên, benchmark phải ghi đúng cơ chế adapter đang dùng; không tự coi mọi lần chạy XPolicyLab đã bật asynchronous inference. Xem giải thích kiến trúc của Hugging Face.
GR00T-N1.7 là foundation policy của NVIDIA. Trong adapter được đọc, base checkpoint là nvidia/GR00T-N1.7-3B, cùng cấu hình Cosmos riêng. Khi dùng, cần kiểm tra modality config và embodiment_tag, vì chúng xác định cách camera, state và action của robot được ánh xạ vào model. Không dùng tên chung “GR00T” để trộn kết quả N1, N1.5 và N1.7. Nguồn triển khai: adapter GR00T_N17.
3. Chuẩn bị máy và cài simulator
Hướng dẫn cài đặt RoboDojo khuyến nghị Ubuntu 22.04 x64, RAM từ 32 GB, GPU NVIDIA với VRAM từ 16 GB, driver Linux 570 hoặc 580 và CUDA 12.8. Đây là yêu cầu môi trường mô phỏng, không phải lời hứa rằng cùng GPU đó đủ full fine-tune mọi VLA.
OpenPI liệt kê mức tham khảo cao hơn cho training: LoRA cần trên 22,5 GB và full fine-tuning trên 70 GB VRAM ở cấu hình một GPU. Nếu simulator và policy cùng dùng một GPU, cả hai cùng chiếm bộ nhớ. Người mới nên chạy một episode trước, đo bộ nhớ thực tế rồi mới tăng parallelism.
Các lệnh sau dành cho máy benchmark của bạn, từ thư mục làm việc riêng:
sudo apt install libvulkan1 mesa-vulkan-drivers vulkan-tools git-lfs
vulkaninfo | head
git lfs install
git clone https://github.com/RoboDojo-Benchmark/RoboDojo.git
cd RoboDojo
bash scripts/install.sh -i
conda activate RoboDojo
bash scripts/init_assets.sh
python utils/update_embodiment_config_path.py
bash scripts/robodojo.sh doctor
bash scripts/robodojo.sh dimensions
install.sh dựng environment và dependencies; init_assets.sh lấy asset; lệnh Python cập nhật đường dẫn robot tới asset cục bộ. Thiếu bước cuối có thể làm simulator báo không tìm thấy USD dù việc download đã hoàn tất. Nếu di chuyển repo, chạy lại bước cập nhật đường dẫn.
Installer hiện có bước cập nhật submodule từ remote. Vì vậy, lưu revision thực tế của RoboDojo và XPolicyLab sau khi cài, cùng phiên bản dataset và checkpoint, vào ghi chép thí nghiệm. README báo bản sửa ngày 16–17/09/2026 liên quan frame observation và thứ tự kênh RGB, yêu cầu XPolicyLab từ commit bb9a0b5 trở lên. Kết hợp code mới với dữ liệu cũ có thể tạo một lỗi trông giống model yếu.
4. Chọn dữ liệu và kiểm tra action alignment
Không cần tải toàn bộ dữ liệu để kiểm tra server chạy được. Script cho phép tải demo khoảng 1,5 GB; LeRobot v3.0 joint-only khoảng 120 GB; HDF5 đầy đủ khoảng 523 GB. Depth export khoảng 4,5 TB, không phải lựa chọn khởi đầu hợp lý nếu chỉ cần RGB benchmark. Kích thước được ghi trong script download dữ liệu.
# Từ thư mục gốc RoboDojo; chọn dữ liệu phù hợp nhu cầu.
bash scripts/RoboDojo/download_data.sh huggingface demo

# Cho training từ export joint-only chuẩn:
bash scripts/RoboDojo/download_data.sh huggingface lerobot_v3.0
Demo là một bundle nhỏ, không mặc nhiên chứa đủ mọi tác vụ bạn muốn training. Kiểm tra task thực tế trước khi chọn nó làm nguồn. Nếu dùng conversion của π0.5 từ demonstration HDF5, cần có HDF5 cho các task tương ứng; một export LeRobot tải sẵn không tự thay thế đường dẫn raw của mọi converter.
Ba camera chuẩn trong LeRobot export là observation.images.cam_high, cam_left_wrist và cam_right_wrist dưới cùng namespace ảnh. SmolVLA adapter rename chúng sang tên nội bộ khi load, nên đừng đổi key trên đĩa tùy tiện. observation.state và action cũng phải khớp với action mode.
Với HDF5 simulation, state[t] là trạng thái hiện tại còn action[t] là absolute target cho frame kế tiếp; các trường joint/gripper dùng quan hệ action[t] = state[t+1], ngoại trừ padding frame cuối. Không trừ tiếp state để biến action thành delta nếu adapter yêu cầu absolute joint target. EE pose dùng thứ tự quaternion và hệ tọa độ được mô tả trong tài liệu, không được đoán theo một dataset khác.
Một kiểm tra đơn giản nhưng hữu ích: mở preview ba camera, đọc instruction, rồi quan sát vài hàng state/action. Nếu bàn tay trái trong ảnh chuyển động nhưng trường joint bên phải thay đổi, hãy sửa mapping trước khi training hàng chục nghìn bước.
5. Training: workflow thực hành và protocol paper
Bạn có hai đường: tải checkpoint benchmark có sẵn để đánh giá, hoặc fine-tune checkpoint nền từ demonstration. Đường thứ nhất giúp kiểm tra pipeline trước khi đầu tư GPU training.
# Từ thư mục gốc; adapter phải tồn tại trước.
bash scripts/RoboDojo/download_ckpt.sh huggingface Pi_05
bash scripts/RoboDojo/download_ckpt.sh huggingface SmolVLA
bash scripts/RoboDojo/download_ckpt.sh huggingface GR00T_N17
Downloader kiểm tra tên policy và thư mục remote. Nếu checkpoint không tồn tại trên mirror đã chọn, nó báo lỗi; không coi lỗi download là bước đã hoàn thành. Sau khi tải, xem thư mục checkpoints của từng adapter để xác định tên run và checkpoint step chính xác.
π0.5: conversion trong stack OpenPI
README Pi_05 cho phép chọn nguồn task khi chuyển HDF5 sang LeRobot. Ví dụ dưới đây là single-task exercise, cần raw demonstration stack_bowls trước khi chạy:
cd XPolicyLab/policy/Pi_05
bash install.sh
bash process_data.sh RoboDojo stack_bowls arx_x5 joint
bash train.sh RoboDojo stack_bowls arx_x5 joint 0 0
Tên run theo quy ước là RoboDojo-stack_bowls-arx_x5-joint-0. Tham số cuối là GPU training; số 0 trước nó là seed. Model này chỉ phục vụ bài tập một task, không tái tạo hàng π0.5 đa nhiệm của paper. Để training đa nhiệm, chuẩn bị đúng tập demonstration, đặt repo ID phù hợp và kiểm tra OPENPI_TRAIN_CONFIG_NAME cùng OPENPI_LEROBOT_REPO_ID.
SmolVLA: sử dụng LeRobot v3.0
README SmolVLA không có top-level process_data.sh. train.sh dùng dataset repo ID; mặc định tên task được ánh xạ thành tên như RoboDojo_sim_build_tower_v30. Đặt export đó trong cache HF_LEROBOT_HOME hoặc chỉ định SMOVLA_REPO_ID theo dataset thực tế của bạn.
cd XPolicyLab/policy/SmolVLA
bash install.sh
# Chỉ chạy sau khi repo ID và cache chứa đúng dataset build_tower.
bash train.sh RoboDojo build_tower arx_x5 joint 0 0
Checkpoint LeRobot còn có thư mục step bên trong. Kiểm tra checkpoint_num trong deploy.yml; nếu đánh giá một step khác, bạn đang đánh giá model khác dù tên run không đổi.
GR00T-N1.7: kiểm tra conversion và modality
GR00T adapter yêu cầu GR00T_LEROBOT_HOME trỏ tới nơi chứa dataset nguồn. Theo README hiện tại, converter copy export v3.0 rồi downgrade sang v2.1; nguồn mặc định cho arx_x5 là RoboDojo_sim_arx-x5_v30.
cd XPolicyLab/policy/GR00T_N17
bash install.sh
export GR00T_LEROBOT_HOME=/absolute/path/to/lerobot/datasets
bash process_data.sh RoboDojo cotrain arx_x5 joint
bash train.sh RoboDojo cotrain arx_x5 joint 0 0
Thay đường dẫn ví dụ bằng thư mục thật. Tham số expert_data_num của converter GR00T được giữ để tương thích nhưng không thực hiện subsetting episode. Muốn thử nghiệm 50 demonstration, tạo dataset subset thật rồi trỏ GR00T_SRC_DATASET tới đó; đặt tên run “50ep” không tự giảm dữ liệu.
Các cấu hình paper được công bố như sau, độc lập với ví dụ nhỏ ở trên:
| Policy | Batch size simulation | Training steps | Điểm cần giữ |
|---|---|---|---|
| π0.5 | 256 | 60.000 | Fine-tune từ pi05_base |
| SmolVLA Single Task | 512 | 100.000 | Giữ nhãn single-task |
| GR00T-N1.7 | 640 | 100.000 | Khớp embodiment và modality |
Nguồn: paper, Appendix K. Khác batch size, bước training và phạm vi task nghĩa là đây không phải thí nghiệm kiểm soát riêng yếu tố kiến trúc. Nếu bạn đổi sang LoRA hoặc giảm batch, báo thành một recipe khác.
6. Inference: từ một episode tới toàn benchmark
Trước khi chạy, kiểm tra deploy.yml: checkpoint, camera transform, action mode và environment. π0.5 dùng giá trị uv cho policy environment; SmolVLA thường là conda smolvla; GR00T có thể dùng uv. Chọn joint cho ví dụ dưới đây vì dataset và checkpoint phải khớp absolute joint action.
Ví dụ này dùng checkpoint π0.5 single-task vừa training. Nếu dùng checkpoint tải sẵn, thay --ckpt bằng tên run thật và kiểm tra các thiết lập deployment đi kèm.
# Quay về thư mục gốc RoboDojo trước khi chạy.
export EVAL_ENV_TYPE=sim
bash scripts/robodojo.sh eval \
  --policy-dir XPolicyLab/policy/Pi_05 \
  --task stack_bowls \
  --ckpt RoboDojo-stack_bowls-arx_x5-joint-0 \
  --policy-env uv --eval-env RoboDojo \
  --env-cfg arx_x5 --action-type joint \
  --seed 0 --policy-gpu 0 --env-gpu 0 \
  --eval-num 1 --dry-run
--dry-run in lệnh dispatch mà chưa inference. Khi tham số đúng, bỏ cờ đó để chạy một episode thật. Xem video: robot có nhìn đúng camera, đóng đúng gripper và di chuyển đúng bên không? Một run hoàn thành không có nghĩa task thành công; đó chỉ là bằng chứng pipeline thực thi được.
Sau smoke test, chỉ dùng checkpoint có phạm vi training phù hợp cho toàn benchmark. Lệnh sau là template: thay hai giá trị viết hoa bằng policy directory và run thật.
bash scripts/robodojo.sh benchmark \
  --policy-dir XPolicyLab/policy/POLICY_DIRECTORY \
  --ckpt ACTUAL_CHECKPOINT_NAME \
  --policy-env uv --eval-env RoboDojo \
  --env-cfg arx_x5 --action-type joint \
  --seed 0 --eval-num native
bash scripts/robodojo.sh summarize
Đổi --policy-env sang smolvla nếu adapter đó dùng conda mặc định. native lấy số episode theo cấu hình task, còn --eval-num 1 hoặc 5 chỉ phục vụ debug. Dùng dimensions để xem task runnable: các biến thể _random của Generalization có thể làm danh sách dispatch dài hơn 42 tên task khái niệm.

Nguồn ảnh: figure về heterogeneous parallel simulation trong paper.
Mô phỏng song song giúp giảm thời gian chờ nhưng tăng nhu cầu VRAM. Bắt đầu sequential, sau đó dùng tùy chọn multi-GPU theo Quick Evaluation. Đừng tăng số worker chỉ vì máy có nhiều CPU: rendering và policy inference thường cạnh tranh tài nguyên GPU.
7. Kết quả: đọc cả score lẫn success rate
Bảng dưới lấy từ snapshot paper ngày 03/07/2026, không phải thứ hạng live ngày xuất bản bài này. Mỗi ô ghi score / success rate; score cho phép phản ánh tiến độ theo tiêu chí task, còn success rate đo hoàn thành đầy đủ.
| Policy | Generalization | Precision | Long-Horizon | Memory | Open | Average |
|---|---|---|---|---|---|---|
| π0.5 | 13,37 / 8,17% | 12,40 / 5,50% | 23,54 / 14,67% | 5,78 / 4,56% | 1,98 / 1,67% | 11,41 / 6,91% |
| GR00T-N1.7 | 2,16 / 1,22% | 2,54 / 0,67% | 8,30 / 3,58% | 1,06 / 0,89% | 0,18 / 0,17% | 2,85 / 1,31% |
| SmolVLA Single Task | 1,69 / 1,22% | 2,87 / 0,33% | 1,22 / 0,25% | 3,35 / 2,44% | 0,00 / 0,00% | 1,83 / 0,85% |
Nguồn: paper RoboDojo, Table 1. Kết quả mới nằm trên leaderboard chính thức; không trộn hàng cập nhật sau này với snapshot này mà bỏ ngày và recipe.
Average được tính bằng trung bình năm nhóm năng lực, không phải chia tổng số thành công cho toàn bộ episode. Vì số task từng nhóm khác nhau, hai phép tính sẽ cho kết quả khác. Chỉ một nhóm nhiều task có điểm cao chưa đủ đảm bảo Average cao.
Paper mô tả phần lớn policy được training với ba seed, mỗi seed đánh giá 50 trial/task; Generalization chia 25 standard và 25 randomized. Khi tái lập, phân biệt seed training với seed/layout evaluation. Chạy ba layout trên cùng một checkpoint không tương đương training ba model độc lập.
Trong ba hàng này, π0.5 có Average tốt nhất. Tuy nhiên, 6,91% success rate vẫn thấp: benchmark đang bộc lộ hạn chế, không xác nhận một hệ thống sẵn sàng vận hành tin cậy. SmolVLA có Memory success cao hơn GR00T trong snapshot nhưng Precision success thấp hơn. Điều đó khuyến khích phân tích theo task, thay vì kết luận một model luôn tốt hơn model khác trong mọi tình huống.
8. Gỡ lỗi và thiết kế so sánh công bằng
Nếu tất cả task đều thất bại ngay lập tức, ưu tiên kiểm tra pipeline. Tìm lỗi thiếu asset qua doctor; xem log policy server khi model không load; xác nhận tên checkpoint và step; mở RGB preview để phát hiện đảo kênh; kiểm tra joint/EE và thứ tự gripper. Dùng decoder chính thức khi đọc JPEG bytes, tránh tự thêm thao tác đổi BGR/RGB theo thói quen OpenCV.
Nếu robot làm đúng bước đầu nhưng thất bại ở bước sau, xem action chunk và điều kiện re-observation. Chunk dài có thể giảm số lần gọi model nhưng kéo dài thời gian robot chưa nhận phản hồi mới. Đây là giả thuyết cần thử nghiệm, không phải kết luận nguyên nhân từ video duy nhất. Giữ checkpoint cố định, thay một tham số và chạy lại cùng tập layout.
Một báo cáo hữu ích cần task list, phiên bản asset/dataset, action mode, camera mapping, training recipe, checkpoint step, seed và số trial; sau đó mới tới score, success rate, độ biến thiên, latency và VRAM. Lưu video thất bại cùng video thành công. Nếu chỉ báo “π0.5 thắng”, người khác không biết thắng nhờ model, dữ liệu hay cấu hình evaluation.
Để công bố chính thức, làm theo protocol submission và xác nhận yêu cầu hiện hành: chạy cục bộ chỉ tạo kết quả nội bộ, không tự trở thành verified leaderboard entry. Đánh giá mô phỏng cũng chưa thay thế thử nghiệm trên robot thật với camera, tiếp xúc và cơ cấu tương ứng.
Mục tiêu thực hành đầu tiên là một episode có observation đúng, action đúng và video giải thích được. Sau đó hoàn thành một task, một nhóm năng lực, rồi mở rộng ra 42 task theo protocol. Cách tiến dần này giúp mỗi lần tăng chi phí GPU trả lời được một câu hỏi kỹ thuật cụ thể.