Fine-tune UnifoLM-WLA-1.0 cho Unitree G1: từ tabletop đến whole-body manipulation
UnifoLM-WLA-1.0 là bước nâng cấp quan trọng của Unitree so với dòng UnifoLM-VLA cũ: thay vì chỉ nói về một action head cho tabletop manipulation, release mới gom perception, embodied reasoning, interaction-centric world modeling và action generation vào một pipeline mở hơn. Theo repo chính thức, model có khoảng 6B tham số, được huấn luyện trên khoảng 2.500 giờ dữ liệu robot thật, điều phối 64 task trên Unitree G1, gồm 54 tabletop manipulation task và 10 whole-body manipulation task.
Điểm hay cho người mới là Unitree không chỉ thả một video demo. Họ đã mở repo, checkpoint UnifoLM-WLA-1.0-Base, các model reasoner UnifoLM-ER-1 và UnifoLM-ER-Flow, dataset collection Dex1/WBT, tài liệu action-state processing, script evaluation, script fine-tune full và script LoRA. Nếu bạn từng đọc series unifolm-vla + G1 architecture hoặc bài fine-tune unifolm-vla trên G1, hãy xem bài này như bản 2026 thực dụng hơn: checkpoint nền đã public, data format rõ ràng hơn, và whole-body action space không còn là phần phụ.
UnifoLM-WLA-1.0 giải quyết bài toán gì?
Vấn đề của humanoid manipulation không chỉ là cánh tay. Với một G1 đang đứng trước bàn, policy phải nhìn object, hiểu instruction, biết object nào sẽ thay đổi, giữ thăng bằng, chọn quỹ đạo tay, điều khiển gripper hoặc dexterous hand, đồng thời không ra lệnh chân/waist/torso làm robot mất ổn định. Với tabletop task đơn giản, bạn có thể khóa lower body rồi điều khiển hai tay. Với whole-body manipulation như nhặt gối, sắp xếp kệ, làm giường, đặt đĩa vào máy rửa, robot phải dùng toàn thân: base, torso, waist, arm, hand, leg state.
UnifoLM-WLA-1.0 tách bài toán thành ba lớp:
| Lớp | Vai trò | Thành phần chính |
|---|---|---|
| Embodied Reasoner | Hiểu ảnh, instruction, vị trí, quan hệ không gian, object tương tác | UnifoLM-ER-1, dựa trên Qwen3-VL-4B |
| Interaction/world modeling | Dự đoán vùng nào sẽ thay đổi trong tương lai | optical flow, dynamic mask, VQ-VAE token |
| WLA action expert | Sinh continuous action chunk cho robot | UnifoLM-ER-Flow + MMDiT action expert |
Project page mô tả UnifoLM-ER-1 được train trên hơn 5 triệu mẫu, gồm image point prediction, object detection, multi-image reasoning, 2D trajectory prediction, 3D object detection và spatial QA. Sau đó UnifoLM-ER-Flow thêm discrete action token và future dynamic-region mask token để nối ngôn ngữ, hình ảnh và hành động. Lớp WLA phía sau dùng MMDiT flow decoder để sinh action liên tục.
Ý tưởng paper/project: nhìn vùng thay đổi trước khi ra hành động
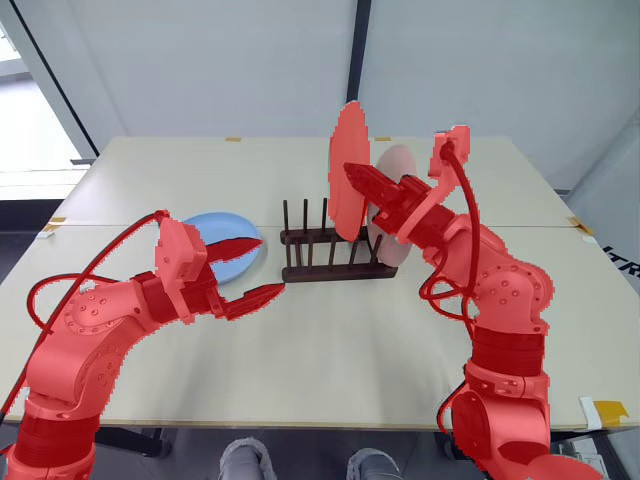
Tài liệu chính thức hiện là project page + repo kỹ thuật, chưa thấy một arXiv paper độc lập cho WLA-1.0 tại thời điểm viết bài. Nhưng ý tưởng nghiên cứu đã khá rõ: muốn robot thao tác tốt, VLM không nên chỉ trả lời "vật ở đâu"; nó cần học xem hành động sẽ làm cảnh thay đổi ở đâu. Unitree dùng optical flow giữa frame t0 và t1 để tách vùng động, rồi dùng VQ-VAE rời rạc hóa dynamic mask thành token. Condition là ảnh hiện tại và instruction/action. VLM học dự đoán token của vùng tương lai.
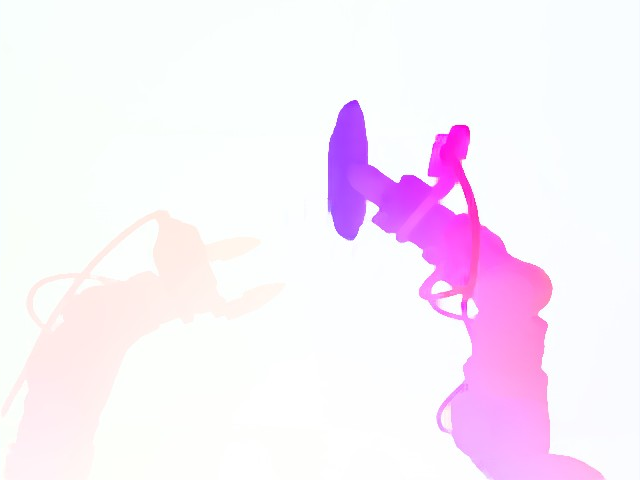
Sau đó action cũng được rời rạc hóa theo ba nhóm: end-effector pose, end-effector joint/gripper/dexterous hand, và lower-body motion. RVQ tạo token như EEF, HAND, LOWER, giúp VLM học alignment thời gian giữa ảnh, prompt, state và action. Khi sang WLA model, phần action expert không chỉ copy discrete token, mà học sinh continuous action chunk để điều khiển robot thật.
Điểm cần nhớ: đây không phải "LLM gọi API robot". Đây là imitation/diffusion-style policy có ngôn ngữ làm điều kiện. Ngôn ngữ giúp chọn task; state và camera giúp xác định tình huống hiện tại; action head sinh lệnh robot.
Kiến trúc cần hiểu trước khi fine-tune
Checkpoint UnifoLM-WLA-1.0-Base chứa VLM, tokenizer/config, action model và statistics. Config fine-tune mặc định dùng framework QwenMMDiT. Phần VLM có hidden dimension 2560 và dùng flash_attention_2. Robot-state projector bật mặc định, nhận input 120 chiều. Action model là DiT-L, hidden size 1024, 16 layer, 32 attention head, action dimension 54, action horizon 30, và inference dùng 4 diffusion timesteps.
Bạn không cần thuộc hết các con số này, nhưng cần hiểu ý nghĩa:
| Cấu hình | Ý nghĩa thực tế |
|---|---|
action_dim: 54 |
Mỗi timestep sinh vector hành động 54 chiều |
action_horizon: 30 |
Mỗi lần policy dự đoán một chunk 30 bước |
target_fps: 30 |
Chunk mặc định phủ khoảng 1 giây |
robot_state_projector.input_dim: 120 |
60 state + 60 validity mask |
freeze_modules: qwen_vl_interface |
Fine-tune mặc định đóng băng VLM, train action expert và state projector |
per_device_batch_size: 1 + gradient_accumulation_steps: 8 |
Cấu hình nhắm tới một GPU 24GB |
Tài liệu action-state processing là phần quan trọng nhất nếu bạn tự thu data. Action vector 54 chiều gồm left/right end-effector, gripper, dexterous hand, waist, torso, base velocity, base pose, height và leg action. State vector 60 chiều gồm pose tay trái/phải dạng xyz + rotation-6D, gripper/hand state, waist, torso, base velocity, gravity direction, angular velocity, height và joint chân. Model-facing state là 120 chiều vì nối thêm validity mask để model biết module nào có thật trên embodiment hiện tại.
Nếu bạn đã quen với whole-body VLA teleop pipeline, hãy xem UnifoLM-WLA như một chuẩn hóa mạnh tay hơn: mọi embodiment được ép về các slot thống nhất, còn mask nói cho model biết slot nào có dữ liệu.
Chuẩn bị máy và repo
Bạn cần một Linux box có NVIDIA GPU. Fine-tune full action expert mặc định nhắm tới một GPU 24GB. Nếu ít VRAM hơn, giảm batch size, giảm worker, hoặc dùng LoRA. Nếu muốn mở khóa VLM để co-train, hãy chuẩn bị nhiều VRAM hơn đáng kể.
mkdir -p ~/robot_ws
cd ~/robot_ws

git clone https://github.com/unitreerobotics/unifolm-wla.git
cd unifolm-wla

curl -LsSf https://astral.sh/uv/install.sh | sh
uv sync
uv pip install flash-attn --no-build-isolation
source .venv/bin/activate
Kiểm tra nhanh:
python -c "import torch; print(torch.cuda.is_available())"
python -c "import unifolm_wla; print('unifolm_wla import ok')"
hf --help | head
Nếu flash-attn build fail, thường là do CUDA/PyTorch mismatch. Với beginner, cách dễ nhất là dùng image CUDA/PyTorch ổn định hoặc thuê cloud GPU đã có PyTorch + CUDA khớp phiên bản. Đừng bắt đầu bằng việc debug driver trên máy production của robot.
Tải checkpoint và dataset
Tải checkpoint nền:
hf download unitreerobotics/UnifoLM-WLA-1.0-Base \
  --local-dir playground/Pretrained_models/UnifoLM-WLA-1.0-Base
Layout đúng phải có:
UnifoLM-WLA-1.0-Base/
├── checkpoints/
│   └── model.safetensors
├── config.yaml
├── dataset_statistics.json
└── tokenizer/
Với data, Unitree chia thành nhiều dataset repo. Dex1 là nhóm tabletop/two-finger hoặc dexterous tabletop; WBT là whole-body teleoperation/manipulation. Ví dụ:
export DATA_ROOT=$HOME/unifolm_data

hf download unitreerobotics/G1_Dex1_Stack_Block --repo-type dataset \
  --local-dir $DATA_ROOT/UnifoLM_G1_Dex1_Dataset/G1_Dex1_Stack_Block

hf download unitreerobotics/G1_WBT_Brainco_Make_The_Bed --repo-type dataset \
  --local-dir $DATA_ROOT/UnifoLM_WBT_Dataset/G1_WBT_Brainco_Make_The_Bed
Tổ chức thư mục nên giống tài liệu gốc:
$DATA_ROOT/
├── UnifoLM_G1_Dex1_Dataset/
│   ├── G1_Dex1_Stack_Block/
│   └── G1_Dex1_Wipe_Table/
└── UnifoLM_WBT_Dataset/
    ├── G1_WBT_Brainco_Make_The_Bed/
    └── G1_WBT_Brainco_Pickup_Pillow/
Collection Hugging Face hiện liệt kê hàng chục task Dex1 và WBT. Dex1 có các task như Stack_Block, Fold_Towel, Organize_Tools, Pour_Drink, Open_Bottle_Cap. WBT có các task như Make_The_Bed, Pickup_Pillow, Collect_Plates_Into_Dishwasher, Put_Clothes_into_Washing_Machine. Với bài tập đầu tiên, chọn 1-2 task gần task bạn muốn fine-tune. Không nên trộn 20 task ngay từ đầu vì bạn sẽ khó biết lỗi đến từ schema, data hay training.
Cấu hình unitree.yaml
Trong repo, file config dataset cần trỏ về root data và cache. Ý tưởng:
data_base: "/home/user/unifolm_data"
cache_dir: "/home/user/unifolm_cache"

datasets:
  - <<: *unitree_base
    name: "unifolm_g1_dex1"
    data_path: "UnifoLM_G1_Dex1_Dataset"
    image_keys: *unitree_img_with_stereo

  - <<: *unitree_fullbody_base
    name: "unifolm_wbt"
    data_path: "UnifoLM_WBT_Dataset"
    image_keys: *unitree_img_wo_stereo
Hai lỗi beginner hay gặp:
| Lỗi | Triệu chứng | Cách sửa |
|---|---|---|
| Sai đơn vị | Loss giảm nhưng action deploy bị giật, scale sai | Convert về meter, radian, m/s, rad/s |
| Sai quaternion order | End-effector xoay lạ, pose plot méo | Dùng xyzw, không phải wxyz |
| Sai left/right convention | Robot làm ngược bên | Không mirror trục tay phải; cả hai tay cùng base frame |
| Thiếu statistics | Eval chạy nhưng denormalize sai | Giữ dataset_statistics.json cùng layout checkpoint |
| Data WBT nhưng server Dex1 | Không có base/finger action khi serve | Mở rộng adapter/protocol trước khi deploy WBT |
Chạy evaluation trước khi train
Trước khi fine-tune, hãy chạy evaluation local để chắc checkpoint, config và data đọc được:
python -m examples.unifolm_wla.eval_files.unitree.eval_local_episode \
  --ckpt_path playground/Pretrained_models/UnifoLM-WLA-1.0-Base/checkpoints/model.safetensors \
  --data_config_path unifolm_wla/dataloader/multi_source_dataset/configs/unitree.yaml \
  --episode_idx 0 \
  --save_dir results/eval_local_episode
Script này chạy checkpoint theo từng chunk trên một episode và plot predicted vs ground-truth action. Đây là sanity check tốt hơn nhiều so với nhìn loss. Nếu plot end-effector relative pose lệch hoàn toàn, hãy dừng lại kiểm schema. Nếu plot bám được xu hướng nhưng biên độ sai, kiểm normalization và statistics. Nếu chỉ một module sai, ví dụ gripper hoặc right leg, kiểm slice mapping của module đó.
Fine-tune full action expert
Fine-tune mặc định đóng băng VLM, chỉ train action expert MMDiT và robot-state projector. Đây là lựa chọn hợp lý cho beginner vì giữ perception/language prior ổn định, giảm VRAM, và tránh làm model quên khả năng spatial reasoning.
base_model_dir=playground/Pretrained_models/UnifoLM-WLA-1.0-Base \
bash examples/unifolm_wla/train_files/run_finetune_mmdit_frozen_vlm.sh
Các tham số đáng chỉnh trong unifolm_wla/config/training/mmdit_finetune_frozen_vlm.yaml:
| Tham số | Mặc định | Khi nào chỉnh |
|---|---|---|
max_train_steps |
20000 | Giảm xuống 2000-5000 để smoke test |
save_interval |
2000 | Giảm nếu muốn checkpoint sớm |
learning_rate.base |
1e-4 |
Giảm nếu loss dao động mạnh |
per_device_batch_size |
1 | Giữ 1 nếu GPU 24GB |
gradient_accumulation_steps |
8 | Tăng nếu muốn effective batch lớn hơn |
freeze_modules |
qwen_vl_interface |
Xóa chỉ khi có nhiều VRAM và data đủ lớn |
Với task nhỏ, hãy chạy ba pha:
- Smoke test 200-500 step: mục tiêu là không crash, cache data đúng, loss finite.
- Pilot 2.000-5.000 step: xem plot evaluation có cải thiện không.
- Run chính 20.000 step: chỉ chạy khi schema và metric đã rõ.
Đừng deploy lên robot thật chỉ vì training loss giảm. Với humanoid, một action channel sai scale cũng đủ tạo chuyển động nguy hiểm. Hãy đọc thêm hướng kiểm tra low-level ở cuRobo + G1 whole-body planning nếu bạn cần một lớp motion/planning safety bên dưới policy.
LoRA fine-tune khi ít VRAM hoặc ít data
Repo có config LoRA cho qwen_vl_interface và action_model. Với beginner, lựa chọn an toàn là giữ VLM frozen và LoRA action model:
base_model_dir=playground/Pretrained_models/UnifoLM-WLA-1.0-Base \
bash examples/unifolm_wla/train_files/run_lora_finetune_mmdit_frozen_vlm.sh
Block LoRA mẫu:
trainer:
  lora:
    enabled: true
    action_model:
      enabled: true
      r: 16
      lora_alpha: 32
      lora_dropout: 0.05
      target_modules: ["to_q", "to_k", "to_v", "to_out.0", "add_q_proj", "add_k_proj", "add_v_proj", "to_add_out"]
      bias: "none"
LoRA ghi ra adapter checkpoint nhỏ như adapter.safetensors hoặc steps_<n>_adapter.safetensors. Đây là artifact dễ chia sẻ hơn full checkpoint. Nếu bạn fine-tune một task tabletop mới với vài trăm episode, LoRA thường là điểm bắt đầu hợp lý. Nếu bạn muốn đổi embodiment, thêm hand mới, hoặc fine-tune WBT phức tạp, full action expert có thể cần thiết.
Inference và giới hạn hiện tại của model server
Repo có server:
python -m model_server.action_server_wbc_msgpack_unitree \
  --ckpt_path playground/Pretrained_models/UnifoLM-WLA-1.0-Base/checkpoints/model.safetensors \
  --host 0.0.0.0 --port 8600 \
  --instruction "pick up the object"
Sau đó có thể chạy evaluator client:
python -m model_server.eval_local_episode_wbc_msgpack_server_only \
  --ckpt_path playground/Pretrained_models/UnifoLM-WLA-1.0-Base/checkpoints/model.safetensors \
  --data_config_path unifolm_wla/dataloader/multi_source_dataset/configs/unitree.yaml \
  --host 127.0.0.1 --port 8600 \
  --episode_idx 0 \
  --save_dir results/eval_local_episode_wbc_msgpack
Nhưng tài liệu gốc ghi rõ server hiện tại là Dex1 only. Adapter _ACTIVE_SLOT_SPECS mirror unitree_base, chưa có left_fig6d, right_fig6d và base_pose, tức các field quan trọng cho WBT. Muốn serve checkpoint WBT, bạn cần mở rộng slot spec và protocol encode/decode để mang finger angles, base pose và action keys tương ứng. Vì vậy trong bài này, inference an toàn cho beginner là local evaluation hoặc Dex1 server; whole-body live deploy cần thêm engineering.
Đọc kết quả như thế nào?
Kết quả chính thức có ba tầng. Tầng embodied reasoning: project page báo UnifoLM-ER-1-4B dẫn đầu open-source model trên 7 benchmark trong nhóm spatial/multimodal embodied reasoning và có bảng so sánh với RoboBrain2.0, Qwen3-VL, Cosmos, Thinker, Gemini/GPT API. Tầng data: WLA train trên khoảng 2.500 giờ robot thật, gồm Unitree Open Datasets và BitRobot-HIW-500. Tầng robot: một model chạy 64 task trên G1, gồm 54 tabletop và 10 whole-body task, hỗ trợ two-finger gripper và nhiều five-finger dexterous hand.
Khi fine-tune nội bộ, bạn nên báo cáo đơn giản hơn:
| Metric | Vì sao cần |
|---|---|
| Local episode action MSE theo module | Biết tay, gripper, base hay chân sai |
| End-effector pose error | Gần với outcome tabletop |
| Gripper open/close accuracy | Sai gripper thường phá task dù pose đúng |
| Chunk smoothness | Phát hiện action giật giữa các horizon |
| Offline replay video | Dễ review với team không đọc tensor |
| Real-robot success rate | Chỉ chạy sau safety gate |
Một baseline tốt cho team nhỏ: lấy checkpoint base, eval trên một task gần nhất; fine-tune 2.000 step; eval cùng episode và một episode held-out; nếu plot tốt hơn và video replay ổn, mới chạy pilot trên robot với speed/torque limit thấp.
Checklist an toàn trước khi cho G1 chạy thật
- Camera stream đúng: head/wrist camera không bị đảo trái phải.
- State vector đúng 60 chiều và mask đúng module.
- Action vector đúng 54 chiều; đặc biệt slice
[42:48]và[48:54]trong action là left/right leg, nhưng state slice tương ứng khác ngữ cảnh. - Unit đúng: meter, radian, m/s, rad/s.
- Base frame đúng: x forward, y left, z up.
- Gravity direction ở state
[41:44]normalized. - Checkpoint có
config.yamlvàdataset_statistics.jsoncạnh thư mụccheckpoints. - Có nút e-stop vật lý, workspace trống, speed limit thấp.
- Không dùng WBT live server nếu chưa mở rộng Dex1-only adapter.
Nguồn đã kiểm
- Project page: UnifoLM-WLA-1.0
- Repo: unitreerobotics/unifolm-wla
- Model collection: UnifoLM-WLA-1.0 trên Hugging Face
- Dataset Dex1: UnifoLM_G1_Dex1_Dataset
- Dataset WBT: UnifoLM_WBT_Dataset