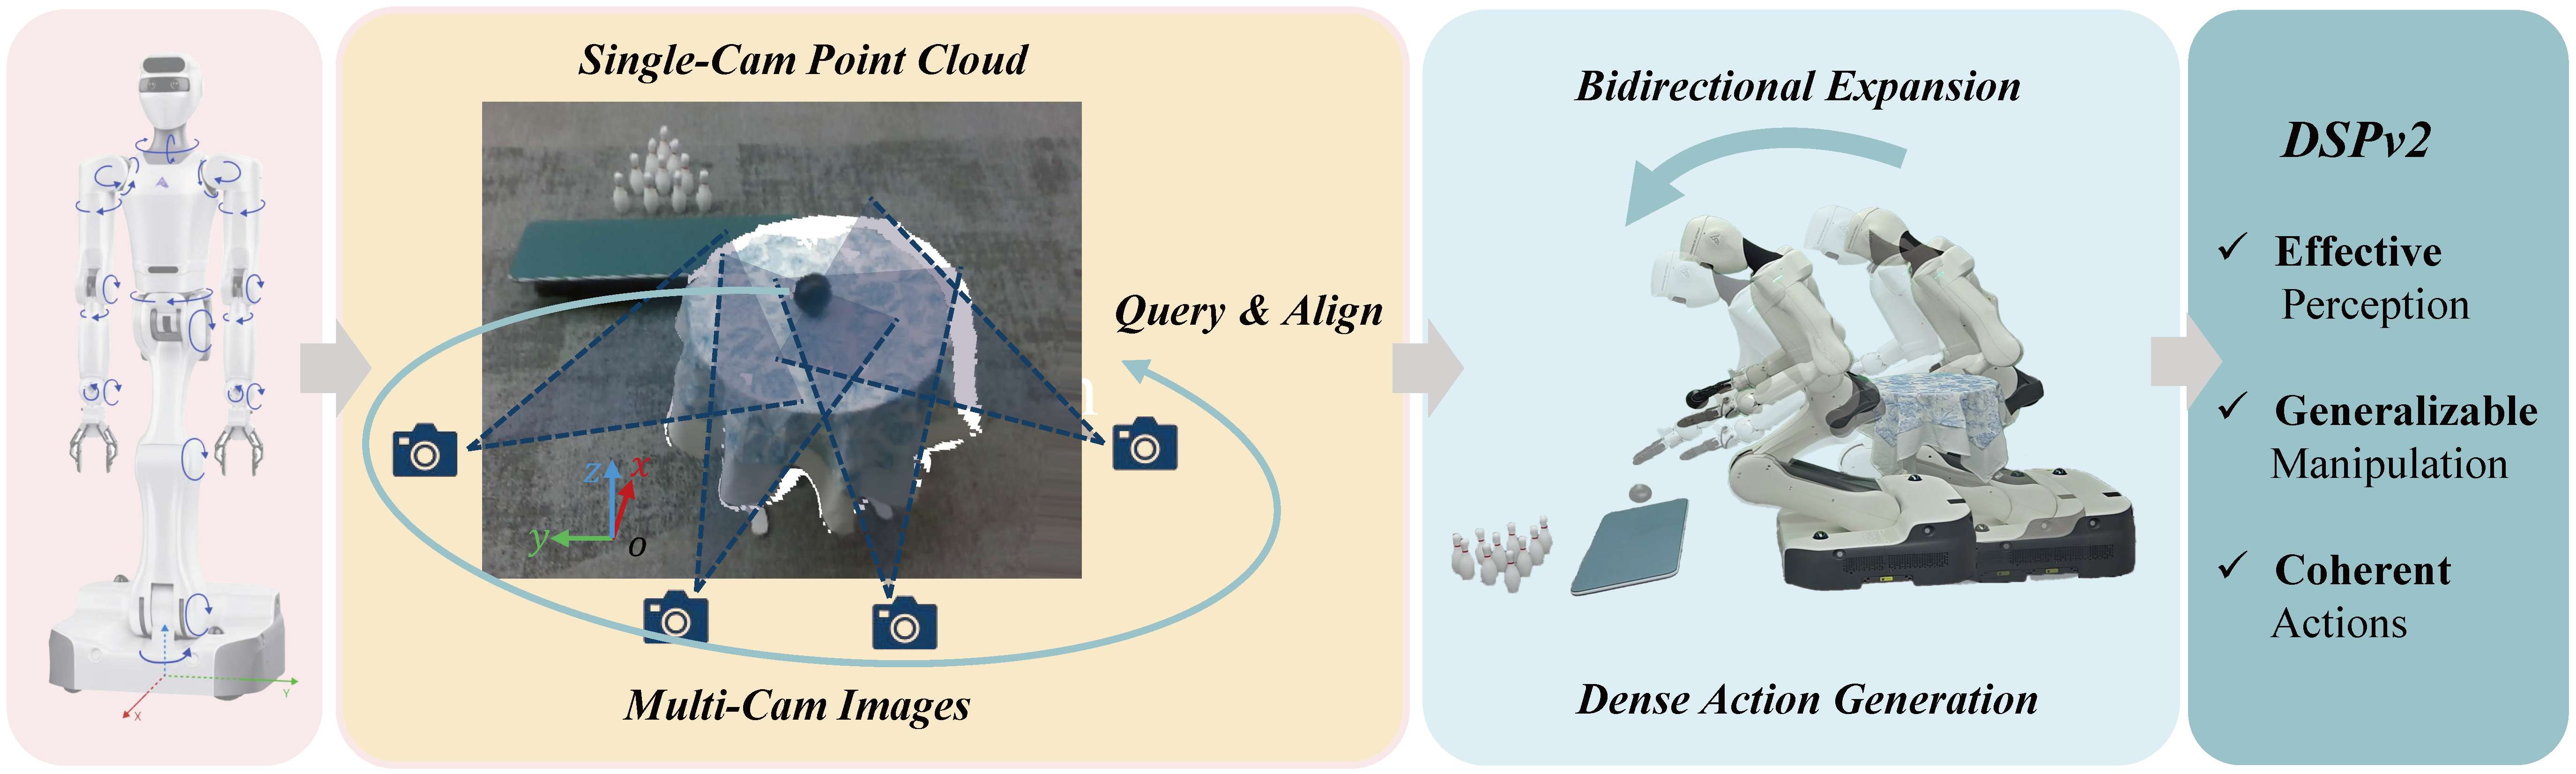
Một humanoid đang nâng chiếc hộp không chỉ cần đặt bàn tay đúng vị trí. Nó còn phải chuyển trọng tâm, giữ chân bám sàn, điều chỉnh thân người và duy trì tiếp xúc khi hộp bắt đầu di chuyển. Nếu camera bị cánh tay che khuất trong vài frame, controller vẫn phải hiểu hành động vừa rồi đã thay đổi tình huống như thế nào. Đây là nơi latent world model trở nên hữu ích: lưu thông tin theo thời gian và dự đoán hệ quả của action trong một biểu diễn gọn.
Bài này chọn DreamMimic: Learning Visuomotor Whole-Body Loco-Manipulation via World Model của Jie Yin và Xingyu Lai, công bố trên arXiv tháng 8/2026. Repo DreamMimic/DreamMimic có code và script training, test, evaluation. Góc nghiên cứu là world-model-assisted policy distillation: chuyển kỹ năng từ privileged teacher sang visual student. Đây là controller có goal condition, không phải VLA nhận lệnh ngôn ngữ, cũng không phải video diffusion WAM sinh action và video đồng thời.
Chúng ta sẽ đi từ khái niệm đến cấu hình thực tế, rồi dựng một quy trình chạy thử có thể kiểm tra từng bước. Các lệnh bên dưới được đối chiếu với mã nguồn ngày 08/10/2026; bài viết không tuyên bố đã training lại model hay đo benchmark trên GPU.
1. Vì sao một ảnh hiện tại chưa đủ?
Hãy tưởng tượng hai ảnh camera gần như giống nhau: humanoid đưa tay sát hộp. Trong tình huống thứ nhất, tay chưa chạm hộp; trong tình huống thứ hai, tay đã tì vào hộp và đang chịu tải. Action tiếp theo hợp lý có thể khác hẳn. Nếu policy chỉ nhìn ảnh hiện tại, nó phải đoán thông tin bị thiếu.
Partial observability là hiện tượng cảm biến không cho biết đầy đủ trạng thái hệ thống. Proprioception là thông tin về chính robot, chẳng hạn cấu hình khớp và vận động của cơ thể. Latent state là vector hoặc tập biến được mạng học để biểu diễn những gì cần nhớ. Dynamics mô tả cách trạng thái thay đổi khi thực hiện action.
World model có thể kết hợp lịch sử cảm biến với action trước đó để duy trì một trạng thái nội bộ. Ví dụ, nếu tay vừa đẩy hộp nhưng ảnh hiện tại bị che, lịch sử vẫn cung cấp manh mối rằng hộp có thể đã dịch chuyển. Đây là khả năng dự đoán có sai số, không phải một bộ cảm biến biết chắc mọi thứ.
Khác biệt này giúp xác định câu hỏi nghiên cứu: liệu thông tin dự đoán có giúp visual student giữ được kỹ năng tiếp xúc của teacher qua một chuỗi dài? Để phân biệt với hướng world action model dự báo tương lai cho loco-manipulation, bạn có thể đọc thêm ω-0 và latent predictive WAM.
2. Teacher, student và world model kết nối ra sao?
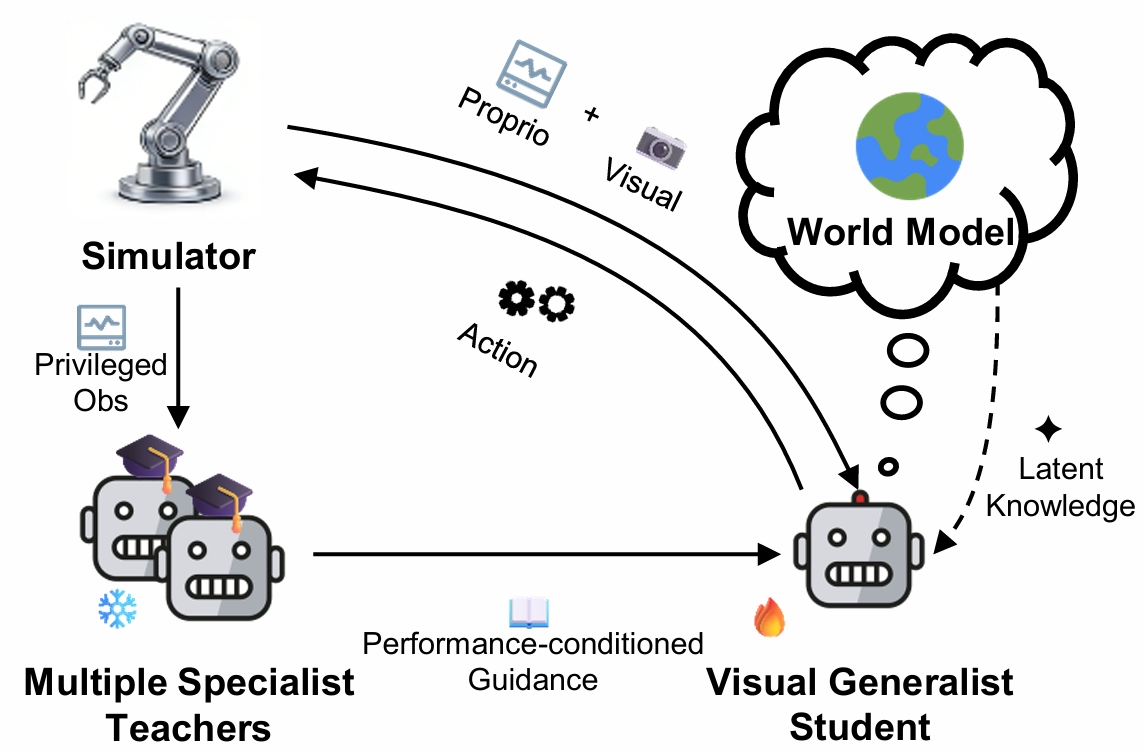
Nguồn hình: DreamMimic project page. Đọc sơ đồ theo ba khối: teacher cung cấp hướng dẫn, world model tạo feature dự đoán, student tạo action.
Có thể hình dung teacher như một huấn luyện viên nhìn được toàn bộ sân tập. Trong simulation, teacher được dùng thông tin mà camera robot không trực tiếp đo được. Student phải học làm việc với cảm biến hạn chế hơn. Nếu lấy luôn ground truth của simulator đưa vào student, bài toán trở nên dễ hơn nhưng controller triển khai sẽ thiếu đầu vào đó.
Một điểm cần giữ rõ là goal khác với measurement. Goal nói vật thể cần đi đâu hoặc robot cần bám quỹ đạo nào. Measurement nói vật thể hiện đang ở đâu. Việc có target object pose trong task command không đồng nghĩa với việc student được cấp current object pose chính xác từ simulator. Khi thiết kế một thí nghiệm của riêng bạn, hãy liệt kê hai nhóm dữ liệu này trước khi viết observation tensor.
Theo cấu hình môi trường được phát hành, student sử dụng depth và segmentation, resize về 32 × 32 với hai channel. Goal reference có horizon 1 và 16. RSSM có deterministic state 128 chiều và stochastic state gồm 32 biến categorical, mỗi biến 8 giá trị. Đây là cấu hình SMPL-X cụ thể của repo, không phải kích thước cố định cho mọi humanoid.
Segmentation giúp phân biệt vùng robot, vật thể và nền; depth cung cấp cấu trúc khoảng cách. Khi đổi sang camera thật, bạn cần một pipeline tạo hai loại dữ liệu với quy ước phù hợp. Đưa RGB nguyên bản vào model đã training với depth–segmentation là thay đổi observation distribution, không phải thao tác thay camera đơn giản.
Nếu thuê cloud GPU để thử policy training, hãy xác nhận máy chạy được Isaac Gym và graphics context trước khi chọn cấu hình đắt hơn. Số môi trường song song, sensor rendering, CPU RAM và dependency tương thích đều ảnh hưởng đến khả năng chạy; chỉ nhìn VRAM chưa đủ.
3. RSSM: trí nhớ và dự đoán trong latent space
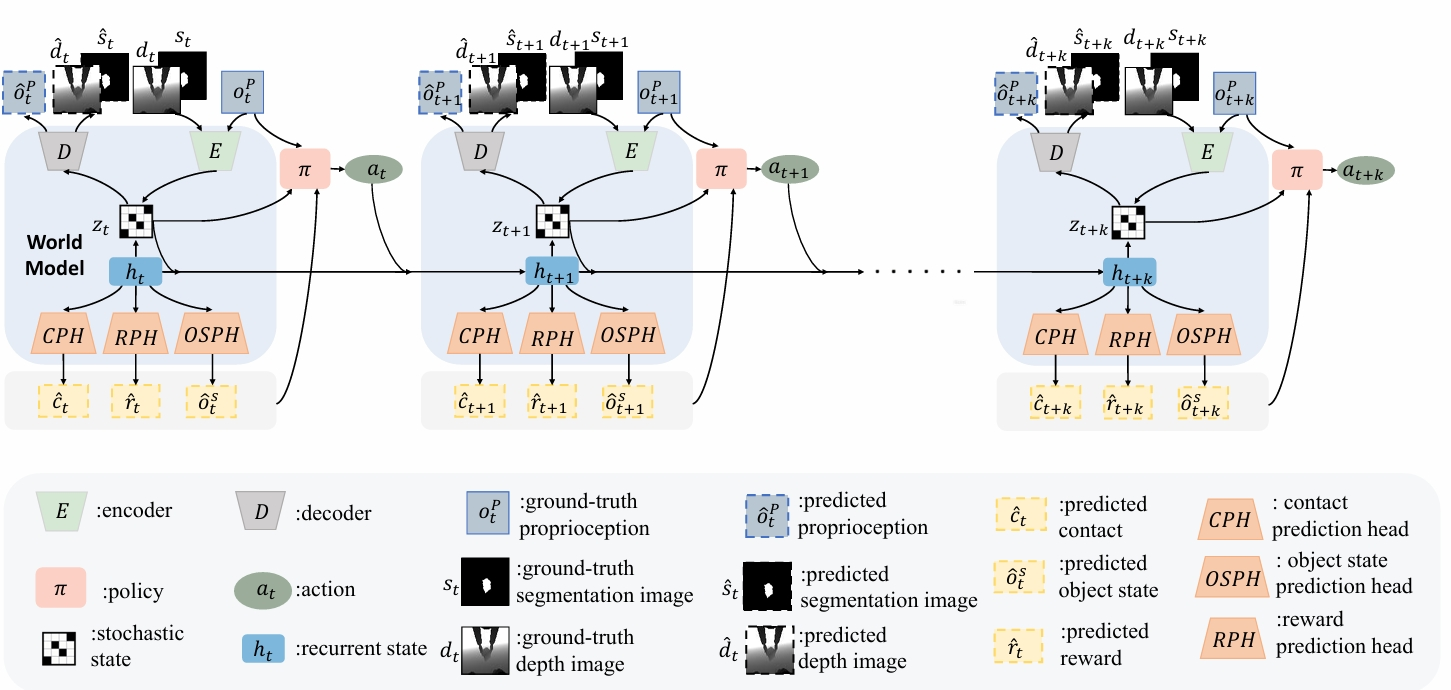
Nguồn hình: sơ đồ world model của DreamMimic. Những head phụ tạo tín hiệu học và feature tương tác; ảnh reconstruction không phải lệnh điều khiển.
Recurrent State-Space Model, viết tắt RSSM, gồm một phần nhớ có tính xác định và một phần biểu diễn bất định. Để hiểu trực giác, hãy gọi phần thứ nhất là h, phần thứ hai là s. Mạng recurrent cập nhật trí nhớ bằng trạng thái trước và action trước. Observation mới giúp hiệu chỉnh suy đoán đó.
Observation hiện tại + action trước
                |
              Encoder
                |
       RSSM posterior update
                |
  Trí nhớ h + prediction heads
                |
  Proprioception/goal + feature fusion
                |
          Student action
Posterior có observation mới để cập nhật latent. Prior dự đoán latent khi chưa có observation mới. Hai chế độ này giải thích vì sao cùng một world model vừa có thể bám dữ liệu cảm biến, vừa có thể chạy một đoạn dự đoán trong latent space.
Trong adapter của visual student, policy feature ghép deterministic feature với các dự đoán reward, privileged state, contact và object state. Với cấu hình mặc định, phép cộng kích thước là 128 + 1 + 164 + 1 + 13 = 307. Adapter lưu previous action, cập nhật latent và reset bộ nhớ theo từng environment khi episode kết thúc.
Tại sao prediction head có ích? Một feature học để tái tạo ảnh có thể lưu nhiều chi tiết hình học nhưng bỏ qua dấu hiệu quan trọng cho điều khiển. Khi phải dự đoán thêm contact hoặc trạng thái vật thể, model có thêm lý do để giữ thông tin về tương tác. Tuy nhiên, prediction vẫn có thể sai; tên head không bảo đảm độ chính xác.
Trong network builder, các nhóm feature được xử lý trước khi đi vào policy. Về mặt thiết kế, tách feature proprioception/goal và feature world model giúp tránh việc một vector lớn áp đảo nhóm còn lại chỉ vì khác thang đo. Khi đổi embodiment, bạn phải kiểm tra thứ tự feature và normalization, không chỉ sửa số chiều tensor.
4. Học hậu quả của action, không chỉ sao chép action
Behavior cloning thường khớp action student với action teacher tại từng thời điểm. Nhưng một sai lệch nhỏ khi chân đang chuyển tải có thể làm thân nghiêng hơn ở bước sau, rồi khiến tay trượt khỏi hộp. Sai số điều khiển có thể tích lũy thành sai số trạng thái.
Agent distillation bổ sung multi-step latent loss: bắt đầu từ cùng latent, chạy hai nhánh dự đoán được điều kiện hóa bằng action student và teacher, rồi so sánh latent thu được. Model parameters được đóng băng trong bước loss này; điều đó vẫn cho phép tính gradient qua dynamics đối với action student. Cấu hình mặc định dùng horizon 3.
Ví dụ trực giác: teacher hạ thân trước khi nâng hộp; student hạ hơi ít. Khoảng cách giữa hai action có thể nhỏ, nhưng dynamics dự đoán rằng khác biệt đó làm trạng thái tiếp xúc lệch sau vài bước. Latent loss thêm một tín hiệu về hậu quả của sai lệch. Ví dụ này minh họa thuật toán, không phải một trajectory được đo trong paper.
DAgger giúp thu dữ liệu ở những trạng thái student thực sự đi tới. Đây là khác biệt lớn so với chỉ học từ một tập demonstration cố định: policy yếu có thể tạo ra tình huống mà demonstration ban đầu không chứa. Teacher cung cấp action tham chiếu tại các trạng thái mới đó.
PCG, hay Performance-Conditioned Guidance, điều chỉnh mức teacher tham gia rollout. Theo training config, teacher ratio nằm trong khoảng 0,30–0,80, performance target là 0,85, imitation coefficient giữ ở 1. PPO có warm-up 5.000 epoch, ramp 2.000 epoch và hệ số cuối 0,10. Đây là default của release, không phải cam kết thời gian training.
Khi theo dõi quá trình học, đừng chỉ xem reward tổng. Hãy tách reward teacher và student, tỷ lệ môi trường teacher điều khiển, loss action, loss latent và tần suất reset. Nếu reward hỗn hợp tăng nhờ teacher làm phần khó, bạn chưa biết student đã tiến bộ đến đâu.
5. Cài đặt: bắt đầu từ một môi trường tương thích
Hướng dẫn chính thức nằm trong README. Bạn cần Linux với NVIDIA GPU phù hợp và Isaac Gym Preview 4. File dependency có nhiều package được pin; nó cũng chứa isaacgym-stubs, nhưng stubs không thay cho simulator. Cài Isaac Gym theo hướng dẫn của NVIDIA trong README.
Để lấy source mà không cần một Git checkout, có thể tải archive:
curl -L https://github.com/DreamMimic/DreamMimic/archive/refs/heads/main.tar.gz \
  -o dreammimic-main.tar.gz
tar -xzf dreammimic-main.tar.gz
cd DreamMimic-main
conda env create -f requirements.yaml
conda activate dreammimic
export LD_LIBRARY_PATH="$CONDA_PREFIX/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
Archive main có thể thay đổi. Khi cần tái lập, dùng archive theo commit và ghi lại revision cùng dataset/config. Cây source được kiểm tra cho bài này có revision 36c81c83f4c271c04b38deb17ba5f13141395b59.
Đọc requirements.yaml trước khi cài: file pin Python 3.8.20, torch 2.4.1 và torchvision 0.19.1, kèm prefix tuyệt đối từ máy tác giả. Nếu resolver hoặc binary extension báo lỗi, lưu lỗi đầu tiên và kiểm tra tương thích driver–CUDA–Python. Đừng nâng đồng loạt dependency để mong hết lỗi; bạn sẽ khó biết thành phần nào làm thay đổi hành vi.
Sau khi cài simulator, kiểm tra import bằng đúng environment:
python -c "import isaacgym; import torch; print(torch.__version__); print(torch.cuda.is_available())"
Import thành công chưa chứng minh camera rendering hoạt động. Vì vậy bước tiếp theo là data replay, không phải mở ngay một training job dài.
6. Dataset và checkpoint: kiểm tra đường dẫn thực tế
README cung cấp link OMOMO processed motions, dữ liệu retarget/correction và teacher checkpoint. Tuy nhiên, cấu hình student được đọc trong bài này trỏ tới InterAct/OMOMO và InterAct/OMOMO_retarget; một số đường chạy khác dùng InterAct/OMOMO_new. Bạn phải đối chiếu config đã chọn với thư mục đã giải nén.
DreamMimic-main/
  InterAct/
    OMOMO/
    OMOMO_retarget/
  ckpts/
    teacher_omomo/
  dm_scripts/
  dreammimic/data/cfg/
Đây là sơ đồ định hướng, không phải danh sách đầy đủ file dataset. Không đổi tên tùy tiện một dataset để khớp đường dẫn: motion reference và dữ liệu correction phải thực sự tương ứng.
Chạy replay rồi kiểm tra teacher:
bash dm_scripts/data_replay_omomo.sh
bash dm_scripts/test_teacher_omomo.sh
Nếu truyền checkpoint riêng, dùng đường dẫn thật đến file .pth và cú pháp trong script. Trước khi chuyển sang student, hãy quan sát vị trí vật thể, scale cơ thể và timing contact. Một teacher lỗi vì thiếu asset không thể trở thành nguồn supervision tốt.
Một lưu ý về phát hành: README có link teacher checkpoint; sự tồn tại của script student test không chứng minh mọi student weight đều tải được. Bạn cần kiểm tra khả năng truy cập checkpoint hoặc tự training. Trong common.sh, cơ chế fallback chỉ sao chép checkpoint legacy đã có trên máy vào ckpts/; nó không tự download weight từ Internet.
7. Training student theo từng nấc
Đối chiếu training wrapper trước khi chạy:
# Chạy thử để kiểm tra pipeline; chưa phải cấu hình benchmark.
bash dm_scripts/train_student_dreammimic.sh 64 checkpoints/dreammimic_smoke

# Default của wrapper dùng 1024 môi trường song song.
bash dm_scripts/train_student_dreammimic.sh 1024 checkpoints/dreammimic_full
Wrapper đặt horizon length 16 và minibatch size 4096. Cấu hình YAML ghi minibatch size 2048, nên cần đọc cả argument command line và resolved config để biết giá trị cuối. Giảm số environment giúp chẩn đoán bộ nhớ; nó cũng thay đổi lượng dữ liệu rollout, do đó không nên coi run nhỏ là tái lập paper.
Trong vài iteration đầu, mục tiêu là xác nhận dữ liệu đi đúng đường: có camera tensor hợp lệ, teacher được load, world model bắt đầu học sau warm-up và loss không xuất hiện NaN. Sau đó mới tăng số environment. Ghi checkpoint, configuration, số sample và seed của từng run để có thể so sánh.
Bạn có thể tổ chức kiểm tra thành ba câu hỏi. Thứ nhất, student có tạo action đúng shape không? Thứ hai, world model có nhận đúng previous action và episode reset không? Thứ ba, student tự điều khiển có hoàn thành clip không? Một run trả lời được câu đầu vẫn có thể thất bại ở hai câu còn lại.
Nếu muốn ablation, tạo run riêng với multi-step latent distillation tắt, giữ các yếu tố khác giống nhau. So sánh nhiều seed và cùng danh sách clip. Không lấy một checkpoint tốt nhất của phương pháp A so với một run chưa hội tụ của phương pháp B.
8. Inference và evaluation
Tìm checkpoint student thực sự được tạo bởi training. Thay đường dẫn minh họa dưới đây bằng file của bạn:
bash dm_scripts/test_student_dreammimic.sh \
  /absolute/path/to/student_checkpoint.pth 4 /tmp/dreammimic_test/custom

bash dm_scripts/eval_student_dreammimic.sh \
  /absolute/path/to/student_checkpoint.pth 64 /tmp/dreammimic_eval/custom false
Test wrapper mặc định dùng mimic_best.pth, còn eval wrapper dùng mimic_bestv4.pth. Truyền cùng checkpoint rõ ràng giúp tránh vô tình xem một model nhưng đo một model khác. Tham số cuối false tắt recording; dùng true nếu muốn xuất video theo cơ chế của wrapper.
Inference duy trì latent theo lịch sử observation và previous action. Episode mới phải reset bộ nhớ tương ứng. Nếu bỏ qua reset, model có thể mang thông tin về vật thể của episode cũ vào episode mới; lỗi này thường khó nhận ra chỉ bằng một video ngắn.
Code lưu trạng thái agent có trường student_world_model. Khi chuyển checkpoint hoặc triển khai một loader riêng, hãy kiểm tra cả actor và world model đã được restore. Chỉ load actor có thể tạo action hợp lệ về shape nhưng feature đầu vào không còn đúng distribution đã học.
Video này minh họa perception input trong simulation. Nó không phải bằng chứng chạy trên G1 vật lý và không thay cho kết quả đánh giá định lượng.
9. Kết quả và cách đọc benchmark
Table I và II của paper báo cáo tracking trong simulation:
| Thiết lập | Phương pháp | Success | Robot error | Object error |
|---|---|---|---|---|
| OMOMO | ResNet-18 + DAgger+RL | 72,6% | 7,8 cm | 9,7 cm |
| OMOMO | DreamMimic | 92,2% | 5,4 cm | 8,8 cm |
| OMOMO, mass ×5 | DreamMimic | 41,2% | 8,1 cm | 14,8 cm |
| BEHAVE, PCG | DreamMimic | 72,7% | 10,2 cm | 13,3 cm |
Success ở đây là bám thành công reference clip. Với clip kết thúc sớm, tracking error chỉ tính trên frame đã chạy. Thử nghiệm chuyển morphology và simulator mang tính định tính; không suy ra success robot thật từ bảng trên.
Về phương pháp đánh giá, hãy luôn đọc success cùng duration và error. Một policy dừng ngay trước đoạn khó có thể có error thấp trên phần dễ đã thực hiện. Tương tự, một video được chọn để minh họa không cho biết tỷ lệ thất bại trên toàn bộ tập clip.
Mass stress test cũng có ý nghĩa thực hành: cùng hình dạng hộp nhưng tải nặng hơn có thể yêu cầu coordination khác. Khi viết báo cáo của riêng mình, lưu riêng kết quả nominal và stress condition. Đừng trộn chúng thành một tỷ lệ trung bình làm mất thông tin về giới hạn tải.
10. Những gì cần làm trước khi đổi sang humanoid thật
Một thí nghiệm tiếp theo hợp lý là tái lập student trên đúng embodiment mô phỏng, rồi đo từng thay đổi của sensor và controller. Đổi camera, timing action và actuator cùng lúc sẽ khiến nguyên nhân thất bại khó xác định.
Bạn cần một giao diện goal có thể tạo ở deployment, một pipeline depth–segmentation nhất quán và một mapping action đúng với controller robot. Đồng thời phải kiểm tra normalization, joint ordering, tần số observation và cơ chế reset khi task đổi. Đây là các yêu cầu tích hợp được suy ra từ cấu trúc hệ thống, không phải một recipe sim2real đã được paper chứng minh.
Điều đáng học từ DreamMimic là cách biến world model thành tín hiệu hỗ trợ policy: trí nhớ về tương tác, dự đoán có điều kiện theo action và supervision về hậu quả. Với người mới, lộ trình hữu ích nhất là chạy replay, xác minh teacher, chạy student nhỏ rồi mới thiết kế ablation. Mỗi bước tạo một bằng chứng cụ thể về pipeline trước khi bạn đầu tư vào training lớn.