Khi humanoid ngã, tracking thôi đã đủ chưa?
Hãy tưởng tượng bạn đang teleoperate một humanoid: người điều khiển đứng thẳng, robot cũng đang đứng thẳng, rồi robot bị đẩy ngã. Reference của người vẫn là tư thế đứng. Một controller chỉ quen bám những đoạn chuyển động đẹp có thể tiếp tục cố giảm sai số joint trong khi cơ thể đã nằm ngoài phân phối training. Câu hỏi lúc này không chỉ là “tay cần ở đâu”, mà còn là “từ trạng thái hiện tại, cơ thể có thể đi qua những trạng thái nào để đứng dậy”.
UFO của RoboParty Lab Team nghiên cứu câu hỏi đó bằng unsupervised reinforcement learning. Thay vì xem motion tracking là mục tiêu duy nhất, hệ thống học một không gian latent của kỹ năng toàn thân; tracking và goal reaching trở thành những cách đưa yêu cầu vào không gian này. Bài viết chọn góc temporal reachability và recovery, bổ sung cho cách tiếp cận tracking trong kiến trúc GR00T SONIC.
Nguồn gốc là technical report UFO, cập nhật ngày 14/07/2026, project page và repo Roboparty/UFO. Report trình bày hai hướng: UFO-FB, dựa trên Forward-Backward representation learning, và UFO-TeCH, dùng temporal-distance representation. Đây là nghiên cứu có code công khai; các kết quả bên dưới do tác giả báo cáo, không phải benchmark được VnRobo tự chạy lại.
WBC, WBID/QP và RL khác nhau ở lớp nào?
Whole-body control phối hợp chân, thân và tay để cơ thể vừa giữ được trạng thái khả thi vừa thực hiện yêu cầu. Khi robot đưa tay xa về phía trước, phần hông và chân phải phản ứng để giữ thăng bằng. Điều khiển riêng từng joint không diễn đạt được toàn bộ sự phối hợp này.
Với WBID, whole-body inverse dynamics, ta thường tìm joint acceleration, torque và contact force thỏa mãn phương trình động lực học. Một QP, quadratic program, có thể tối ưu tracking error dưới các ràng buộc torque, contact và friction. Tính khả thi phụ thuộc mô hình, contact assumption và trạng thái ước lượng. QP cũng không tự tạo ra cả chuỗi đứng dậy nếu planner chỉ cung cấp một pose đích.
RL học một ánh xạ từ observation đến action thông qua tương tác với simulator. Với tracking RL, reward thường thưởng robot bám reference motion. UFO đi thêm một bước: học representation của nhiều hành vi để một actor có thể nhận một latent command và chọn hành động phù hợp với trạng thái hiện tại.
| Cách tiếp cận | Đầu vào điều khiển điển hình | Công việc cần làm trước |
|---|---|---|
| WBID/QP | Task acceleration, contact specification | Mô hình động lực học, estimator, planner |
| Tracking RL | Reference pose hoặc motion window | Retargeting, reward, training trong simulation |
| UFO-FB / UFO-TeCH | Observation và latent skill hoặc goal | Motion prior, representation learning, off-policy RL |
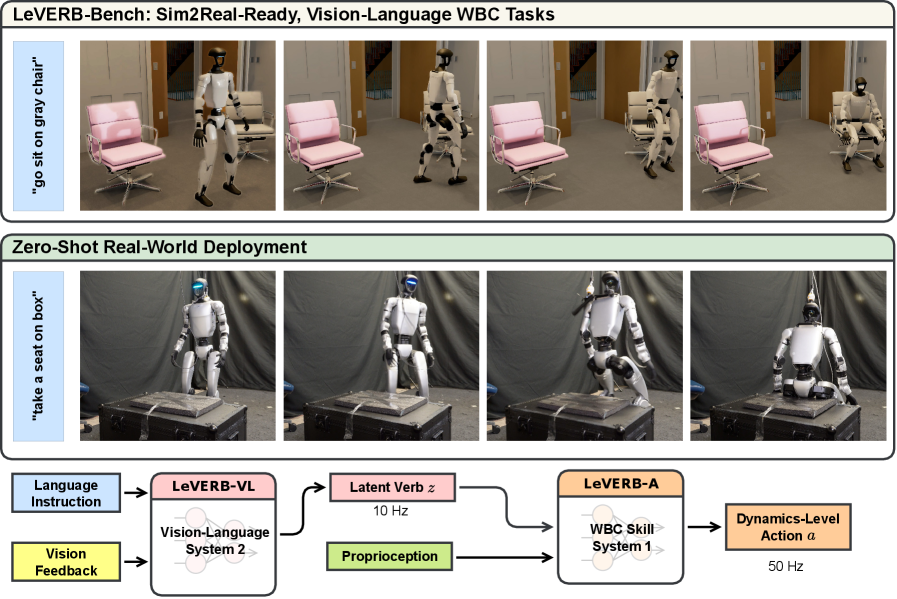
UFO không phải một QP solver và cũng chưa phải VLA hiểu ngôn ngữ. Nó cung cấp lớp motor policy mà một hệ thống teleop hoặc planner cấp cao có thể sử dụng. Nếu muốn kết hợp VLA, bạn vẫn cần định nghĩa cách semantic action được chuyển thành motion target hoặc latent command.
“Unsupervised” vẫn cần dữ liệu và mục tiêu phụ
Trong ngữ cảnh UFO, unsupervised nghĩa là không phải viết riêng một task reward cho mỗi kỹ năng downstream. Điều đó không có nghĩa robot học hoàn toàn không có motion data, không có reward hay không có engineering.
Hệ thống dùng motion demonstrations để giữ hành vi gần phân phối chuyển động người. Đồng thời, policy khám phá simulator và lưu transition vào replay buffer. Off-policy learning cho phép sử dụng lại các transition đã thu thập, thay vì chỉ tối ưu từ batch rollout mới nhất.
Ngoài representation objective còn có discriminator cho motion style và auxiliary objectives hỗ trợ sim-to-real. Trong FB preset, bạn có thể thấy các thành phần liên quan action rate, joint limits, undesired contact và foot slippage. Một số hệ số torque được đặt bằng zero ở preset mặc định; vì vậy không nên đọc danh sách tên penalty rồi kết luận tất cả đều đang có tác dụng như nhau.
Đây là khác biệt thực hành quan trọng. Nếu bạn chỉ giữ một reward “đến gần goal” mà bỏ motion prior và các mục tiêu phụ, hệ thống mới không còn tương đương implementation được report đánh giá.
Kiến trúc: observation, encoder, latent và actor
Report sử dụng G1 với 29 DoF. Actor xuất target cho PD controller, không trực tiếp xuất một phương án contact-force tối ưu như WBID. Observation cơ bản gồm joint position tương đối với nominal pose, joint velocity, root angular velocity và projected gravity; report mô tả vector proprioception này có 64 chiều. History chứa các observation và action trước đó để giúp actor suy ra thông tin động học khó đo trực tiếp.
Trong code, actor nhận các nhóm state, last_action, history_actor. Các network training khác còn được dùng privileged_state: thông tin đầy đủ hơn do simulator cung cấp. Tách hai loại input giúp tránh thiết kế một actor phụ thuộc những đại lượng không sẵn có trên robot thật.
Preset FB và TeCH hiện dùng latent dimension 256. Actor có kiến trúc residual, hidden width 2048 và sáu hidden layers. Đây là thông số của preset đã đọc, không phải chứng minh mọi checkpoint công khai có cùng cấu hình. Khi export, phải lấy input dimensions từ checkpoint và metadata tương ứng.
Motion data đã retarget         Robot observation + history
          |                                  |
   Representation encoder                    |
          |                                  |
      Latent command z ------------------> Actor
                                             |
                                      Joint PD targets
                                             |
                                       Humanoid G1

Training: simulator -> replay buffer -> representation / style / auxiliary critics
Ở FB, backward mapping biểu diễn trạng thái đích trong latent space; forward mapping học thông tin về những trạng thái tương lai có thể đạt dưới policy được conditioning bởi latent. Hai mapping này cho phép tái sử dụng representation cho nhiều yêu cầu. Tuy nhiên, lệnh --agent fb trong UFO chọn một preset có thêm style và auxiliary components, không chỉ phiên bản FB tối giản.
TeCH: khoảng cách nói lên thời gian chuyển trạng thái
Hai pose gần nhau theo góc joint chưa chắc dễ chuyển qua lại. Robot đang nằm và robot đứng có thể cần nhiều bước tiếp xúc mặt đất; một sai khác pose nhỏ đôi khi lại xảy ra khi cơ thể đang mất thăng bằng. Vì thế, TeCH học representation phản ánh temporal reachability, thay vì chỉ gom các pose có tọa độ giống nhau.
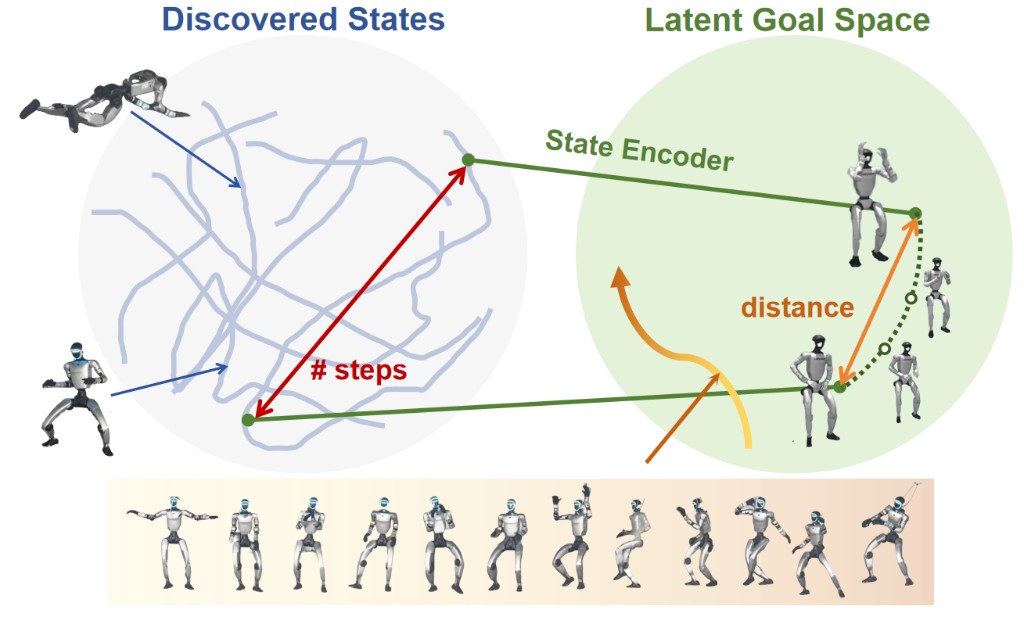
Trong report, encoder nhận trạng thái hiện tại, trạng thái kế tiếp và pseudo-goal lấy từ tương lai của trajectory. Contrastive objective phân biệt các trạng thái cách xa nhau theo thời gian; một thành phần regularization giữ representation của trạng thái liên tiếp đủ liên tục. Hình trên minh họa quan hệ giữa số bước và khoảng cách trong latent goal space, không phải bản đồ hình học của căn phòng.
Policy sau đó nhận progress reward: nếu transition mới làm khoảng cách tới latent goal giảm, reward dương; nếu khoảng cách tăng, reward âm. Có thể hiểu bằng công thức khái niệm sau, dùng ký hiệu distance để tránh nhầm với tọa độ joint:
r_progress = distance(goal_latent, encoded_current_state)
           - distance(goal_latent, encoded_next_state)
Đây là diễn giải reward ở Equation 6 của report, không phải một training script thay thế. Actor được tối ưu bằng các critic cho representation progress, motion style và auxiliary constraints. TeCH cũng không có cùng successor-feature interface như FB: report nói rõ nó không trực tiếp cung cấp khả năng reward optimization tổng quát của FB. Beginner nên bắt đầu bằng tracking và goal reaching khi thử TeCH.
Cài đặt: bắt đầu từ môi trường G1 đã được hỗ trợ
Các lệnh dưới đây dùng trên Linux workstation dành riêng cho thử nghiệm UFO. Chúng là hướng dẫn cho người đọc, chưa được chạy trong phiên viết bài này. Pyproject của repo yêu cầu Python 3.10, pin MJLab 1.4.0, dùng MuJoCo khoảng phiên bản 3.8 và PyTorch trong khoảng 2.7 đến dưới 2.8. GPU training cần stack CUDA phù hợp; không nên cài một phiên bản Isaac Lab tùy ý vào environment này.
git clone https://github.com/Roboparty/UFO.git
cd UFO
python3 -m pip install --user uv
export PATH="$HOME/.local/bin:$PATH"
uv sync

bash scripts/download_data.sh g1_lafan
ls -lh humanoidverse/data/lafan_29dof_10s-clipped.pkl
Download script kiểm tra SHA256 cho dữ liệu. Dataset training là motion đã xử lý cho G1; repo không tự biến bất kỳ human skeleton nào thành joint trajectory đúng cho robot mới. Nếu file chưa tồn tại, hãy giải quyết download trước khi chạy training: lỗi dữ liệu đầu vào không được chữa bằng tăng số GPU.
Tiếp theo chạy smoke test theo quick start:
./run_train.sh \
  --agent fb \
  --data-manifest configs/data/example_mix.yaml \
  --gpu-ids single \
  --smoke \
  --work-dir /tmp/ufo_smoke_g1
Smoke test chỉ kiểm tra pipeline ngắn. Quan sát xem environment có được tạo, dataset có load, các giá trị loss có finite và quá trình có lưu output. Chạy được smoke test chưa có nghĩa model đã học đi bộ hay đủ chất lượng sim-to-real.
Training: đọc đúng ngân sách trước khi thuê GPU
Repo công bố command FB với nhiều GPU. Cấu hình bên dưới giữ các giá trị của quick start để bạn nhận diện từng tham số:
CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 \
./run_train.sh \
  --agent fb \
  --gpu-ids all \
  --num-envs 1024 \
  --num-env-steps 192000000 \
  --work-dir runs/ufo_fb_g1 \
  --data-path humanoidverse/data/lafan_29dof_10s-clipped.pkl \
  --update-z-every-step 100 \
  --buffer-size 5120000
num-envs và buffer-size được tính trên mỗi GPU, còn num-env-steps là ngân sách sample toàn cục. Với tám GPU, 1024 environment mỗi GPU nghĩa là tổng cộng 8192 environment. Buffer giữ nhiều transition có thể tiêu thụ đáng kể VRAM; preset tám H200 không tự trở thành preset tối ưu cho một RTX 4090.
Để thử TeCH, dùng một work directory riêng và đổi --agent fb thành --agent tech, đồng thời dùng --update-z-every-step 10 theo quick start. Tên tldr cũ vẫn tồn tại trong file nội bộ và là compatibility alias; giao diện hiện tại gọi thuật toán là TeCH. Không nên gộp checkpoint hai hướng vào cùng thư mục.
Tham số update-z ảnh hưởng thời gian giữ latent trong rollout. Report quan sát giảm khoảng giữ latent có thể cải thiện tracking nhưng làm hành vi kém mềm và dễ jitter khi deploy. Nó không phải công tắc để tăng control frequency. Evaluation trong report dùng simulation 200 Hz và control 50 Hz.
Một thí nghiệm đầu tiên hợp lý là giữ nguyên dataset, robot và thuật toán, chỉ thay ngân sách hoặc số environment để vừa tài nguyên. Ghi GPU model, số GPU, dataset revision, seed và thời gian chạy. Sau đó mới so sánh FB với TeCH trên cùng tập motion và cùng điều kiện evaluation.
Thêm kỹ năng: vì sao trộn cartwheel có thể gây hỏng training?
Report phân tích việc thêm cartwheel, một kỹ năng hiếm và khó. Nếu trộn tất cả trajectory vào chung một pool rồi prioritized sampling, những motion khó có thể liên tục nhận priority cao. Kết quả là policy dành quá nhiều thời gian cho một phần nhỏ dữ liệu, làm phân phối training lệch khỏi motion nền.
Giải pháp là chọn dataset trước bằng tỷ lệ cố định, rồi mới prioritized sampling bên trong dataset đã chọn. Thí nghiệm cartwheel dùng tỷ lệ foundation/cartwheel 0.95/0.05. Report ghi nhận các baseline trộn kiểu cũ bị non-finite metrics khoảng 14–28 triệu environment steps, trong khi cấu hình tỷ lệ cố định ổn định đến 384 triệu steps. Đây là kết quả cho thí nghiệm đó; không bảo đảm tỷ lệ 5% phù hợp mọi kỹ năng.
configs/data/example_mix.yaml hiện chỉ có nguồn LaFAN với weight 1.0. Nếu thêm nguồn mới, bạn cần motion đã retarget, format hợp lệ và weight có chủ đích. Repo hỗ trợ RobotState CSV/NPZ và ufo_pkl; robot khác cần MuJoCo XML, joint order đúng và robot config được review. Chia sẻ infrastructure không có nghĩa chia sẻ một checkpoint giữa G1 và H1.
Inference: từ motion reference đến ONNX
Tracking inference cần full motion sequence, không phải chỉ file đã cắt clip để training. Sau khi có checkpoint, thay đường dẫn placeholder bằng tập full motion thật:
CUDA_VISIBLE_DEVICES=0 \
uv run python -m humanoidverse.tracking_inference \
  --model-folder runs/ufo_fb_g1 \
  --data-path /path/to/full_motions.pkl \
  --device cuda:0 \
  --headless \
  --save-mp4 \
  --motion-list 0 \
  --export-onnx true
Output nằm dưới tracking_inference/ của model folder. Đọc video để tìm foot slipping, sai hướng root và đứt continuity, đồng thời dùng metrics thay vì chỉ xem một đoạn demo đẹp. Metadata export ghi robot config, XML path, controlled joints, actor input dimensions, latent dimension và action dimension.
Đối với goal reaching, encoder tạo latent từ target state. Đối với tracking, report dùng tổ hợp representation của các future states trong một look-ahead window. Điều này giải thích vì sao motion playback có thể cung cấp thông tin mà live teleop chưa có: future reference. Khi tích hợp teleop, phải sử dụng runtime online tương ứng, không giả định một stream pose hiện tại tương đương file trajectory biết trước tương lai.
Repo có goal_inference và reward_inference, được mô tả trong Training and Inference. Sự tồn tại của module reward inference không có nghĩa mọi thuật toán, mọi robot đều hỗ trợ mọi reward task. Non-G1 hiện bị giới hạn nhiều hơn, và TeCH có giới hạn representation riêng đã nêu ở trên.
Teleop-to-policy: dùng deploy runtime tương thích
Nhánh main dành cho training, data import và export; nhánh deploy là runtime riêng cho G1 29-DoF. Runtime phát hành dùng policy ONNX, backward encoder ONNX và các latent context, không chỉ một file actor duy nhất. README deploy chỉ định artifact tại xuewang/ufo-g1-policy.
Pipeline teleop có thể đọc PICO/XRobot motion, retarget bằng code được vendored trong deploy runtime, tính latent z, rồi gửi bằng ZeroMQ đến policy. Actor đóng vòng với proprioception của robot. Người điều khiển cung cấp mục tiêu vận động, còn policy quyết định joint action dựa trên cơ thể thật đang ở trạng thái nào.
Bước tiếp cận dễ kiểm tra là sim2sim. Cài environment deploy riêng theo README, tải artifact đầy đủ, kiểm tra release manifest; sau đó chạy hai terminal:
# Terminal A, trong UFO-Deploy và environment ufo-deploy
python -m sim_env.base_sim \
  --robot_config ./config/robot/g1.yaml \
  --scene_config ./config/scene/g1_29dof.yaml

# Terminal B, cùng thư mục và environment
python rl_policy/ufo_policy.py \
  --robot_config config/robot/g1.yaml \
  --policy_config config/policy/g1_policy.yaml \
  --model_path model/g1_policy/exported/FBcprAuxModel.onnx \
  --task config/exp/tracking/tracking.yaml
Các phím sim2sim được README ghi là i để về standing pose, ] để enable policy và [ để bắt đầu tracking. Runtime robot thật còn cần binding ARM64, DDS interface đúng, kiểm tra stale latent và stop latch. Những yêu cầu này thuộc đường deploy cụ thể, không được đáp ứng chỉ bằng việc actor chạy nhanh trên workstation.
“Teleop-to-policy” ở đây là stream mục tiêu teleop vào motor policy đã pretrain. Nó chưa đồng nghĩa với tự động thu dataset rồi train một VLA hoàn chỉnh. Nếu muốn học manipulation từ demonstrations, hãy ghi synchronized observation, reference, latent và robot action; sau đó xác định rõ tầng policy nào bạn sẽ train.
Kết quả: phải đọc cả hardware lẫn evaluation protocol
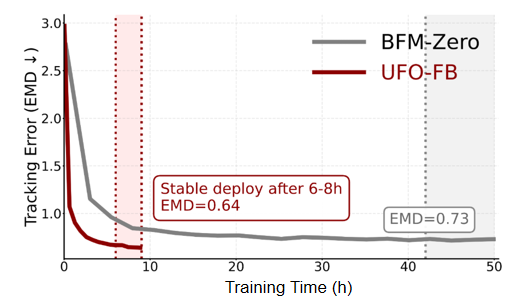
Hình highlight nêu mốc 6–8 giờ, nhưng Table 1 trong report tách cấu hình cụ thể:
| Phương pháp | Hardware | Số environment | Training time |
|---|---|---|---|
| BFM-Zero | 1 H200 | 1024 | 45 giờ |
| UFO-FB | 1 H200 | 1024 | 21 giờ |
| UFO-FB | 8 H200 | 8 × 1024 | 6 giờ |
| UFO-FB | 8 RTX 4090 | 8 × 512 | 14 giờ |
Các mốc này là wall-clock để đạt policy mà tác giả xem phù hợp triển khai, không phải thời gian chạy một smoke test. Report có câu mô tả ngắn chưa hoàn toàn nhất quán về RTX 4090; khi lập ngân sách, nên dùng hàng cấu hình rõ ràng trong bảng và tự đo trên máy của bạn.
Table 3 báo cáo joint-position tracking error như sau, giữ nguyên tên metric và giá trị của tác giả:
| Phương pháp | LAFAN1 | 100-Style |
|---|---|---|
| SONIC, full trajectory | 0.2916 ± 0.1887 | 0.1522 ± 0.1049 |
| SONIC, trước termination | 0.1081 ± 0.0213 | 0.1355 ± 0.0351 |
| BFM-Zero, full trajectory | 0.1510 ± 0.0255 | 0.1674 ± 0.0459 |
| UFO-FB, full trajectory | 0.1178 ± 0.0575 | 0.1278 ± 0.0403 |
| UFO-TeCH, full trajectory | 0.1272 ± 0.0582 | 0.1385 ± 0.0392 |
Không nên biến bảng này thành câu “UFO thắng SONIC trong mọi tình huống”. Dòng trước termination bỏ phần sau khi robot thất bại; dòng full trajectory tiếp tục tính cả recovery. TeCH cũng không đứng đầu tracking error trong bảng, dù report mô tả lợi thế về chuyển goal và recovery. LAFAN1 là tập training khoảng 2–3 giờ, còn 100-Style là tập test khoảng 18–19 giờ; tổng thời lượng data không thay thế việc kiểm tra split và coverage của task bạn quan tâm.
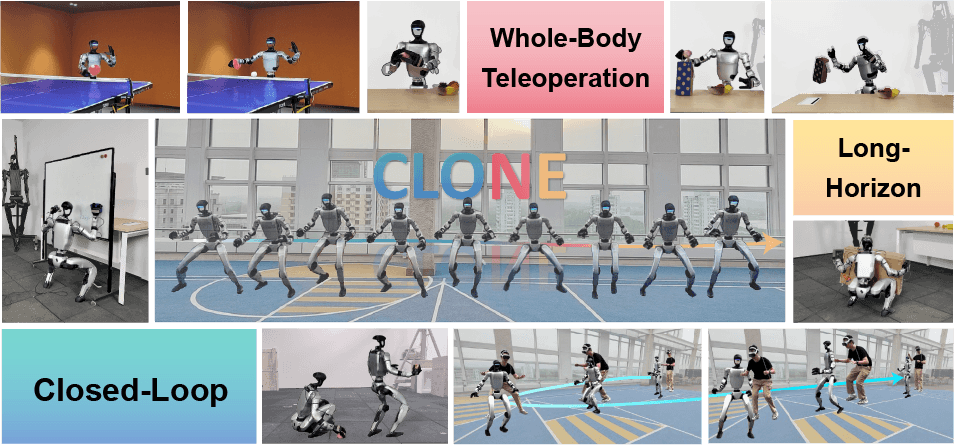
Tác giả trình diễn push, pull, ngã và đứng dậy trên robot thật, nhưng đồng thời thừa nhận hạn chế về locomotion, đi ngang/đi lùi, global tracking và latency của backward mapping. Video chứng minh có demonstration thực tế; nó không cung cấp một success rate chuẩn hóa cho mọi môi trường hay mọi vật thể.
Một bài thực hành nhỏ để hiểu đúng UFO
Hãy bắt đầu bằng một motion đứng–squat–đứng trong simulation. Giữ nguyên reference, đo joint error, foot contact và thời gian quay về tracking sau một perturbation có kiểm soát. Tiếp theo đổi sang goal reaching với vài target pose rời rạc, quan sát robot chọn transition thay vì phát lại một trajectory cố định.
Nếu chỉ số đẹp nhưng robot drift nhiều, tách root error khỏi joint error. Nếu một clip thất bại, giữ cả phần recovery trong log. Nếu FB và TeCH khác nhau, kiểm tra observation normalization, history và latent cadence trước khi quy toàn bộ khác biệt cho thuật toán. Cách làm này giúp bạn biến một repo nghiên cứu thành thí nghiệm có thể giải thích và lặp lại.
UFO đáng nghiên cứu ở khả năng xây một motor skill space có nhiều đường chuyển trạng thái, cùng infrastructure để so sánh FB và temporal-distance learning. Việc lựa chọn cuối cùng vẫn phụ thuộc mục tiêu: bám reference chính xác, chuyển pose nhanh, teleop ổn định hay tích hợp với planner cấp cao.