Vì sao một ảnh đẹp chưa đủ để dạy robot tiếp cận?
Một camera cổ tay có thể nhìn rõ ốc vít trên motherboard, nhưng policy vẫn cần biết chuyển động nào sẽ đưa gripper đến đúng vị trí. Nếu ảnh và robot state lệch thời điểm, hoặc tọa độ camera chưa khớp robot base, dữ liệu trông hợp lý vẫn có thể dạy sai hành động. Với linh kiện mỏng, sai số nhỏ ở hướng tiếp cận đủ làm lần gắp thất bại.
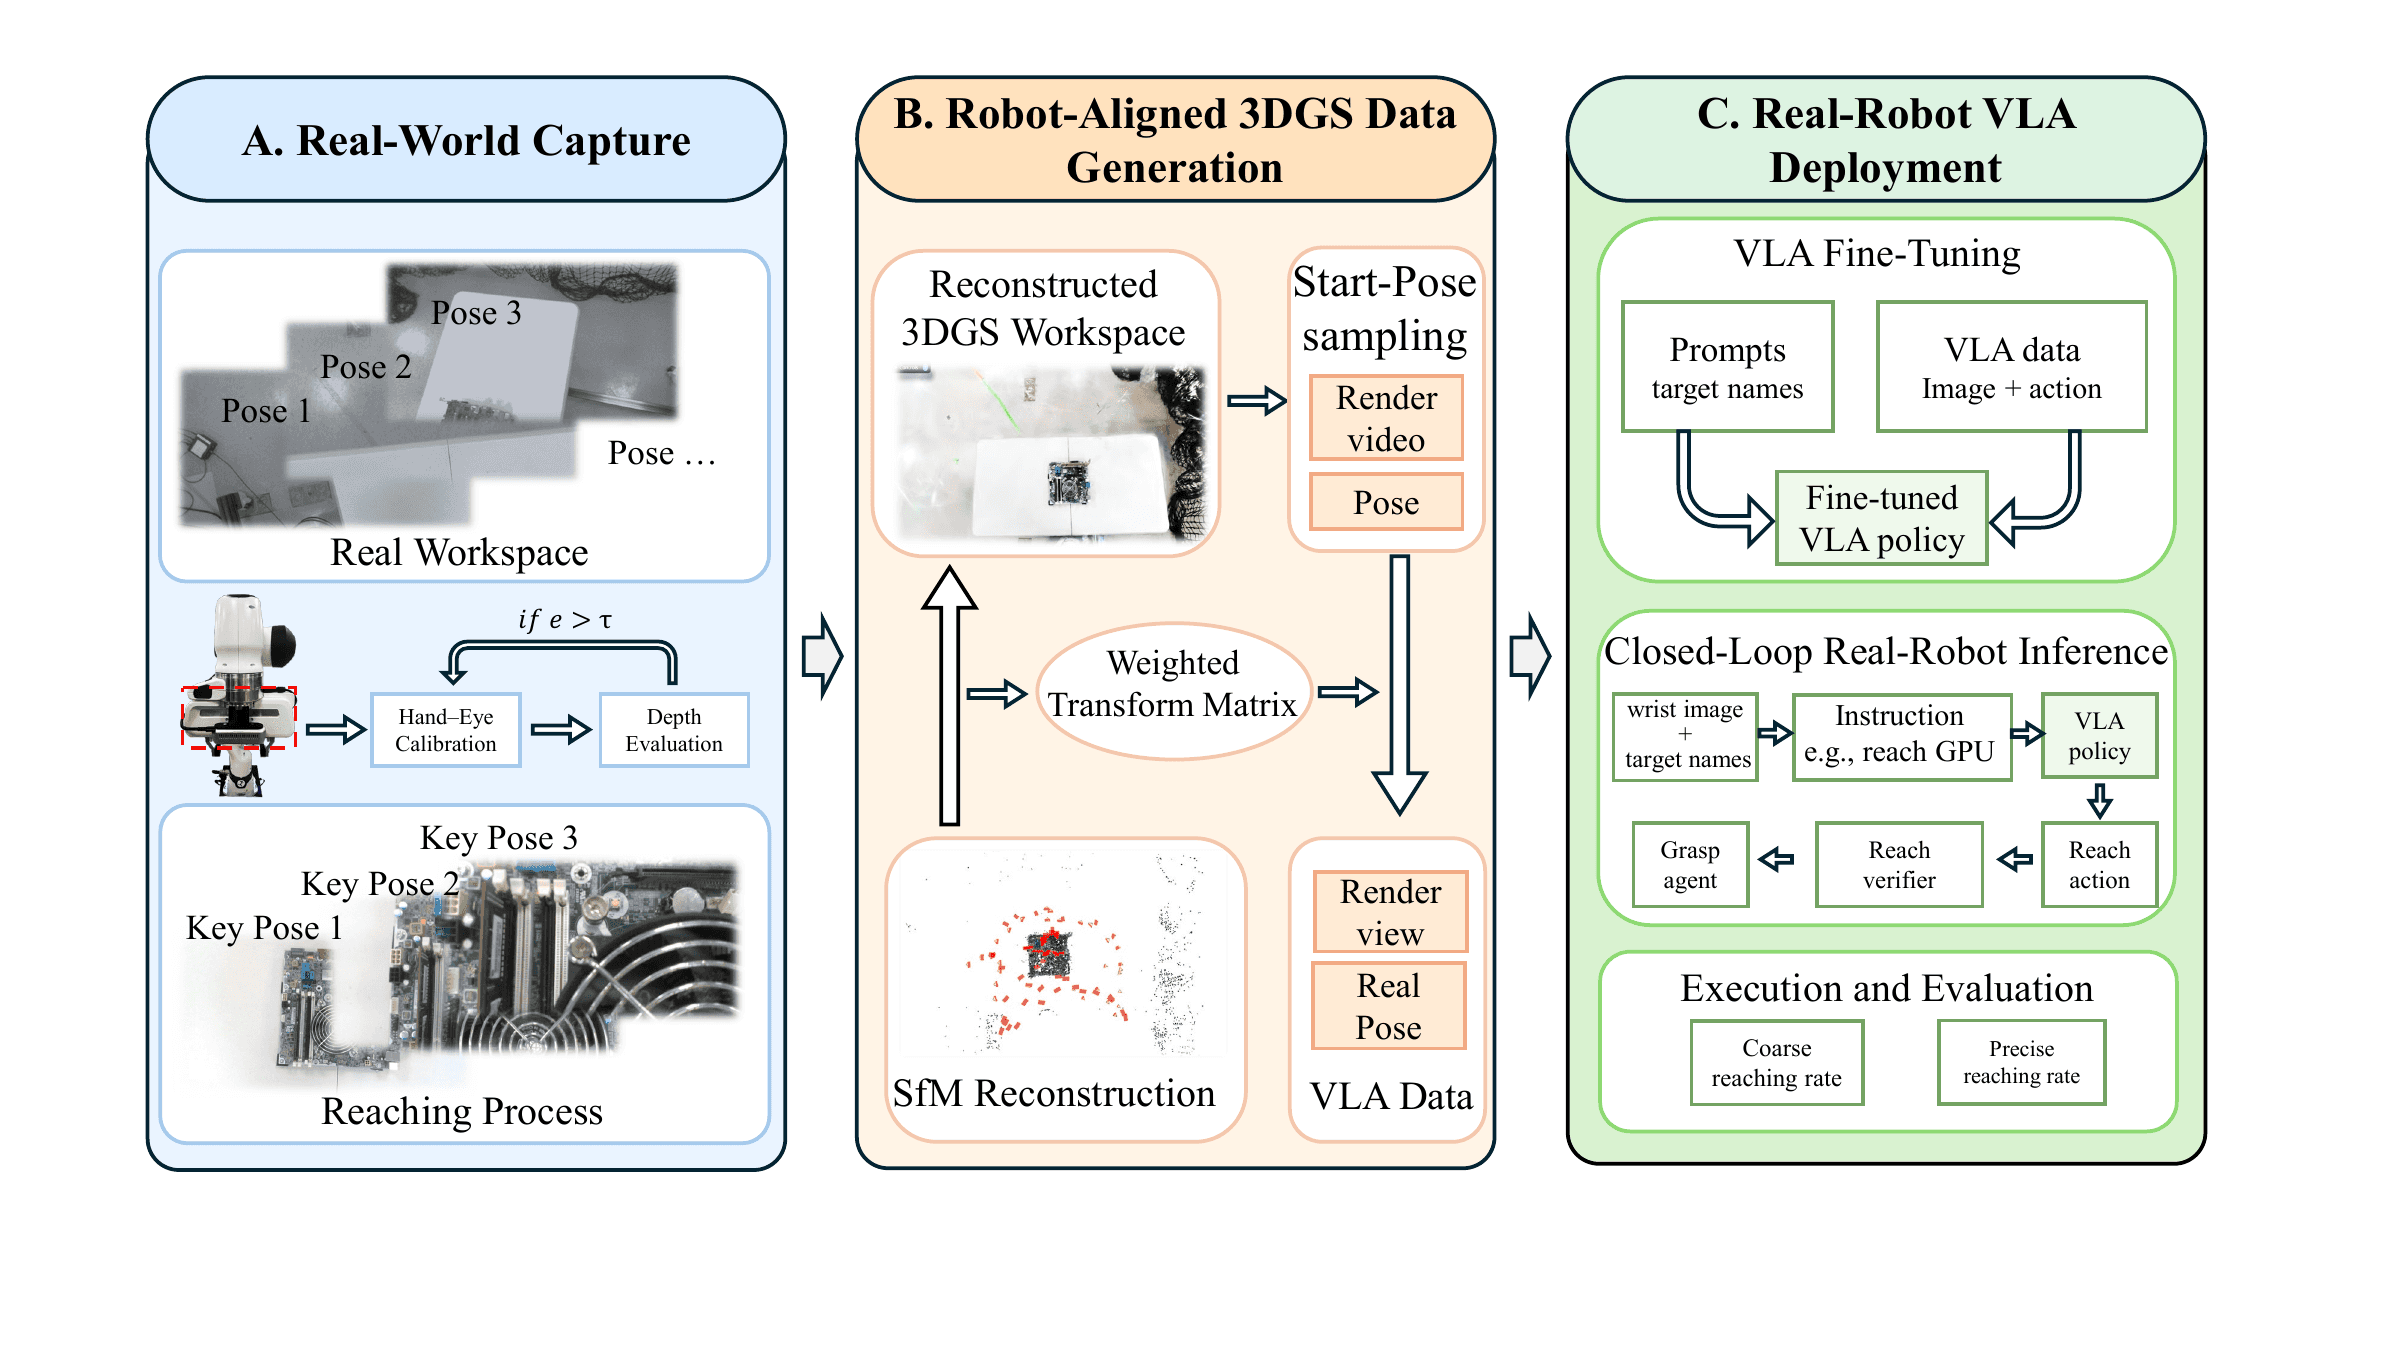
PrecisionReach-GS giải quyết bài toán thu thập dữ liệu cho giai đoạn pre-contact reaching: đưa end-effector đến vùng có thể bắt đầu tương tác. Công trình Robot-Aligned 3D Gaussian Splatting for Precise Reaching with Wrist-Camera VLA Policies, của Zuoxu Wang và Xiao Liang tại Texas A&M University, là preprint công bố ngày 26/10/2026. Ý tưởng là tái dựng workspace bằng 3D Gaussian Splatting, gắn cảnh vào hệ tọa độ robot, rồi sinh ảnh cổ tay cùng nhãn hành động.
Bài hướng dẫn này dựa trên repo chính thức và project page, được đối chiếu ngày 29/10/2026. Các bước cài đặt và chuyển đổi dùng tên script, tham số thật. Phần fine-tuning được trình bày như công việc tích hợp vì repo chưa phát hành toàn bộ training stack, dataset hay checkpoint. Đây không phải báo cáo vnrobo đã chạy thử trên Franka.
1. Hiểu pipeline trước khi cài đặt
Hãy tách pipeline thành ba công việc khác nhau:
| Giai đoạn | Input | Output cần kiểm tra |
|---|---|---|
| Capture và reconstruction | Ảnh workspace, intrinsics, robot poses, hand–eye calibration | Sparse model và cảnh 3DGS |
| Alignment và data generation | Cảnh, camera poses, target keyframes | Video wrist view đồng bộ với EE poses |
| Learning và deployment | Observation, instruction, state, action | Policy reaching và cơ chế xác nhận dừng |
3DGS biểu diễn cảnh bằng các Gaussian có vị trí, kích thước, hướng, độ trong suốt và thuộc tính màu. Renderer tổng hợp ảnh từ camera pose mới. Nó giúp giữ các chi tiết bề mặt và bối cảnh khó tái dựng thành mesh sạch, nhưng không tự cung cấp mô hình tiếp xúc của linh kiện.
Do đó, bạn không nên mong chờ cảnh Gaussian mô phỏng thao tác vặn vít hay lực rút RAM. Hệ thống học đường tiếp cận; một controller khác phụ trách thao tác sau đó. Sự phân chia này làm bài toán sinh dữ liệu nhẹ hơn, đồng thời giới hạn phạm vi kết luận của kết quả thực nghiệm.
Nếu còn lẫn lộn observation với action, hãy đọc hướng dẫn training SmolVLA. Các khái niệm dataset và normalization hữu ích ở đây, dù PrecisionReach-GS không phải một recipe LeRobot hoàn chỉnh.
2. Chuẩn bị môi trường và dữ liệu thật
Tải ZIP của nhánh main bằng nút Code → Download ZIP trong repo, giải nén rồi mở terminal tại thư mục có requirements.txt. Bạn cần Python 3.10 trở lên; lệnh dưới dùng python3, phù hợp với nhiều máy Linux:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python tools/align_colmap_to_robot.py --help
python tools/prepare_fastgs_robot_dataset.py --help
requirements.txt hiện chỉ liệt kê NumPy và Pillow. Cài xong hai thư viện này không đồng nghĩa đã có COLMAP, trainer 3DGS hay môi trường training π0.5. Bạn cần cài riêng COLMAP theo hướng dẫn chính thức, và chọn một pipeline 3DGS phù hợp với định dạng viewer.
Trước khi thu dữ liệu, cố định camera mount, ghi intrinsics ở đúng độ phân giải, và lưu robot pose cùng timestamp của ảnh. Đổi camera mount sau calibration có thể làm toàn bộ chuỗi transform không còn đúng. Một frame mẫu phải có trường rgb_path và ma trận base_T_camera kích thước 4×4.
Cấu trúc input được README mô tả như sau:
dataset/
  image/
    rgb_000000.png
    rgb_000001.png
  frame_poses.jsonl
  sparse/0/
    cameras.bin
    images.bin
    points3D.bin
frame_poses.jsonl chứa một JSON record trên mỗi dòng. Tên ảnh cần khớp với ảnh đăng ký trong sparse model. Đừng tạo ma trận identity giả để vượt qua kiểm tra định dạng: script có thể đọc được nhưng kết quả sẽ không có ý nghĩa vật lý.
Khi quay workspace, giữ cảnh tĩnh, di chuyển đủ chậm để giảm motion blur và tạo vùng chồng lấn giữa các ảnh. Bắt đầu bằng một vùng nhỏ có texture rõ để kiểm tra reconstruction, rồi mới mở rộng sang bề mặt phản xạ hoặc vùng có dây cáp. Đây là khuyến nghị thực hành, không phải một ngưỡng capture do tác giả công bố.
3. Hand–eye calibration: nối camera với robot
Dùng quy ước base_T_camera là transform đưa tọa độ một điểm từ camera frame sang robot base frame. Nếu đã có base_T_ee và transform cố định ee_T_camera, quan hệ là:
base_T_camera = base_T_ee @ ee_T_camera
Khi đổi chiều transform, bạn phải dùng nghịch đảo ma trận; đổi tên biến không thay đổi chiều ánh xạ. Cũng cần phân biệt camera optical frame với frame của vỏ thiết bị. Một phép quay sai trục có thể khiến renderer nhìn đúng linh kiện trong khi nhãn hành động lại hướng sang bên khác.
Ở đầu ra viewer, script chuyển đổi dùng trường camera_T_gripper trong run_metadata.json:
base_T_gripper = base_T_camera @ camera_T_gripper
Quan hệ này được ghi rõ trong mã camera_path_to_ee_poses.py. Đọc comment trong script trước khi chuẩn bị metadata, đặc biệt nếu robot của bạn gọi TCP và gripper center bằng những tên khác nhau.
Một phép kiểm tra dễ hiểu là chọn vài pose chưa dùng để calibration, chiếu các điểm trên một mặt phẳng tham chiếu về robot base, rồi kiểm tra độ nhất quán của mặt phẳng. Nếu sai số thay đổi mạnh theo hướng cổ tay, hãy xem lại hand–eye, timestamp và frame convention trước khi tăng số lượng trajectory. Bài UMI: SLAM và dữ liệu robot cung cấp thêm bối cảnh về việc giữ thông tin hình học nhất quán trong dataset.
4. Align COLMAP với robot base
COLMAP tái dựng cảnh trong hệ tọa độ SfM. Đơn vị, vị trí gốc và hướng trục của nó chưa mặc nhiên trùng robot. Tool alignment dùng các camera center tương ứng để tìm phép biến đổi gồm scale, rotation và translation; anchor frames cho phép tăng trọng số những góc nhìn quan trọng quanh đích.
Ví dụ từ README, sau khi thay đường dẫn bằng dataset của bạn:
python tools/align_colmap_to_robot.py \
  --colmap-model /path/to/dataset/sparse/0 \
  --robot-poses /path/to/dataset/frame_poses.jsonl \
  --output-model ./results/aligned \
  --mode similarity_plus_camera_rotation \
  --anchor-frames 66,69 \
  --anchor-weight 50
66 và 69 là ví dụ của repo, không phải hai chỉ số thích hợp cho mọi dataset. Chọn frame thực sự tồn tại và có pose đáng tin cậy gần vùng tương tác. Nếu chưa có anchor phù hợp, đọc --help và lựa chọn mode trước khi sao chép cấu hình có trọng số cao.
Hai file viewer cần là alignment.json và cameras_colmap_world.json. Giữ cùng một bộ reconstruction, splat và alignment trong một lần thử. Tái dựng lại cảnh rồi dùng alignment cũ là một cách tạo dữ liệu sai rất khó phát hiện bằng cách xem riêng từng ảnh.
Chuẩn bị input cho FastGS
Repo có utility riêng cho dữ liệu robot-pose-aware. Khi đã có aligned model và ảnh undistorted, có thể chạy:
python tools/prepare_fastgs_robot_dataset.py \
  --aligned-model ./results/aligned \
  --robot-poses /path/to/dataset/frame_poses.jsonl \
  --undistorted-images /path/to/undistorted/images \
  --source-images /path/to/dataset/image \
  --output-root ./results/fastgs_robot
Tham số trên được đối chiếu với script chuẩn bị dataset. Script chuẩn bị dữ liệu, không thực hiện training Gaussian. Bạn vẫn phải chạy trainer 3DGS bên ngoài và xuất file .splat hoặc .ply tương thích. Không phải mọi biến thể PLY đều có cùng thuộc tính Gaussian; hãy kiểm tra một cảnh nhỏ trong viewer trước khi chạy reconstruction lớn.
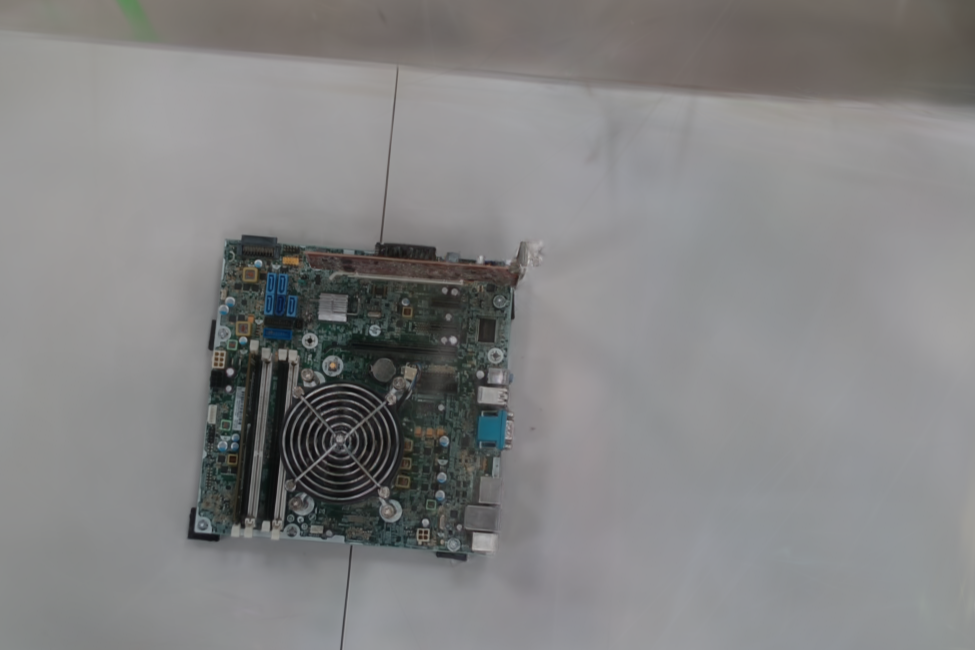
Ảnh trên minh họa lượng bối cảnh được giữ trong representation. Hãy kiểm tra cả vị trí target lẫn những chi tiết ở rìa ảnh, vì policy có thể sử dụng chúng khi đích chưa nằm giữa trường nhìn.
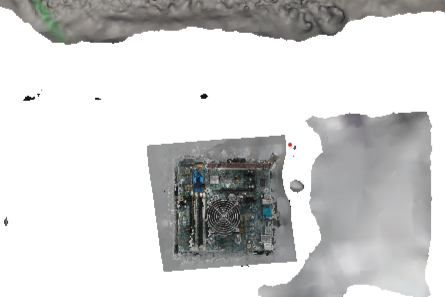
Hai ảnh là minh họa của project, không phải bằng chứng rằng mọi reconstruction 3DGS đều tốt hơn mesh. Capture thiếu góc nhìn vẫn có thể tạo vùng mờ, floaters hoặc appearance không ổn định.
5. Sinh wrist-camera trajectory bằng viewer
Từ thư mục gốc repo, chạy:
python -m http.server 8765 --bind 127.0.0.1
Mở hai URL trong cùng trình duyệt:
http://127.0.0.1:8765/gs_dual_viewer/index.html?role=ee
http://127.0.0.1:8765/gs_dual_viewer/index.html?role=side
EE view là góc camera dùng cho dữ liệu policy. Side view là công cụ quan sát cảnh và camera frustum trong quá trình tạo dữ liệu; nó không có nghĩa deployment bắt buộc dùng camera ngoài.
Theo viewer guide chính thức, quy trình thực hành gồm:
- Load cảnh
.splathoặc.ply, rồi loadalignment.json. - Chọn vị trí bắt đầu có hình ảnh rõ và kiểm tra
Check Reachability. - Chuẩn bị path gồm pre-approach pose và target pose; lưu lại để tái sử dụng.
- Chọn
Smoothtrong mụcmotion, load path bằngLoad Path. - Dùng
Record Start + Pathđể ghi start hiện tại cùng các pose trong path. - Khi clip đơn đã đúng, chọn
Output Folder, đặt batch count nhỏ rồi chạyBatch Starts.
Bắt đầu với vài clip để kiểm tra ảnh, thời gian và tọa độ. Sau đó mới tăng batch count. Mỗi clip được xuất cùng log pose; các tên có dạng 000.webm, 000_ee_poses.json, 000_ee_poses.csv và 000_camera_path_keyframes.json.
Record WebM + EE Poses lưu cả frame_index, video_time_sec, timestamp_ms và base_T_gripper. Khi decode video để training, sử dụng những chỉ số này để ghép frame và pose; đừng ghép dựa trên thứ tự file trong thư mục.
Viewer công khai ghi rõ IK hiện ưu tiên ràng buộc vị trí gripper, chưa ràng buộc wrist orientation khớp camera hoàn toàn. IKerr nhỏ cũng không bảo đảm tránh singularity hoặc va chạm. Cần kiểm tra orientation, joint limits và đường đi bằng stack robot của bạn trước khi coi clip là demonstration có thể thực thi.
6. Từ pose log đến action cho π0.5
Một frame training cần liên kết bốn thành phần: ảnh cổ tay, instruction, robot state và action. Việc có video cùng pose log mới chỉ là bước đầu. Bạn còn cần adapter chuyển trajectory sang representation mà cấu hình policy đang dùng thực sự mong đợi.
Nếu cần đổi saved camera keyframes sang gripper poses, script sau có sẵn:
python tools/camera_path_to_ee_poses.py \
  --path-json ./camera_path_keyframes.json \
  --run-metadata /path/to/run_metadata.json \
  --output-json ./ee_keyframes.json \
  --output-csv ./ee_keyframes.csv
Script này chuyển keyframes, không tự tạo dataset LeRobot hay toàn bộ joint-action trajectory. Metadata phải chứa calibration thật ở trường camera_T_gripper. Nếu path chưa có robot_camera_to_world, hãy quay lại viewer và load alignment trước khi export.
Với joint-space supervision, một cách biểu diễn là giải IK cho từng EE pose rồi lấy chênh lệch giữa hai joint configurations liên tiếp. Hãy giữ nghiệm IK liên tục: hai nghiệm khác nhau cho cùng một pose có thể tạo bước nhảy joint lớn dù camera path rất mượt.
Đừng tự động hiểu output π0.5 luôn là joint delta. Action semantics phụ thuộc adapter và training configuration. Nếu training dùng delta mà controller hiểu absolute position, lỗi sẽ xuất hiện ngay từ bước đầu. Ghi rõ đơn vị radians, thứ tự joints, gripper channel và cadence trong dataset của bạn.
7. Fine-tuning và reach verifier: phần cần tích hợp
Repo hiện không cung cấp một lệnh train.py hoàn chỉnh cho π0.5, checkpoint fine-tuned hay exporter dataset end-to-end. Vì vậy, không có lệnh duy nhất trong bài này có thể tái lập toàn bộ benchmark. Bạn cần nối dữ liệu đã kiểm tra vào stack phù hợp, chẳng hạn OpenPI chính thức, theo action contract của cấu hình đã chọn.
Một kế hoạch tích hợp cho beginner là:
- Chốt observation schema và action schema trước khi convert hàng loạt.
- Tách train/validation theo episode; tránh chia các frame kề nhau của cùng clip sang hai tập.
- Tính normalization chỉ từ training split, rồi lưu cùng cấu hình model.
- Kiểm tra một batch: ảnh đúng màu, state đúng joint order, instruction đúng target, action đúng cadence.
- Thử overfit một tập nhỏ để phát hiện lỗi adapter trước khi mở rộng dữ liệu.
Những bước này là khuyến nghị kỹ thuật của bài hướng dẫn, không phải hyperparameters công bố của tác giả. Không có đủ cơ sở để tự điền batch size, learning rate hay số GPU rồi gọi đó là cấu hình paper.
Ngoài policy, paper dùng một reach verifier riêng để ước lượng khoảng cách đến target từ ảnh, instruction và state. Nhánh visual được condition bằng ngôn ngữ qua FiLM và spatial attention, rồi hợp nhất với state. Verifier học bằng Smooth-L1; state masking giúp giảm việc dựa quá nhiều vào tọa độ tuyệt đối. Cơ chế này khác với việc coi action gần zero là dấu hiệu chắc chắn đã đến đích.
Trong triển khai riêng của bạn, cần tập validation cho từng target và các tình huống gần đích nhưng chưa thẳng hàng. Đặc biệt, một mô hình dự đoán khoảng cách tốt trung bình vẫn có thể dừng sai ở những frame quan trọng nhất. Kiểm tra false stop trực tiếp thay vì chỉ xem loss.
8. Inference: đóng vòng phản hồi trước khi gắp
Luồng inference cần đọc ảnh mới và state mới, chạy policy, giới hạn action, thực thi một phần chunk rồi quan sát lại. Gần target, nên tăng tần suất phản hồi thị giác bằng cách thực thi ít action hơn giữa hai lần query. Verifier quyết định khi nào chuyển quyền điều khiển sang routine thao tác.
Bảng dưới là checklist tích hợp, không phải một API được repo phát hành:
| Kiểm tra | Câu hỏi cần trả lời |
|---|---|
| Camera | Crop, resize, intrinsics có khớp dữ liệu không? |
| State | Joints, gripper và timestamp có cùng observation không? |
| Action | Delta hay absolute, radians hay degrees? |
| Chunk | Controller thực thi bao nhiêu bước trước khi lấy ảnh mới? |
| Termination | Verifier đã được đánh giá trên workspace hiện tại chưa? |
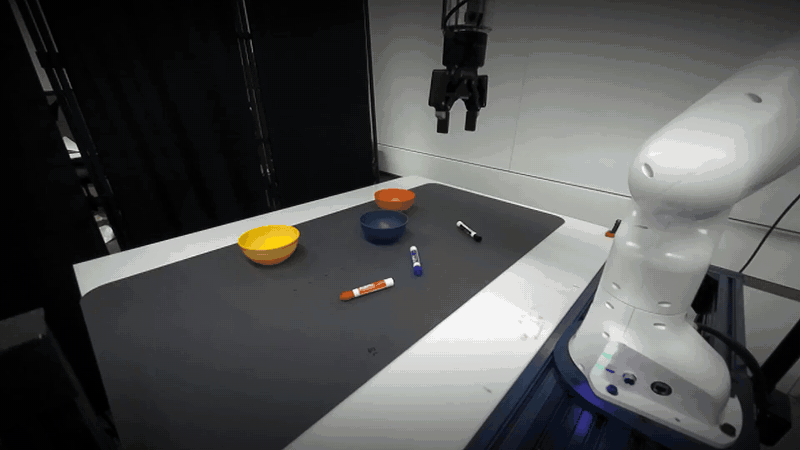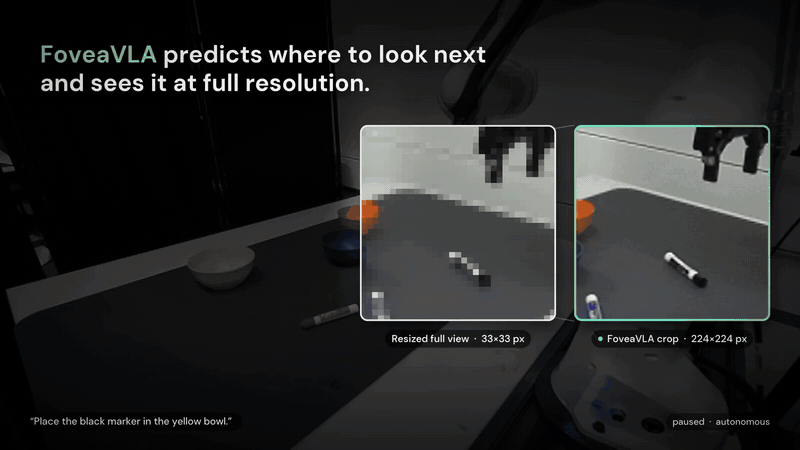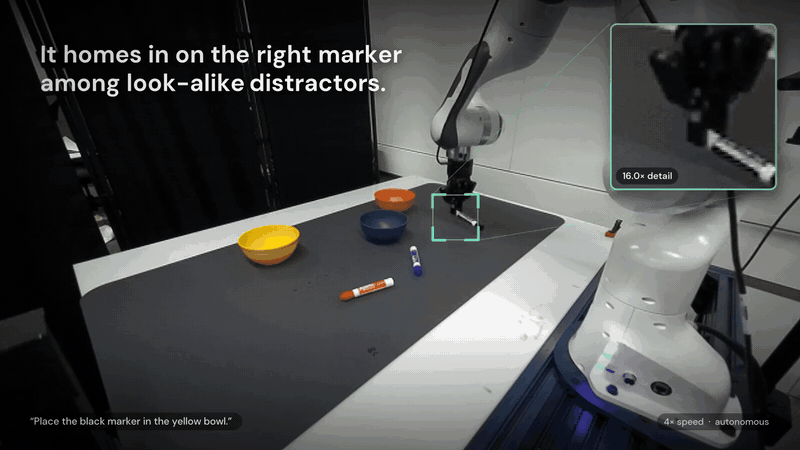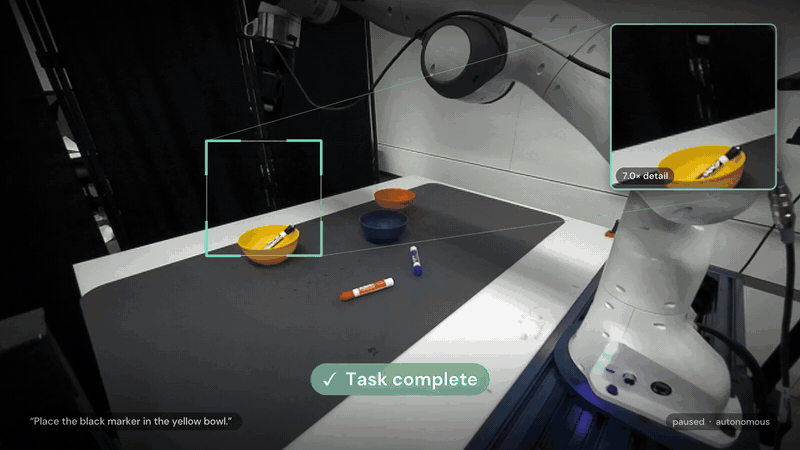
Nếu mới tìm hiểu các cách phân bổ góc nhìn cho VLA, FoveaVLA và camera ngoài là bài đối chiếu hữu ích. PrecisionReach-GS tập trung tạo supervision nhất quán cho wrist view; việc đổi sensor setup cần được đánh giá riêng.
Video là kết quả minh họa của nhóm tác giả. Tốc độ phát nhanh không cho biết trực tiếp latency của policy hay control frequency trên phần cứng của bạn.
9. Đọc kết quả và giới hạn đúng cách
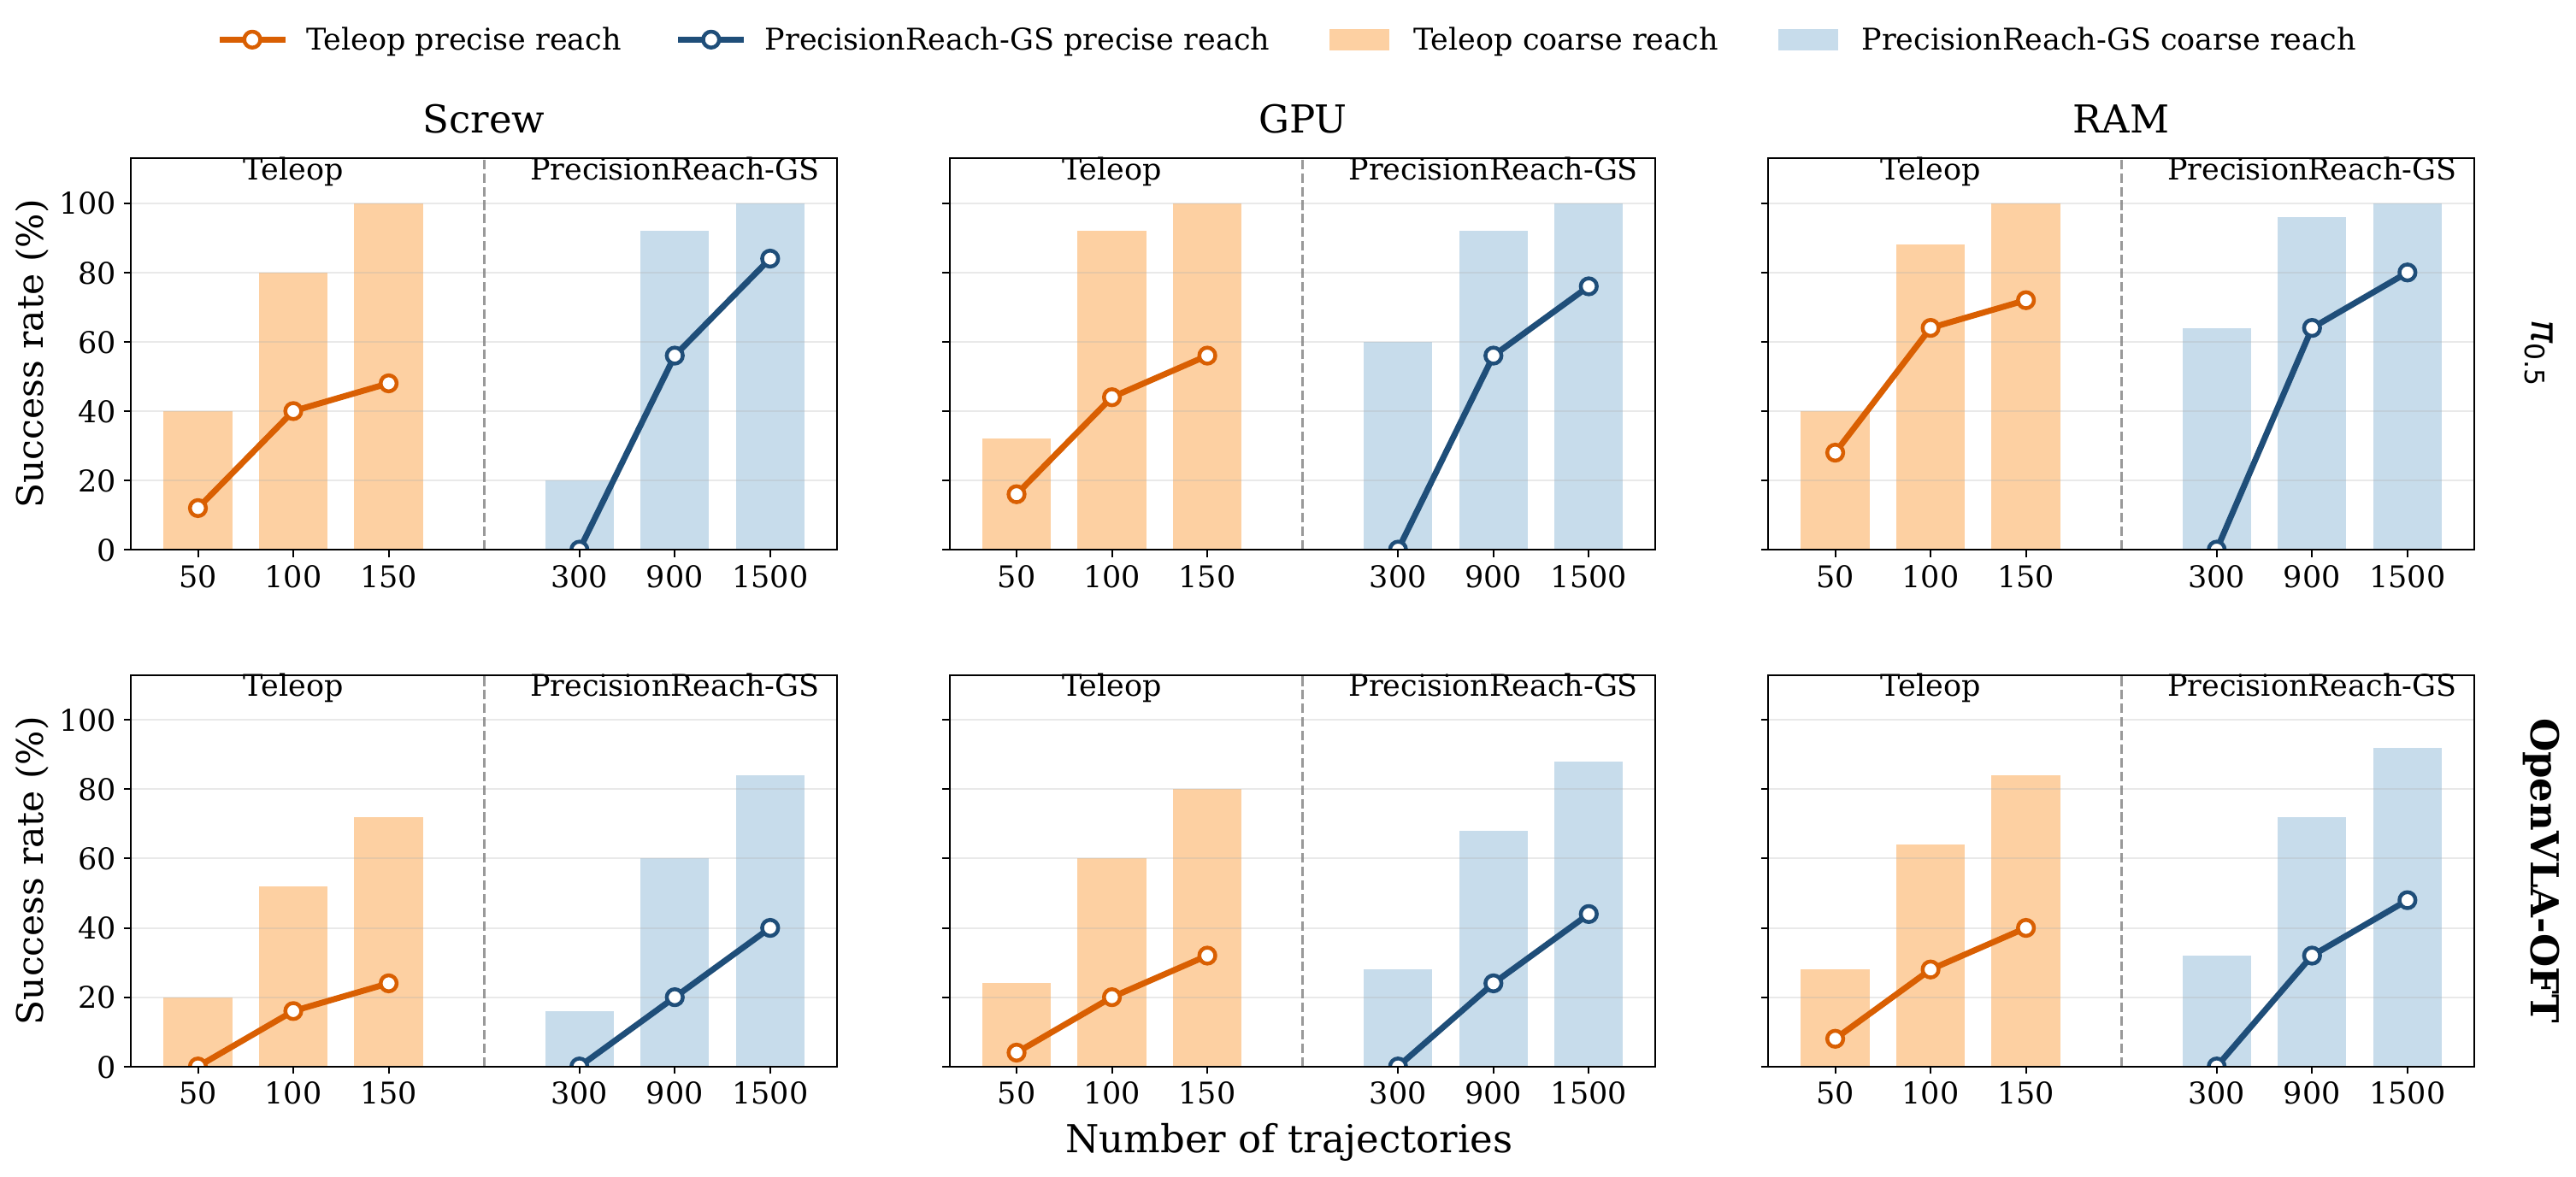
Các con số nổi bật được README tóm tắt:
| π0.5, 1.500 generated trajectories | Precise reach |
|---|---|
| Screw | 21/25 |
| GPU | 19/25 |
| RAM | 20/25 |
Tổng là 60/75, tương đương 80%. Paper so sánh với 58,7% của 150 teleoperated demonstrations. Đây không phải so sánh cùng số episode: quy mô, chất lượng trajectory và sensor setup khác nhau. Baseline teleop chính dùng wrist cùng side view, trong khi generated setting dùng wrist view.
Precise reach được kiểm tra bằng một routine grasp-and-lift cố định ở terminal pose. Kết quả vì thế cho biết pose kết thúc có phục vụ được thao tác sau đó, không chứng minh VLA đã học toàn bộ quá trình tháo linh kiện hay điều khiển lực tiếp xúc.
README cũng báo RMS jerk của trajectory sinh là 0,2353 m/s³, so với 3,2657 m/s³ ở teleoperation. Jerk là tốc độ thay đổi của acceleration; giá trị thấp hơn cho thấy supervision mượt hơn theo phép đo này, không tự bảo đảm đường đi tránh vật cản.
Mốc dưới 10 phút là active human capture. Theo bảng thời gian trong paper, tạo 1.500 trajectory mất khoảng 200 phút tổng thời gian ở một generation window. Không nên quảng bá thành “toàn bộ pipeline hoàn tất trong 10 phút”, càng không bao gồm cả fine-tuning.
Giới hạn thực tế còn nằm ở scene tĩnh, calibration, góc nhìn được capture và kiểm tra khả thi của path. Một workspace bị thay linh kiện hoặc camera mount bị xê dịch có thể cần reconstruction hoặc calibration mới. Với lần thử đầu tiên, mục tiêu hợp lý là tạo một clip có ảnh–pose đúng, chuyển keyframe đúng, rồi kiểm tra adapter trên một batch; sau đó mới mở rộng training và thử robot.