Một robot nhìn thấy chiếc bát trước mặt, đưa tay đến gần, rồi lại rút tay về. Khung hình tiếp theo vẫn có vẻ hợp lý, nhưng policy tiếp tục đảo chiều. Nếu chỉ nhìn hiện tại, robot có thể không phân biệt được “đang tiến đến để gắp” với “vừa thử gắp và cần đổi cách”. Đây là một lý do memory trở thành chủ đề quan trọng trong Vision-Language-Action, hay VLA.
REKI — Registering Knowledge in VLAs của Kyutai cùng các cộng tác viên tại Inria và École nationale des ponts et chaussées giải quyết vấn đề bằng một lựa chọn gọn: đặt memory ngay trong action expert. Mô hình có khoảng 2,4 tỷ tham số, được pretrained trên dữ liệu công khai, rồi fine-tune riêng cho từng benchmark. Với LIBERO, nhóm phát hành checkpoint để bạn chạy trực tiếp qua API REKI hoặc plugin LeRobot.
Bài này đi từ ý tưởng paper đến cài đặt, thử một task, inference, fine-tuning và cách đọc kết quả. Các lệnh được đối chiếu với repository ngày 20/10/2026; số benchmark là kết quả tác giả công bố, không phải phép đo chúng tôi đã chạy lại. Nguồn chính là paper REKI, repository chính thức và tài liệu kỹ thuật liên kết ở từng phần.
1. Hiểu mục tiêu trước khi thuê GPU
VLA nhận ảnh camera, chỉ dẫn ngôn ngữ và trạng thái robot để sinh hành động. VLM là phần hiểu ảnh và câu lệnh; action expert chuyển biểu diễn đó thành lệnh điều khiển. LIBERO là bộ benchmark manipulation trong simulation, với robot Franka Panda và nhiều nhiệm vụ như di chuyển, gắp hoặc đặt đồ vật.
Bạn nên bắt đầu bằng checkpoint kyutai/reki-2b-libero. Nó đã được fine-tune cho LIBERO. Checkpoint kyutai/reki-2b là nền pretrained để fine-tune tiếp, không phải bản thay thế tương đương cho bài đánh giá LIBERO.
Cần tách ba mức công việc. Chạy checkpoint có sẵn giúp kiểm tra môi trường và quan sát rollout. Fine-tuning cần dữ liệu và nhiều bộ nhớ GPU hơn. Tái lập toàn bộ pretraining là một dự án nghiên cứu lớn: recipe công bố sử dụng 200.000 steps trên 32 H100. Tại thời điểm đọc, README vẫn ghi pretraining code và data pipeline sẽ được phát hành trong bản cập nhật sau; có recipe không đồng nghĩa mọi bước pretraining đã sẵn sàng chạy.
Nếu mới làm quen, hãy đặt mục tiêu đầu tiên là chạy được một task có ảnh đầu vào đúng chiều, action hợp lệ và log kết quả rõ ràng. Đừng bắt đầu bằng cách thuê cả node chỉ để kiểm tra một import Python.
2. Ý tưởng paper: nhớ quá khứ mà không đọc lại video
Cách trực tiếp để policy có memory là đưa nhiều khung hình quá khứ vào VLM. Tuy nhiên, mỗi ảnh tạo thêm vision tokens và tăng chi phí xử lý. Một hướng khác là recurrent state hoặc module memory riêng, nhưng chúng có thể làm training phải chạy tuần tự hoặc thêm thành phần kiến trúc.
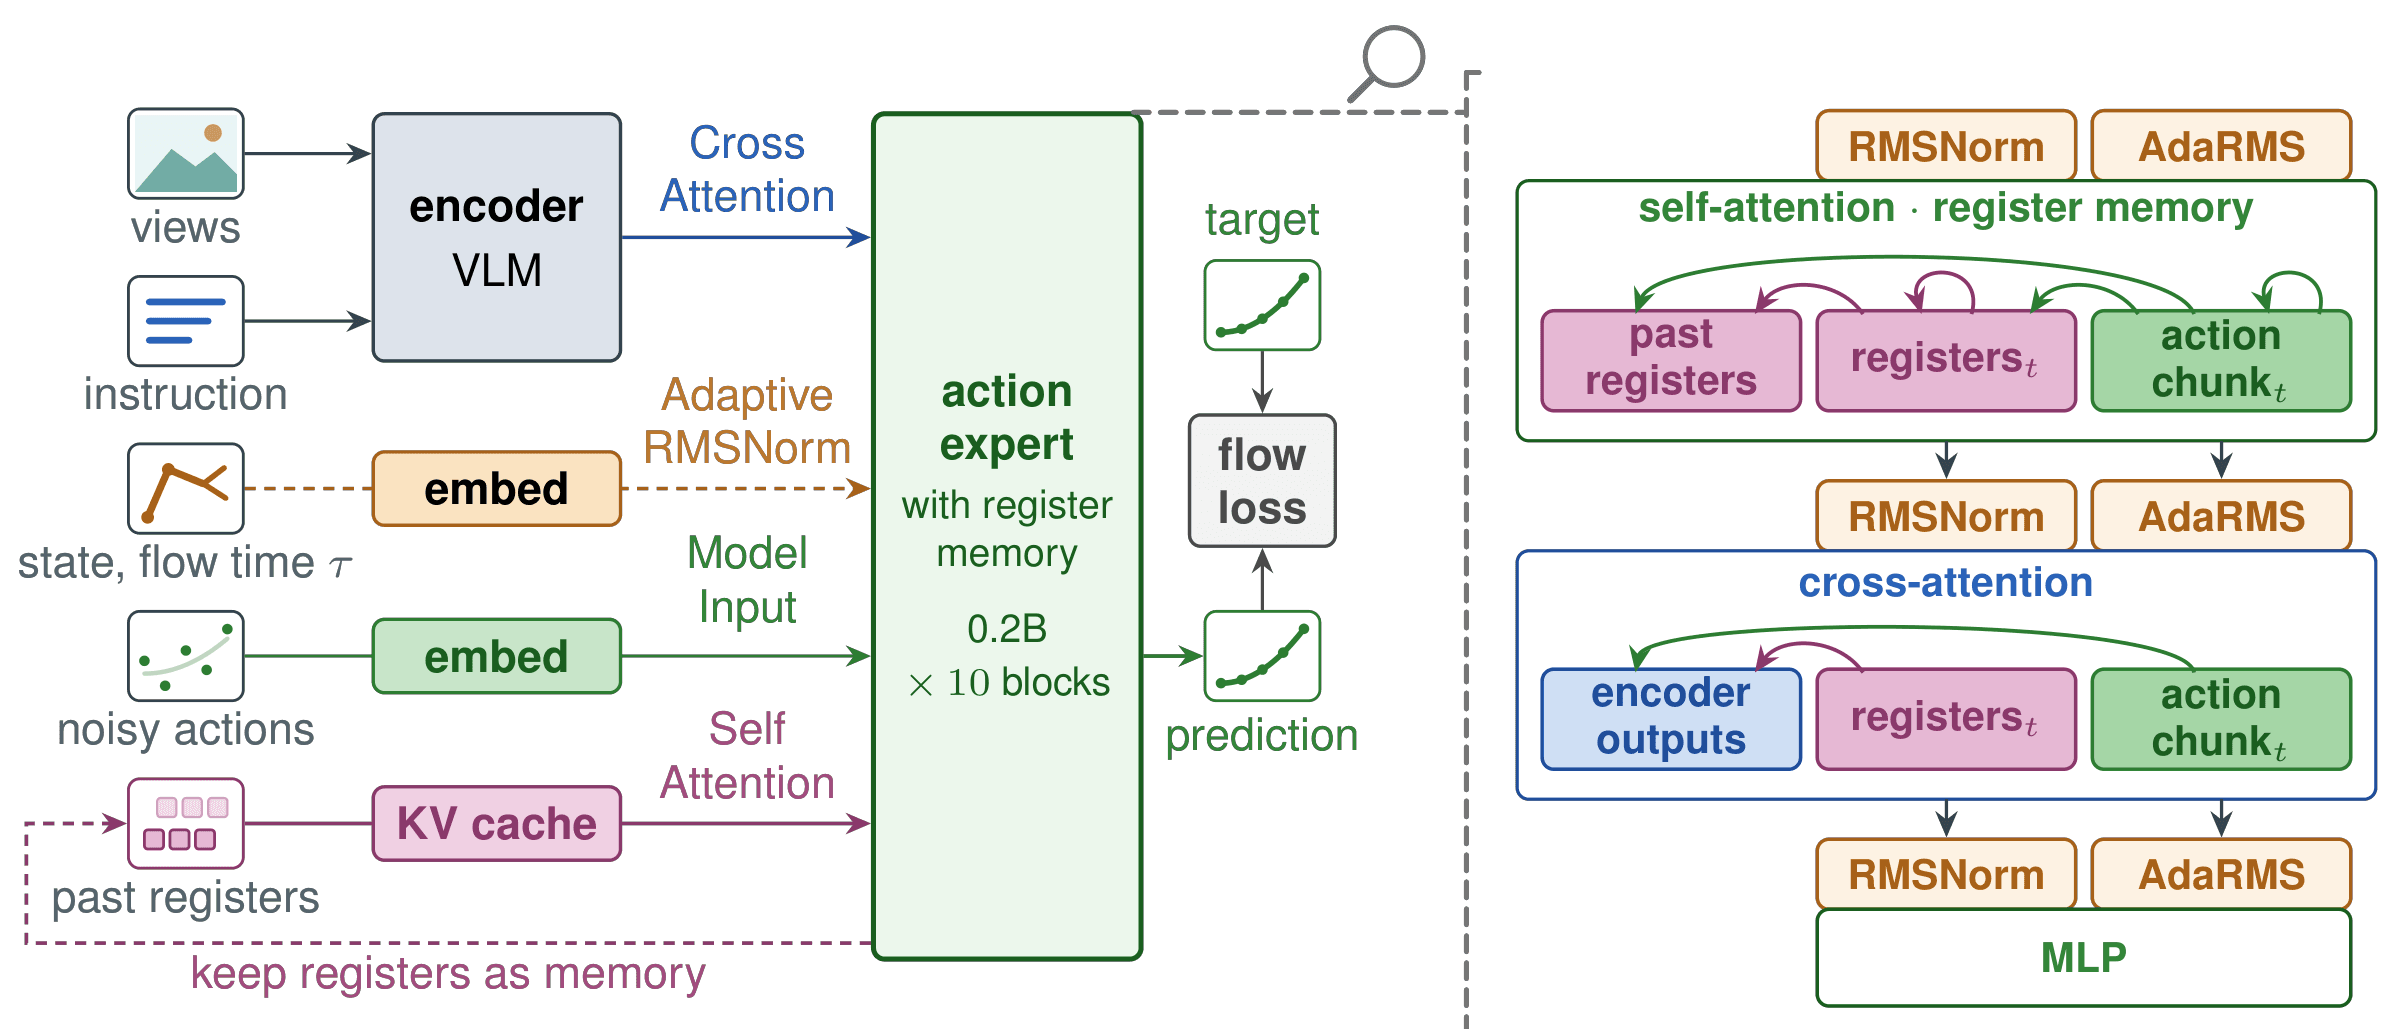
REKI để VLM xử lý một observation tại một thời điểm. Trong action expert, mỗi frame có 32 learned register tokens. Chúng tóm tắt thông tin ảnh và ngôn ngữ, rồi lưu keys và values vào cache để các frame sau đọc lại. Policy vì thế có thể biết vừa xảy ra điều gì mà không cần encode lại các ảnh cũ.
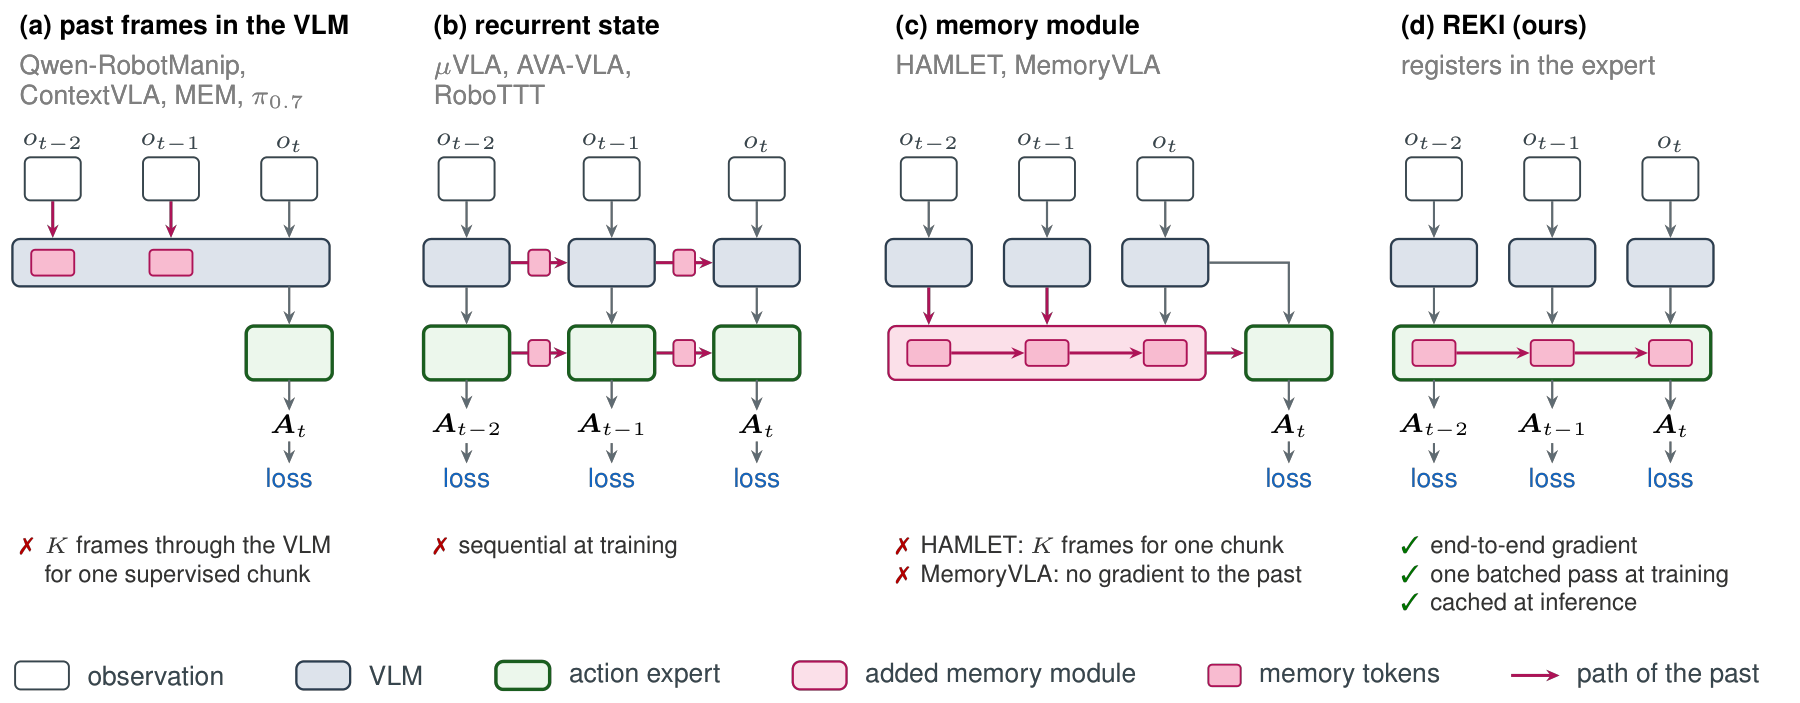
Recipe mặc định dùng cửa sổ K = 3 frames, cách nhau một giây. Khi dự đoán frame hiện tại, mô hình đọc registers hiện tại và cache của hai frame trước. Đây là lịch sử ngắn, không phải trí nhớ dài hạn cho mọi sự kiện trong một phiên làm việc.
Một chi tiết quyết định hiệu quả là registers không đọc action tokens hoặc robot state. Chúng không phụ thuộc flow time của quá trình denoising. Vì vậy, REKI tính registers một lần cho observation mới, rồi tái sử dụng trong các bước sinh action và ở lần dự đoán sau. Đây là cơ sở của chi phí memory thấp, không phải do mô hình bỏ qua lịch sử.
Theo phân tích memory trên project page, cache thêm khoảng 2 MiB GPU memory cho mỗi past frame. Với hai camera 256×256 và compilation trên H100, đọc memory tăng khoảng 0,1 ms. Những số này gắn với cấu hình đo của tác giả; không nên dùng chúng làm cam kết cho mọi GPU.
3. Kiến trúc: VLM, action expert và flow matching
Theo tài liệu architecture, VLM dựa trên Qwen3.5-2B, thực tế chiếm khoảng 2,2B parameters, còn action expert khoảng 0,2B. Action expert là diffusion transformer có 10 layers, hidden width 768, 12 attention heads và MLP width 3072.
Luồng thông tin có thể hình dung như sau:
Ảnh camera + instruction
          |
          v
     Qwen3.5 VLM ----> context của observation hiện tại
                              |
                     cross-attention
                              v
Registers quá khứ ---> Action expert ---> action chunk 1 giây
                              ^
                  robot state + flow time
                    qua adaptive RMSNorm
Mỗi expert block có self-attention, cross-attention tới đầu ra layer cuối của VLM và MLP. Robot state đi qua một MLP theo state format, sau đó cùng flow time điều kiện hóa action tokens qua adaptive RMSNorm. Không nên hiểu state là một đoạn văn được nhét vào memory.
Flow matching học cách biến một action chunk nhiễu thành chuyển động phù hợp với observation. Khi inference, model dùng 10 denoising steps để sinh chunk. Chunk mặc định dài một giây; số action bên trong phụ thuộc control frequency. 10 denoising steps không có nghĩa chunk chỉ chứa 10 lệnh điều khiển.
Trong training, action được zero-pad đến 32 dimensions để hỗ trợ nhiều embodiments; loss bỏ qua phần padding. API trả action theo kích thước và convention của checkpoint, không yêu cầu người dùng gửi toàn bộ vector padded vào simulator.
4. Cài đặt môi trường có thể tái lập
Yêu cầu chính thức là Linux x86-64, NVIDIA GPU với CUDA 12 và Pixi. Pixi cung cấp Python 3.12 và lock dependencies. Kiểm tra driver bằng nvidia-smi, đồng thời xác nhận pixi --version hoạt động trước khi đi tiếp.
Chạy các lệnh dưới trong môi trường làm việc của riêng bạn, từ thư mục repository REKI:
git clone https://github.com/kyutai-labs/reki.git
cd reki
pixi install --frozen
cp .env.example .env
Sửa .env theo ổ đĩa thực tế. Ba biến quan trọng là REKI_DATASETS_ROOT cho datasets, REKI_RUNS_DIR cho training runs và REKI_SIM_ROOT cho simulators. HF_HOME là tùy chọn để đặt cache model. Chọn nơi có đủ dung lượng; trên cluster, compute nodes phải đọc được các đường dẫn dùng chung.
Không thay toàn bộ dependencies bằng bản mới nhất chỉ vì cài đặt thất bại. README ghi kết quả dùng torch==2.7.0, transformers==5.3.0, flash-linear-attention==0.4.2, FlashAttention 2.8.3 và LeRobot revision aa9cc9b; pixi.lock giữ cấu hình cụ thể. Khác version có thể thay API hoặc kết quả rendering.
Cài riêng simulator LIBERO:
bash scripts/eval/install.sh libero
Script tạo môi trường Pixi sim. LIBERO render bằng OSMesa trên CPU; policy vẫn cần GPU NVIDIA. Theo hướng dẫn simulator, phải giữ MuJoCo 3.3.2 và Mesa đã pin. Đổi MuJoCo có thể làm màu ảnh khác đi, đủ ảnh hưởng success rate ngay cả khi model weights giữ nguyên.
5. Chạy một task bằng LeRobot
lerobot_policy_reki được cài cùng môi trường Pixi. Plugin đăng ký cả policy type reki và env type reki, để lerobot-eval sử dụng protocol simulator của dự án. Đây là plugin inference only; fine-tuning bên dưới dùng training scripts của REKI.
Sau khi cài LIBERO, thử task đầu tiên của suite Spatial:
S=$(pixi run printenv REKI_SIM_ROOT)
env -u DISPLAY MUJOCO_GL=osmesa PYOPENGL_PLATFORM=osmesa \
  LIBERO_CONFIG_PATH="$S/libero/config" \
  pixi run -e sim lerobot-eval \
    --policy.path=kyutai/reki-2b-libero \
    --env.type=reki --env.benchmark=libero \
    --env.task=libero_spatial --env.task_ids='[0]' \
    --env.n_episodes=10 \
    --eval.batch_size=1 --eval.n_episodes=10 \
    --output_dir=results/reki-libero-smoke
Ở đây S chỉ là biến trỏ đến simulator root. env -u DISPLAY tránh phụ thuộc màn hình desktop; OSMesa phục vụ rendering headless. Hai giá trị episodes được đặt rõ: 10 episodes cho một task ở environment và tổng cộng 10 episodes cho evaluator.
Giữ --eval.batch_size=1, vì plugin chưa hỗ trợ batched inference. Nếu mở rộng sang nhiều task, tổng --eval.n_episodes phải bằng số task nhân episodes mỗi task. Environment in số này khi khởi động. Muốn kiểm soát seeds của episodes, dùng --env.seed; tài liệu ghi lerobot-eval --seed không thay seeds của benchmark episodes.
Lần prediction đầu có thể mất 15–30 giây vì compilation. Đừng kết luận model bị treo chỉ từ khoảng chờ này; xem log và hoạt động GPU. Sau rollout, LeRobot ghi eval_info.json. Một task chạy thành công mới chứng minh đường đi cài đặt–policy–simulator hoạt động, chưa tái lập được điểm toàn benchmark. Các giới hạn và cờ lệnh nằm trong tài liệu evaluation.
6. Hiểu inference API trước khi tự nối simulator
API trực tiếp trả cả action chunk. Đoạn dưới minh họa với một observation LIBERO đã có sẵn; proprio phải được dựng theo đúng training state layout, không phải vector tùy ý:
import numpy as np
from reki import RekiPolicy

policy = RekiPolicy.from_pretrained(
    "kyutai/reki-2b-libero", device="cuda"
)
print(policy.spec.camera_keys)
print(policy.spec.state_layout)
policy.reset()  # gọi tại đầu mỗi episode

# obs và proprio do adapter simulator của bạn cung cấp.
images = {
    "camera_top": np.ascontiguousarray(
        obs["agentview_image"][::-1, ::-1]
    ),
    "camera_wrist_left": np.ascontiguousarray(
        obs["robot0_eye_in_hand_image"][::-1, ::-1]
    ),
}
actions = policy.predict(
    images=images,
    state=proprio,
    task="put the bowl on the plate",
)
print(actions.shape)
Ảnh phải là RGB, uint8, dạng H×W×3. Với LIBERO, tài liệu yêu cầu xoay ảnh environment 180° để khớp training data; slicing hai trục ở trên thực hiện việc đó. Không xoay thêm nếu wrapper đã xử lý. Sai chiều ảnh thường không gây lỗi Python nhưng làm policy nhìn thấy một thế giới khác.
state_layout và camera keys trong spec là hợp đồng dữ liệu. State trực tiếp phải theo observation.state của training dataset; adapter chính thức thực hiện slicing và chuyển đổi cần thiết. Đừng tự ghép quaternion, Euler angles và gripper thành vector chỉ vì số phần tử có vẻ gần đúng.
Kết quả predict là NumPy float32, shape [n_action_steps, action_dim], đã unnormalize. Thực thi từng action theo convention simulator rồi dự đoán lại sau policy.n_action_steps environment steps. Với checkpoint phát hành, đó là một giây hành động. Không normalize thêm lần nữa và không gọi prediction ở mọi physics step: nhịp đó làm cache nhận lịch sử dày hơn lúc training.
LeRobot wrapper nhận observation theo feature names của dataset và select_action trả từng action bằng queue nội bộ. Khi dùng wrapper, hãy để nó quản lý chunk; đừng xây thêm một tầng queue làm lệch cadence. Dù dùng API nào, reset() ở đầu episode phải xóa cả lịch sử cũ để tránh thông tin task trước lọt sang task sau.
7. Chuẩn bị dữ liệu và fine-tune LIBERO
Sau khi checkpoint có sẵn chạy được, mới chuyển sang training. Tải dataset và tính statistics đúng representation:
pixi run python scripts/data/download.py libero
pixi run python scripts/data/recompute_euler_stats.py --datasets libero
pixi run python scripts/dry_run.py \
  --config=configs/sft.yaml --dataset=libero --batch_size=4
LIBERO dataset đã ở LeRobot v3.0. Bước Euler statistics gắn với cách dự án chuyển đổi rotations và normalize dữ liệu. Bỏ bước này có thể làm training hoặc evaluation dùng statistics không phù hợp. Dry run thực hiện một batch forward/backward để phát hiện lỗi đường dẫn, decoding, shape hoặc memory sớm.
Lệnh local chính thức dưới dùng tất cả GPU trên máy qua Accelerate:
pixi run train --config=configs/sft.yaml \
  --pretrained_path=kyutai/reki-2b --dataset=libero \
  --steps=15000 --warmup_steps=1000 --mirror_prob=0.0 \
  --state_mlp_embodiments="{'single_arm_ee_euler': 8}" \
  --aug_random_crop=0.95 --aug_random_scale=True \
  --pin_overhead_camera=False --output_dir=runs/libero
Dim 8 ở đây là state format đã cấu hình cho run LIBERO, không phải chỉ dẫn rằng action cũng có 8 dimensions. mirror_prob=0.0 giữ cấu hình LIBERO của tác giả. Không bật mirroring tùy tiện: camera, gripper và action conventions phải có phép biến đổi tương ứng.
Theo recipe training, run LIBERO công bố sử dụng 8 H100, 15.000 steps và 40 GPU-hours. Con số 40 là tổng GPU-hours, không phải thời gian chạy trên một GPU consumer. Tài liệu khuyên GPU 80 GB cho các recipe; có run RoboTwin đạt khoảng 73 GB mỗi GPU. Giảm batch size để thử nghiệm sẽ thay đổi điều kiện tối ưu hóa, nên cần ghi rõ nếu so sánh kết quả.
Fine-tuning dùng flow-matching loss. Action expert và state MLP có learning rate 1e-4; backbone scale 0,3 trong cấu hình fine-tuning chung. Model dùng bf16, flow heads fp32, AdamW, gradient clipping 1,0 và EMA decay 0,999. Evaluation báo cáo dùng EMA weights.
Mỗi training sample gồm ba frames cách nhau một giây, và cả ba action chunks đều nhận loss. Tám noise/time draws mỗi frame chia sẻ VLM pass. Nhờ vậy registers của frame trước nhận gradient từ loss của frame sau, thay vì chỉ là một cache được thêm lúc inference.
Theo dõi metrics.jsonl: loss, gradient norm, thời gian load data và peak GPU memory. Loss giảm chưa đủ chứng minh robot hoàn thành task. Hãy đánh giá checkpoint bằng rollout; nếu dùng --resume=True, giữ output directory đúng run để tiếp tục checkpoint phù hợp.
8. Export và chạy protocol đánh giá đầy đủ
Export giúp đóng gói EMA weights, inference spec và normalization statistics, để inference không còn phụ thuộc toàn bộ training dataset:
pixi run python scripts/export_checkpoint.py \
  runs/libero/checkpoint-15000 exports/libero \
  --merge-ema --pretrained-path kyutai/reki-2b --benchmark libero
Nếu chỉ muốn đánh giá bản phát hành, không cần huấn luyện trước. Dùng protocol generator của repository:
pixi run hf download kyutai/reki-2b-libero \
  --local-dir checkpoints/reki-2b-libero
pixi run python launchers/eval_protocols.py \
  libero checkpoints/reki-2b-libero results/reki-full | bash
pixi run python scripts/eval/results_table.py results/reki-full
Generator in các lệnh benchmark để shell chạy tuần tự; bạn có thể bỏ | bash để xem trước. Với checkpoint tự train, thay đường dẫn checkpoint bằng exports/libero. Không dùng results_table.py để đọc eval_info.json của LeRobot: hai đường đánh giá có định dạng kết quả khác nhau.
Muốn chạy LIBERO-Plus, cài bash scripts/eval/install.sh libero_plus, rồi dùng benchmark libero_plus trong protocol generator. Nó đánh giá khả năng chịu perturbations của model đã fine-tune trên LIBERO, không đòi bạn huấn luyện thêm một checkpoint LIBERO-Plus.
9. Kết quả: memory cải thiện điều gì?
Theo model card LIBERO chính thức, một checkpoint dùng chung cho bốn suites đạt:
| Suite | Success rate |
|---|---|
| Spatial | 99,2% |
| Object | 99,4% |
| Goal | 96,6% |
| Long | 95,0% |
| Trung bình | 97,6% |
Protocol là 10 tasks mỗi suite, 50 episodes mỗi task, tổng 2.000 episodes. LIBERO-Plus đạt 90,4% trên 10.030 perturbed episodes. Trong các trục perturbation, robot initialization đạt 75,6%, còn sensor noise đạt 98,6%. Chênh lệch này cho thấy cần xem từng điều kiện, thay vì chỉ nhìn một điểm tổng hợp.
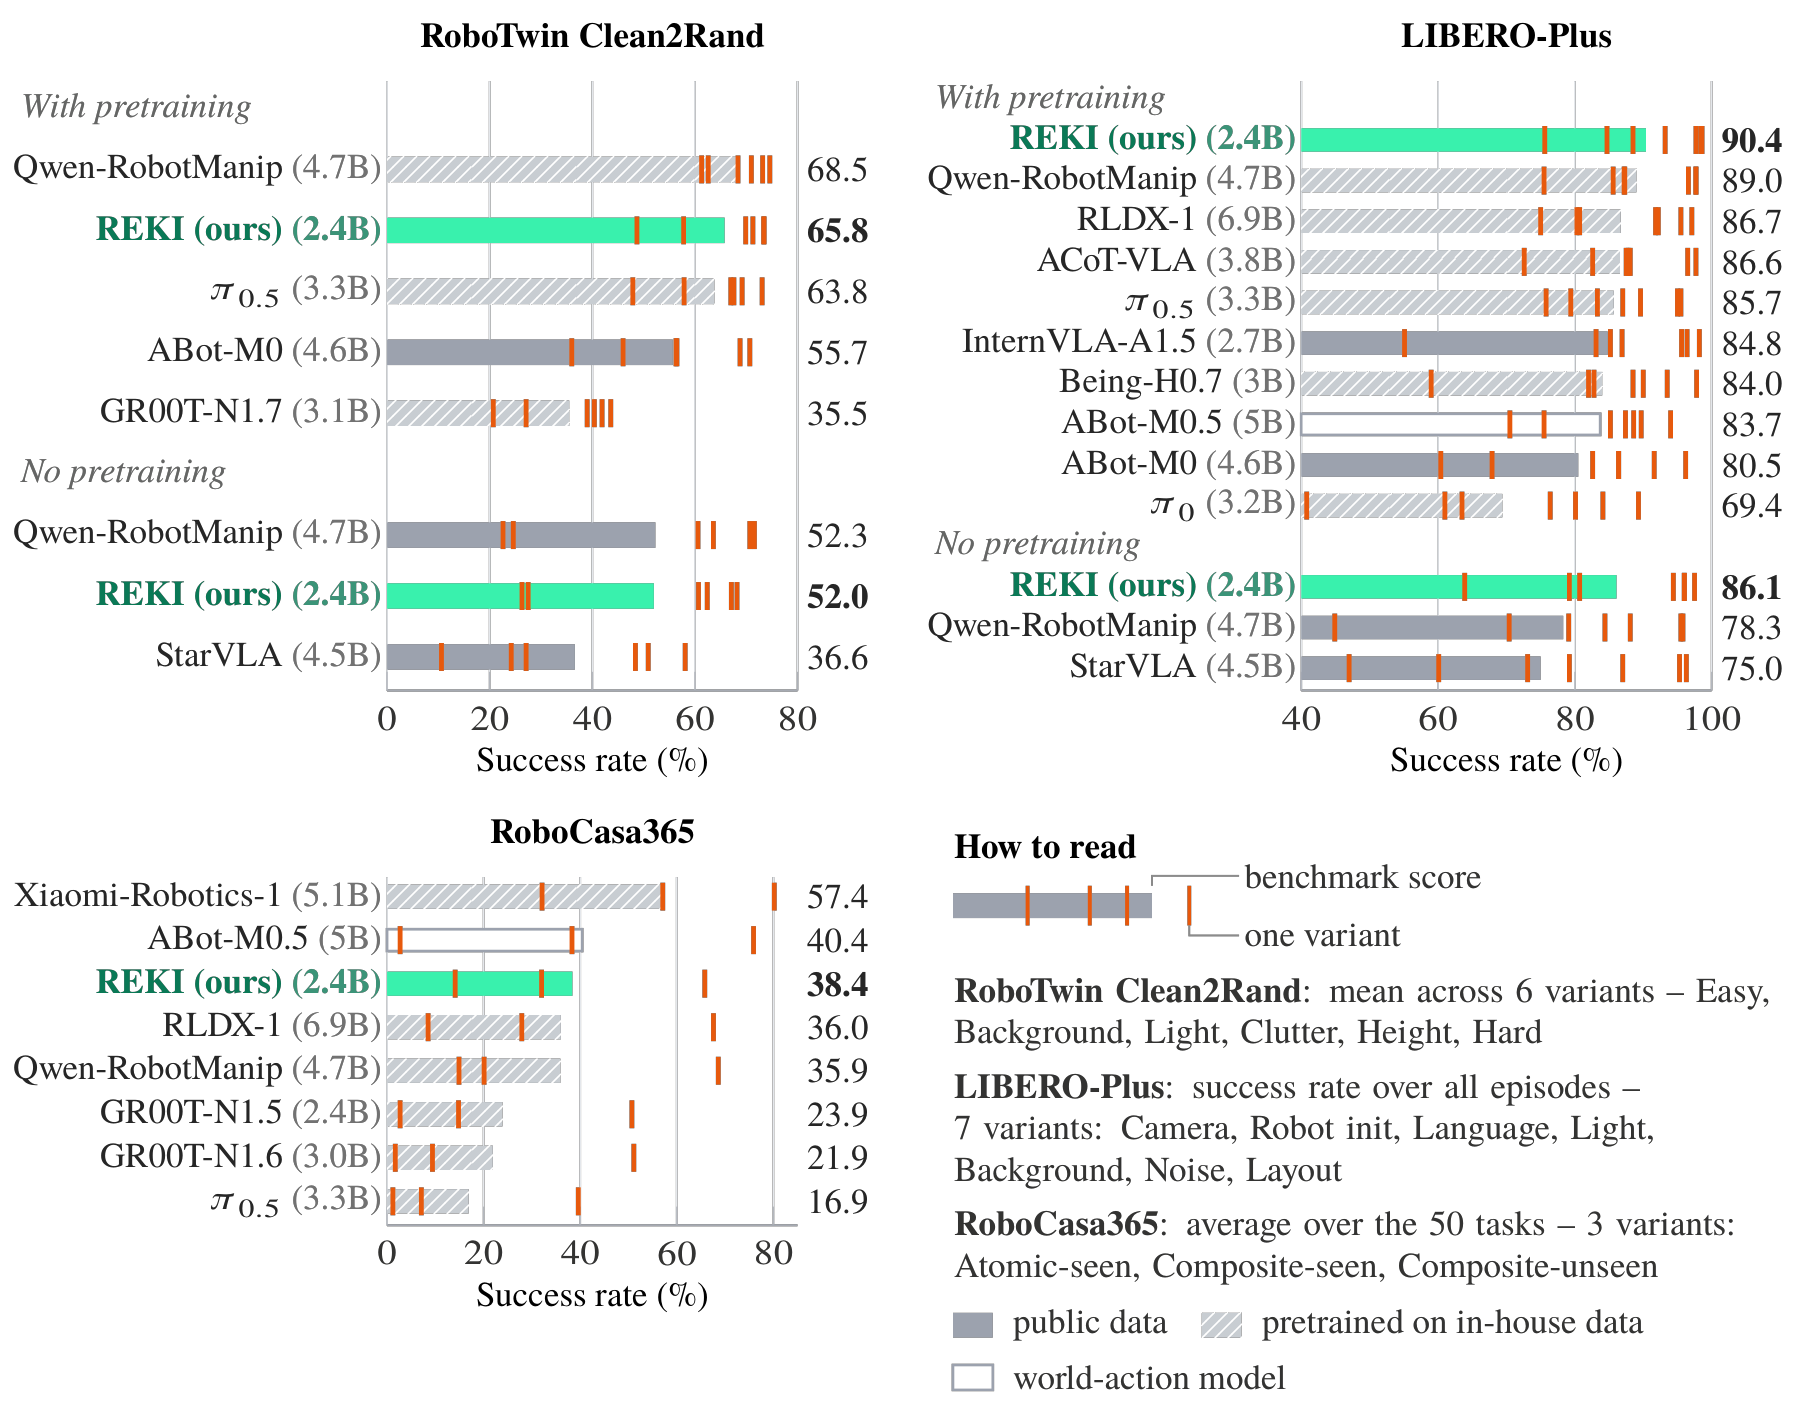
Ở phần ablation của paper, memory tăng 1,5 điểm phần trăm trên LIBERO-Plus, 5,5 trên RoboTwin clean và 5,4 trên RoboCasa365. “Điểm phần trăm” khác tăng tương đối: từ 88,9% lên 90,4% là cộng 1,5 điểm, không phải nhân với 1,015.
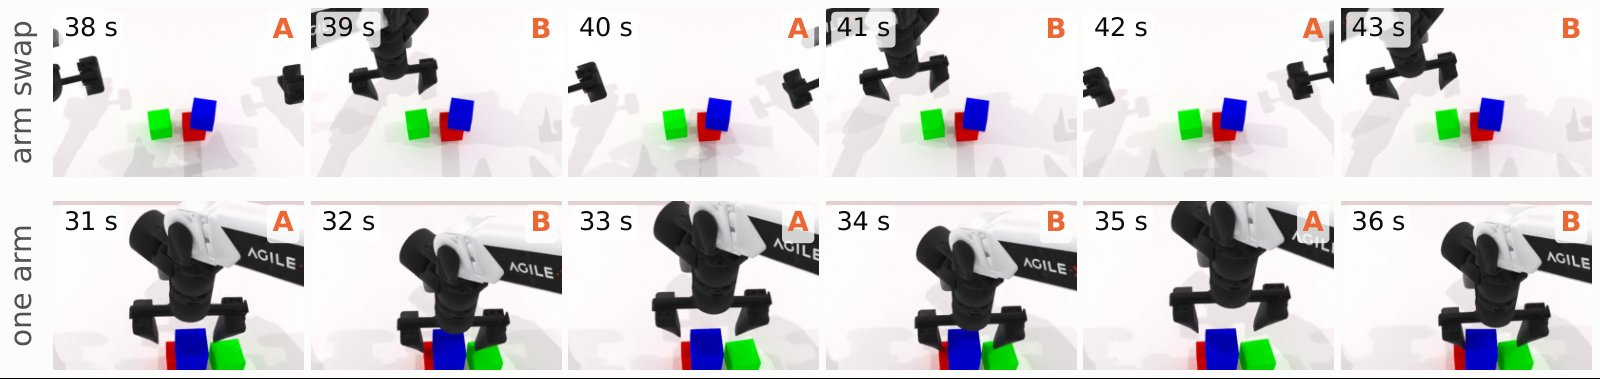
Hiện tượng oscillation được đo trên RoboTwin Clean giảm từ 18,6% episodes ở model train không memory xuống 4,1% với memory. Đây không phải số oscillation của LIBERO. Paper còn kiểm tra cùng weights nhưng bỏ past frames lúc evaluation: tỷ lệ tăng lên 14,8%. Điều đó hỗ trợ nhận định policy thực sự sử dụng lịch sử khi chạy.
Về tốc độ, 21,8 ms là latency cho một action chunk trên H100, với hai ảnh 256×256 và compilation; không phải chu kỳ điều khiển robot được chứng minh an toàn ở 46 Hz. Model vẫn được đánh giá với replanning stride một giây. Thời gian inference ngắn và nhịp thu thập lịch sử là hai tham số khác nhau.
10. Demo thật, lỗi thường gặp và giới hạn
Project page có demo UR5 sau fine-tuning trên dữ liệu robot thật. Video dưới được tác giả trình bày ở tốc độ 3×; nó minh họa ứng dụng REKI, không chứng minh checkpoint Franka/LIBERO có thể điều khiển UR5 trực tiếp.
Khi rollout thất bại, kiểm tra theo thứ tự từ dữ liệu đến model. Nếu robot luôn tiếp cận sai phía, xem chiều ảnh và camera mapping. Nếu chuyển động sai biên độ hoặc gripper ngược, kiểm tra normalization, action convention và state layout. Nếu task đầu ổn nhưng task sau bất thường, kiểm tra reset(). Nếu chỉ benchmark đổi mạnh sau nâng cấp môi trường, đối chiếu MuJoCo và lockfile trước khi sửa weights.
OOM trong training không có nghĩa inference cũng cần cùng lượng VRAM. Training giữ activations, gradients và optimizer states; inference có profile khác. Ngược lại, “model 2.4B” cũng không đủ để suy ra mọi GPU 8 GB đều chạy được compilation với mọi resolution. Đo peak memory và latency trên máy đích trước khi lên ngân sách triển khai.
REKI có memory ngắn và vẫn phụ thuộc demonstration distribution. Chưa có cơ sở để suy ra nó nhớ được sự kiện cách hàng chục phút, tự lập kế hoạch mọi nhiệm vụ dài, hoặc bảo đảm an toàn robot thật. Code dùng MIT với một số thành phần Apache-2.0, nhưng weights có giấy phép CC-BY-NC-SA 4.0; sử dụng thương mại phải đối chiếu điều khoản weights và dữ liệu nguồn.
Một lần thực hành tốt kết thúc bằng ba bằng chứng: log cài đặt rõ version, rollout có camera và action đúng convention, bảng success rate ghi đúng task và số episodes. Sau đó bạn mới có nền chắc để so sánh memory, thay recipe hoặc chuyển sang dữ liệu robot của mình.