Vì sao robot cần nhìn khác một chatbot?
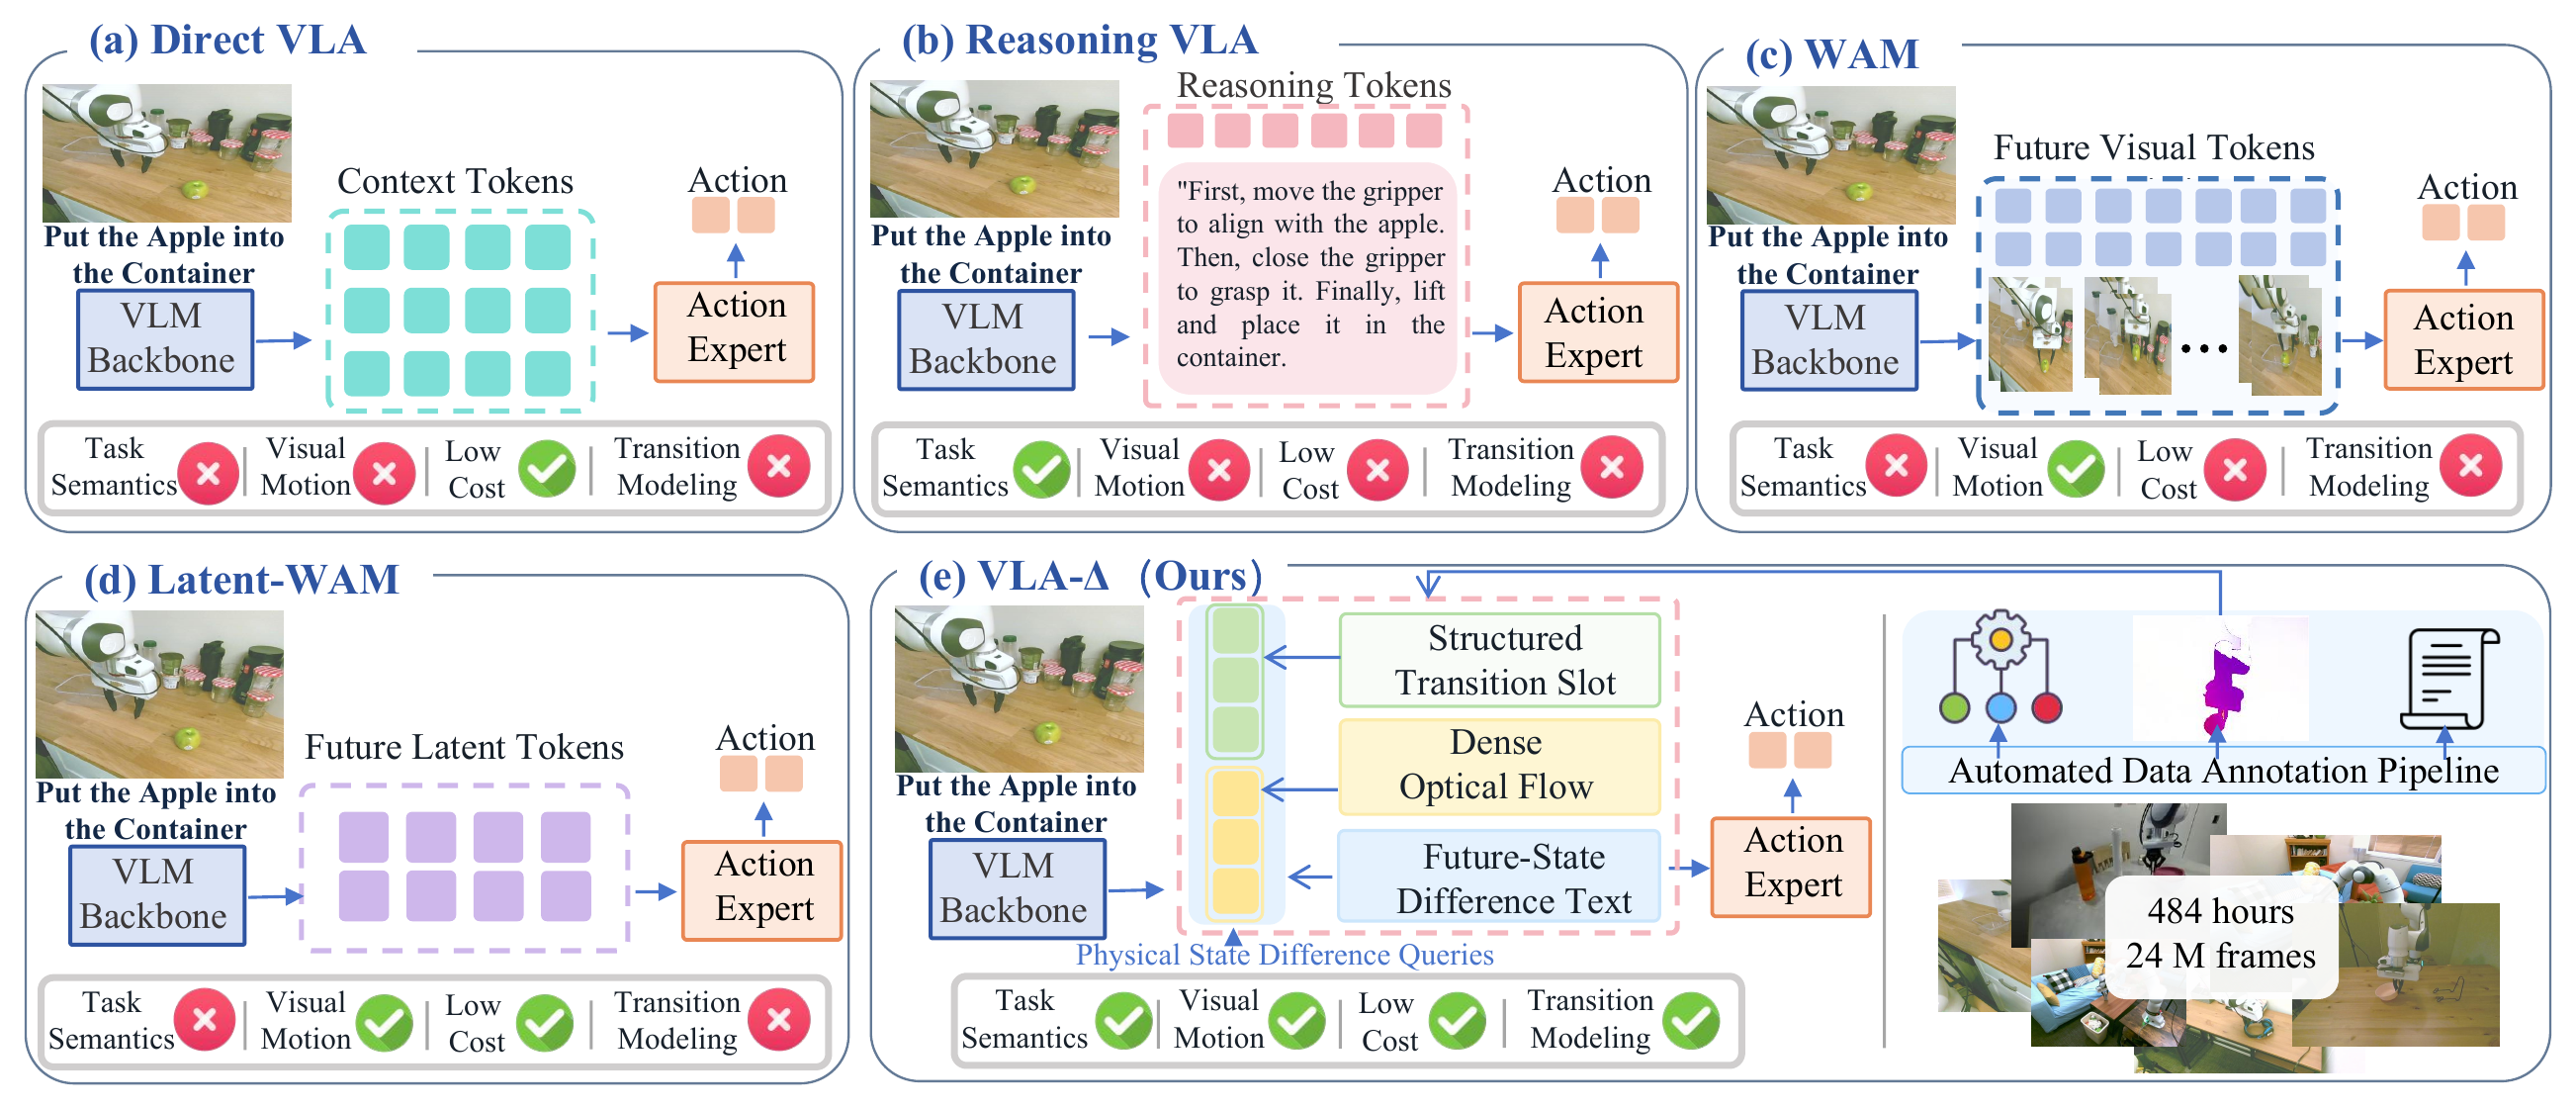
Một chatbot có thể mô tả đúng rằng trên bàn có chiếc cốc nhưng vẫn không cung cấp đủ thông tin để robot đưa ngón kẹp vào đúng vị trí. Thao tác đòi hỏi ranh giới vật thể, thay đổi trạng thái nhỏ và quan hệ hình học rất cụ thể. Khi hình ảnh đã đi qua một vision encoder riêng rồi được nén thành biểu diễn ngữ nghĩa, action policy có thể khó tiếp cận những tín hiệu này.
NEO-VLA trong paper From Pixels to Actions—Towards Native Vision-Language-Action Policies, của Weichen Fan và cộng sự, đặt lại câu hỏi: action expert có nên chỉ nhận đầu ra cuối của perception, hay được đọc quá trình tính toán thị giác ở nhiều độ sâu? Paper xuất hiện ngày 4/11/2026; bài này đối chiếu bản v3 cập nhật ngày 9/11 và VLAKit chính thức tại thời điểm 10/11/2026.
Mục tiêu thực hành là khởi động checkpoint phát hành, nối policy service với LIBERO, chạy một phép thử nhỏ rồi mở rộng đánh giá. Đây là hướng dẫn dựa trên mã và tài liệu upstream; các điểm benchmark bên dưới là kết quả tác giả báo cáo, không phải kết quả chúng tôi vừa chạy lại. Nếu chưa quen chuỗi ảnh–ngôn ngữ–hành động, hãy đọc giải thích kiến trúc OpenVLA trước.
Encoder-free thực sự nghĩa là gì?
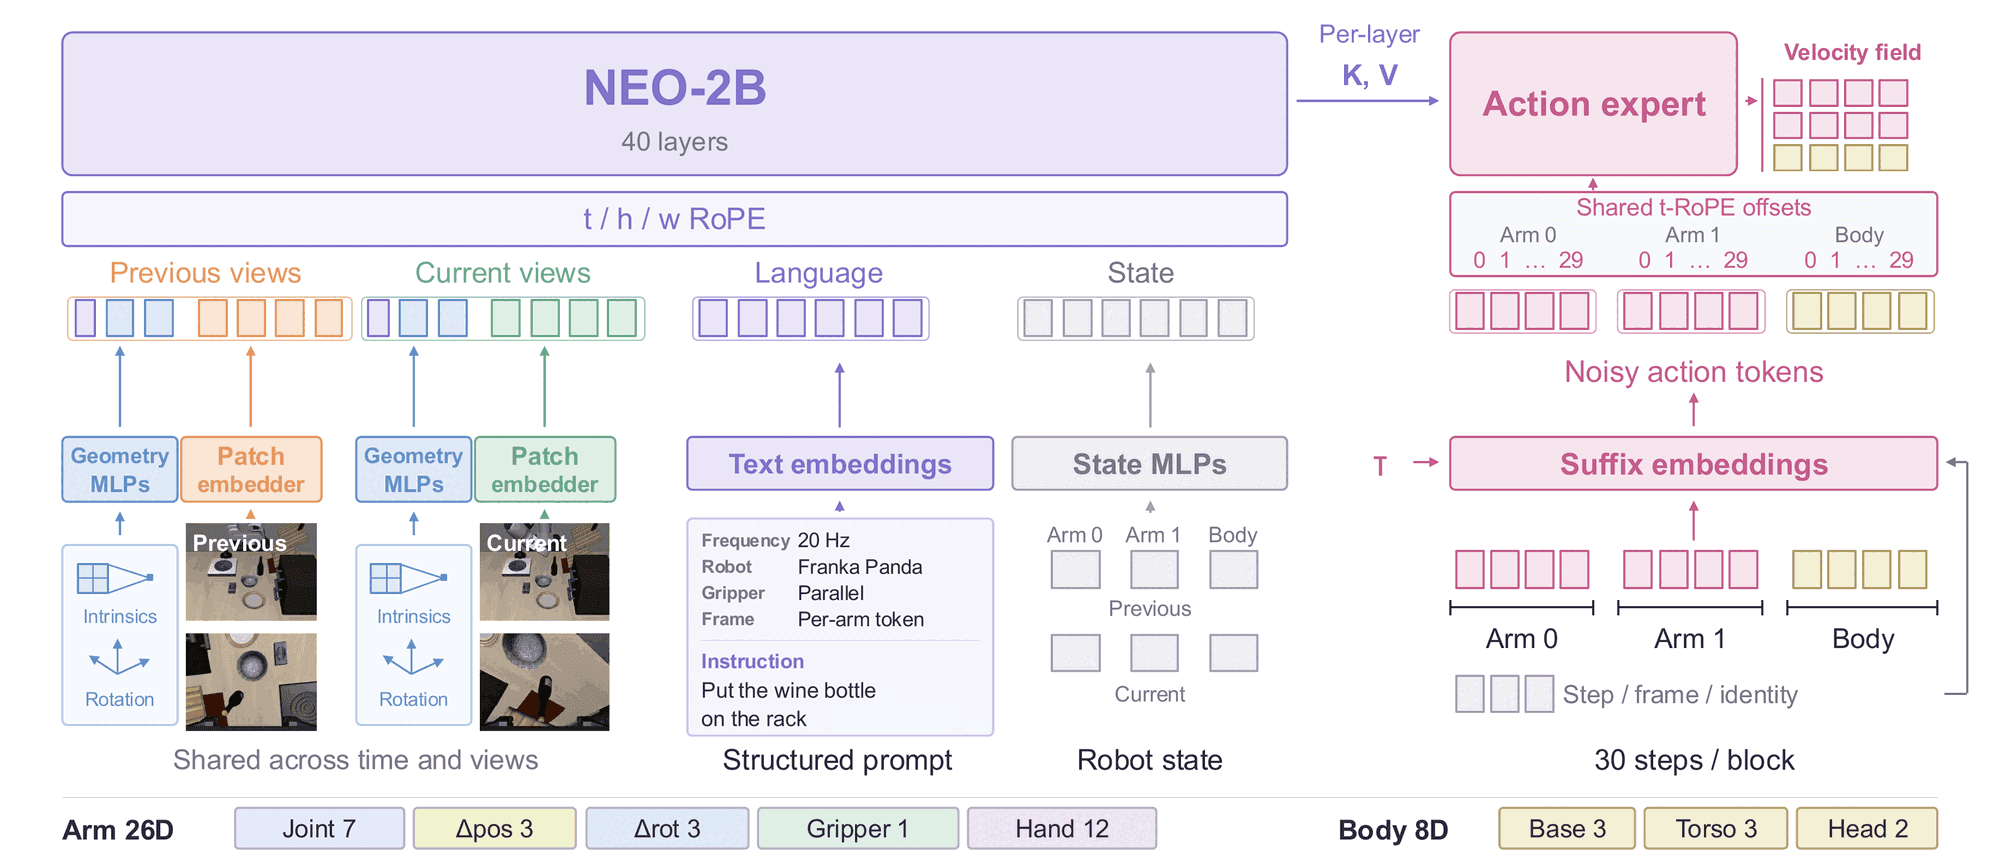
NEO-VLA vẫn có phép biến đổi ảnh thành token. Điểm khác là nó không gắn một vision transformer được huấn luyện riêng vào trước language backbone. Một patch embedder gồm hai tầng convolution, tổng stride 32, đưa từng vùng ảnh tương ứng 32 × 32 pixel vào không gian token. Từ đó, visual token và language token cùng được xử lý trong backbone NEO-2B gồm 40 tầng.
Ảnh được giữ tỷ lệ khung hình và điều chỉnh theo ngân sách tối đa 88 visual token mỗi view. Native Rotary Position Embedding tách vị trí theo thời gian, chiều cao và chiều rộng. Text dùng causal attention, còn các token thuộc cùng một khối ảnh có thể attention hai chiều. Như vậy, đặc trưng ảnh tiếp tục thay đổi theo instruction trong backbone thay vì kết thúc tại một đầu ra encoder cố định.
Prefix chứa quan sát trước và hiện tại, tối đa ba camera mỗi thời điểm, camera intrinsics và rotations, instruction có cấu trúc, cùng proprioception. Các thành phần không có trên robot được mask; giá trị chưa đo được không được tự ý điền thành số không. Một robot một tay vẫn dùng được giao diện chung mà không cần giả vờ có tay thứ hai.
Ảnh trước + ảnh hiện tại ── patch convolution ──┐
Camera geometry + instruction + robot state ───┤
                                               v
                                  Backbone NEO-2B, 40 tầng
                                               |
                                   KV cache từ nhiều tầng
                                               v
                                  Flow-matching action expert
                                               |
                               Action chunk → controller/simulator
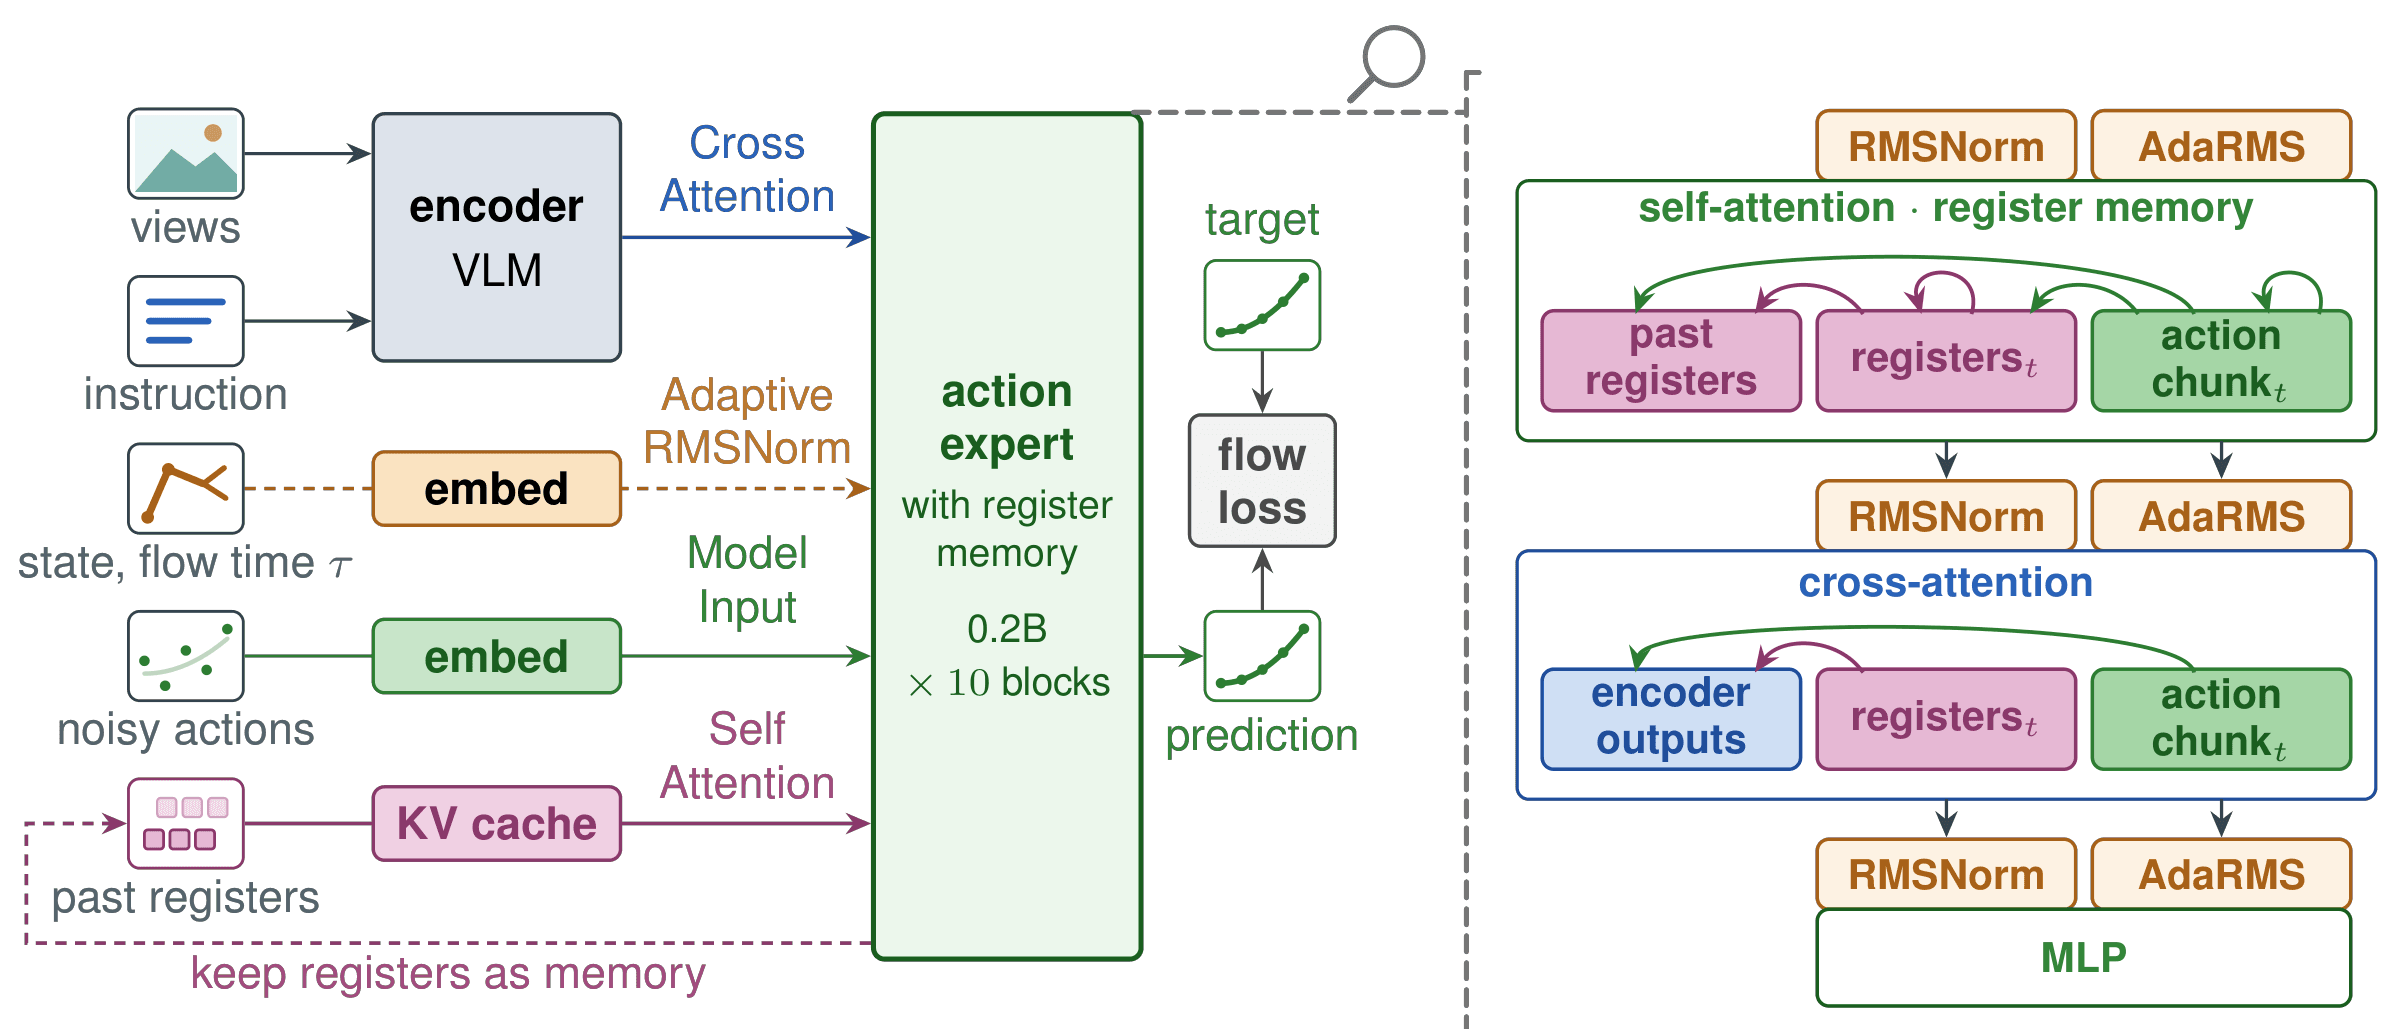
Action expert là mạng riêng, hẹp hơn, khởi tạo ngẫu nhiên. Mỗi tầng expert đọc key/value cache ở một tầng backbone đã chọn, đồng thời attention vào action token của chính nó. Cấu hình skip28 lấy 28 tầng trải trên backbone 40 tầng. Đây không phải việc chỉ lấy embedding ở tầng cuối rồi nối một MLP.
Từ flow matching đến action chunk
Trong training, expert nhận action đã trộn với noise cùng flow time, rồi học vector field để biến noise thành trajectory hợp lệ. Trong inference, solver tích phân vector field qua nhiều bước để sinh action liên tục. Cách làm này tránh việc phải biểu diễn mỗi tọa độ điều khiển thành một từ trong vocabulary ngôn ngữ.
Giao diện tổng quát dự đoán 30 bước cho hai arm slot, mỗi arm có 26 chiều, và một body block 8 chiều. Các chiều tay bao gồm joint target, translation increment, rotation increment, gripper và hand joint. Tuy nhiên, LIBERO chỉ dùng một tay và thực thi bảy chiều: ba dịch chuyển end-effector, ba rotation increment và gripper. Không đưa nguyên tensor 26 chiều vào simulator.
Cần phân biệt prediction horizon với executed horizon. Model có thể sinh 30 bước, nhưng protocol LIBERO phát hành thực thi 16 bước trước lần gọi policy tiếp theo. Tại control rate 20 Hz trong eval.json, 16 bước tương đương 0,8 giây mô phỏng; đó không phải độ trễ inference hay tốc độ gọi model 20 lần mỗi giây. Nếu muốn hiểu sâu hơn quá trình sampling, xem flow matching và cắt ngắn quá trình sinh action.
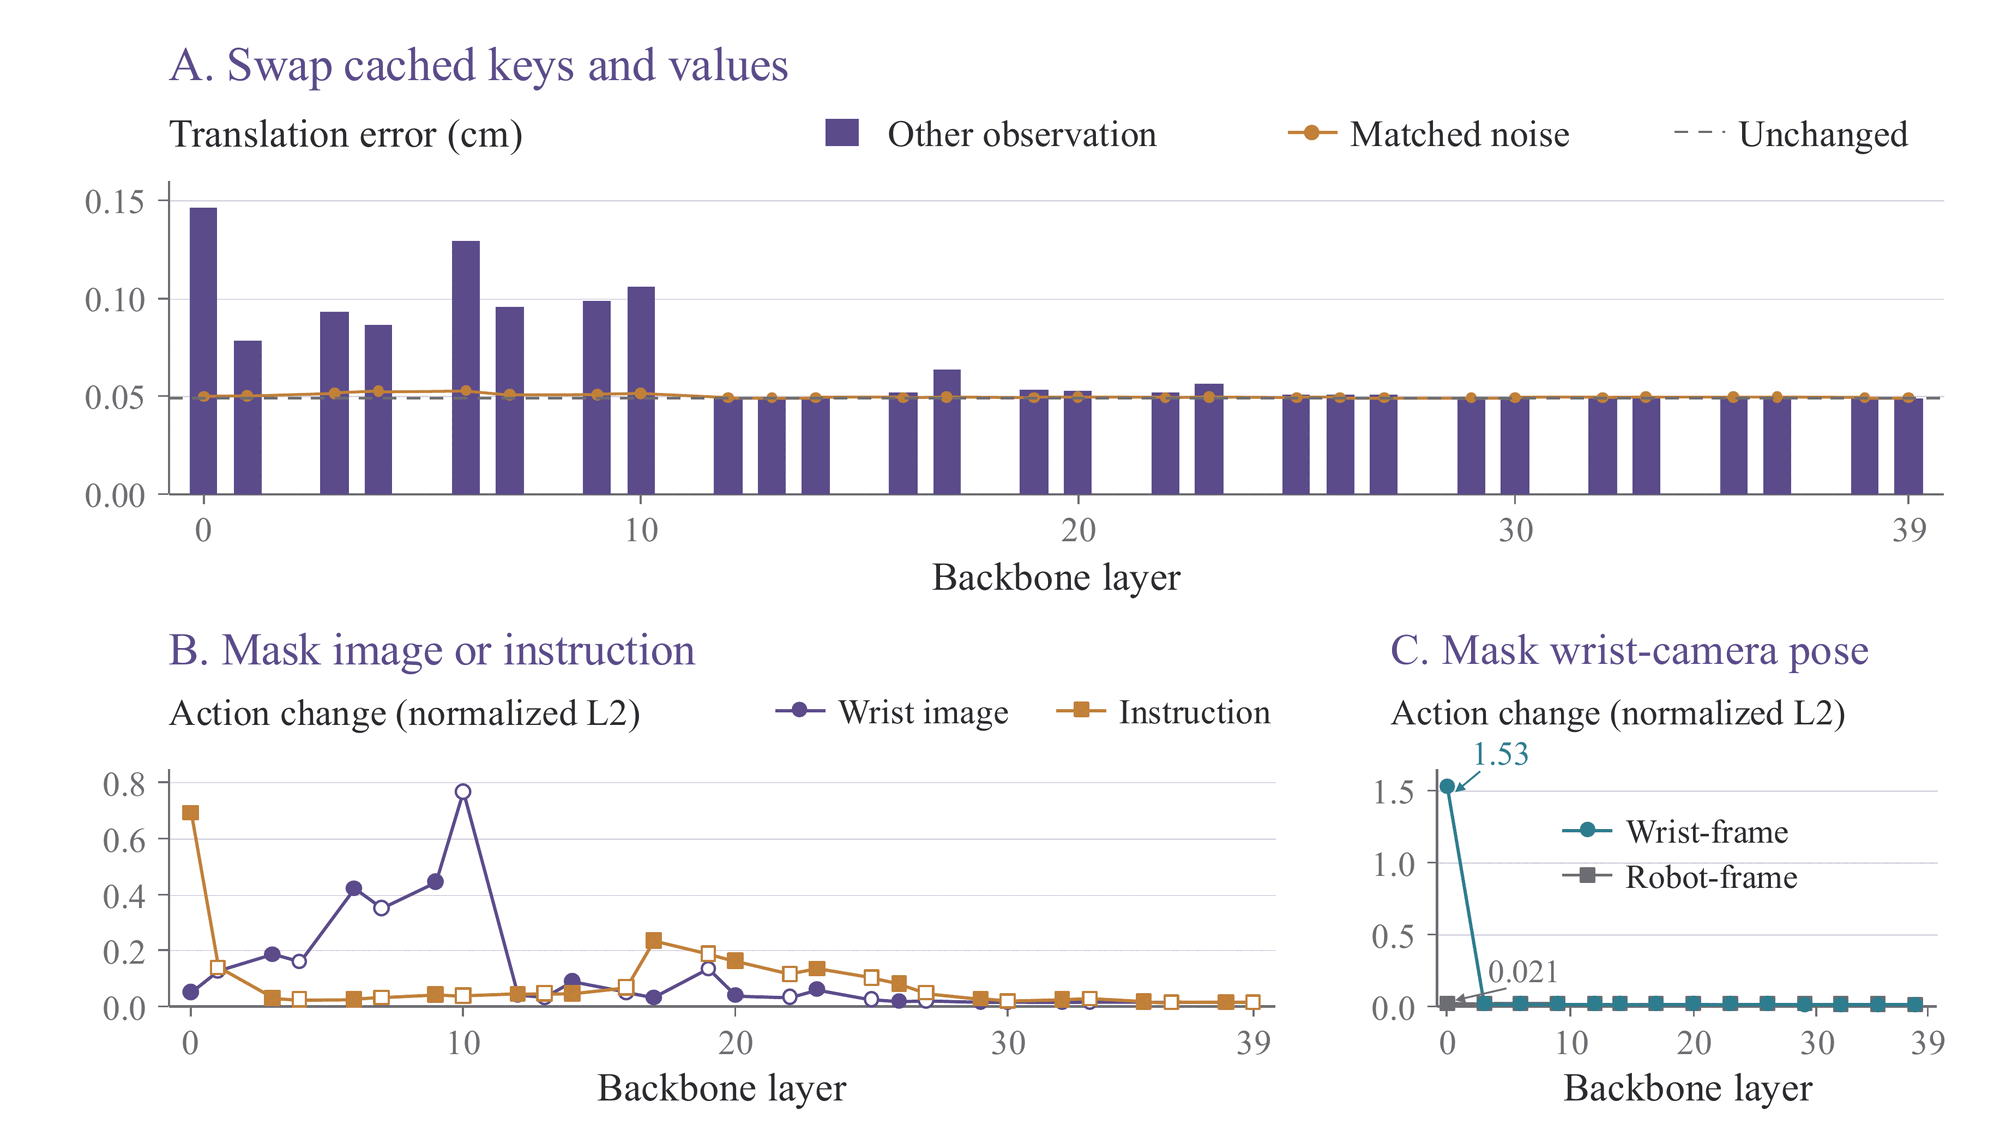
Nguồn: phân tích layer trên project page. Các thí nghiệm chỉ ra tín hiệu quan trọng cho action xuất hiện sớm, với độ nhạy khác nhau theo loại thông tin; không nên suy ra rằng bỏ toàn bộ tầng cuối luôn tốt hơn.
Bước 1: chuẩn bị workspace và môi trường policy
Dùng Linux, Conda và GPU NVIDIA với CUDA hoạt động. Upstream yêu cầu Python từ 3.10, PyTorch từ 2.6 và Transformers từ 4.50. Paper đo inference trên RTX 3090 24 GB; đây là cấu hình tham khảo, không phải cam kết mọi GPU ít VRAM hơn đều chạy được. Cần chừa dung lượng cho cả policy checkpoint và backbone: riêng stage_libero/state.pt hiện khoảng 12,6 GB.
Các lệnh sau tải source archive, không cần thao tác Git. Dùng workspace mới; biến NEO_WORK là thư mục thực hành của bạn, không phải đường dẫn mặc định của dự án vnrobo.
mkdir -p "$HOME/neo-vla-lab"
export NEO_WORK="$HOME/neo-vla-lab"
cd "$NEO_WORK"
curl -fL https://github.com/EvolvingLMMs-Lab/NEO/archive/refs/heads/main.tar.gz \
  | tar -xz

conda create -n neo-policy python=3.10 -y
conda activate neo-policy
cd "$NEO_WORK/NEO-main/VLAKit"
python -m pip install --upgrade pip
# Ví dụ wheel CUDA 12.4; driver phải tương thích.
python -m pip install torch==2.6.0 torchvision==0.21.0 \
  --index-url https://download.pytorch.org/whl/cu124
python -m pip install -e . huggingface_hub
python -c 'import torch; print(torch.__version__, torch.cuda.is_available())'
Nếu dòng cuối trả False, giải quyết driver và PyTorch trước khi tải model. Không sửa recipe để ép CPU rồi coi đó là cùng cấu hình benchmark. Gói .[prep] chỉ cần khi chạy bộ lọc dữ liệu camera; inference LIBERO không yêu cầu cài phần này.
Bước 2: tải đúng checkpoint và giữ metadata đi kèm
Model card phát hành phân biệt policy checkpoint native với backbone Hugging Face. stage_libero là policy đã fine-tune cho simulation; stage2_backbone chứa config, tokenizer, modeling code và backbone weights. Chỉ tải hai thư mục cần thiết cho bài thực hành:
python - <<'PY'
import os
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="weepiess2383/NEO-VLA",
    allow_patterns=["stage_libero/*", "stage2_backbone/*"],
    local_dir=os.path.join(os.environ["NEO_WORK"], "checkpoints"),
)
PY
export NEO_VLA_BACKBONE="$NEO_WORK/checkpoints/stage2_backbone"
export NEO_LIBERO_CKPT="$NEO_WORK/checkpoints/stage_libero"
ls "$NEO_LIBERO_CKPT"
Thư mục policy phải có state.pt, meta.json, embodiments.json và eval.json. Normalizer không phải file phụ có thể thay tùy ý: nó quyết định diễn giải action, mask và embodiment. Policy native này không phải thư mục có thể tải trực tiếp bằng AutoModel.from_pretrained.
Một giới hạn đáng chú ý: model card nói backbone NEOpp-2B-SFT ban đầu chưa phát hành. stage2_backbone được trích từ policy sau joint training, nên không phải bản thay thế tương đương để tái lập pretraining từ đầu. Với inference, hãy dùng cặp artifact được hướng dẫn trong benchmark guide; với training, phải ghi rõ điểm khởi tạo thực tế.
Bước 3: khởi động inference service
Trong terminal policy, sinh config từ protocol của checkpoint thay vì viết camera mapping bằng tay:
cd "$NEO_WORK/NEO-main/VLAKit"
python -m neo_vla.bench.spec \
  --checkpoint "$NEO_LIBERO_CKPT" --device cuda \
  > "$NEO_WORK/server.json"
neo-vla-serve --config "$NEO_WORK/server.json" \
  --host 127.0.0.1 --port 8000
Giữ terminal này mở. Ở terminal khác, kiểm tra:
curl -f http://127.0.0.1:8000/health
curl -f http://127.0.0.1:8000/metadata
Health trả thành công chỉ chứng minh service đã khởi động, chưa chứng minh policy giải được task. Service xử lý một prediction tại một thời điểm. Khi đánh giá, bắt đầu với một simulator client để dễ phân biệt lỗi model, lỗi rendering và lỗi HTTP.
Bước 4: cài LIBERO trong môi trường riêng
Benchmark guide của VLAKit pin mujoco==3.2.3, robosuite==1.4.1, numpy==2.2.6. Không cài nguyên requirements cũ của LIBERO vì chúng pin các phiên bản khác. Tách môi trường cũng tránh kéo dependency của training policy vào simulator.
Ở terminal thứ hai, khai báo lại đường dẫn vì biến môi trường không tự lan giữa các terminal:
export NEO_WORK="$HOME/neo-vla-lab"
export NEO_LIBERO_CKPT="$NEO_WORK/checkpoints/stage_libero"
cd "$NEO_WORK"
curl -fL https://github.com/Lifelong-Robot-Learning/LIBERO/archive/refs/heads/master.tar.gz \
  | tar -xz
conda create -n neo-libero python=3.10 -y
conda activate neo-libero
python -m pip install --upgrade pip
python -m pip install numpy==2.2.6 mujoco==3.2.3 robosuite==1.4.1 \
  bddl==1.0.1 easydict pyyaml cloudpickle gym==0.25.2
python -m pip install --no-deps -e "$NEO_WORK/LIBERO-master"
# Chỉ cài phần package để client import được; không tải torch vào môi trường này.
python -m pip install --no-deps -e "$NEO_WORK/NEO-main/VLAKit"
export MUJOCO_GL=egl
export LIBERO_CONFIG_PATH="$NEO_WORK/libero-config"
Đây là tập dependency khởi đầu cho đường evaluation, không phải lockfile đã được kiểm thử trên mọi hệ điều hành. Nếu import báo thiếu dependency phụ, đối chiếu lỗi với hướng dẫn upstream và giữ nguyên ba pin benchmark quan trọng. Trên máy không có EGL phù hợp, upstream cho phép MUJOCO_GL=osmesa; cần cài thư viện Mesa tương ứng ở hệ điều hành.
LIBERO đọc config.yaml để tìm BDDL, initial states và assets. Chuẩn bị trước để không bị dừng ở câu hỏi tương tác trong lần import đầu:
python - <<'PY'
import os
from pathlib import Path
import yaml

work = Path(os.environ["NEO_WORK"])
root = work / "LIBERO-master" / "libero" / "libero"
config = Path(os.environ["LIBERO_CONFIG_PATH"])
config.mkdir(parents=True, exist_ok=True)
paths = {
    "benchmark_root": str(root),
    "bddl_files": str(root / "bddl_files"),
    "init_states": str(root / "init_files"),
    "datasets": str(work / "LIBERO-master" / "libero" / "datasets"),
    "assets": str(root / "assets"),
}
(config / "config.yaml").write_text(yaml.safe_dump(paths))
from libero.libero.envs import OffScreenRenderEnv
print("LIBERO import OK")
PY
Muốn rollout checkpoint có sẵn, bạn cần task definitions, initial states và assets; không cần tải toàn bộ demonstration dataset để training. Nếu source archive thay đổi cấu trúc, kiểm tra lại các đường dẫn trên trước khi chạy.
Bước 5: smoke test rồi mới chạy đủ bộ
Chạy một task của Spatial với một episode trước:
python -m neo_vla.bench.libero --benchmark libero \
  --checkpoint "$NEO_LIBERO_CKPT" \
  --server http://127.0.0.1:8000 \
  --libero-root "$NEO_WORK/LIBERO-master" \
  --suites libero_spatial --tasks 0 --episodes 1 \
  --out "$NEO_WORK/results/smoke"
Một episode thành công hay thất bại đều không đủ để kết luận chất lượng model. Smoke test chỉ kiểm tra đường đi hoàn chỉnh: simulator render ảnh, client tạo observation, server sinh action, simulator thực thi và lưu kết quả. Khi đường đi này ổn, dùng output directory mới cho full run:
python -m neo_vla.bench.libero --benchmark libero \
  --checkpoint "$NEO_LIBERO_CKPT" \
  --server http://127.0.0.1:8000 \
  --libero-root "$NEO_WORK/LIBERO-master" \
  --out "$NEO_WORK/results/libero-full"
Default hiện tại là bốn suite, mỗi suite 10 task × 50 episode, tổng 2.000 episode. Mỗi episode có 10 bước giữ yên để scene ổn định; không tính vào budget task. Budget Spatial/Object/Goal/Long lần lượt là 220/280/300/520 bước.
Kết quả gồm settings.json, JSON từng task và summary.json. Client bỏ qua task đã có result file để resume. Vì vậy, tuyệt đối không trộn smoke run hoặc cấu hình mới vào cùng thư mục rồi tưởng rằng tất cả task đã được chạy lại. Lưu output riêng cho mỗi protocol và checkpoint.
Điều gì xảy ra giữa action model và simulator?
Checkpoint LIBERO trả action trong frame của wrist camera. Client đọc camera pose sống ở từng bước, đổi increment sang robot-base frame rồi chia theo unit factors của suite. Ảnh scene và wrist được render 256 × 256, đưa về đúng chiều theo protocol. Gripper model dùng quy ước 0 mở, 1 đóng, còn robosuite cần dấu điều khiển riêng.
Những phép đổi này giải thích vì sao policy có thể load bình thường nhưng robot vẫn đi sai hướng nếu tự viết adapter thiếu geometry. Dùng client chính thức trước; chỉ sửa adapter khi đã hiểu frame, đơn vị centimetre/radian và thứ tự action columns. Với các benchmark biến thể, hướng dẫn LIBERO-PRO và policy planning cung cấp thêm bối cảnh về đánh giá ngoài phân phối.
Training: ba giai đoạn và phần chưa thể tái lập trọn vẹn
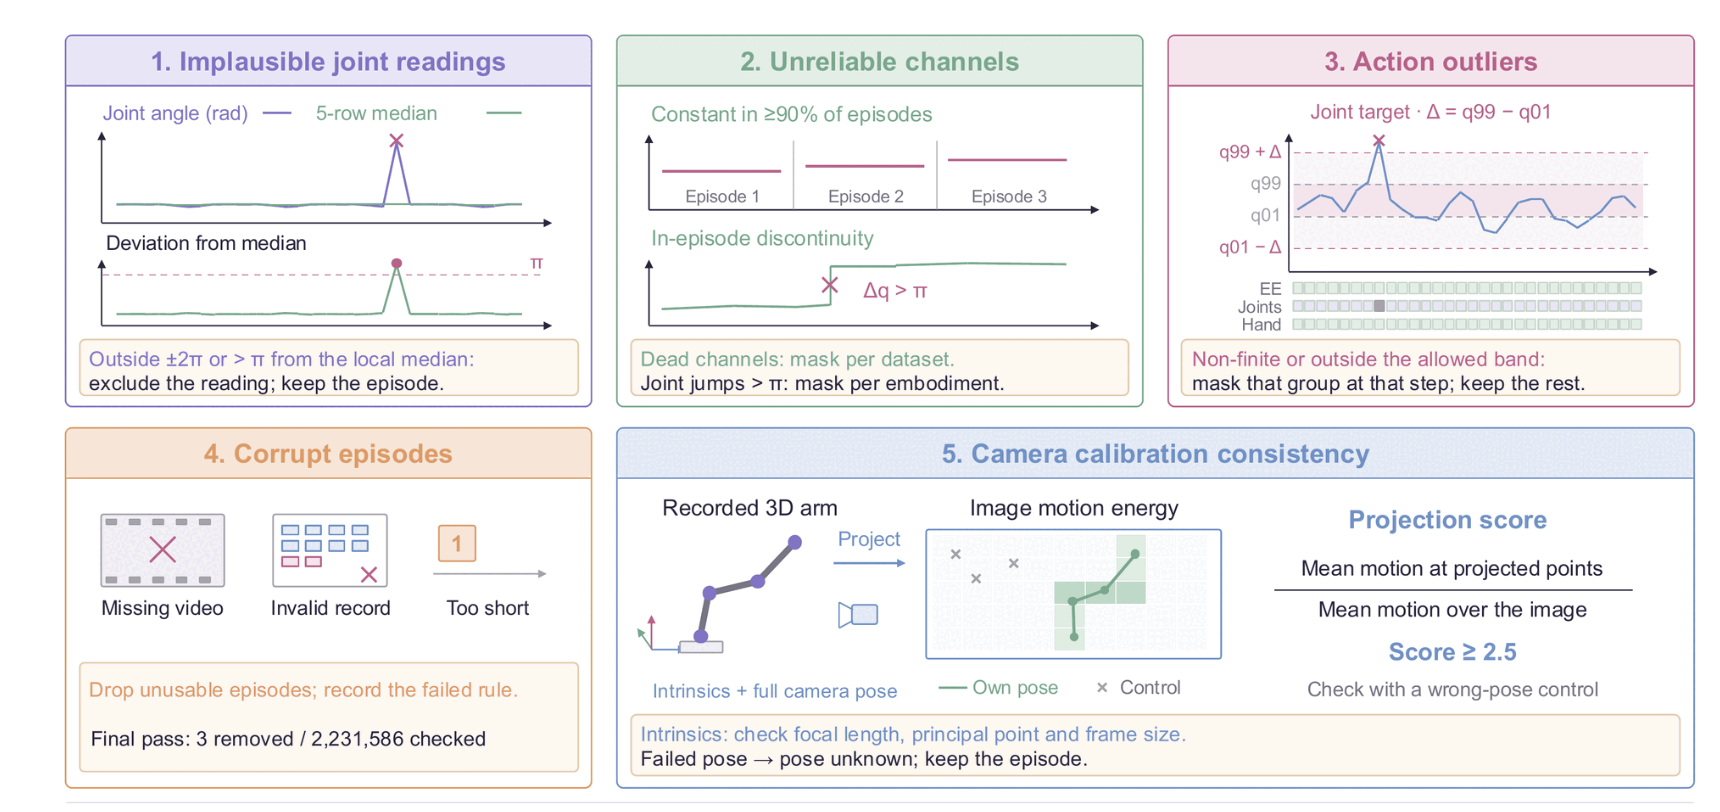
Nguồn: training guide. Corpus tổng hợp được mô tả có 2.231.583 episode, khoảng 928,4 triệu row từ chín họ dataset. Quy mô này là lý do người mới nên bắt đầu bằng inference.
| Giai đoạn | Thành phần học | Recipe công bố trong code |
|---|---|---|
| Stage 1 | Action expert và prefix tokenizers, backbone đóng băng | 113.400 step, global batch 8.192, learning rate 2e-4 |
| Stage 2 | Toàn policy, robot data cùng understanding data | 75.000 step, expert 2e-4, backbone 5e-5 |
| Robot adaptation | Fine-tune toàn policy trên corpus tương thích | Mặc định 30.000 step, global batch 128 |
Các launcher Stage 1/2 có reference shape 16 node × 8 GPU. Đổi GPUS_PER_NODE=1 không biến recipe này thành bài tập rẻ trên laptop: global batch vẫn rất lớn và gradient accumulation phải chia hết theo world size. Trước khi chạy, xem command expansion:
# Thực hiện trong neo-policy, từ NEO-main/VLAKit.
# Các đường dẫn /data bên dưới phải trỏ tới corpus đã chuẩn bị thật.
export NEO_VLA_DATA_ROOT=/data/robot-corpus
export NEO_VLA_OUTPUT_ROOT=/data/neo-runs
bash scripts/stage1.sh --print-argv
Đây chỉ là xem cấu hình, không phải lệnh tái lập training hoàn chỉnh. Stage 1 yêu cầu backbone khởi tạo đúng và corpus có manifest, prompt cache, normalizer. Repo nói dataset pretraining đang upload tăng dần và chưa đầy đủ; các converter theo nguồn, manifest/cache/normalizer builder không được cung cấp trọn bộ. Không có một lệnh download demonstration LIBERO rồi chạy train_libero.sh được tài liệu hóa trong hướng dẫn phát hành này.
Nếu tiếp tục nghiên cứu adaptation, model card cho phép dùng trainer.init_from trỏ tới stage2. Cần tải thêm artifact đó, chuẩn bị schema-3 manifest, embodiments.json đúng định dạng và processed corpus, rồi cấu hình embodiment, tokenizer identifier, frame reference và control rate nhất quán. posttrain_real.sh là launcher adaptation dữ liệu robot thật, không phải pipeline LIBERO tự động.
Stages 2/3 dùng co-training understanding; ví dụ code chọn COCO ShareGPT, một chat row trên mỗi robot row với loss weight 0,1. Model card nhấn mạnh ví dụ này không tái tạo nguyên mixture understanding của run gốc. Paper báo action-only post-training làm RoboTwin Clean2Rand giảm mạnh so với co-training; vì vậy bỏ chat data là thay đổi giả thuyết huấn luyện, không chỉ là tiết kiệm ổ đĩa.
Đọc kết quả mà không nhầm protocol
Paper v3, Tables 2 và 7 trình bày hai nhóm kết quả khác nhau:
| Thiết lập | Spatial | Object | Goal | Long | Trung bình |
|---|---|---|---|---|---|
| Qwen3-VL-2B frozen, đối chiếu backbone | 71,4 | 89,8 | 92,8 | 64,0 | 79,5 |
| NEO-VLA frozen, đối chiếu backbone | 89,2 | 95,8 | 93,2 | 85,4 | 90,9 |
| NEO-VLA full FT, đối chiếu backbone | 95,6 | 97,8 | 96,0 | 92,0 | 95,3 |
| NEO-VLA, benchmark chính | 98,4 | 99,4 | 95,6 | 96,2 | 97,4 |
Nhóm đối chiếu backbone dùng final checkpoint 30.000 step và 500 episode mỗi suite. Benchmark chính báo checkpoint 27.500 step và 2.000 episode mỗi suite, khác default released runner là 500 mỗi suite. Không gắn nhãn output mặc định là tái lập chính xác 97,4%. Muốn đối chiếu, phải thống nhất checkpoint, số episode, simulator, camera, horizon và cách sampling initial states; chỉ đổi số episode chưa đủ.
NEO-VLA đạt 89,7% tổng trên LIBERO-plus nhưng chỉ 47,9% trung bình trong bảng LIBERO-PRO của paper. Các perturbation position và task goal vẫn khó. Đây là bằng chứng rằng robust perception chưa đồng nghĩa giải được mọi bố trí không gian mới. Cũng không thể quy toàn bộ lợi thế cho việc bỏ encoder, vì các backbone còn khác pretraining và capacity.
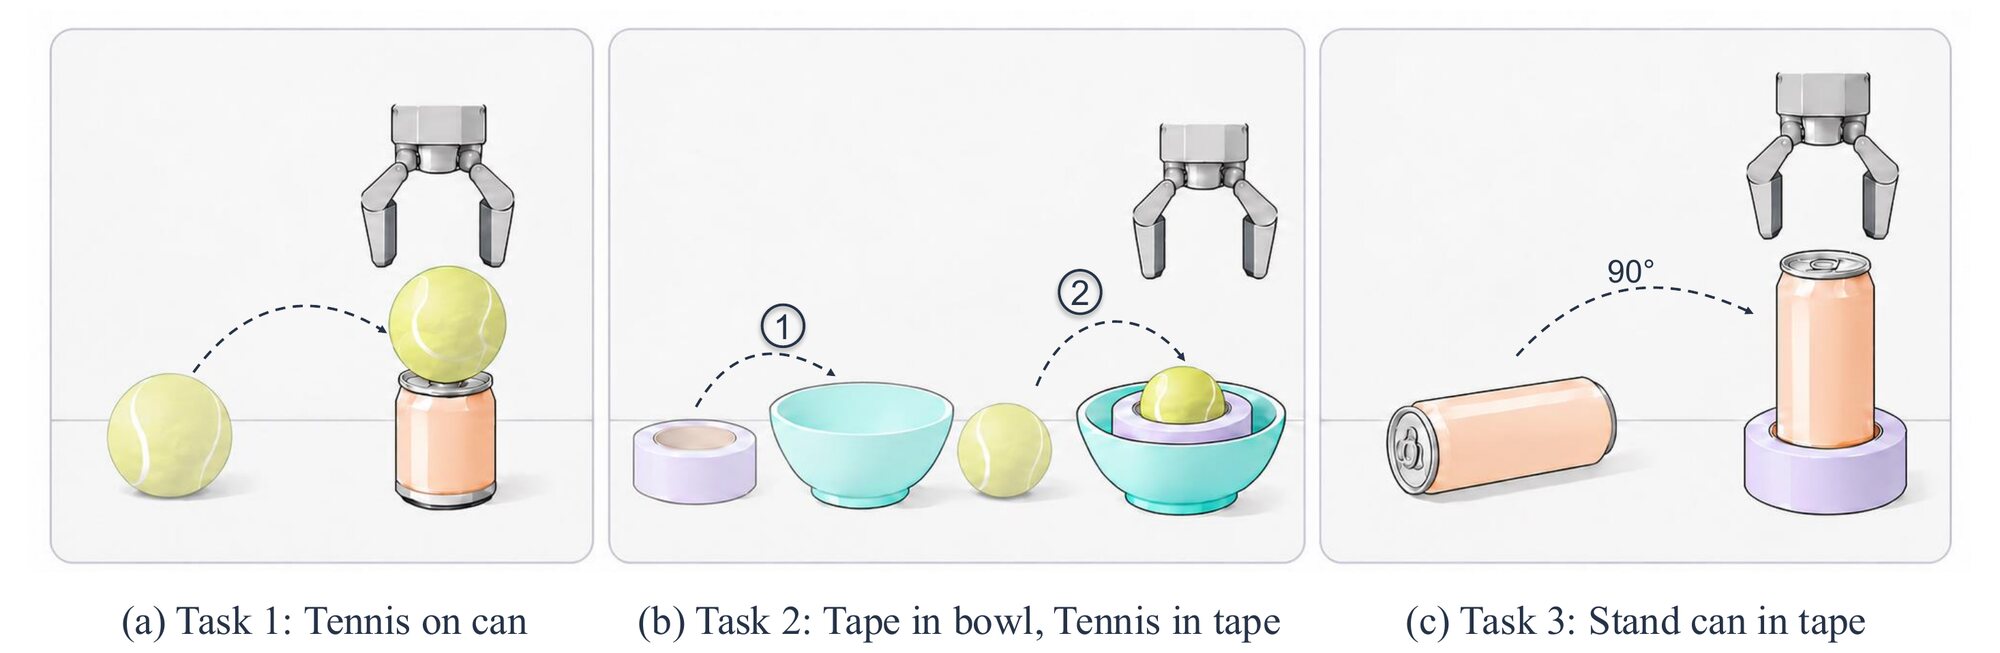
Nguồn: project NEO-VLA. Mỗi task được fine-tune với 50 demonstration và đánh giá 20 trial; NEO-VLA đạt lần lượt 12/20, 17/20, 13/20. Quy mô nhỏ này không phải chứng nhận độ tin cậy triển khai công nghiệp.
Chẩn đoán lỗi thường gặp và bước tiếp theo
Nếu không import được simulator, kiểm tra đúng Conda environment và ba version pin trước. Nếu EGL không khởi tạo, kiểm tra driver/rendering backend thay vì thay model. Nếu service trả HTTP 500, đọc traceback phía policy; lỗi checkpoint metadata khác với lỗi HTTP không kết nối được.
Nếu action có hướng lạ, kiểm tra camera order, phép xoay ảnh, frame và gripper trước khi tăng số solver step. Nếu chỉ đạt vài episode rồi dừng, kiểm tra file kết quả cũ và log từng task. Khi thay tham số, tạo output mới để kết quả không bị resume ngoài ý muốn.
Một mốc hoàn thành hợp lý cho người mới là: service trả metadata, smoke test sinh result, full run lưu protocol và per-suite success rate, rồi bạn giải thích được vì sao kết quả của mình có thể khác paper. Sau đó mới thử ablation một biến, chẳng hạn executed horizon, và giữ mọi yếu tố khác cố định. Đó là cách biến việc chạy model thành một thí nghiệm robotics có thể diễn giải.