Đọc cùng hướng dẫn chạy LIBERO.
Bài toán kinh điển trong VLA (Vision-Language-Action) từ trước đến nay luôn gắn với một giả định ngầm: cần một vision encoder mạnh, được pretrain riêng biệt — ViT, SigLIP, DINOv2 — để "hiểu" hình ảnh trước khi backbone ngôn ngữ xử lý. NEO-VLA đảo ngược giả định đó. Paper "From Pixels to Actions: Towards Native Vision-Language-Action Policies" từ S-Lab (Nanyang Technological University), SenseTime Research và Ropedia cho thấy: bỏ encoder riêng đi, để backbone tự học visual representation từ đầu, không những không tệ hơn mà còn đạt 95.3% trên LIBERO khi fine-tune toàn phần — và 90.9% khi chỉ train action expert, tức backbone hoàn toàn frozen.
Đây là một bước ngoặt về thiết kế kiến trúc, không phải chỉ là một trick engineering.
Tại sao lại bỏ vision encoder?
Trước NEO-VLA, pipeline VLA tiêu chuẩn trông như thế này:
Ảnh → [ViT/SigLIP Encoder] → visual tokens
Text → [tokenizer] → text tokens
[visual tokens + text tokens] → LLM backbone → action prediction
Vấn đề ở chỗ: hai encoder (visual + language) được pretrain riêng biệt, với objective khác nhau, rồi "ghép" vào nhau sau. Cách tiếp cận này có nhược điểm:
- Visual representation bị đóng băng ở một task — SigLIP được pretrain cho image-text matching, không phải cho manipulation control. Khi robot cần phân biệt góc quay của cổ tay 2°, feature của SigLIP có thể không đủ fine-grained.
- Mismatch giữa visual depth và language depth — backbone LLM có 40 lớp, nhưng visual encoder chỉ feed vào ở lớp đầu. Thông tin visual phải "chảy ngược" qua toàn bộ 40 lớp — rất nhiễu cho các lớp đầu vốn không được thiết kế cho visual reasoning.
- Chi phí bộ nhớ nhân đôi — phải load 2 model khi inference.
NEO-VLA đặt câu hỏi: nếu ta xây backbone từ đầu, học cả visual lẫn language cùng lúc từ scratch, liệu representation sẽ tốt hơn không?
Kiến trúc NEO-VLA
Kiến trúc gồm 3 thành phần chính:
1. Lightweight Patch Embedder
Thay vì dùng ViT-Large 300M params, NEO-VLA dùng vài lớp convolution nhẹ để chia ảnh thành patch tokens. Các lớp này học cùng backbone, không pretrain độc lập. Chi phí params rất nhỏ so với toàn model.
# Ý tưởng conceptual — patch embedder cực nhẹ
class PatchEmbedder(nn.Module):
    def __init__(self, patch_size=16, hidden_dim=2048):
        super().__init__()
        self.proj = nn.Conv2d(3, hidden_dim, kernel_size=patch_size, stride=patch_size)
        self.norm = nn.LayerNorm(hidden_dim)

    def forward(self, x):  # x: (B, 3, H, W)
        tokens = self.proj(x)           # (B, D, H/p, W/p)
        tokens = tokens.flatten(2).T    # (N_patches, B, D)
        return self.norm(tokens)
Điều quan trọng: patch tokens và word tokens được xử lý cùng nhau ngay từ lớp đầu tiên của backbone — không có "pre-processing" riêng.
2. Shared Vision-Language Backbone (2B params)
Backbone là decoder-only transformer 40 lớp, khoảng 2 tỷ tham số. Nó nhận toàn bộ context làm prefix:
- Ảnh multi-view hiện tại và trước đó (patch tokens)
- Mô tả task bằng ngôn ngữ (word tokens)
- Robot state (joint angles, end-effector pose)
Không có "visual pathway" riêng — tất cả xử lý qua cùng một chuỗi attention.
3. Flow-Matching Action Expert
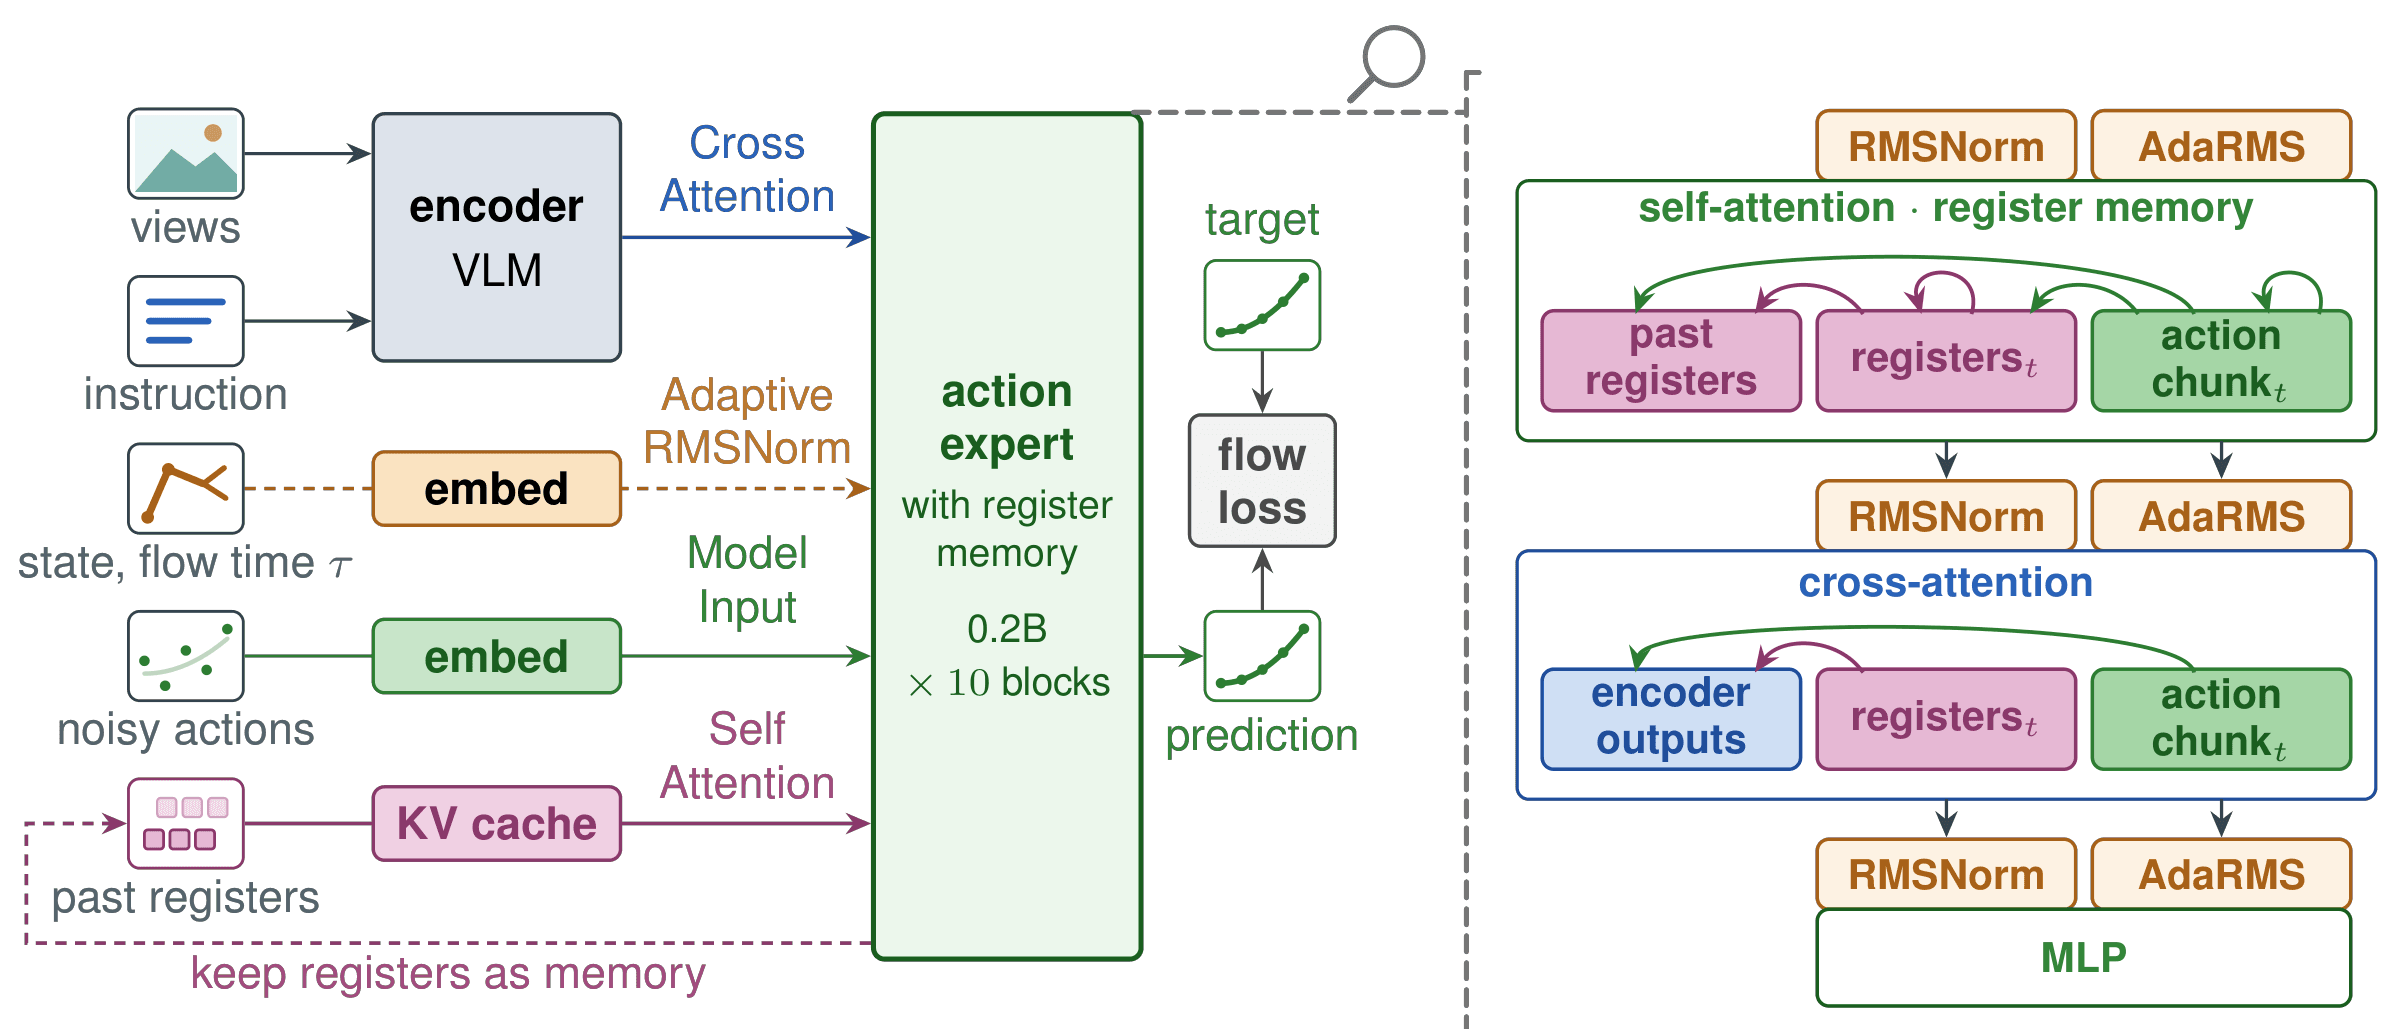
Đây là phần sáng tạo nhất. Thay vì chỉ đọc hidden state của lớp cuối backbone, action expert đọc cached keys và values từ nhiều lớp khác nhau.
Lớp 1  → K, V cache ──────────────────────┐
Lớp 10 → K, V cache ──────────────────────┤
Lớp 20 → K, V cache ──────────────────── Action Expert → action chunk
Lớp 30 → K, V cache ──────────────────────┤
Lớp 40 → K, V cache ──────────────────────┘
Lý do thiết kế này: paper chứng minh bằng layer-wise probing rằng thông tin quan trọng cho manipulation (fine-grained motor control) thường peak ở các lớp giữa, không phải lớp cuối cùng. Lớp cuối thiên về semantic/language reasoning hơn là visuomotor control.
Action expert dùng flow matching (không phải diffusion) để dự đoán action trajectory — nhanh hơn diffusion policy vì chỉ cần 1-5 NFE (Number of Function Evaluations) thay vì 20-100 bước denoising.
Kết quả trên LIBERO
LIBERO là benchmark tiêu chuẩn cho tabletop manipulation, gồm 4 suite:
- LIBERO-Spatial — hiểu không gian (trái/phải, trên/dưới)
- LIBERO-Object — nhận dạng vật thể khác nhau
- LIBERO-Goal — đạt mục tiêu đã chỉ định
- LIBERO-Long — chuỗi hành động dài (long-horizon)
| Model | Frozen backbone | Full fine-tune |
|---|---|---|
| Qwen3-VL-2B | 79.5% | 92.5% |
| Gemma-3-4B | 84.5% | 90.3% |
| NEO-VLA (2B) | 90.9% | 95.3% |
Ba điểm cần lưu ý:
- Frozen 90.9% là con số ấn tượng nhất — backbone hoàn toàn không được fine-tune, chỉ train action expert. Nghĩa là visual representation mà backbone tự học đã đủ tốt cho manipulation mà không cần adaptation.
- NEO-VLA cùng kích thước (2B) nhưng vượt Qwen3-VL-2B cả hai setting.
- Full fine-tune 95.3% so với Qwen3-VL 92.5% — gap 2.8% có vẻ nhỏ nhưng ở mức cao (>90%) thì mỗi % rất khó kiếm.
Ngoài LIBERO, NEO-VLA cũng được test trên RoboTwin 2.0 — benchmark mô phỏng với biến thể vật thể ngẫu nhiên:
| Setting | Score |
|---|---|
| RoboTwin 2.0 (randomized split) | 69.40 |
| RoboTwin 2.0 (clean split) | 75.78 |
Các task thực tế được demo

Paper demo NEO-VLA trên các task manipulation thực tế, bao gồm:
- Pick and place với vật thể ngẫu nhiên
- Stacking có yêu cầu ngôn ngữ (đặt hộp đỏ lên hộp xanh)
- Cabinet open + retrieve — cần hiểu không gian 3D
- Bimanual coordination — task yêu cầu 2 tay phối hợp
Điều đáng chú ý là trong tất cả các task, model chỉ nhận ảnh RGB thô + câu lệnh ngôn ngữ — không có depth, không có point cloud, không có 3D reconstruction.
Cài đặt và chạy inference
NEO-VLA được release tại GitHub repo chính thức của EvolvingLMMs-Lab: github.com/EvolvingLMMs-Lab/NEO.
Yêu cầu môi trường
# Môi trường cơ bản
Python >= 3.10
CUDA >= 12.1
GPU: RTX 3090 24GB trở lên (inference); A100 80GB cho full fine-tune

# Clone repo
git clone https://github.com/EvolvingLMMs-Lab/NEO
cd NEO

# Cài dependencies
pip install -e ".[vla]"
# hoặc
pip install torch torchvision transformers accelerate
pip install lerobot  # cho LIBERO data loader
Download weights
# NEO-VLA 2B model
huggingface-cli download EvolvingLMMs-Lab/NEO-VLA-2B \
  --local-dir ./checkpoints/neo-vla-2b

# Hoặc dùng Python
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id="EvolvingLMMs-Lab/NEO-VLA-2B",
    local_dir="./checkpoints/neo-vla-2b"
)
Inference cơ bản
import torch
from neo_vla import NEOVLAPolicy

# Load model
policy = NEOVLAPolicy.from_pretrained(
    "./checkpoints/neo-vla-2b",
    action_readout_layers=[10, 20, 30, 40],  # lớp nào action expert đọc
    device="cuda"
)
policy.eval()

# Chuẩn bị observation
obs = {
    "image": {
        "top": torch.rand(1, 3, 224, 224).cuda(),       # top camera
        "wrist": torch.rand(1, 3, 224, 224).cuda(),     # wrist camera
    },
    "language_instruction": ["put the red block on the plate"],
    "robot_state": torch.zeros(1, 7).cuda(),  # joint angles
}

# Predict action
with torch.no_grad():
    action = policy.predict_action(obs)
    # action shape: (1, action_horizon, action_dim)
    # action_horizon = 50 steps, action_dim = 7 (6DOF + gripper)
print(f"Action chunk: {action.shape}")  # torch.Size([1, 50, 7])
Chạy trên LIBERO
import lerobot
from lerobot.common.datasets.lerobot_dataset import LeRobotDataset

# Load LIBERO dataset
dataset = LeRobotDataset("lerobot/libero_goal")

# Evaluate
results = policy.evaluate_libero(
    suite="libero_goal",
    num_episodes=50,
    render=False,  # True để xem video
)
print(f"Success rate: {results['success_rate']:.1%}")
# Expected: ~90.9% (frozen backbone)
Fine-tuning trên dataset riêng
Điểm mạnh của NEO-VLA là khả năng fine-tune chỉ action expert — phần còn lại của backbone không cần đụng đến, tiết kiệm bộ nhớ đáng kể.
Chuẩn bị data
Data cần format theo chuẩn LeRobot:
from lerobot.common.datasets.push_dataset_to_hub import push_dataset_to_hub

# Dataset cần có:
# - observation.images.{camera_name}: video frames
# - observation.state: robot joint states
# - action: joint velocities/positions
# Mỗi episode khoảng 100-500 steps

# Convert từ raw teleoperation data
push_dataset_to_hub(
    raw_dir="./my_robot_data/",
    repo_id="my-org/my-task-dataset",
    raw_format="rlds",  # hoặc "pusht", "xarm", etc.
)
Training chỉ action expert (ít VRAM nhất)
# Frozen backbone — chỉ train action expert
# VRAM: ~20GB cho 2B model
python train_neo_vla.py \
  --model_path ./checkpoints/neo-vla-2b \
  --dataset lerobot/libero_goal \
  --train_mode action_expert_only \
  --readout_layers 10,20,30,40 \
  --batch_size 32 \
  --num_steps 50000 \
  --lr 1e-4 \
  --output_dir ./outputs/my-task-expert
Full fine-tune (đạt accuracy cao nhất)
# Full fine-tune — train cả backbone + action expert
# VRAM: ~80GB (cần A100 80GB hoặc multi-GPU)
python train_neo_vla.py \
  --model_path ./checkpoints/neo-vla-2b \
  --dataset lerobot/libero_goal \
  --train_mode full_finetune \
  --readout_layers 10,20,30,40 \
  --batch_size 16 \
  --num_steps 100000 \
  --lr 5e-5 \
  --gradient_checkpointing \
  --output_dir ./outputs/my-task-full
Tip thực tế: Với task mới trong domain tương tự LIBERO, action expert only thường đủ dùng và nhanh hơn nhiều. Full fine-tune chỉ cần khi task rất khác biệt về visual domain (ví dụ: outdoor, underwater).
Điểm nào khiến NEO-VLA quan trọng?
1. Encoder-free không có nghĩa là "không hiểu ảnh"
Nhiều người nghe "bỏ vision encoder" và nghĩ model sẽ mù. Nhưng thực ra backbone 2B params khi được train end-to-end với cả visual + language data, nó học visual representation tốt hơn cho downstream manipulation — vì objective training trực tiếp là robot control, không phải image-text matching trung gian.
2. Layer-wise readout là insight quan trọng
Phát hiện rằng action-critical features peak ở lớp giữa (không phải cuối) có thể thay đổi cách thiết kế nhiều VLA khác. Nếu bạn đang dùng Pi0, OpenVLA, hay Qwen-VL-based policy và chỉ đọc hidden state lớp cuối, có thể bạn đang bỏ sót thông tin quan trọng.
3. Robustness dưới visual perturbation
Paper báo cáo NEO-VLA có robustness cao hơn các model encoder-based khi test với visual distribution shift — thay đổi màu sắc nền, ánh sáng, góc camera. Lý do: vì visual representation được co-train với action objective, nó học các feature invariant hơn so với feature general-purpose của ViT/SigLIP.
So sánh với các VLA architecture khác
| Kiến trúc | Vision Encoder | Action Head | LIBERO (frozen) | LIBERO (full FT) |
|---|---|---|---|---|
| OpenVLA | SigLIP-400M | MLP | ~70% | ~85% |
| Pi0 | SigLIP + ViT | Diffusion | - | ~88% |
| Qwen3-VL-2B | Qwen vision | Flow matching | 79.5% | 92.5% |
| Gemma-3-4B | Gemma vision | Flow matching | 84.5% | 90.3% |
| NEO-VLA-2B | Không có | Flow matching | 90.9% | 95.3% |
Ba trụ cột của NEO-VLA so với Pi0/OpenVLA:
- Không cần encoder riêng → đơn giản hơn, ít params hơn cho cùng performance
- Multi-layer readout → khai thác thông tin tốt hơn từ backbone
- Flow matching → nhanh hơn diffusion (1-5 NFE vs 20-100 NFE)
Giới hạn và những gì chưa được giải quyết
Như mọi paper, NEO-VLA cũng có hạn chế cần nhắc đến:
- Chỉ test trên tabletop tasks — chưa có real-robot deployment video công khai cho các task phức tạp hơn (mobile manipulation, outdoor).
- Dataset pretraining chưa được công bố đầy đủ — paper đề cập dùng "action pretraining dataset" nhưng không chi tiết về nguồn gốc và quy mô.
- 2B params vẫn là medium-size — inference trên Jetson Orin cần benchmark thêm (Pi0 Fast đã có con số cho embedded deployment, NEO-VLA chưa).
- Multi-modal input chưa test video — hiện chỉ dùng frame tĩnh, chưa tận dụng temporal sequence như một số VLA mới hơn.
Kết luận
NEO-VLA đặt câu hỏi đúng: tại sao cần hai encoder riêng biệt khi một backbone thống nhất có thể học tốt hơn? Kết quả 95.3% trên LIBERO và đặc biệt là 90.9% với frozen backbone cho thấy kiến trúc native VLA không chỉ là ý tưởng hay về lý thuyết — nó thực sự work trong thực tế.
Với flow-matching action expert đọc từ nhiều lớp backbone, NEO-VLA cũng mở ra hướng nghiên cứu mới về how và where VLA nên extract visual information — không nhất thiết phải là lớp cuối cùng.
Paper và code tại: arxiv.org/abs/2611.06918 | github.com/EvolvingLMMs-Lab/NEO