Có một nghịch lý thú vị trong thế giới VLA (Vision-Language-Action) hiện nay: các model hành động ngày càng tinh vi hơn, nhưng "mắt" của chúng — backbone vision — lại được vay mượn từ những model đa năng không được tối ưu cho nhiệm vụ cốt lõi nhất: nhìn chính xác vào đúng vật thể cần thao tác.
XPENG, cùng với các nhà nghiên cứu từ Đại học Bắc Kinh và Đại học Hồng Kông, đề xuất một hướng khác: thay vì dùng backbone đa năng, hãy xây dựng một model grounding chuyên dụng làm nền tảng tri giác. Kết quả là GroundingPI — một model 4 tỷ tham số đạt điểm trung bình 73,68% trên 34 benchmark grounding, vượt qua GPT-6 Astra (71,54%) với ít tham số hơn, và cải thiện đáng kể hiệu suất VLA manipulation trên robot thực.
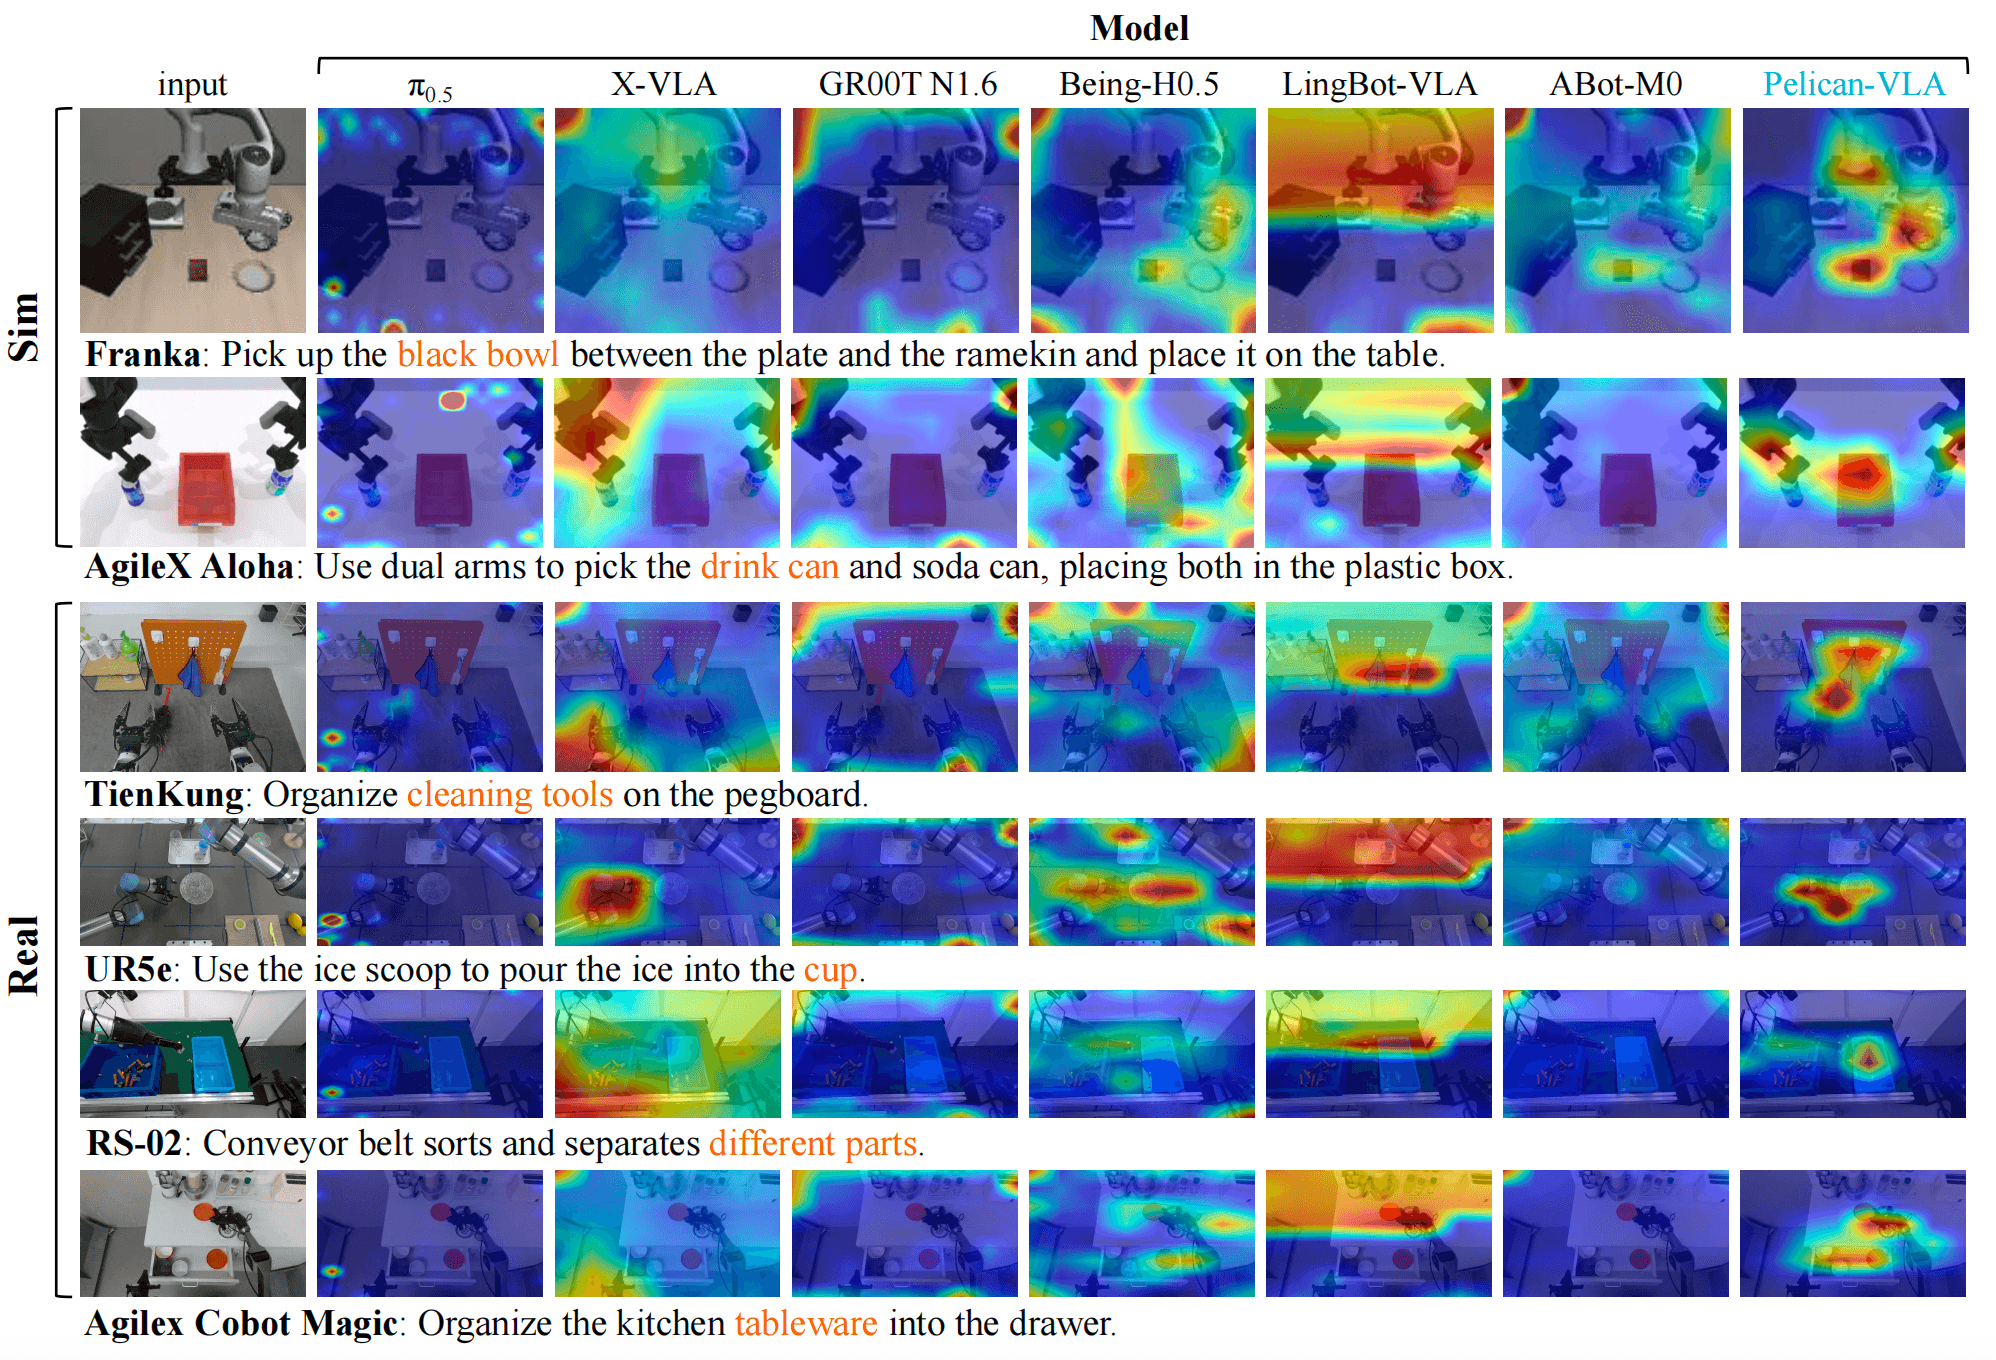
Vấn đề cốt lõi: VLA đang "mù" về perception chính xác
Hãy tưởng tượng bạn nhờ ai đó nhặt chiếc bút bi trên bàn, nhưng người đó chỉ có thể nhìn thấy "vật thể dài hình trụ màu xanh" mà không xác định được vị trí chính xác khi nhiều vật thể chen lẫn nhau. Đó chính xác là vấn đề mà các VLA model hiện tại gặp phải.
Các backbone vision-language và video-generation hiện dùng trong VLA (như các model đa năng từ GPT, Gemini hay InternVL) được thiết kế để hiểu nội dung hình ảnh theo nghĩa rộng. Chúng không được tối ưu cho:
- Vật thể nhỏ và bị che khuất: Khi robot cần thao tác với bu-lông 5mm trên bảng mạch
- Cảnh đông đúc: Khi nhiều vật thể chồng chất, cần chọn đúng một cái
- Độ chính xác tọa độ: Điểm mà cần gắp phải chính xác đến mức cm, không phải "khu vực"
- Tốc độ real-time: Closed-loop control cần latency thấp
GroundingPI được thiết kế để giải quyết đúng những vấn đề này, với kiến trúc và pipeline training đặc biệt dành cho grounding chính xác.
GroundingPI là gì?
GroundingPI là model grounding nền tảng 4 tỷ tham số, được thiết kế để làm backbone perception cho Physical Intelligence — tức là hệ thống robot và xe tự hành cần tương tác với thế giới vật lý.
Điểm khác biệt cốt lõi: thay vì xử lý ảnh theo nghĩa đa dụng, GroundingPI tập trung vào việc định vị chính xác — xác định chính xác vật thể là gì và ở đâu, biểu diễn kết quả dưới dạng điểm (points) và hộp bao (bounding boxes) dưới dạng tọa độ số lượng hóa (quantized coordinates) trong một vocabulary chung.
Điều này tạo ra một interface ngôn ngữ thống nhất: thay vì có pipeline riêng cho detection, referring, OCR, GUI grounding... tất cả đều được xử lý như bài toán "sinh ra chuỗi tọa độ có điều kiện theo ngôn ngữ".
Kiến trúc kỹ thuật
GroundingPI kết hợp hai thành phần đã được kiểm chứng:
Visual Encoder: MoonViT-V2 (Kimi K3)
MoonViT-V2 từ Kimi K3 đóng vai trò "mắt" của model. Đây là visual encoder mạnh mẽ được thiết kế để xử lý ảnh độ phân giải cao với chi tiết tinh tế — quan trọng cho việc phát hiện vật thể nhỏ.
Language Decoder: Qwen3-4B
Phần "não" của model là Qwen3-4B — decoder ngôn ngữ 4 tỷ tham số. Toàn bộ quá trình sinh ra tọa độ được xử lý như bài toán next-token prediction autoregressive.
Projector kết nối
Giữa encoder và decoder là một projector hai lớp MLP với GELU activation và output normalization. Nó aggregate các visual feature 2×2 lân cận và map chúng vào language embedding space. Thiết kế đơn giản nhưng hiệu quả.
Tokenization tọa độ
Điểm thú vị nhất: tọa độ được biểu diễn như các token ngôn ngữ. Ví dụ, một bounding box [x1, y1, x2, y2] được encode thành 4 token số trong vocabulary của Qwen3-4B. Điều này cho phép model học mối quan hệ giữa ngôn ngữ mô tả và vị trí không gian theo cách end-to-end, không cần head riêng.
Pipeline Training ba giai đoạn
GroundingPI được train qua ba giai đoạn, mỗi giai đoạn giải quyết một khía cạnh khác nhau:

Giai đoạn 1: Multimodal và Spatial Pretraining
Đây là giai đoạn xây dựng nền tảng. Model học từ dữ liệu đa phương thức đa dạng: ảnh-văn bản, detection, referring, OCR, GUI grounding, layout detection, v.v. Dữ liệu đến từ cả public dataset và "dedicated data engines" — pipeline tự động tạo dữ liệu chất lượng cao.
Giai đoạn 2: Supervised Fine-Tuning (SFT)
SFT dùng cross-entropy loss trên token level để học sinh ra tọa độ có cấu trúc. Giai đoạn này dạy model hiểu format output: cú pháp của bounding box, cú pháp của điểm chú ý (attention point), v.v.
Giai đoạn 3: GRPO Reinforcement Learning
Đây là giai đoạn tinh chỉnh quan trọng nhất. GRPO (Group Relative Policy Optimization) sample G=8 responses cho mỗi cặp ảnh-query, sau đó tính reward để update model.
Có hai hàm reward chính:
R_set — đo coverage: với mỗi ground truth box, tìm prediction có IoU cao nhất và kiểm tra class. Metric này đánh giá "bao nhiêu object thật được tìm thấy".
R_strict — đo chất lượng tổng thể: kết hợp multi-threshold F1, localization accuracy, format correctness, count, ordering. Phạt mạnh duplicate boxes và oversized boxes.
Combined reward: Ã_i = 0.7 × Z(R_set,i) + 0.3 × Z(R_strict,i)
Trong đó Z() là standardization trong cùng một prompt. Quan trọng: chỉ update language parameters, frozen SFT model làm reference. Điều này tránh catastrophic forgetting và giữ ổn định training.
Với OCR, dùng Hungarian matching để so sánh text và geometry — một approach khác biệt vì OCR cần exact match về text, không chỉ IoU.
Kết quả trên 34 Grounding Benchmarks
GroundingPI được evaluate trên 34 benchmark spanning 11 perceptual capabilities, so sánh với 44 baselines. Các capability bao gồm:
- Detection: COCO, LVIS (common + long-tail), Dense200 (đông đúc), VisDrone (vật thể nhỏ trên drone)
- Referring grounding: RefCOCO, RefCOCO+, RefCOCOg, HumanRef
- Spatial grounding: RoboSpatial, RefSpatial
- GUI grounding: ScreenSpot-V2, ScreenSpot-Pro, OSWorld-G
- OCR: HierText, ICDAR2015, TotalText, SROIE
- Document layout: DocLayNet, M6Doc
- Visual prompting: FSC147
Kết quả: GroundingPI đạt 73,68% trung bình, vượt GPT-6 Astra (71,54%) — model lớn hơn với "thinking effort: High". Đây là con số đáng chú ý vì GroundingPI nhỏ hơn đáng kể về số tham số.
Lưu ý quan trọng: trên ScreenSpot-Pro, Astra vẫn vượt trội. Điểm mạnh của GroundingPI là dense detection và tiny objects — đúng những gì cần cho robot manipulation.
Ứng dụng VLA Manipulation: Kết quả thực tế
Đây là phần quan trọng nhất với người làm robotics. GroundingPI được tích hợp như visual backbone cho policy theo kiến trúc π-style flow-matching.
Tích hợp với Action DiT
Kiến trúc pipeline như sau:
- GroundingPI encode ảnh quan sát và language instruction một lần (không lặp)
- Intermediate features được project và resample
- Inject vào Action DiT qua cross-attention layers tương ứng (layer-wise connection theo StarVLA)
- Action DiT denoises noisy action chunk thành continuous controls, có điều kiện theo features và robot state
Điểm thú vị: foundation model bị frozen — chỉ Action DiT được train. Điều này nghĩa là GroundingPI có thể được dùng như plug-in backbone cho bất kỳ π-style VLA nào.

RoboTwin 2.0: Out-of-Distribution Generalization
RoboTwin 2.0 đánh giá khả năng generalization trong 4 out-of-distribution (OOD) settings. GroundingPI vượt qua tất cả baselines trong cả 4 settings, với cải thiện lên đến 24,8% so với backbone mạnh nhất trong nhóm so sánh.
Các baseline được so sánh thuộc 4 nhóm:
- General-purpose vision-language models
- Video-generation backbones
- Grounding models khác
- Embodied foundation models
RoboCasa-GR1: Data Efficiency
Kết quả ấn tượng nhất về data efficiency: GroundingPI train với 50% demonstration data vượt tất cả baseline train với 75% data. Đây là chỉ số quan trọng vì dữ liệu robot thực sự rất tốn kém để thu thập.
Điều này gợi ý rằng backbone perception tốt hơn không chỉ cải thiện accuracy — nó còn giúp policy học nhanh hơn từ ít data hơn.

Autonomous Driving: nuScenes
Ngoài manipulation, GroundingPI cũng được test như visual backbone cho autonomous driving trên nuScenes. Kết quả: average open-loop L2 error 0,296m — một con số cạnh tranh cho bài toán trajectory planning.
Điều này confirm rằng grounding chính xác không chỉ có ích cho robot thao tác mà còn cho bất kỳ hệ thống nào cần hiểu không gian từ ảnh.
Cài đặt và Sử dụng
Clone repo và cài đặt
# Clone từ GitHub
git clone https://github.com/groundingpi/GroundingPI.git
cd GroundingPI

# Tạo môi trường (khuyến nghị conda)
conda create -n groundingpi python=3.10 -y
conda activate groundingpi

# Cài dependencies
pip install -e .
Download weights
from huggingface_hub import snapshot_download

# Download model weights
snapshot_download(
    repo_id="GroundingPI/GroundingPI",
    local_dir="./checkpoints/groundingpi-4b"
)
Inference cơ bản: Object Grounding
import torch
from PIL import Image
from groundingpi import GroundingPIModel, GroundingPIProcessor

# Load model và processor
model = GroundingPIModel.from_pretrained("./checkpoints/groundingpi-4b")
processor = GroundingPIProcessor.from_pretrained("./checkpoints/groundingpi-4b")
model = model.cuda().eval()

# Load ảnh
image = Image.open("robot_scene.jpg")

# Query ngôn ngữ
query = "Find the red cup on the table"

# Preprocess
inputs = processor(images=image, text=query, return_tensors="pt").to("cuda")

# Inference
with torch.no_grad():
    outputs = model.generate(
        **inputs,
        max_new_tokens=100,
        do_sample=False
    )

# Decode kết quả
result = processor.decode_grounding(outputs[0])
print(f"Boxes: {result['boxes']}")     # [[x1, y1, x2, y2], ...]
print(f"Points: {result['points']}")   # [[x, y], ...]
Tích hợp với VLA pipeline
# GroundingPI như visual backbone cho policy
from groundingpi import GroundingPIForVLA

# Load pretrained backbone (frozen)
backbone = GroundingPIForVLA.from_pretrained(
    "./checkpoints/groundingpi-4b",
    freeze_backbone=True  # Chỉ train Action DiT
)

# Forward pass để lấy intermediate features
def encode_observation(image, instruction):
    """Extract features cho Action DiT."""
    with torch.no_grad():
        features = backbone.extract_features(
            images=image,
            text=instruction,
            return_intermediate=True  # Layer-wise features
        )
    return features  # Dict của các layer features

# Trong training loop của Action DiT:
obs_features = encode_observation(obs_image, task_instruction)
action = action_dit(
    noisy_actions=noisy_actions,
    visual_features=obs_features,
    robot_state=robot_state
)
Thay đổi perceptual capability
GroundingPI hỗ trợ nhiều loại query khác nhau nhờ shared vocabulary:
# Object detection (open-vocab)
query = "Detect all objects in the image"

# Referring grounding (specific object)
query = "Find the small blue cube next to the yellow cylinder"

# Spatial relationship
query = "What is to the left of the red cup?"

# Point grounding (chỉ điểm, không phải box)
query = "Point to where I should grasp the cup"

# GUI grounding (cho robot thao tác màn hình cảm ứng)
query = "Click the 'Start' button"

# OCR + Layout
query = "Read the text on the product label"
Phân tích điểm mạnh và hạn chế
Điểm mạnh
Scaling rõ ràng: Khi tăng quy mô pretraining (data và model size), downstream manipulation và driving đều cải thiện. Điều này cho thấy con đường cải thiện rõ ràng.
Dense grounding có lợi nhất: Phân tích data recipe cho thấy khả năng dense grounding (tìm nhiều vật thể cùng lúc trong cảnh đông đúc) đóng góp lớn nhất cho cả manipulation lẫn driving.
OCR như catalyst: Bất ngờ nhất là OCR giúp cải thiện các perceptual capability khác — có lẽ vì nó dạy model kết hợp text và geometry chính xác.
Data efficiency: Kết quả RoboCasa-GR1 cho thấy đây là hướng đi đúng để giảm chi phí thu thập dữ liệu robot.
Hạn chế cần lưu ý
ScreenSpot-Pro: Astra vẫn vượt trội trong benchmark GUI precision cao — GroundingPI chưa tối ưu cho UI grounding phức tạp.
Chưa có real-world commercial deployment: XPENG nói rõ rằng kết quả hiện tại dựa trên simulation và offline evaluation, chưa chứng minh sẵn sàng cho triển khai thực tế thương mại.
Independent replication: Chưa có bên thứ ba chạy lại benchmark độc lập để xác nhận con số.
Kết luận
GroundingPI đặt ra một câu hỏi quan trọng cho cộng đồng VLA: nếu chúng ta đầu tư vào backbone perception chuyên dụng thay vì vay mượn từ model đa năng, hiệu suất downstream có thể cải thiện bao nhiêu?
Kết quả trên RoboTwin 2.0 (24,8% improvement trong OOD settings) và RoboCasa-GR1 (50% data hiệu quả như 75% data) gợi ý câu trả lời là "khá nhiều". Với code và weights mở, đây là một baseline đáng để cộng đồng khám phá và xây dựng tiếp.