BitVLA đặt ra một câu hỏi rất thực tế: có thể giữ khả năng nhìn, hiểu chỉ dẫn và điều khiển tay máy khi phần lớn ma trận trọng số chỉ còn ba giá trị hay không? Với robot.cpp, câu hỏi đó đã có đường triển khai cụ thể: tải bốn file GGUF I2S, khởi động một server C++, gửi hai ảnh cùng trạng thái robot và nhận lại một action chunk.
Ngày 09/11/2026, tác giả công bố robot.cpp là inference framework chính thức cho BitVLA. Với đầu vào LIBERO hai ảnh, dự án báo cáo 39 ms/action chunk trên RTX 3090 và 17 ms trên RTX 4090. Đây là số liệu của nhóm phát triển, không phải kết quả đo mới của bài viết. Nguồn: thông báo robot.cpp.
Hướng dẫn này đi từ ý tưởng, cài đặt, inference đến một rollout LIBERO nhỏ và fine-tuning. Điểm cần nhớ xuyên suốt: checkpoint, preprocessing và quy ước action đều ảnh hưởng trực tiếp đến kết quả. Một chương trình chạy hết mà robot không hoàn thành nhiệm vụ vẫn chưa chứng minh policy được triển khai đúng.
1. BitVLA giải quyết vấn đề gì?
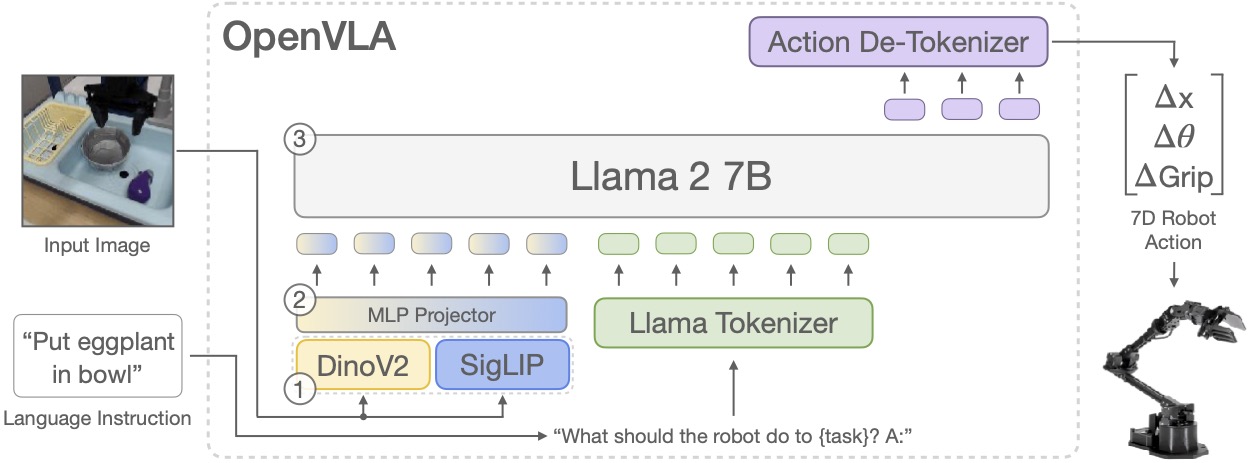
Một Vision-Language-Action model nhận ảnh, câu lệnh và có thể cả proprioception, sau đó dự đoán hành động. Trong mô phỏng, câu lệnh có thể là đặt chiếc bát vào ngăn kéo; proprioception mô tả vị trí end-effector, hướng và trạng thái gripper. Mô hình phải chuyển toàn bộ thông tin đó thành tín hiệu điều khiển có ích.
Các VLA lớn tốn bộ nhớ và thời gian tính toán. BitVLA tiếp cận từ quá trình học: language backbone là BitNet b1.58 2B4T, còn vision encoder SigLIP-L được chuyển sang trọng số ternary bằng Quantize-then-Distill. Ba trạng thái trọng số tương ứng mức thông tin lý thuyết log2(3) ≈ 1.585 bit. Tên gọi “1-bit VLA” không có nghĩa mỗi tham số trong file triển khai đều chiếm đúng một bit.
Hai lớp MLP nối đặc trưng ảnh vào language embedding và action head nhỏ vẫn giữ precision cao hơn. Trong GGUF, các tensor ngoài nhóm ma trận được đóng gói có thể còn BF16/F32. Vì vậy, không nên lấy số tham số nhân 1.58 bit để suy ra chính xác tổng VRAM cần dùng. Nguồn: kiến trúc và training trong paper.

2. Kiến trúc: từ hai camera đến tám hành động
Trong cấu hình LIBERO đang xét, dữ liệu đi qua hệ thống như sau:
Camera ngoài + camera cổ tay, RGB 224×224
                  |
            SigLIP-L low-bit
                  |
           MLP nối đặc trưng ---- Câu lệnh được tokenize
                  |                         |
                  +------ BitNet b1.58 ------+
                              ^
                   MLP trạng thái robot 8D
                              |
                      Action head liên tục
                              |
                       Chunk 8 × 7 giá trị
Mỗi ảnh 224×224 sinh 256 visual tokens ở encoder được mô tả trong paper. Hai góc nhìn bổ sung thông tin cho nhau: camera ngoài cho bố cục, camera cổ tay cho vùng tiếp xúc gần gripper. Trạng thái 8D gồm ba tọa độ end-effector, ba thành phần axis-angle và hai giá trị gripper.
Một action chunk có tám hàng, mỗi hàng bảy thành phần điều khiển. Client thường lấy từng hàng cho mỗi bước môi trường, dùng hết tám hàng rồi mới hỏi policy. Đây là action chunking: tiết kiệm số lần gọi mô hình nhưng tạo một khoảng open-loop ngắn. Nếu thay số action thực thi trước khi dự đoán lại, bạn đã thay một phần giao thức đánh giá.
robot.cpp tách mô hình thành bốn GGUF: language, vision, proprio và action. Server giữ chúng trong bộ nhớ, còn model-client truyền observation qua TCP. Phần inference C++ không cần PyTorch; môi trường mô phỏng, công cụ chuyển đổi và training vẫn có dependency Python riêng. Nguồn: tài liệu robot-server.
3. I2S khác gì với quantization thông thường?
Trong paper, trọng số được lượng tử hóa bằng absmean và activation bằng absmax theo token. Với training, nhóm tác giả vẫn giữ master weights để cập nhật gradient, còn forward sử dụng biểu diễn low-bit. Tải một checkpoint BF16 vì vậy không tự động mang lại mức tiết kiệm bộ nhớ của inference đã đóng gói.
Ở phía robot.cpp, converter áp dụng WeightQuant rồi pack những ma trận ternary hợp lệ thành i2s-matrix-v1. Mã pack hiện tại mã hóa bốn giá trị bằng các mã hai bit trong một byte và lưu scale của ma trận. Nó kiểm tra có thể khôi phục chính xác ma trận ternary đầu vào trước khi ghi. Đây là đóng gói một mô hình đã học với ràng buộc low-bit; không phải tùy ý nén một VLA BF16 bất kỳ và kỳ vọng giữ nguyên độ chính xác.
Cần dùng runtime robot.cpp đã patch. Không đưa các file này cho một bản llama.cpp CLI độc lập rồi giả định chúng tương thích. Cũng không trộn language của suite Spatial với action hoặc normalization của suite Goal. Nguồn: mã pack I2S và model card GGUF Spatial.

4. Chuẩn bị máy và checkpoint
Đường dễ đối chiếu nhất là Linux với NVIDIA GPU, driver hoạt động và CUDA Toolkit có nvcc. Cần C/C++ compiler, CMake từ 3.16 trở lên và Conda cho các công cụ Python. Kiểm tra trước:
nvidia-smi
nvcc --version
cmake --version
Một GPU có bộ nhớ lớn hơn mức mô hình công bố sẽ giúp bạn còn chỗ cho rendering, activation và workspace. Con số 1.4 GB trong bảng nghiên cứu không phải cam kết toàn bộ ứng dụng chỉ dùng 1.4 GB VRAM.
Lấy mã nguồn theo Quick Start; các lệnh sau dành cho máy bạn dùng để chạy tutorial:
git clone https://github.com/Robot-cpp/robot.cpp
cd robot.cpp
git submodule update --init --recursive
./tools/apply_patches.sh
export ROBOT_CPP_ROOT="$PWD"
Model card chỉ tới revision tương thích cf0712c2751fdd8519de22f822b7baa1b08b5937 hoặc revision mới hơn tương thích. Khi lưu kết quả, ghi lại revision thực tế và checksum checkpoint để lần sau không so sánh nhầm phiên bản.
Tạo môi trường benchmark và tải model:
conda env create -f eval/libero/environment.yaml
conda activate robotcpp-libero
pip install -U huggingface_hub
hf download robotcpp/bitvla-libero-spatial-i2s \
  --include '*.gguf' \
  --local-dir ckpts/bitvla-libero-spatial-i2s
export GGUF_DIR="$ROBOT_CPP_ROOT/ckpts/bitvla-libero-spatial-i2s"
ls "$GGUF_DIR"/*.gguf
Phải có đủ bốn file sau:
| File | Vai trò |
|---|---|
bitvla-llm-i2s.gguf |
Language backbone và metadata liên quan |
bitvla-vision-i2s.gguf |
Vision encoder và phần nối được export |
bitvla-proprio-i2s.gguf |
Chiếu và chuẩn hóa trạng thái |
bitvla-action-i2s.gguf |
Action head, thông tin chunk và action statistics |
Lưu ý về phiên bản: model card xác nhận bộ Spatial công khai này lấy từ fine-tune chưa robotics pre-training, với key libero_spatial_no_noops. Không gán cho nó kết quả 96.0% của biến thể mới đã pre-training. Model card cũng không tuyên bố kết quả success-rate mới sau conversion.
5. Chạy inference và benchmark latency
Từ thư mục robot.cpp, build và mở server bằng launcher có hỗ trợ BitVLA:
export MODEL_TYPE=bitvla
export HOST=127.0.0.1
export PORT=5555
bash robot_server/shell/launch_robot_server_linux_cuda.sh
Giữ terminal này mở nếu muốn dùng client ở phần rollout. Launcher cấu hình CMake, build model-server và nạp bốn thành phần. Nếu báo không tìm thấy compiler CUDA, kiểm tra đường dẫn nvcc; nếu báo thiếu GGUF, kiểm tra lại GGUF_DIR tuyệt đối và tên file.
Để đo latency riêng, dừng server trên bằng Ctrl+C rồi chạy benchmark độc lập. Script benchmark tự quản lý server riêng, mặc định dùng port 5569:
WARMUP=5 LOOPS=100 \
bash robot_server/test/test_server_latency.sh \
  bitvla linux-cuda bitvla-libero
Preset này gửi hai ảnh 224×224 mang tên full_image, wrist_image và state 8D. Nó hữu ích để xác nhận tải model, giao thức và thời gian suy luận; không dùng nó để tính tỷ lệ thành công thao tác. Script ghi TSV cùng server logs dưới thư mục debug/artifacts/robot_server_latency_linux_cuda theo cấu hình mặc định. Nguồn: benchmark script.
Nếu muốn thử CPU trên Linux, thay backend bằng linux-cpu. Trên M4 Pro, dự án hiện khuyên dùng CPU thay vì Metal cho BitVLA I2S; không suy rộng ưu thế CUDA sang mọi backend.
6. Nối LIBERO mà không mất preprocessing
Ở phiên bản tài liệu được kiểm tra, eval/libero/scripts/run_model_server.sh chỉ nhận pi0 hoặc smolvla. Vì vậy, đặt MODEL_TYPE=bitvla cho wrapper đó sẽ bị từ chối. Hơn nữa, đường adapter chung không tự chứng minh rằng crop và gripper giống đánh giá BitVLA. Ta dùng model-client trực tiếp và tái sử dụng helper của repo BitVLA.
Tạo môi trường BitVLA riêng theo hướng dẫn gốc; đừng cài transformer fork vào môi trường benchmark đang dùng:
# Chạy từ thư mục cha nơi bạn muốn đặt repo BitVLA.
git clone https://github.com/ustcwhy/BitVLA
conda create -n bitvla python=3.10 -y
conda activate bitvla
pip install torch==2.5.0 torchvision==0.20.0 torchaudio==2.5.0 \
  --index-url https://download.pytorch.org/whl/cu124
cd BitVLA
pip install -e openvla-oft/
pip install -e transformers
cd openvla-oft
git clone https://github.com/Lifelong-Robot-Learning/LIBERO.git
pip install -e LIBERO/
pip install -r experiments/robot/libero/libero_requirements.txt
pip install -e bitvla/
export PYTHONPATH="$ROBOT_CPP_ROOT:$PWD${PYTHONPATH:+:$PYTHONPATH}"
Đường dẫn ROBOT_CPP_ROOT phải trỏ tới robot.cpp ở terminal hiện tại; nếu mở shell mới, export lại bằng đường dẫn tuyệt đối. Cài đặt LIBERO gốc có thể hỏi vị trí dataset/assets: dùng cấu hình theo repo, không trộn ngẫu nhiên package hf-libero vào environment này.
Khởi động lại server BitVLA ở terminal riêng như phần 5. Trong terminal đang ở BitVLA/openvla-oft, chạy smoke rollout dưới đây. Đây là adapter minh họa để chạy một task, chưa phải bản tái lập benchmark đầy đủ đã được nghiệm thu:
MUJOCO_GL=egl python - <<'PY'
from collections import deque
from types import SimpleNamespace
import numpy as np
from libero.libero import benchmark
from robot_client.python.model_client import ModelClient
from experiments.robot.libero.libero_utils import (
    get_libero_env, get_libero_image, get_libero_wrist_image,
    get_libero_dummy_action, quat2axisangle,
)
from experiments.robot.openvla_utils import prepare_images_for_vla
from experiments.robot.robot_utils import (
    normalize_gripper_action, invert_gripper_action,
)

suite = benchmark.get_benchmark_dict()["libero_spatial"]()
env, instruction = get_libero_env(
    suite.get_task(0), "bitnet", resolution=256
)
client = ModelClient(host="127.0.0.1", port=5555)
queue = deque()
cfg = SimpleNamespace(center_crop=True)
try:
    env.reset()
    obs = env.set_init_state(suite.get_task_init_states(0)[0])
    client.reset()
    for _ in range(10):
        obs, _, _, _ = env.step(get_libero_dummy_action("bitnet"))
    success = False
    for step in range(220):
        if not queue:
            images = prepare_images_for_vla(
                [get_libero_image(obs), get_libero_wrist_image(obs)],
                cfg, image_size=224,
            )
            state = np.concatenate([
                obs["robot0_eef_pos"],
                quat2axisangle(obs["robot0_eef_quat"]),
                obs["robot0_gripper_qpos"],
            ]).astype(np.float32)
            response = client.predict({
                "images": [
                    {"name": name, "image": np.asarray(im, dtype=np.uint8).copy()}
                    for name, im in zip(["full_image", "wrist_image"], images)
                ],
                "state": state,
                "prompt": instruction,
            })
            actions = np.asarray(response.actions, dtype=np.float32)
            assert actions.shape == (8, 7), actions.shape
            queue.extend(actions)
        action = queue.popleft().copy()
        action = normalize_gripper_action(action, binarize=True)
        action = invert_gripper_action(action)
        obs, _, done, _ = env.step(action.tolist())
        if done:
            success = True
            break
    print({"task": instruction, "success": success, "steps": step + 1})
finally:
    env.close()
PY
Helper ảnh xoay đúng hướng camera, resize và center-crop theo pipeline gốc. Chỉ gửi RGB uint8; server đảm nhiệm normalization ảnh/state và action denormalization. Không normalize state lần nữa ở client. Ngược lại, gripper vẫn cần biến đổi từ quy ước dataset sang quy ước môi trường, như hai lời gọi cuối trong ví dụ. Nguồn: evaluator BitVLA.
Nếu EGL lỗi, kiểm tra NVIDIA EGL và device visibility trước. OSMesa là lựa chọn software rendering khi thiếu GPU rendering, nhưng cần thư viện OSMesa và sẽ làm tổng rollout chậm hơn. Khi một episode thất bại, trước tiên kiểm tra camera order, crop, state, gripper và checkpoint-suite; đừng vội kết luận quantization làm hỏng policy.
7. Training: hiểu pipeline rồi mới fine-tune
BitVLA có ba chặng lớn. Đầu tiên, multimodal training nối vision encoder precision cao với BitNet để học liên kết ảnh và ngôn ngữ. Tiếp theo, Quantize-then-Distill tạo vision student low-bit; teacher precision cao được giữ cố định, language backbone và connector cũng đóng băng. Loss kết hợp language modeling với khoảng cách biểu diễn teacher–student, giúp ảnh sau quantization vẫn mang ý nghĩa phù hợp với backbone.
Cuối cùng là robotics training. Pre-training dùng dự đoán action autoregressive, với mỗi chiều action được rời rạc hóa thành 256 bins. Fine-tuning theo OFT chuyển sang dự đoán action chunk liên tục với L1 loss; BitVLA giữ causal attention thay vì tự động dùng bidirectional mask. Vì thế, đừng thay mask hoặc dùng decoding của một VLA khác chỉ vì chúng đều có action chunking.
Quy mô pre-training công bố là 200K steps, global batch 2048, khoảng 14 ngày trên 16 H800 80 GB. Đây không phải bước beginner cần tái tạo để chạy inference. Repo vẫn đánh dấu pre-training code là hạng mục chưa phát hành đầy đủ; đường thực hành là dùng checkpoint rồi fine-tune.
Để fine-tune Spatial, tải dataset openvla/modified_libero_rlds và checkpoint được repo khuyến nghị lxsy/bitvla-bf16. Trong môi trường BitVLA, mở script bên dưới và thay các đường dẫn placeholder trước khi chạy:
# Thực hiện trong BitVLA/openvla-oft.
sh ft_script/ft_bitvla_libero_spatial.sh
Script hiện dùng bốn GPU, batch mỗi GPU bằng 2 và gradient accumulation bằng 8: global batch hiệu dụng là 4 × 2 × 8 = 64. Các thiết lập đáng chú ý gồm use_l1_regression=True, use_lora=False, hai ảnh, proprioception, learning rate 1e-4 và 10001 steps trong launcher. Nếu chỉ có một GPU, điều chỉnh số process, batch và accumulation theo bộ nhớ thực tế; việc giảm process không tự đảm bảo bài toán vừa VRAM.
Giữ các file head, config và dataset_statistics.json cùng checkpoint. Converter cần chúng, không chỉ model.safetensors. Với key Spatial, ví dụ export là:
cd "$ROBOT_CPP_ROOT"
conda env create -f tools/hf2gguf/environment.yaml
conda activate gguf_converter
CHECKPOINT_DIR=/absolute/path/to/complete-finetuned-checkpoint \
OUTPUT_DIR=/absolute/path/to/new-bitvla-spatial-i2s \
DATASET_KEY=libero_spatial_no_noops \
PYTHON_BIN="$(command -v python)" \
bash tools/hf2gguf/bitvla/convert_bitvla_all.sh
OUTPUT_DIR phải là đường dẫn mới. Script tạo BF16 trung gian, pack I2S và dọn thư mục trung gian sau khi thành công; khi lỗi nó giữ lại để chẩn đoán. Kiểm tra key thật trong statistics của checkpoint thay vì mặc định mọi dataset đều dùng tên trên. Nguồn: converter.
8. Đọc kết quả mà không trộn các thí nghiệm
Bảng dưới tóm tắt kết quả tác giả công bố, không phải kết quả rollout minh họa:
| Biến thể | Spatial | Object | Goal | Long | Trung bình |
|---|---|---|---|---|---|
| BitVLA chưa robotics pre-training | 97.4 | 99.6 | 94.4 | 87.6 | 94.8 |
| BitVLA đã robotics pre-training | 96.6 | 99.0 | 95.4 | 92.8 | 96.0 |
| OpenVLA-OFT, baseline tham khảo | 97.6 | 98.4 | 97.9 | 94.5 | 97.1 |
Các baseline trong paper có nguồn từ công trình tương ứng. Không thể từ bảng này kết luận conversion I2S mới giữ nguyên success rate nếu chưa đo lại cùng checkpoint và giao thức.

Với latency, bảng robot.cpp ghi 17 ms trên RTX 4090, 39 ms trên RTX 3090, 87 ms trên RTX 3060 và 1168 ms trên M4 Pro CPU. Speedup 9.7× lấy 377.8/39; 5.4× lấy 209.2/39, so với eager và compile trên RTX 3090. Các tỷ lệ này phản ánh cả mô hình thực thi và runtime, không tách riêng đóng góp của I2S.
1000/17 ≈ 58.8 là số chunk mỗi giây. Với tám action mỗi chunk, không có nghĩa robot vật lý có thể đóng vòng phản hồi ở 58.8 × 8 Hz: còn camera, truyền dữ liệu, bước mô phỏng và thời gian thực thi. Paper cũng có phép đo 73 ms trên A100 với ba ảnh, state 14D và chunk 25; không so trực tiếp số đó với benchmark hai ảnh/chunk 8 của robot.cpp. Nguồn: bảng hiệu năng robot.cpp.
Khi tự đánh giá, hãy ghi checkpoint revision, mã nguồn, backend, số warmup, số lần đo và cấu hình ảnh. Sau smoke test, chạy nhiều task và nhiều initial states, lưu success rate riêng với latency; đối chiếu baseline PyTorch cùng preprocessing trước khi quy nguyên nhân sai khác cho quantization. Đó là cách biến một bản demo chạy được thành kết quả kỹ thuật có thể kiểm chứng.