Long-horizon robot manipulation đặt ra một câu hỏi khó: làm sao robot nhớ được những việc nó đã làm cách đây 2 phút để ra quyết định đúng ngay bây giờ? Đây không phải vấn đề tính toán thuần túy — đây là vấn đề thiết kế bộ nhớ sai từ gốc.
Paper SimpleMemVLA: A Simple but Effective Native-Video Memory for Vision-Language-Action Models (arXiv:2609.05533, tháng 9/2026) của nhóm tác giả Cheng Yin, Wang Xu, Junpeng Yang và cộng sự đưa ra một lời giải bất ngờ: không cần module nhớ chuyên dụng nào cả. Chỉ cần đưa dữ liệu đúng định dạng mà backbone VLM đã được train để xử lý từ đầu.
Vấn đề: Tại sao Long-Horizon Manipulation khó đến vậy?
Hãy tưởng tượng một robot cần thực hiện chuỗi thao tác: đặt khối A vào hộp đỏ, sau đó đặt khối B vào hộp xanh, rồi dựa vào thứ tự đặt ban đầu để tháo chúng ra theo đúng trình tự ngược lại. Thông tin quan trọng nhất — khối nào được đặt trước — đã biến mất khỏi khung hình hiện tại từ lâu.
Đây là bản chất của bài toán partially observable: policy cần thông tin từ quá khứ, nhưng observation hiện tại không chứa đủ thông tin đó. Các VLA model thông thường chỉ xử lý frame hiện tại hoặc cửa sổ ngắn vài frame — chúng hoàn toàn mù trước lịch sử dài.
Các benchmark đo khả năng này rất đa dạng:
- RMBench: 9 task trên robot bimanual Aloha-AgileX, yêu cầu nhớ vật thể và thứ tự qua nhiều bước
- RoboMME: 16 task trên Panda, kiểm tra nhiều loại memory (sequence, spatial, semantic)
- MIKASA-Robo: Task với wrist camera, phụ thuộc lịch sử ngắn hơn nhưng dày đặc hơn
- RoboMemArena: Horizon dài nhất — cửa sổ lịch sử tới 126 giây
Các Cơ chế Memory Cũ: Tại sao Đều Thất bại?
Trước SimpleMemVLA, cộng đồng nghiên cứu đã thử ba hướng tiếp cận chính:
1. Retrieval-based memory
Lưu trữ observation "quan trọng" vào memory bank, truy vấn (retrieve) khi cần quyết định. Vấn đề cốt lõi: phải quyết định cái gì quan trọng tại thời điểm ghi — trước khi biết quyết định trong tương lai cần thông tin gì. Đây gọi là "write-time commitment problem".
2. Token compression
Nén lịch sử thành số token cố định (ví dụ 1 token/frame). Vấn đề: thông tin bị mất không thể phục hồi được. Model nén không có khả năng dự đoán thông tin nào sẽ cần trong tương lai.
3. Recurrent state (kiểu RNN)
Duy trì hidden state tóm tắt lịch sử, cập nhật mỗi bước. Vấn đề: state là "lossy" — mỗi bước có thể ghi đè thông tin cũ. Đây chính xác là nơi thông tin về thứ tự và ngữ cảnh bị mất dần.
Kết quả ablation của SimpleMemVLA trên RoboMME (cùng backbone Qwen3.5-4B, chỉ thay memory interface):
| Memory Interface | Kết quả RoboMME |
|---|---|
| Native Context (SimpleMemVLA) | 88.3% |
| Retrieval-based | 31.5% |
| Token Compression | 22.6% |
| Recurrent State | 20.6% |
Khoảng cách 88.3% vs 20–31% không thể giải thích bằng backbone hay training data. Bằng chứng hiển nhiên: vấn đề nằm ở thiết kế memory interface, không phải ở năng lực backbone.
Insight Cốt lõi: VLM Đã Biết Cách Đọc Video
Backbone Qwen3.5-4B đã được pre-train trên lượng khổng lồ video kèm timestamp. Nó biết cách xử lý video theo thời gian — đó chính xác là định dạng nó được huấn luyện từ đầu.
Insight của SimpleMemVLA rất đơn giản nhưng sâu sắc: đừng "dạy lại" model cách nhớ bằng module mới — hãy cho nó dữ liệu theo đúng định dạng nó đã biết xử lý.
Thay vì nén, truy vấn hay duy trì recurrent state, SimpleMemVLA:
- Lưu lại các frame quan sát có timestamp dạng video gốc
- Đưa toàn bộ vào backbone dưới dạng video clip thuần túy
- Để self-attention của backbone tự quyết định frame nào quan trọng tại thời điểm ra quyết định
Không cần "commit" cái gì quan trọng từ sớm — bằng chứng chỉ được đánh giá khi cần thiết. Đây là nguyên tắc deferred evidence selection.
Để hiểu tại sao điều này quan trọng: một human expert đọc video lịch sử để tìm clue — họ không ép bản thân "tóm tắt" video trước khi biết câu hỏi cần trả lời. SimpleMemVLA cho backbone làm đúng điều đó.
Kiến Trúc của SimpleMemVLA
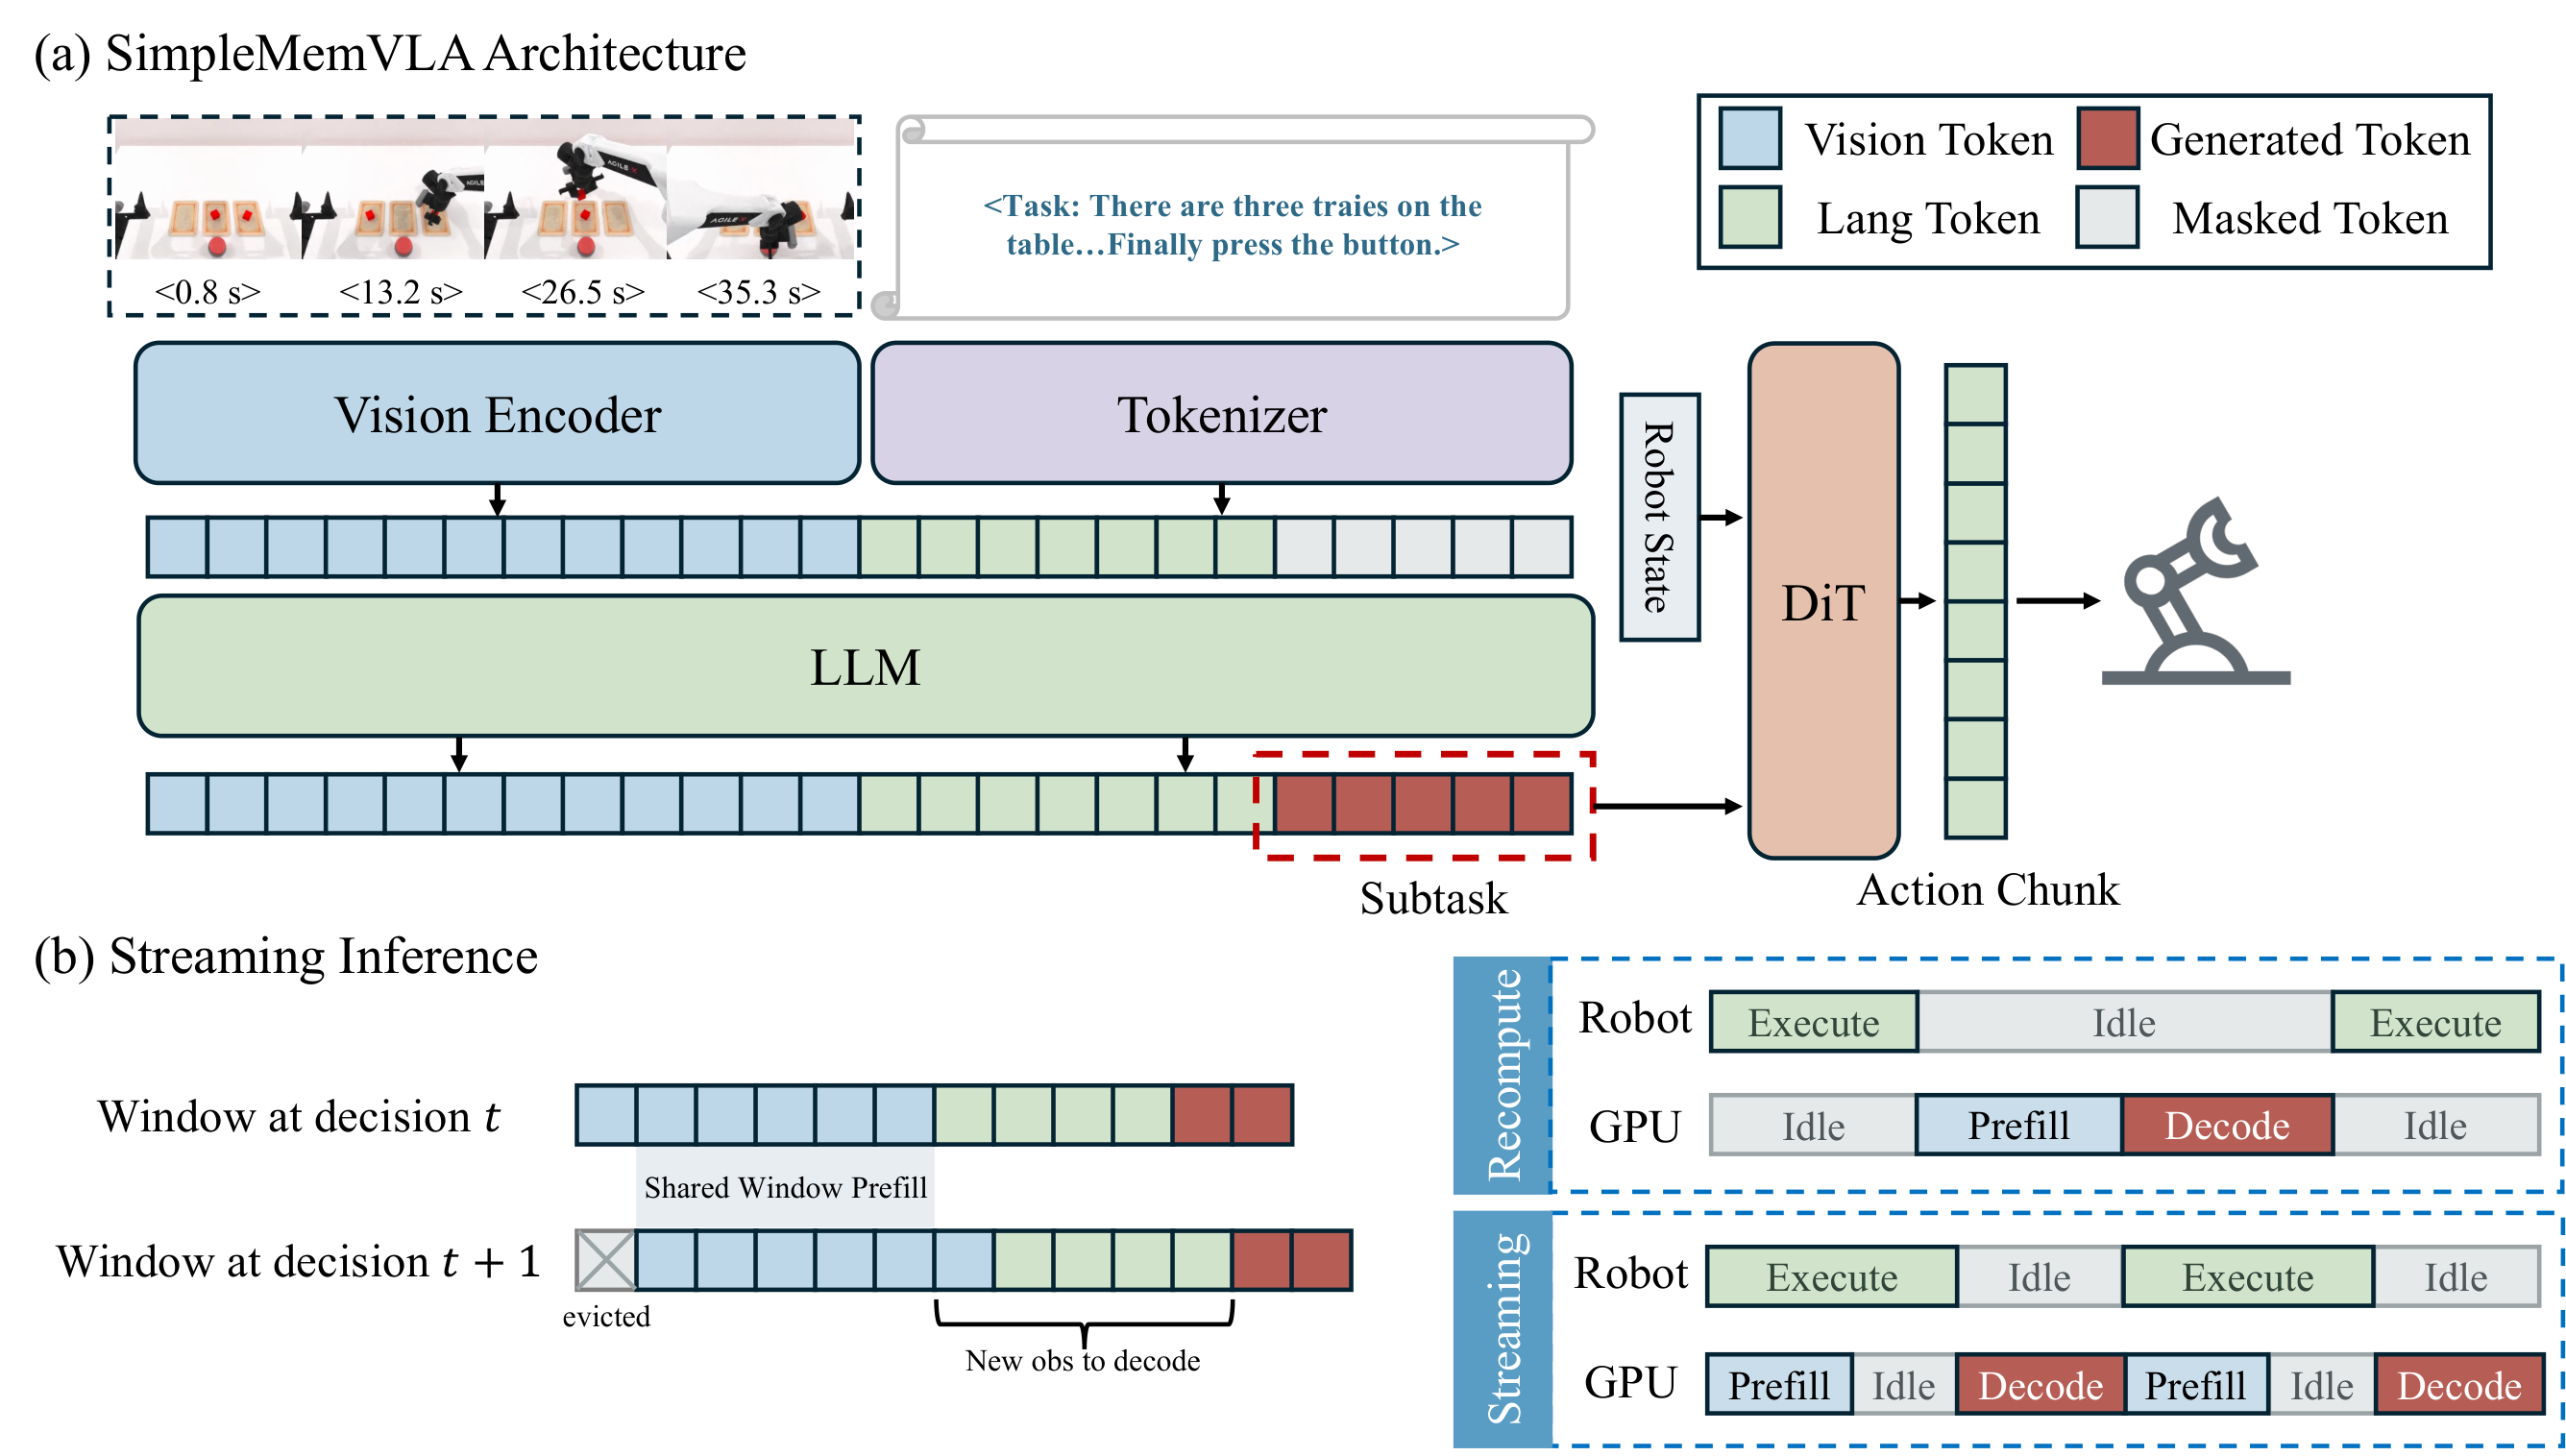
SimpleMemVLA gồm 3 thành phần kết nối tuần tự:
Thành phần 1 — Video History Input
Model duy trì cửa sổ lịch sử V_t = (frame_{t−Ks}, …, frame_{t−s}, frame_t):
- 60 giây lịch sử tại 2 fps = 120 frame
- Mỗi frame được prefix bằng plaintext timestamp theo đúng định dạng video pretraining của Qwen3.5-4B (ví dụ:
[t=42.3s]) - Một cửa sổ 60 giây chỉ tốn khoảng 5.600 token trong context window 262.000 token — đủ chỗ lưu tới 45 phút lịch sử
Camera chính đưa video history vào video channel của backbone. Camera cổ tay (wrist camera) chỉ đưa frame hiện tại qua image channel — phân biệt quá khứ và hiện tại bằng modality, không cần encoding đặc biệt.
Thành phần 2 — Sub-task Generation (Cầu nối Memory → Action)
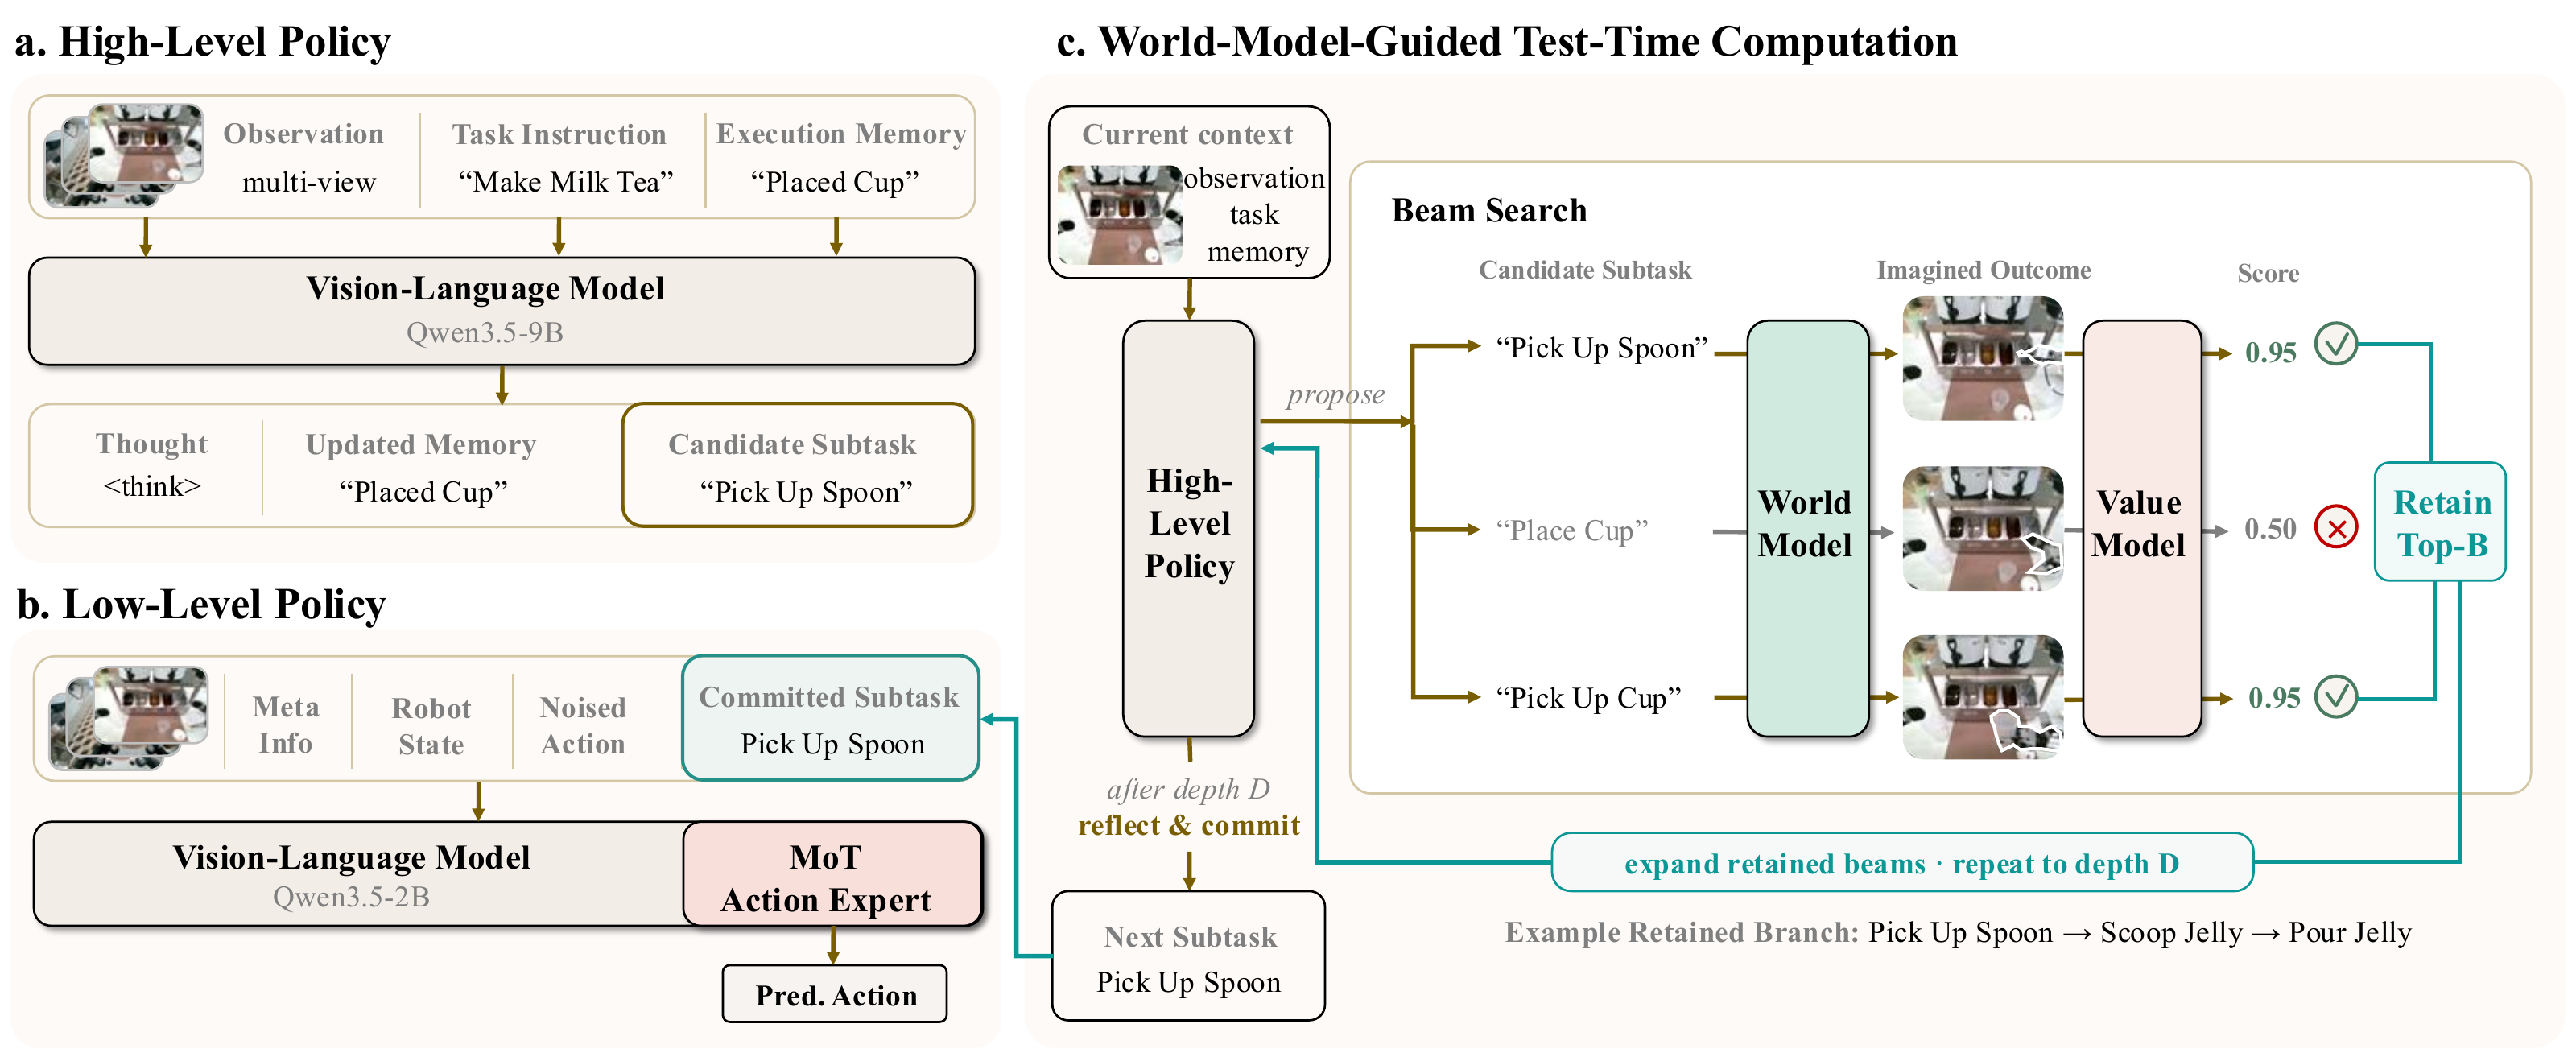
Backbone sinh ra mô tả ngắn về task hiện tại dựa trên toàn bộ video history:
- Tối đa 64 token — không chain-of-thought, không suy luận dài dòng
- Được supervise bằng token-level cross-entropy với nhãn sub-task chính xác
- Hidden states và token embeddings của span này là kênh duy nhất truyền thông tin từ video history xuống action head
Đây là "thắt cổ chai có chủ đích": model phải nén những gì nó hiểu từ lịch sử video vào ≤64 token — nhưng sự nén này xảy ra sau khi đã đọc toàn bộ lịch sử, không phải trước. Quan trọng hơn, không có drift giữa train và inference vì span masking hoàn toàn xác định.
Thành phần 3 — Flow-Matching Action Head
Action head là một DiT (Diffusion Transformer) khoảng 0.9 tỷ tham số:
- Conditioning set C_t = [token embeddings + hidden states từ sub-task span] + [normalized proprioceptive token]
- Inference: 10 bước Euler integration deterministic
- Loss: flow-matching loss chuẩn — E[‖v_φ(A^τ, τ | C_t) − (ε − Ā_t)‖²]
Không có kiến trúc đặc biệt ở đây — đây là flow-matching head tiêu chuẩn, chỉ khác ở conditioning đến từ hidden states của sub-task span thay vì từ frame đơn lẻ. Xem thêm cơ chế flow-matching trong bài phân tích A1-VLA Truncated Flow Matching.
Streaming Inference: Giữ Latency Gần Single-Frame
Robot thực hiện action trong ~0.96 giây. Trong thời gian đó, SimpleMemVLA prefill shared prefix thay vì đứng không chờ.
Vì các quyết định liên tiếp chia sẻ hầu hết video prefix (chỉ vài frame mới nhất thay đổi), hệ thống:
- Lưu KV cache của prefix đã compute trong lần quyết định trước
- Khi cần quyết định mới, chỉ compute phần mới thêm vào prefix
- Output bit-identical với full recomputation — không mất accuracy
Latency thực đo (60 giây lịch sử):
| Mode | Latency |
|---|---|
| Full recomputation | 1.02 giây |
| Streaming inference | 0.68 giây |
| Execution budget robot | 0.96 giây |
Với lịch sử 45 phút, streaming giảm latency từ 32.1 giây xuống 1.18 giây — speedup 27 lần, và output vẫn bit-identical.
Kết quả Benchmark
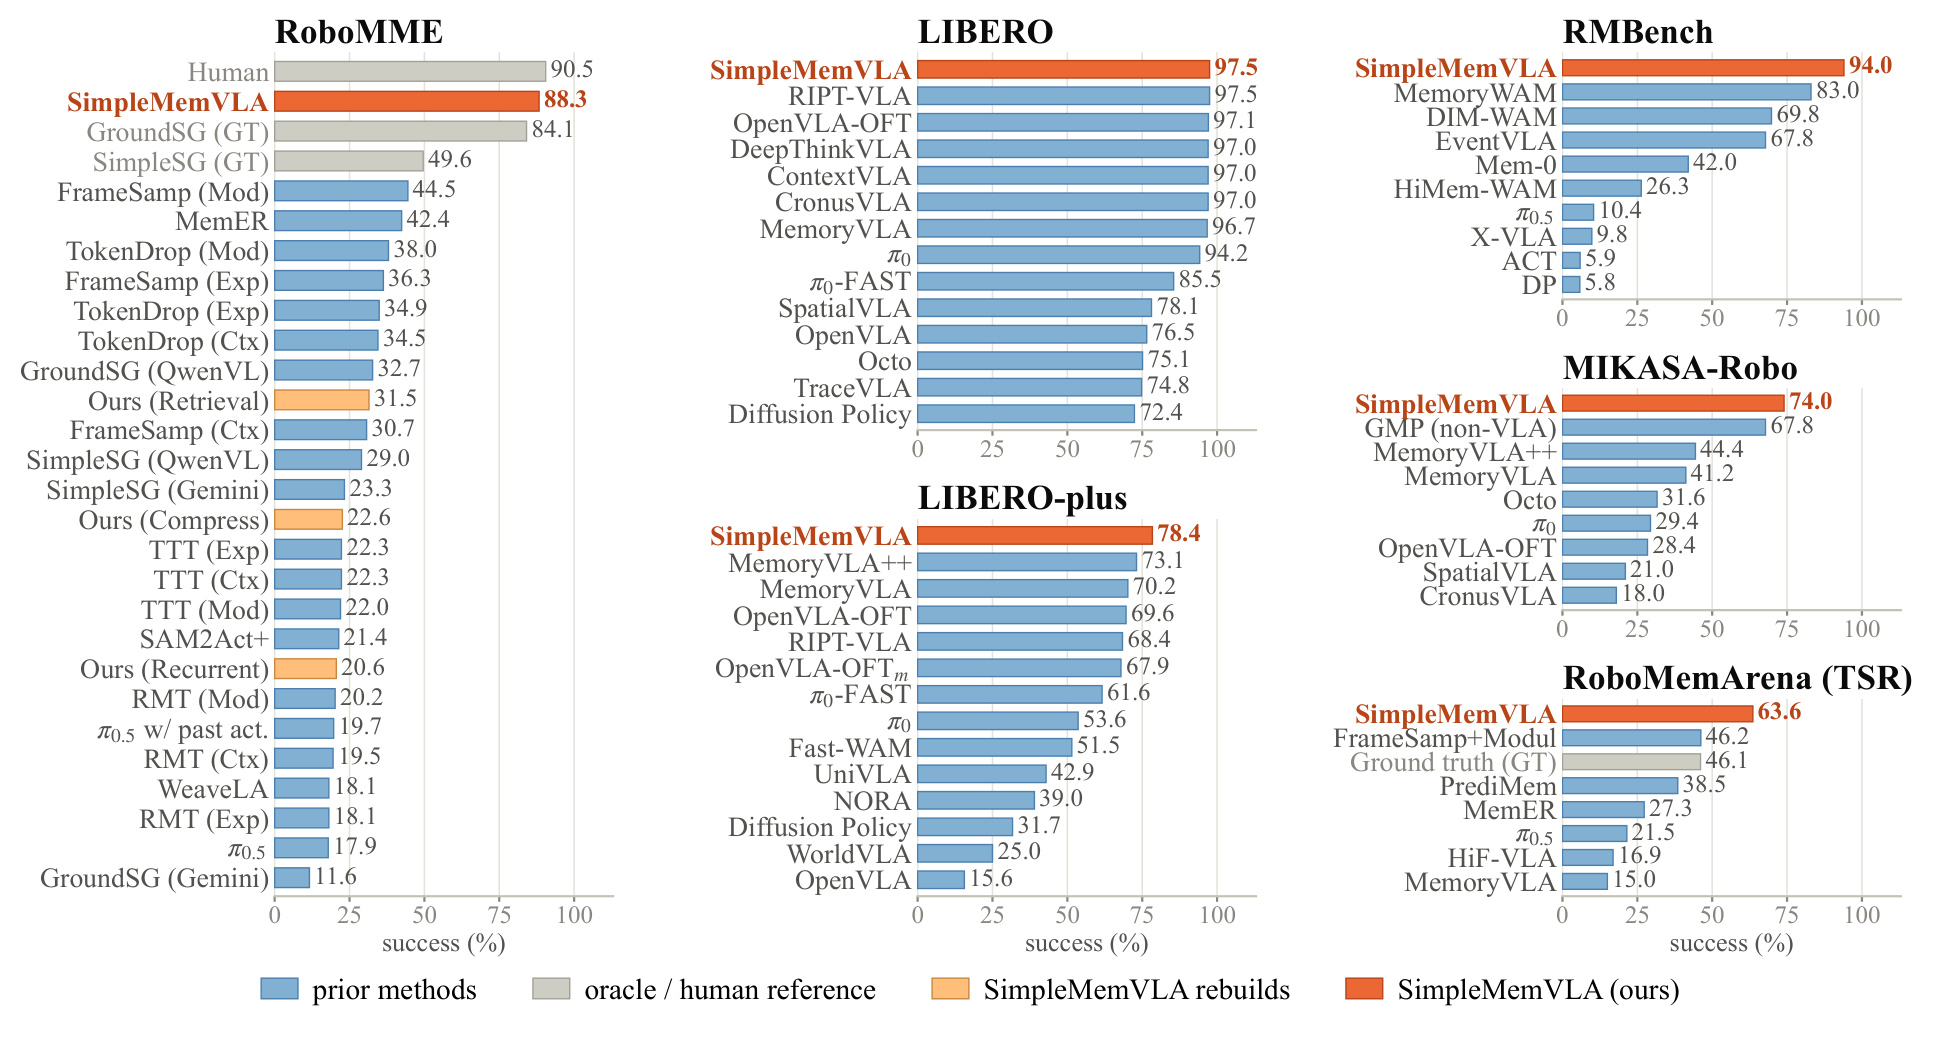
| Benchmark | SimpleMemVLA | Prior SOTA | Cải thiện |
|---|---|---|---|
| RMBench | 94.0% | 83.0% | +11.0 pts |
| RoboMME | 88.3% | 44.6% | +43.7 pts |
| MIKASA-Robo | 74.0% | 44.4% | +29.6 pts |
| RoboMemArena | 63.6% TSR | 46.2% | +17.4 pts |
| LIBERO | 97.5% | 97.5% | Ngang nhau |
| LIBERO-Plus (zero-shot) | 78.4% | 73.1% | +5.3 pts |
Điểm đáng chú ý nhất: trên RoboMME, SimpleMemVLA đạt 88.3% — vượt qua cả GT-oracle baseline ở 84.1% (oracle có ground-truth state của môi trường). Điều này gợi ý model đã học khai thác video history tốt hơn cả việc nhìn thấy đáp án trực tiếp.
Cải thiện +43.7 pts trên RoboMME là lớn nhất trong lịch sử benchmark này — và nó đến từ việc thay memory interface, không thay backbone hay tăng data.
Cài đặt và Chạy
Yêu cầu hệ thống
Python 3.10
CUDA GPU với flash-attention support
PyTorch 2.4.1 (do tương thích SAPIEN simulator)
Tạo môi trường và cài đặt dependencies
Mỗi benchmark có conda environment riêng vì xung đột SAPIEN version:
conda create -n simplememvla-rmbench python=3.10 -y
conda activate simplememvla-rmbench
pip install -r requirements.txt

# Cài fast-path kernels (bắt buộc cho training và eval)
bash scripts/install/install_fast_path.sh

# Cài simulator cho benchmark cụ thể
bash scripts/install/install_rmbench_sim.sh
# Thay "rmbench" bằng: robomme | mikasa | robomemarena | libero
Download checkpoint đã train sẵn
# RMBench checkpoint
huggingface-cli download yinchenghust/simplememvla_rmbench \
  --local-dir checkpoints/simplememvla_rmbench

# ModelScope (nếu ở Trung Quốc / truy cập HuggingFace chậm)
modelscope download yinchenghust/simplememvla_rmbench \
  --local_dir checkpoints/simplememvla_rmbench
Checkpoint tự-contained: bao gồm model weights, config, tokenizer và dataset statistics. Rebuild được toàn bộ training pipeline chính xác từ config.json.
Training từ đầu
# Chạy training — chọn benchmark
bash scripts/train.sh rmbench
# Hoặc: robomme | mikasa | robomemarena | libero
Override defaults bằng environment variables:
HISTORY_VIDEO_SEC=60 \
GPUS_PER_NODE=8 \
PER_DEVICE_BATCH=2 \
  bash scripts/train.sh robomme
Cấu hình training mặc định:
- Optimizer: AdamW với split learning rate (backbone vs action head)
- Schedule: 1000-step warmup + cosine decay
- DeepSpeed: ZeRO-2 mặc định
- History window: 60 giây (đổi qua
HISTORY_VIDEO_SEC)
Evaluation (closed-loop với simulator)
CHECKPOINT=checkpoints/simplememvla_rmbench \
NUM_GPUS=8 \
  bash scripts/eval_rmbench.sh
Evaluation (open-loop, không cần simulator)
Chạy nhanh hơn để kiểm tra action L1 loss và sub-task accuracy:
bash scripts/eval_openloop.sh rmbench
Demo Robot Thực tế
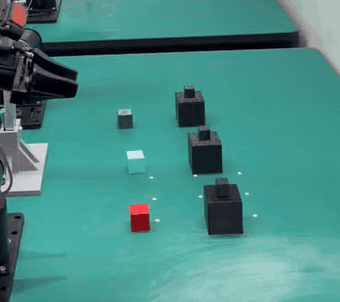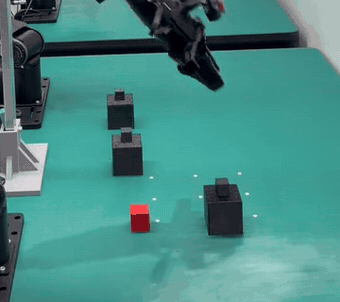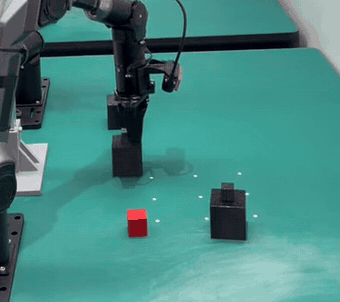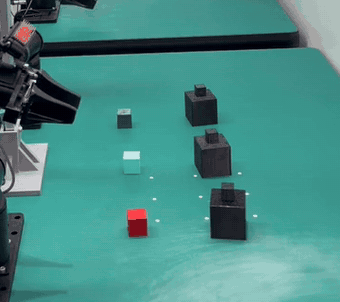
Nhóm tác giả deploy SimpleMemVLA trên robot dual-arm thực với task Cover Blocks:
- Robot phải đặt cover lên 3 khối theo thứ tự, sau đó gỡ ra theo đúng thứ tự ngược lại (đỏ → xanh lá → xanh dương)
- Thứ tự gỡ không thể suy ra từ layout hiện tại — chỉ có thể suy ra từ lịch sử video từ 52–98 giây trước
- 3 rollout tự động trên 3 layout khác nhau
Kết quả thực tế:
- Cover Blocks: 58.3% success rate
- Put Back Block: 70.0% success rate
Phân tích causal intervention xác nhận: các frame quyết định hành vi nằm ở 52–98 giây trước thời điểm quyết định. Model thực sự đọc và sử dụng lịch sử dài — không phải shortcut từ vị trí vật thể hiện tại.
So sánh với Các Phương pháp Memory Khác
So sánh kỹ thuật với các VLA memory approach liên quan:
| Phương pháp | Cơ chế | Mạnh | Yếu |
|---|---|---|---|
| SimpleMemVLA | Native video context | Không mất thông tin, tận dụng VLM pretraining | Giới hạn context window |
| μVLA | Recurrent memory token | Latency thấp, memory nhỏ | Lossy, gradient khó học |
| NativeMEM | 1 token/frame compression | Memory footprint nhỏ gọn | Mất chi tiết spatial |
| MemoryVLA++ | World model + imagination | Generalization tốt | Kiến trúc phức tạp hơn |
SimpleMemVLA cũng hỗ trợ Sliding Window Attention (SWA) cho lịch sử dài hơn mà không để context window tăng không giới hạn — hữu ích khi deploy với constraint memory GPU.
Để so sánh chi tiết với μVLA về recurrent memory, xem μVLA: Recurrent Memory Token cho Manipulation Partially Observable. Với hướng world model, xem MemoryVLA++: World Model và Imagination cho VLA.
Bài học Kỹ thuật Từ Paper Này
Paper SimpleMemVLA dạy một nguyên tắc thiết kế AI quan trọng: đừng tạo ra abstraction mới khi component đã có đủ năng lực — hãy dùng đúng cách.
Retrieval, compression, recurrent state đều là câu trả lời cho câu hỏi: "làm thế nào để backbone cũ xử lý được lịch sử dài?". Khi backbone mới (modern VLM như Qwen3.5-4B) đã được train trên video với timestamp, câu hỏi đó không còn đúng nữa. Backbone đã có khả năng đó rồi. Việc cần làm là đưa dữ liệu đúng định dạng — không phải tạo adapter cho định dạng sai.
Đây là lý do SimpleMemVLA có thể đánh bại các hệ thống phức tạp hơn nhiều chỉ với một thay đổi nhỏ về input pipeline.
Xem thêm cách BridgeVLA+ tiếp cận memory bài toán manipulation 3D tại BridgeVLA+: Spatio-Temporal Memory cho 3D Manipulation.
Kết luận
SimpleMemVLA chứng minh rằng simplicity đúng chỗ là nghiên cứu tốt: bằng cách loại bỏ module memory phức tạp và tận dụng năng lực video processing sẵn có của Qwen3.5-4B, paper đạt state-of-the-art trên 4 trong số 4 memory-centric benchmark với margin rất lớn — đặc biệt +43.7 pts trên RoboMME so với prior best. Latency vẫn gần single-frame nhờ streaming inference với KV cache prefix.
Đây là hướng nghiên cứu quan trọng: khi VLM backbone ngày càng mạnh hơn, nhiều "vấn đề" trong robot learning sẽ được giải bằng cách đưa đúng input cho backbone thay vì tạo thêm module chuyên dụng.
Paper, code và checkpoint đã public tại github.com/hongzefu/SimpleMemVLA — MIT license.