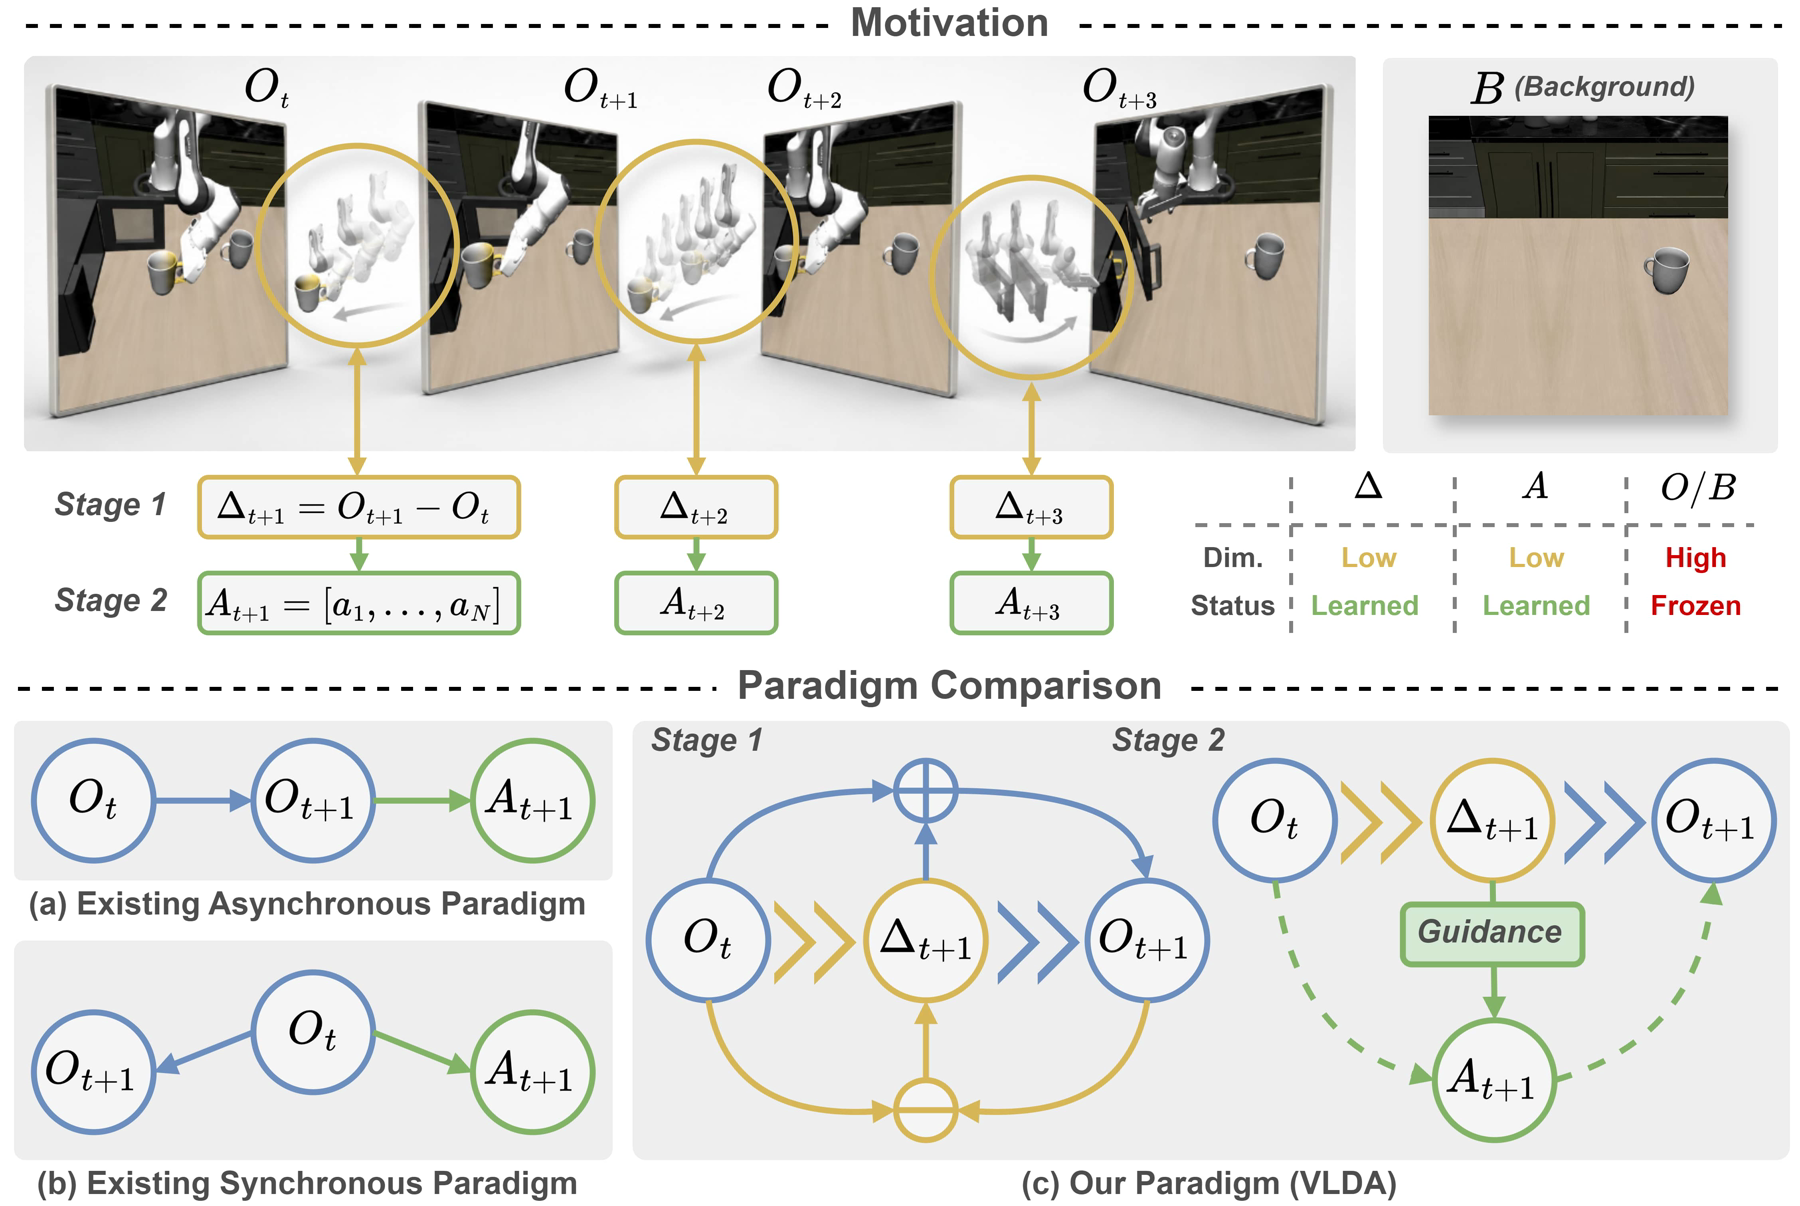
Một robot được yêu cầu đặt chai vào thùng không cần dự đoán lại màu tường, vân bàn và mọi pixel của căn phòng. Nó cần hiểu những thay đổi quyết định: gripper tiến đến chai, tạo tiếp xúc, nâng chai rồi chuyển chai vào thùng. LoongForge-VLDA biến phần “điều gì cần thay đổi” thành một biến trung gian gọi là Delta, sau đó dùng Delta dẫn hướng sinh action.
Công trình gốc là Vision-Language-Delta-Action: Learning Compact Deltas as Actionable Transition Interfaces for Robotic Manipulation, Lingsen Zhang và cộng sự, arXiv 2026. Bài này dựa trên project page chính thức, cookbook mã nguồn mở và checkpoint LIBERO, đối chiếu ngày 21/10/2026.
Lộ trình dành cho beginner là hiểu kiến trúc, chạy checkpoint trên một task, đánh giá đủ bốn suite rồi mới training. Các lệnh dưới đây được đối chiếu tài liệu và cấu hình công khai; đây không phải báo cáo vnrobo đã tự chạy training hay tái lập benchmark trên GPU.
1. Delta giải quyết vấn đề gì?
Một VLA thông thường nhận ảnh, instruction và robot state, rồi dự đoán một action chunk: chuỗi hành động liên tiếp thay vì một hành động đơn lẻ. Với LIBERO, checkpoint VLDA phát hành dùng chunk dài 10 bước, mỗi bước có 7 chiều action. State đầu vào có 8 chiều; không được suy ra rằng state và action phải có cùng số chiều.
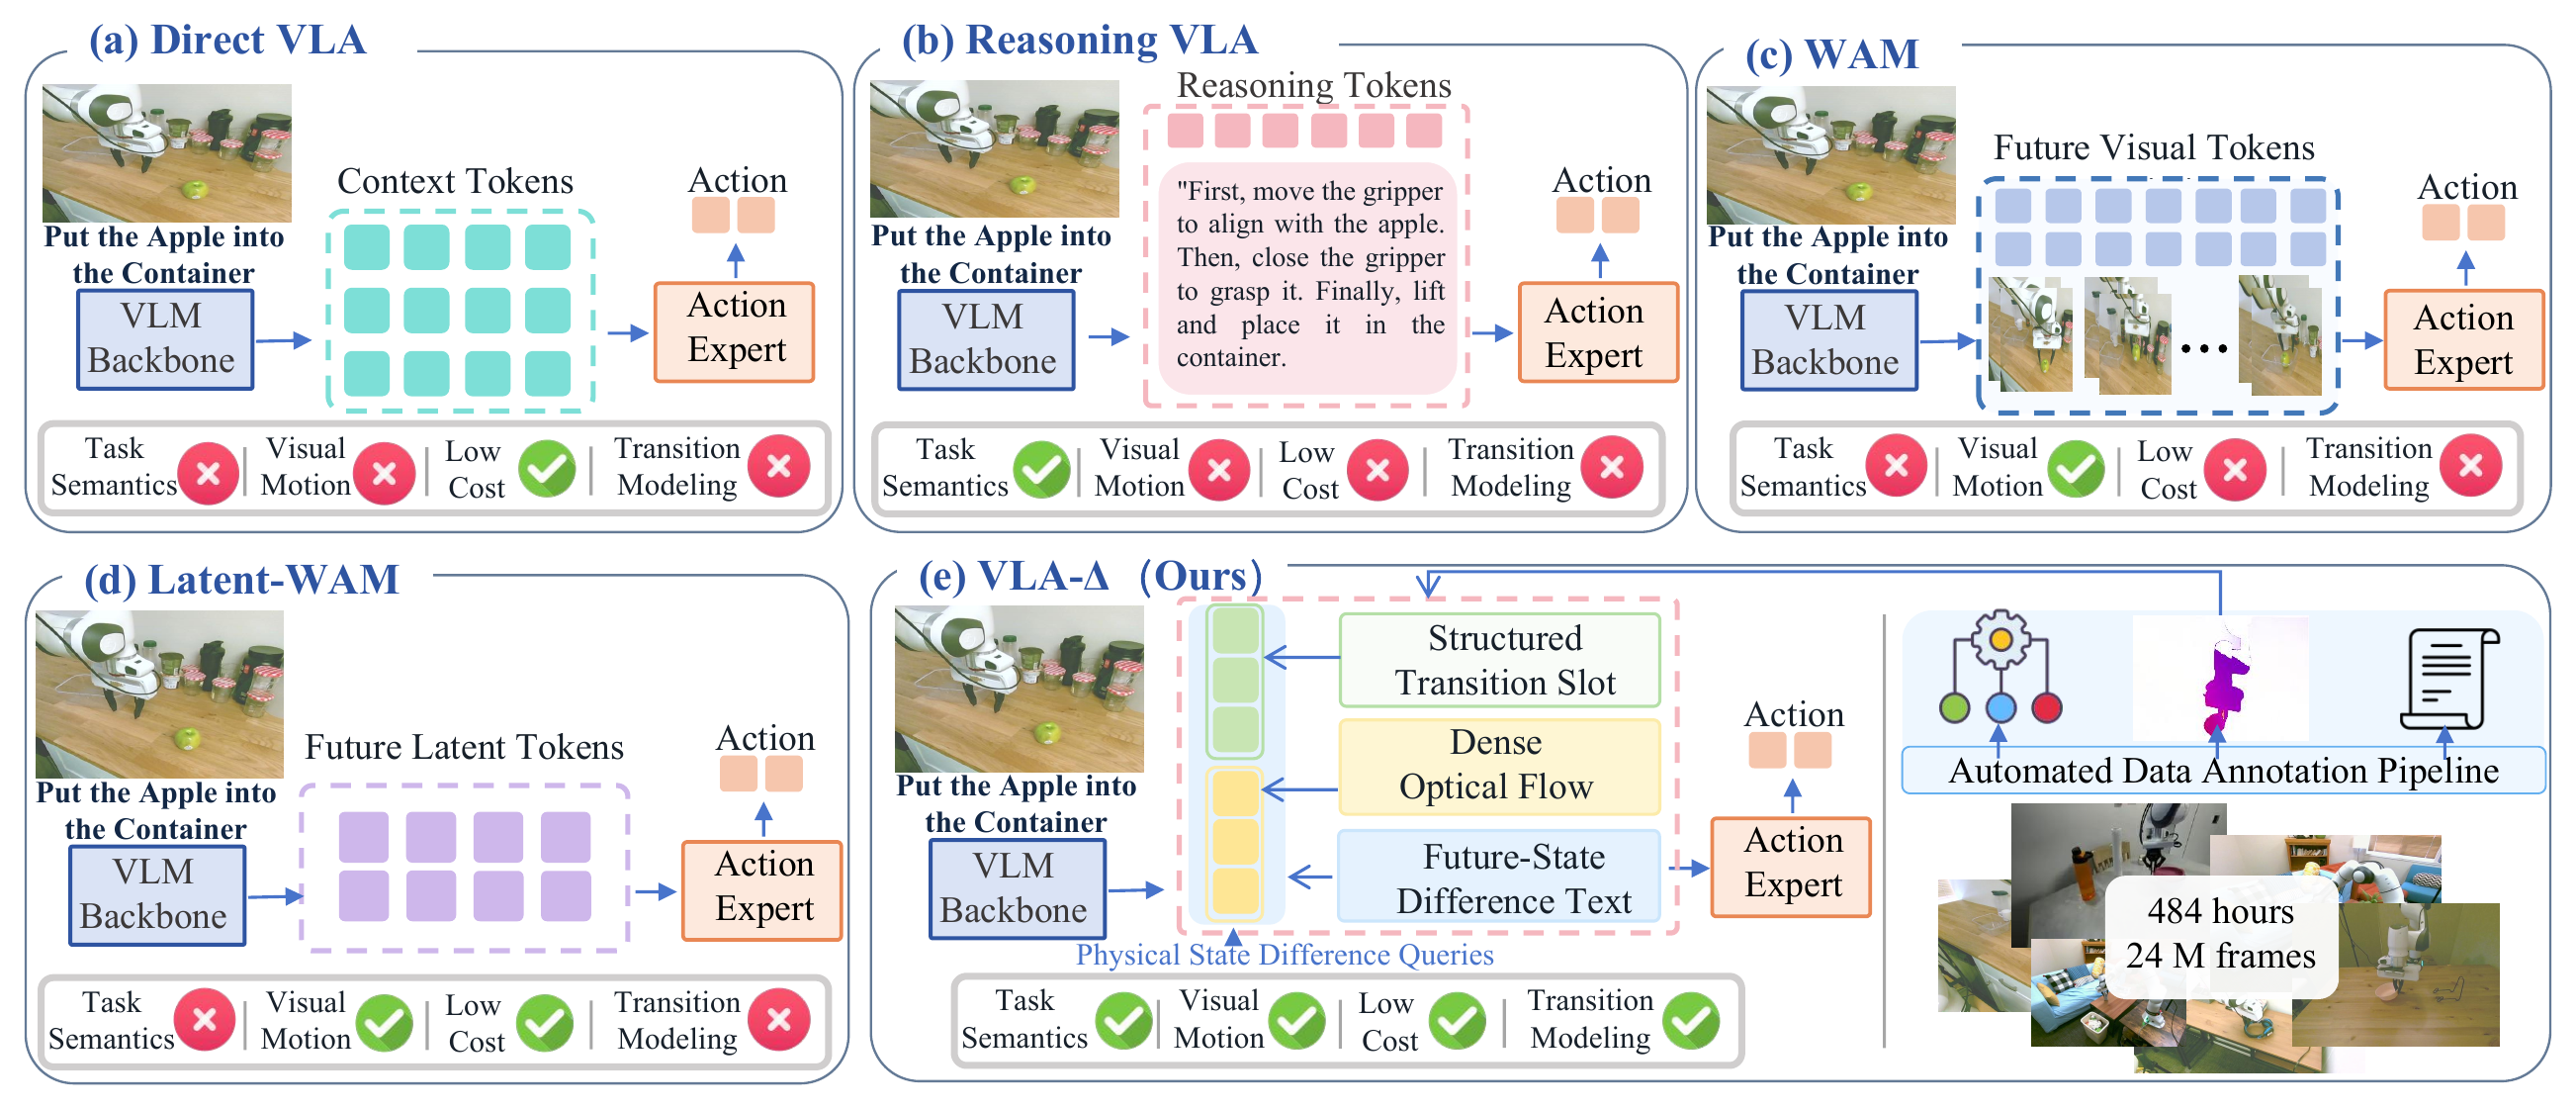
Trong cách học trực tiếp, policy phải tự tìm cầu nối giữa “tôi nhìn thấy gì” và “motor cần làm gì”. Một hướng khác là world-action model dự đoán tương lai để hỗ trợ điều khiển. Tuy nhiên, tái tạo đầy đủ tương lai có thể dành quá nhiều năng lực cho những chi tiết không giúp hoàn thành task.
VLDA tách bài toán thành ba phần: understanding → transition → execution. Vision-language backbone hiểu cảnh và yêu cầu. World Expert dự đoán Delta biểu diễn biến đổi sắp xảy ra. Action Expert chuyển tín hiệu đó thành action chunk. Delta là representation học được trong latent space, không phải trực tiếp vector độ dịch chuyển Cartesian, cũng không phải danh sách câu lệnh được viết bằng tay.
Nếu cần nền tảng về ảnh, instruction và action head, xem phân tích OpenVLA. Điểm mới của VLDA là tạo một giao diện transition có supervision riêng và thực sự đưa giao diện này vào quá trình sinh action.
2. Kiến trúc: backbone, World Expert và Action Expert
Theo phụ lục paper, VLDA mở rộng π0.5 với vision-language backbone khoảng 2B được khởi tạo từ PaliGemma và Action Expert Gemma khoảng 300M. World Expert có kiến trúc và dung lượng tương đương Action Expert, nhưng được khởi tạo độc lập từ đầu. Vì vậy, không nên mô tả đây là chỉ thêm một linear head nhỏ vào policy có sẵn.
Trong training, V-JEPA 2 ViT-g/16 tạo feature cho ảnh hiện tại và ảnh tương lai. Online encoder được cập nhật bằng gradient; teacher encoder được cập nhật bằng exponential moving average, hay EMA. Teacher thay đổi chậm giúp target ổn định hơn khi online encoder đang học. Nhánh transition dùng primary camera ở 256 × 256; backbone policy vẫn nhận các camera được cấu hình ở 224 × 224, gồm camera ngoài và wrist camera trong checkpoint LIBERO.
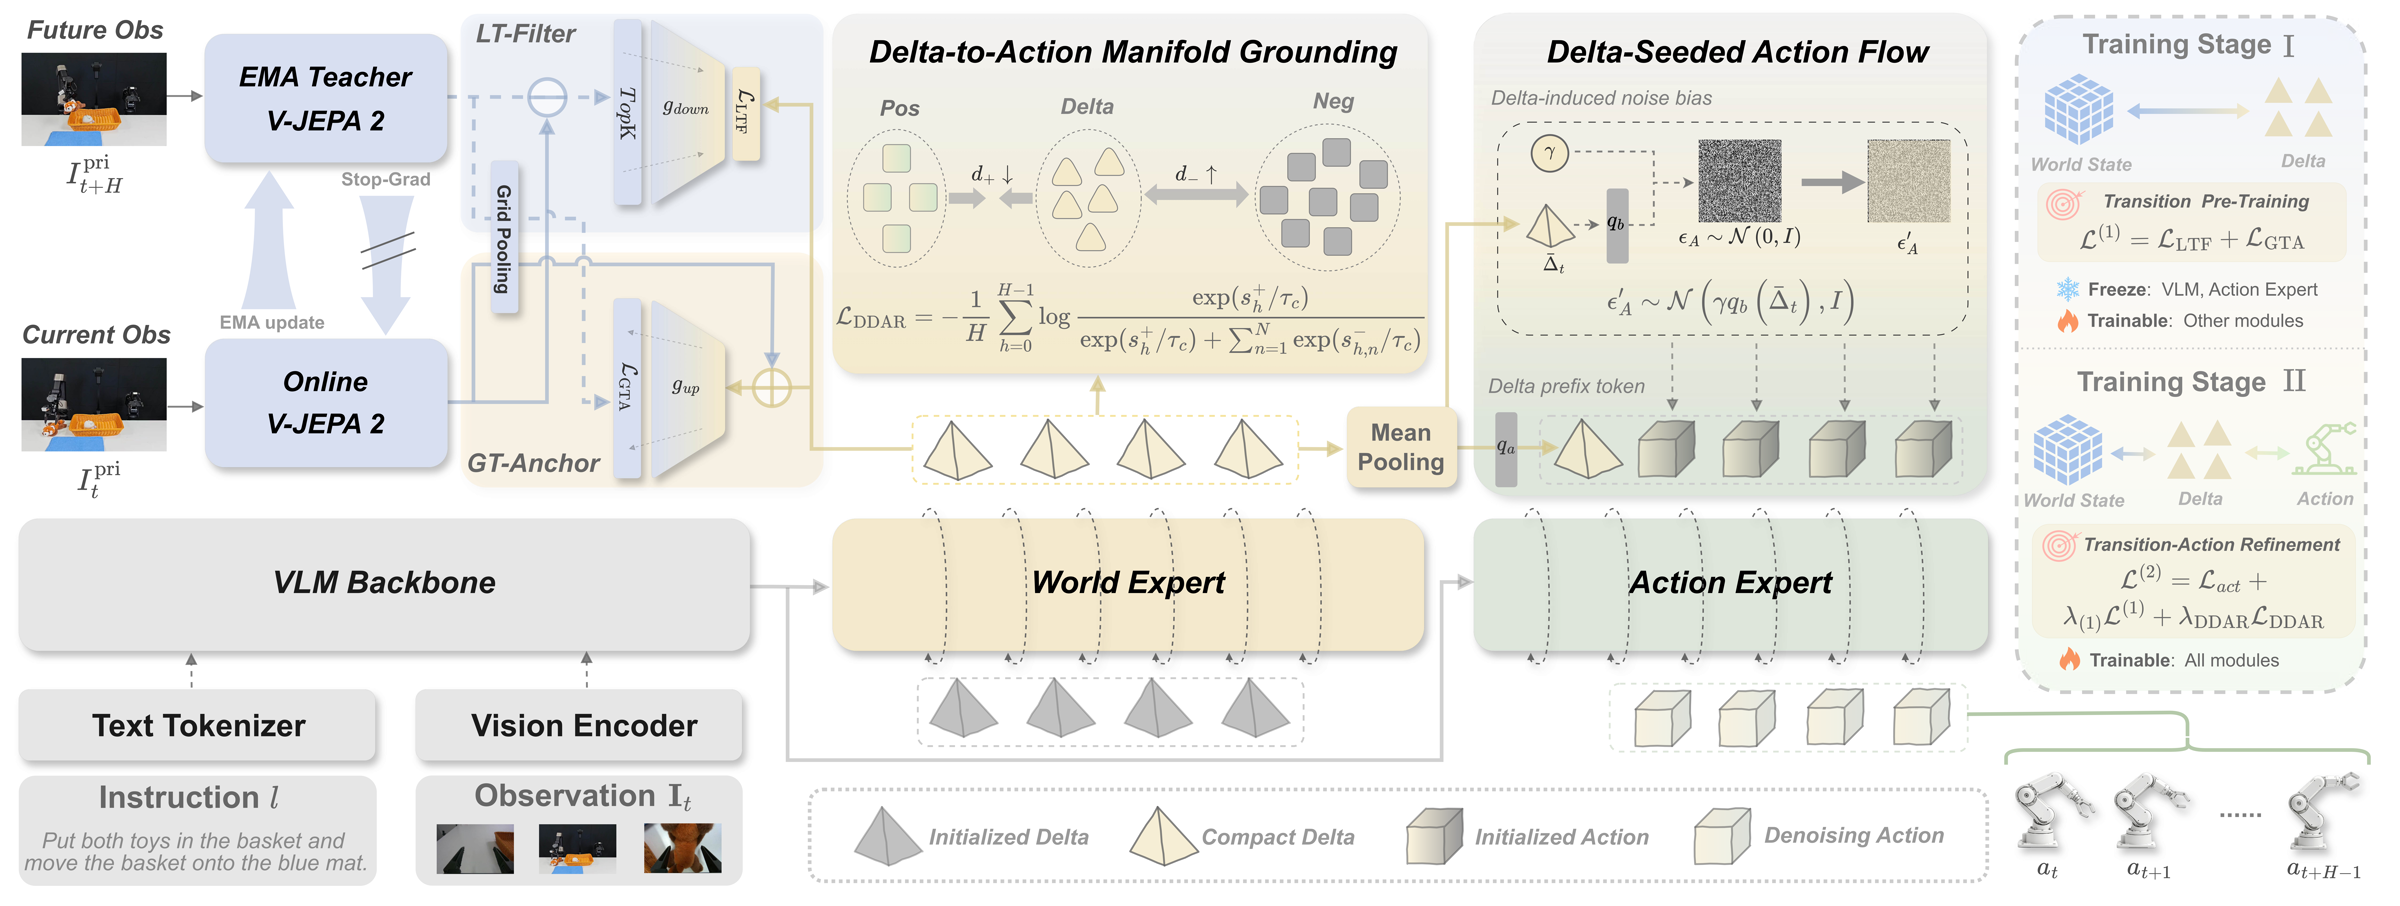
Có thể đọc sơ đồ theo hai luồng. Luồng supervision chỉ tồn tại khi training, dùng quan sát tương lai để xây target. Luồng điều khiển chạy khi inference, chỉ nhận quan sát hiện tại và instruction để sinh Delta rồi action. Không có việc đưa ảnh tương lai của episode đang đánh giá vào policy.
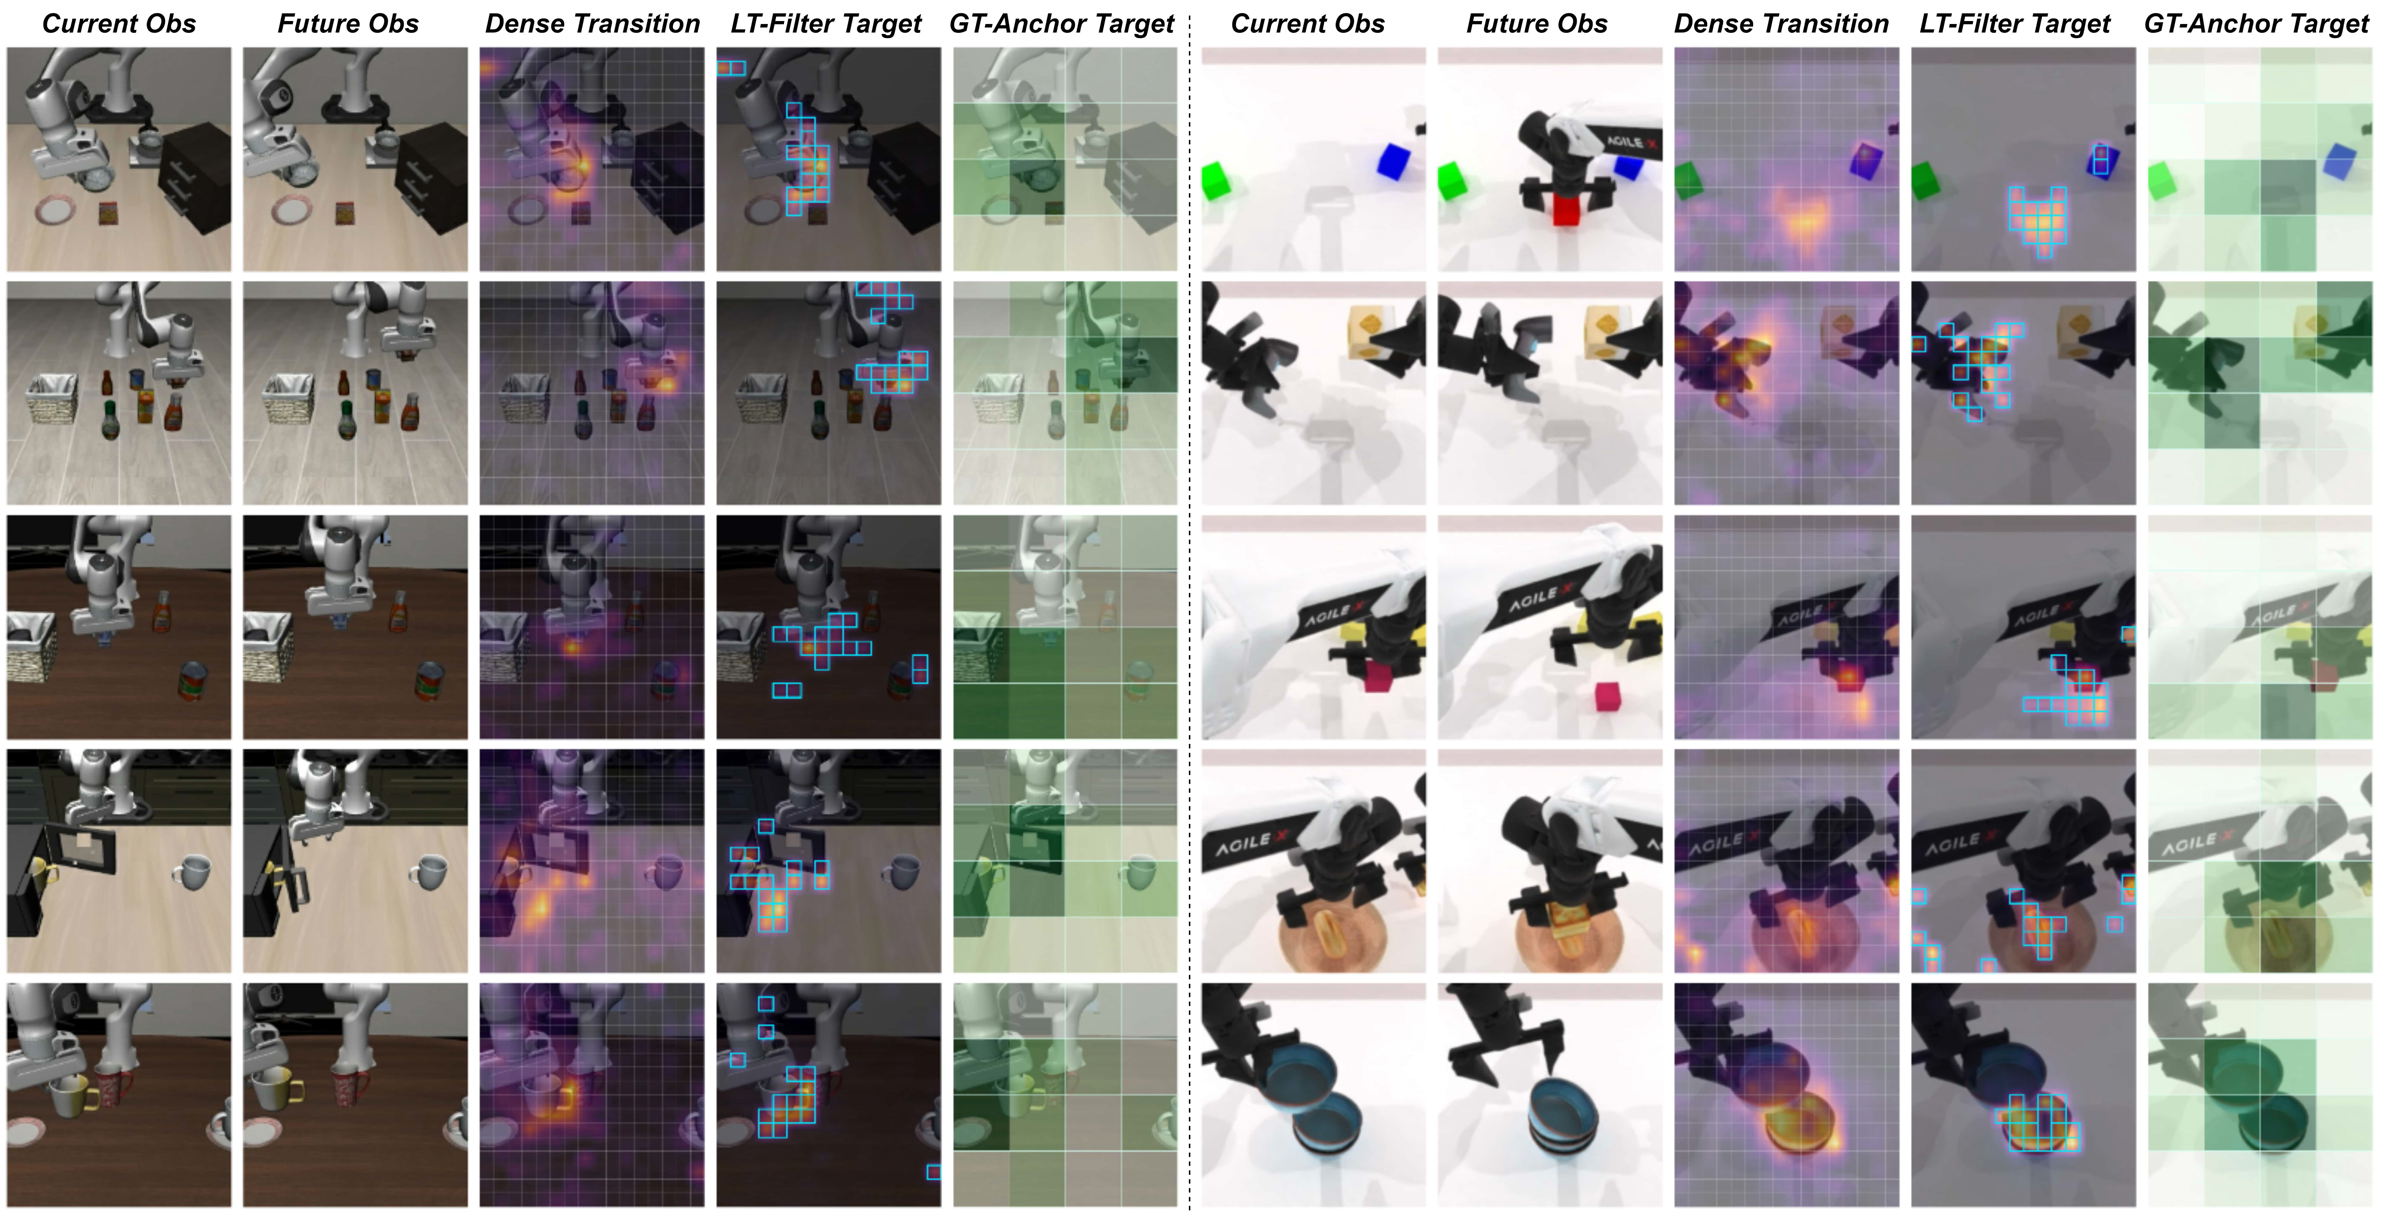
LT-Filter: chọn thay đổi cục bộ
Local Transition Filter lấy hiệu feature giữa tương lai từ teacher và hiện tại từ online encoder. Những spatial token có độ lớn thay đổi cao nhất được chọn để tạo target Delta. Paper chính dùng top-64 token và latent dimension 256.
Vì tập token được chọn không có thứ tự ngữ nghĩa cố định, ép token thứ nhất dự đoán khớp token thứ nhất của target là một ràng buộc tùy tiện. VLDA dùng Sinkhorn optimal transport để ghép mềm hai tập token. Beginner có thể hình dung đây là tìm cách phân phối sự tương ứng hợp lý giữa các vùng thay đổi, thay vì buộc từng vị trí trong hai danh sách khớp cứng nhau.
GT-Anchor: giữ hướng biến đổi toàn cảnh
Chỉ tập trung vùng chuyển động mạnh có thể bỏ mất bối cảnh. Global Transition Anchor dùng pooled feature của hiện tại và tương lai để tạo một mô tả thô về hướng thay đổi toàn cảnh. Delta dự đoán được project về visual feature space rồi so khớp với anchor này. Đây vẫn là học transition; không phải yêu cầu tái tạo toàn bộ ảnh tương lai.
DDAR: biến Delta thành tín hiệu điều khiển
Delta-Driven Action Refinement gồm hai thành phần. Delta-to-Action Manifold Grounding, viết tắt DAMG, dùng InfoNCE để alignment Delta với action thực trong chunk. Action ở vùng thời gian không chồng lấn của cùng trajectory đóng vai trò negative samples. Mục tiêu là làm Delta liên quan đến hành động thực hiện được, thay vì chỉ phản ánh chuyển động thị giác.
Delta-Seeded Action Flow, viết tắt DSAF, đưa Delta vào Action Expert bằng hai đường: một bias dịch chuyển noise khởi tạo trong action space, và một prefix token cung cấp context trong denoising. Action flow vì thế bắt đầu với tín hiệu về transition mong muốn, thay vì noise hoàn toàn không mang định hướng của Delta.
3. Phân biệt paper với recipe công khai
Đây là chi tiết quan trọng trước khi chạy. Phụ lục paper và cookbook/checkpoint mở có một số thông số khác nhau:
| Thông số | Paper | Cookbook/checkpoint mở |
|---|---|---|
| Delta tokens | 64 | 16 trong checkpoint và YAML eval |
| Global batch Stage 1 | 48 | 96 trong launcher hiện tại |
| Alignment weight Stage 2 | 0.1 | 0.01 |
| EMA momentum | 0.99925 | 0.9985005625 |
| LIBERO trung bình | 98.5% trong bảng paper | 98.00% qua 10 lần eval checkpoint |
Không đổi delta_token_num thành 64 chỉ vì thấy con số đó trong paper khi đang load checkpoint 16 token. Hãy giữ model trong YAML phù hợp với vlda_config.json của checkpoint. Muốn tái lập đúng cấu hình paper là một thí nghiệm khác, cần kiểm soát toàn bộ training recipe, không chỉ sửa một trường.
Một công trình có tên gần giống là VLA-Δ học physical state transition. Đó là dự án khác; không lấy checkpoint, script hoặc kết quả của VLA-Δ gán cho LoongForge-VLDA.
4. Chuẩn bị máy và môi trường training/model server
Tài liệu LoongForge khuyến nghị Linux và NVIDIA GPU Ampere/Hopper hoặc mới hơn. Recipe training được công bố dùng 8 GPU; cookbook ghi các run batch 128 gần đây dùng 8 GPU, mỗi GPU 80 GB. Một GPU cho inference không đồng nghĩa một GPU bất kỳ đủ để training recipe này. Tài liệu được dẫn không xác lập mức VRAM tối thiểu cho mọi trường hợp inference.
Cài uv theo hướng dẫn chính thức của công cụ nếu máy chưa có. Bắt đầu từ source LoongForge, dùng Python 3.12 riêng cho VLDA:
git clone --recurse-submodules https://github.com/baidu-baige/LoongForge.git
cd LoongForge
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e ".[gpu]"
Installation guide của LoongForge còn hướng dẫn chuẩn bị TransformerEngine bằng python setup_env.py --te-tag v2.9 cho source install GPU. Theo đầy đủ phần setup tương ứng nếu môi trường của bạn cần bước biên dịch này; không coi vài gói Python dưới đây là thay thế toàn bộ base installation.
Sau base installation, cookbook pin các dependency VLDA như sau:
uv pip install --python .venv/bin/python \
  torch==2.8.0 torchvision==0.23.0 torchcodec==0.7.0 \
  --index-url https://download.pytorch.org/whl/cu128
uv pip install --python .venv/bin/python \
  lerobot==0.5.0 transformers==5.3.0 torchdata==0.11.0 \
  sentencepiece timm==1.0.3 pandas pyarrow tensorboard \
  websockets==15.0.1 msgpack
.venv/bin/python -c 'import torch; print(torch.__version__, torch.version.cuda, torch.cuda.is_available())'
Kết quả mong đợi là 2.8.0+cu128 12.8 True. CUDA wheels không nâng cấp NVIDIA driver của hệ điều hành. Nếu False, xử lý driver, quyền truy cập GPU/container và môi trường Python trước khi tải model lớn. Các bước đầu training còn compile và autotune nên chậm hơn trạng thái chạy ổn định.
5. Chạy checkpoint trước: tải weights và tạo môi trường LIBERO
Đường ngắn nhất để thử là checkpoint Stage 2 đã phát hành:
.venv/bin/hf download LoongForge/LoongForge-VLDA-LIBERO \
  --local-dir models/LoongForge-VLDA-LIBERO
mkdir -p models
curl -fL https://storage.googleapis.com/big_vision/paligemma_tokenizer.model \
  -o models/paligemma_tokenizer.model
Giữ nguyên bộ model.safetensors, vlda_config.json và assets/norm_stats.json. Tokenizer được tải riêng. Model card nói bản phát hành không chứa optimizer state để resume training gốc, nên đừng nhầm tải weights với khôi phục nguyên trạng một run.
LIBERO có stack mô phỏng riêng; cookbook tách nó khỏi Python 3.12 của server. Tạo môi trường Python 3.10, chạy từ LoongForge root:
uv venv --python 3.10 .venv-libero
git clone https://github.com/Lifelong-Robot-Learning/LIBERO.git third_party/LIBERO
uv pip install --python .venv-libero/bin/python \
  torch==2.1.2 numpy==1.24.4 robosuite==1.4.0 mujoco==3.2.3 \
  gym==0.25.2 opencv-python==4.6.0.66 \
  imageio==2.35.1 imageio-ffmpeg==0.5.1 \
  websockets==13.1 msgpack==1.1.1 PyYAML==6.0.3 \
  bddl==1.0.1 easydict==1.9 cloudpickle==2.1.0 \
  matplotlib==3.5.3 future==0.18.2 termcolor==2.5.0
uv pip install --python .venv-libero/bin/python \
  --no-deps -e third_party/LIBERO
Môi trường này cung cấp task definitions, assets và initial states. Eval mặc định dùng EGL offscreen rendering. Máy hoặc container phải nhìn thấy NVIDIA EGL graphics libraries, không chỉ CUDA compute libraries. Nếu dùng OSMesa, đổi cả env.mujoco_gl và env.pyopengl_platform thành osmesa, đồng thời cài thư viện hệ thống tương ứng như libosmesa6 trên Ubuntu, theo cookbook.
6. Inference: sửa YAML và chạy một episode
Mở cookbook/loongforge-vlda/eval/configs/libero/libero.yaml. Điền đường dẫn tuyệt đối cho server.python, server.ckpt_path, server.dataset_statistics_path, server.tokenizer_path, server.loongforge_root và các đường dẫn repository trong env. Dùng checkpoint vừa tải làm ckpt_path; statistics phải là file đi kèm checkpoint đó. Điền env.libero_config_path cho cấu hình LIBERO cục bộ và run.output_dir cho kết quả.
Để smoke test, đặt benchmark.max_tasks: 1, benchmark.episodes_per_task: 1 và chỉ giữ entry libero_object trong sweep. Đây là chỉnh YAML có sẵn; không tạo file YAML chỉ chứa vài trường rồi tưởng các trường còn lại tự được bổ sung.
CUDA_VISIBLE_DEVICES=0 \
BENCHMARK_PYTHON="$PWD/.venv-libero/bin/python" \
bash cookbook/loongforge-vlda/eval/run_libero_eval.sh
Launcher quản lý policy server và LIBERO client, nên chỉ cần một terminal. Server dùng .venv, client dùng .venv-libero. Trong inference, World Expert dùng 3 bước explicit Euler để sinh Delta; Action Expert dùng 10 bước để sinh action chunk. Những bước tích phân này khác với số bước điều khiển trong chunk và cũng không phải FPS của robot.
Sau smoke test, khôi phục max_tasks: 0, episodes_per_task: 50 và đủ bốn suite libero_spatial, libero_object, libero_goal, libero_10. Mỗi suite có 10 task × 50 episode, tức 500 episode; một lượt đủ bốn suite là 2.000 episode. Đọc results.jsonl, summary.csv, suite_summary.csv, policy_server.log và rollout artifacts trong thư mục kết quả.
Theo paper, inference không cần hai V-JEPA encoders và các module chỉ phục vụ target/alignment. Tuy nhiên checkpoint công khai vẫn chứa weights liên quan; hãy dùng factory và launcher được cung cấp, không tự xóa tensor khỏi checkpoint. YAML eval mặc định tắt compilation, tắt gradient checkpointing và dùng eager attention. Client seed mặc định là 7, nhưng cookbook ghi server seed chưa được cố định; đây là một nguồn biến động cần ghi vào báo cáo.
7. Chuẩn bị dataset cho training
Reader VLDA yêu cầu LeRobot v2 với embedded images. Một dataset LeRobot v3 hoặc video-backed có tên gần giống không phải đầu vào thay thế tương đương. Cookbook pin revision:
.venv/bin/hf download physical-intelligence/libero \
  --repo-type dataset \
  --revision a4336d589d589045d1c56423ffdf3b88a0e19b1f \
  --local-dir datasets/libero
Kiểm tra meta/info.json, meta/episodes.jsonl, meta/tasks.jsonl và data/chunk-*/episode_*.parquet. Các cột cần có là image, wrist_image, state, actions. Quantile normalization yêu cầu q01 và q99 cho cả state lẫn action; mean/std/min/max trong metadata chưa đủ.
Nếu training mới, đoạn sau tính statistics theo cách cookbook minh họa. Nó đọc toàn bộ hai cột vào RAM, vì vậy cần tính dung lượng trước nếu chuyển sang dataset lớn hơn:
DATA_PATH="$PWD/datasets/libero" .venv/bin/python - <<'PY'
import json
import os
from pathlib import Path
import numpy as np
import pyarrow as pa
import pyarrow.parquet as pq

root = Path(os.environ["DATA_PATH"])
files = sorted((root / "data").glob("chunk-*/episode_*.parquet"))
if not files:
    raise RuntimeError("No episode parquet files found")
table = pa.concat_tables([
    pq.read_table(p, columns=["state", "actions"]) for p in files
])
stats = {}
for key in ("state", "actions"):
    values = np.asarray(table[key].to_pylist(), dtype=np.float64)
    q01, q99 = np.quantile(values, [0.01, 0.99], axis=0)
    stats[key] = {
        "mean": values.mean(axis=0).tolist(),
        "std": values.std(axis=0).tolist(),
        "q01": q01.tolist(), "q99": q99.tolist(),
    }
(root / "norm_stats.json").write_text(
    json.dumps({"norm_stats": stats}, indent=2) + "\n"
)
PY
Chạy checkpoint có sẵn thì dùng statistics gốc của checkpoint, không tính lại rồi thay vào. Cùng một output chuẩn hóa có thể trở thành action vật lý khác nếu dùng quantile khác. Đây là lý do policy vẫn trả tensor đúng shape nhưng rollout có thể sai hoàn toàn.
8. Training hai giai đoạn
Stage 1 cần π0.5 base ở định dạng OpenPI PyTorch, tokenizer và V-JEPA 2 vitg.pt gốc chứa cả encoder lẫn target_encoder. Nếu base weights ở JAX, theo OpenPI PyTorch support, dùng môi trường chuyển đổi riêng và converter chính thức. Cookbook dùng --config_name pi05_libero để chọn kiến trúc, nhưng input vẫn phải là pi05_base, không tự thay bằng checkpoint đã fine-tune.
Đặt base weights tại models/pi05_base_pytorch/model.safetensors, rồi tải teacher initializer:
mkdir -p models/vjepa2
curl -fL https://dl.fbaipublicfiles.com/vjepa2/vitg.pt \
  -o models/vjepa2/vitg.pt
Stage 1 đóng băng PaliGemma và Action Expert, học delta_loss + future_loss trong 10.000 optimizer updates. Chạy theo launcher hiện tại:
CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 \
DATA_PATH="$PWD/datasets/libero" \
NORM_STATS_PATH="$PWD/datasets/libero/norm_stats.json" \
TOKENIZER_PATH="$PWD/models/paligemma_tokenizer.model" \
CHECKPOINT_PATH="$PWD/models/pi05_base_pytorch" \
VJEPA_CHECKPOINT="$PWD/models/vjepa2/vitg.pt" \
OUTPUT_DIR="$PWD/outputs/vlda/libero_stage1" RESUME=0 \
bash cookbook/loongforge-vlda/run_vlda_8gpu_stage1.sh
Stage 2 lấy checkpoint Stage 1 và khởi tạo optimizer/schedule mới. Objective trong cookbook là action_loss + delta_loss + future_loss + 0.01 * align_loss. Nhánh action được học cùng transition regularization:
INIT_CHECKPOINT="$PWD/outputs/vlda/libero_stage1/checkpoints/steps_10000"
CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 \
DATA_PATH="$PWD/datasets/libero" \
NORM_STATS_PATH="$INIT_CHECKPOINT/assets/norm_stats.json" \
TOKENIZER_PATH="$PWD/models/paligemma_tokenizer.model" \
CHECKPOINT_PATH="$INIT_CHECKPOINT" \
OUTPUT_DIR="$PWD/outputs/vlda/libero_stage2" RESUME=0 \
bash cookbook/loongforge-vlda/run_vlda_8gpu_stage2.sh
Cookbook Stage 1 dùng global batch 96, peak LR 7e-5, warmup 500 updates. Stage 2 dùng batch 128, 60.000 updates; LR warmup lên 5e-5 trong 10.000 bước, giữ đến bước 40.000 rồi cosine decay xuống 1e-5. Gradient accumulation bằng 1, nên batch 128 trên 8 GPU là 16 mẫu/GPU. Gradient checkpointing tiết kiệm activation memory bằng tính lại; nó không đổi phép tính batch.
Theo dõi từng loss trong metrics.jsonl và TensorBoard, không chỉ tổng loss. Khi đổi số GPU, cấu hình cả GPUS_PER_NODE và CUDA_VISIBLE_DEVICES, đảm bảo global batch chia hết cho số GPU nhân accumulation. Muốn resume một run bị ngắt, dùng RESUME=1 cùng output directory và cấu hình cũ. Muốn đổi schedule thì khởi tạo run mới bằng RESUME=0; đó không còn là exact resume.
9. Kết quả và cách diễn giải
Bảng sau lấy từ paper/project page, không phải số đo của vnrobo:
| Phương pháp | Spatial | Object | Goal | Long | Trung bình |
|---|---|---|---|---|---|
| π0.5 | 98.8 | 98.2 | 98.0 | 92.4 | 96.9 |
| OpenVLA-OFT | 97.6 | 98.4 | 97.9 | 94.5 | 97.1 |
| VLA-Adapter | 97.8 | 99.2 | 97.2 | 95.0 | 97.3 |
| VLDA | 99.8 | 99.6 | 99.4 | 95.2 | 98.5 |
Tất cả là success rate phần trăm. So với π0.5, VLDA tăng 1,6 điểm phần trăm trung bình. LIBERO-Plus zero-shot đạt 84,5% so với 73,6%, tăng 10,9 điểm trên 10.030 rollouts. Nhưng ở perturbation camera, GuidedVLA đạt 73,7% và VLDA 72,4%; không được diễn giải thành thắng mọi dimension.
RoboTwin 2.0 đạt 62,9% trên 10 hard tasks được chọn, so với π0.5 là 42,7%. Trung bình đủ 50 task là 50,86% so với 43,84%. Hai phạm vi đánh giá khác nhau, không thể gọi 62,9% là kết quả toàn benchmark.
Robot thật GALAXEA R1 Lite đạt trung bình final-stage success 73,0% trên bốn task, so với π0.5 là 56,0%; mỗi task có 25 trials. AgileX Cobot Magic đạt 72,0% so với 54,0%. Đây là các task/platform trong nghiên cứu, không phải cam kết hiệu năng cho mọi robot mới.
Đối với checkpoint phát hành, cookbook báo trung bình 10 lần đánh giá là Spatial 98,94%, Object 98,66%, Goal 98,68%, Long 95,72%, trung bình 98,00%. Giá trị ±0.60 của average được định nghĩa là nửa khoảng max–min, không phải standard deviation hay confidence interval. Bốn suite dùng 500 episode/suite/lần; một episode smoke test chỉ xác nhận pipeline hoạt động, chưa chứng minh accuracy.
10. Khi gặp lỗi và khi nên dùng VLDA
Nếu model load lỗi shape, so delta_token_num, action/state dimensions và horizon với checkpoint config. Nếu simulator lỗi OpenGL, kiểm tra EGL/OSMesa và graphics libraries. Nếu server trả action nhưng robot gần như không làm đúng, kiểm tra statistics, encoding và preprocessing trước khi kết luận checkpoint kém. Nếu training không đọc được dữ liệu, xác nhận LeRobot v2 embedded images và các cột parquet.
LT-Filter dựa trên độ lớn feature transition nên chuyển động nền mạnh vẫn có thể gây nhiễu; đó là limitation được paper nêu. Horizon cố định cũng chưa mô tả hết các task có tốc độ thay đổi khác nhau. Cross-embodiment transfer là hướng nghiên cứu tiếp theo, không phải tính năng đã được chứng minh tổng quát. Bạn có thể đối chiếu cách dùng latent future trong SmolWAM trên LIBERO để hiểu lựa chọn giữa mô hình hóa future state và compact transition.
VLDA phù hợp khi bạn muốn nghiên cứu mối nối giữa hiểu cảnh và action generation, có hạ tầng training tương ứng và cần đánh giá robustness thay vì chỉ một success rate trên cảnh chuẩn. Bước thực hành đầu tiên nên là một checkpoint, một task và một rollout đọc được; sau đó mới mở rộng số episode, số suite và thí nghiệm ablation.