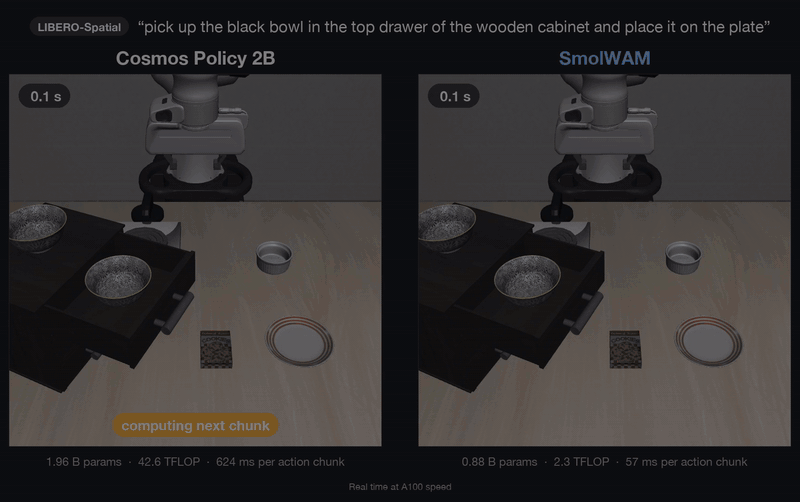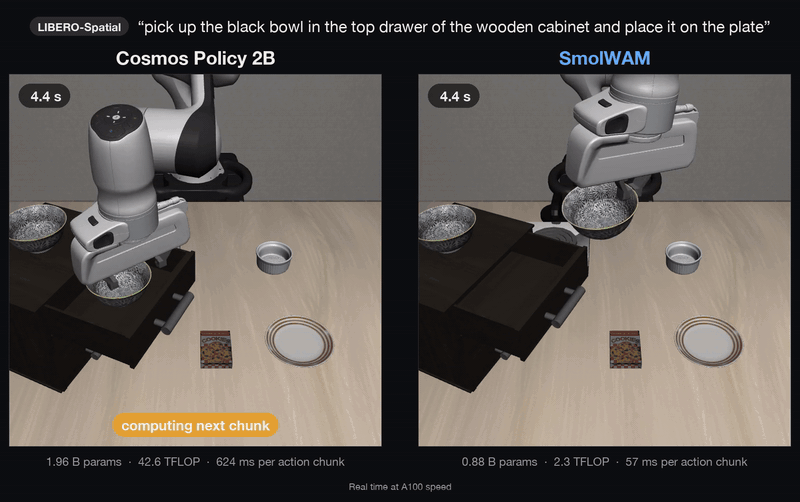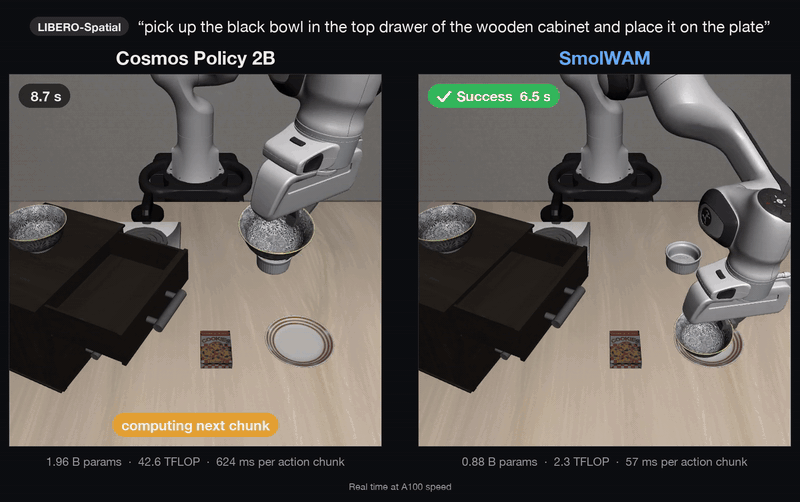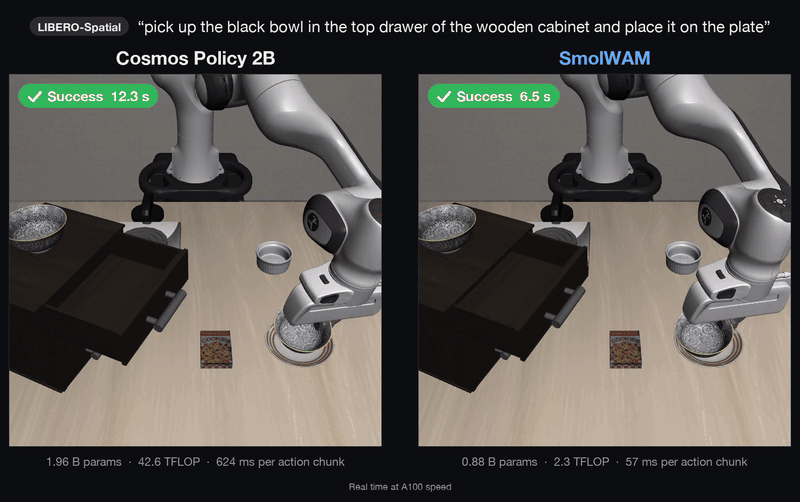
Một policy robot thường nhận ảnh camera cùng câu lệnh rồi trả về hành động. SmolWAM còn dự đoán hai góc nhìn camera sau khi robot thực hiện chuỗi hành động đó. Điểm hấp dẫn là tác giả giữ khả năng dự đoán tương lai trong một mạng khoảng 0,88 tỷ tham số, thay vì phải chạy toàn bộ video model lớn ở mỗi lần điều khiển.
Theo repo SmolWAM, mô hình đạt 382/400 episode thành công, tương đương 95,5%, trên LIBERO. Inference một chunk gồm 16 action mất khoảng 57 ms và đạt peak GPU memory 2,36 GiB trên NVIDIA A100, batch 1, bf16, với text features đã cache. “Khoảng 2,4 GB VRAM” trong cách giới thiệu phổ thông vì vậy nên đọc chính xác là khoảng 2,4 GiB khi inference, không phải yêu cầu bộ nhớ cho training hay lời bảo đảm tốc độ trên mọi GPU nhỏ.
Bài này hướng dẫn bạn đi từ tải mã nguồn đến một episode mô phỏng, sau đó mới tái lập training. Các kết quả là số liệu tác giả công bố; hướng dẫn dưới đây được đối chiếu với source code, không phải báo cáo rằng vnrobo đã tự chạy lại toàn bộ benchmark.
1. SmolWAM giải quyết vấn đề gì?
Nguồn nghiên cứu gốc là SmolWAM: A Latent World-Action Model for Robotic Manipulation on Edge Devices, của Timi Owolabi, Hikmah Olawore, Frances Adelakun và Ayotomiwa Oyewumi, công bố tháng 10/2026. Dự án giới thiệu công trình thuộc NeurIPS 2026 Workshop on Robot Learning with World Models.
VLA là viết tắt của Vision-Language-Action: thông tin thị giác và ngôn ngữ được chuyển thành action. World-action model, hay WAM, mở rộng đầu ra để chứa cả trạng thái quan sát tương lai. Với câu lệnh đặt bát lên đĩa, bạn không chỉ muốn biết tay robot cần di chuyển thế nào, mà còn muốn mô hình biểu diễn cảnh sau khi di chuyển.
SmolWAM kế thừa Cosmos Policy. Teacher này có backbone video diffusion mạnh nhưng giao diện được xây dựng theo nhu cầu sinh video: xử lý clip nhiều frame, nhiều token và nhiều denoising pass. Câu hỏi của nhóm là phần chi phí nào thực sự cần cho điều khiển robot, và phần nào chỉ đến từ cách đóng gói đầu vào của video model?
Cách tiếp cận là giữ prior đã học, sửa giao diện, giảm độ sâu rồi dùng distillation để khôi phục chức năng. Đây không phải một robot foundation model mới được train hoàn toàn từ đầu. Cũng không nên nhầm với SmolVLA của LeRobot; bạn có thể đọc hướng dẫn training SmolVLA để phân biệt một policy nhỏ dự đoán action với WAM có thêm future visual latents.
2. Kiến trúc: ảnh hiện tại, trạng thái và tương lai
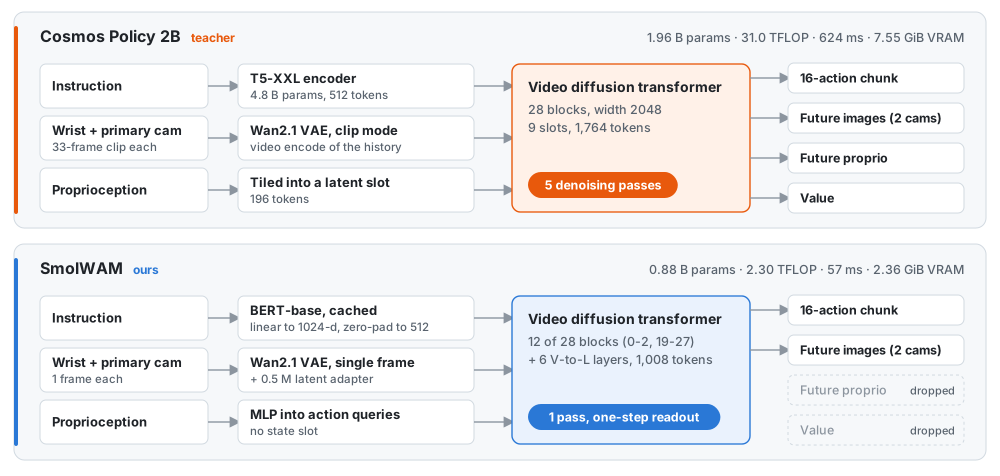
Nguồn: assets/architecture.svg trong repo SmolWAM. Hình minh họa các thành phần; với FLOPs tổng của teacher, bài này dùng record benchmark 42,6 TFLOP vì sơ đồ còn hiển thị số 31,0 TFLOP khác record hiện hành.
Bạn có thể hình dung inference như một dây chuyền gồm năm thay đổi:
- Single-frame visual latents. Mỗi camera cung cấp một ảnh hiện tại. Wan2.1 VAE encoder nén ảnh thành latent, rồi adapter khoảng 0,5 triệu tham số chuyển latent sang không gian mà teacher từng dùng. Adapter quan trọng vì một encoder dùng theo chế độ single-frame không tự động tạo ra phân phối giống clip-mode.
- Text features được cache. BERT-base thay cho T5-XXL trong đường đi ngôn ngữ. Features được chiếu sang context width và zero-pad đến 512 vị trí. Sáu vision-to-language layer cho phép thông tin ảnh tương tác với instruction.
- Giữ 12 trong 28 DiT block. Các block được giữ là 0–2 và 19–27. Chọn block đầu/cuối là một quyết định kiến trúc đã được kiểm tra, không phải quy tắc “xóa layer nào cũng được”.
- Action queries có state conditioning. Trạng thái robot đi qua MLP để điều kiện hóa 28 query. Chúng thay thế action frame 196 token, giúp giảm sequence mà vẫn giữ các vị trí tương ứng trong layout.
- One-pass readout. Một lần chạy trunk trả về action chunk và future latents. Không cần decode ảnh tương lai mới tạo được action.
Chi tiết padding dễ bị bỏ qua. Những vị trí bằng zero vẫn tham gia mẫu số của softmax attention. Cắt chúng đi có thể đổi cách phân bổ attention, dù bạn cho rằng chúng “không chứa nội dung”. Khi sửa model đã pretrained, bảo toàn hành vi của phép tính quan trọng hơn chỉ bảo toàn tensor shape.
Nếu mục tiêu đầu tiên là học API và xem rollout, dùng checkpoint có sẵn trước. Chỉ thuê GPU training sau khi inference, môi trường mô phỏng và pipeline dữ liệu đều hoạt động; làm theo thứ tự này giúp xác định lỗi thuộc phần nào trước khi phát sinh chi phí.
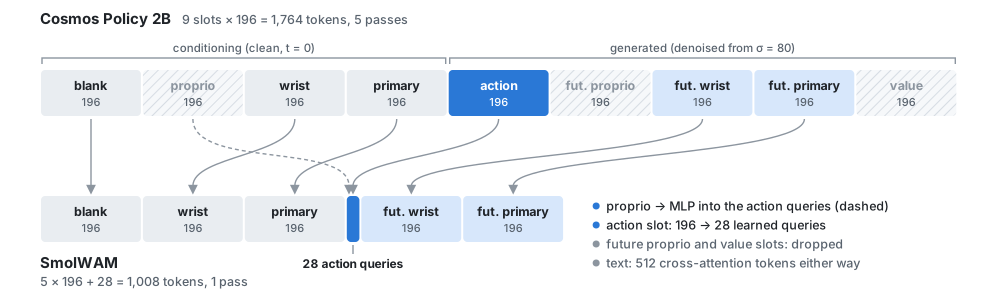
Nguồn: assets/tokens.svg. Sequence nhỏ gồm blank frame, hai camera hiện tại, hai camera tương lai và action queries: 5 × 196 + 28 = 1.008. Đây là sequence của trunk; 512 text positions phục vụ cross-attention là một thành phần riêng.
Khái niệm latent nghĩa là mô hình làm việc với biểu diễn nén thay vì từng pixel RGB. Bạn vẫn đưa ảnh bình thường vào API, nhưng bên trong mạng ảnh đã được biến đổi. Khi muốn kiểm tra trực quan, decoder chuyển future latents trở lại ảnh. Việc decode này là bước bổ sung và không nằm trong đường điều khiển mặc định.
3. Chuẩn bị môi trường và cài đặt
Bạn cần Python từ 3.10 và PyTorch từ 2.5. Package hỗ trợ CUDA, Apple silicon qua MPS và CPU. Điều đó giúp thử API trên nhiều máy; mức 57 ms vẫn là phép đo A100. CPU và MPS không có cùng throughput hoặc cùng cách dùng bộ nhớ như CUDA.
Tải archive để không cần thao tác Git:
curl -L https://github.com/iitimii/SmolWAM/archive/refs/heads/main.tar.gz \
  -o SmolWAM-main.tar.gz
tar -xzf SmolWAM-main.tar.gz
cd SmolWAM-main
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e .
Đây là các lệnh cho máy thực hành của bạn. Khi tái lập kết quả nghiên cứu, hãy lưu ngày tải source, phiên bản package và thông tin GPU; archive main có thể thay đổi về sau. Không trộn package với một môi trường robot cũ nếu bạn muốn xác định lỗi dependency dễ dàng.
Kiểm tra backend trước khi tải checkpoint:
python -c "import torch; print(torch.__version__); print('CUDA:', torch.cuda.is_available()); print('MPS:', torch.backends.mps.is_available())"
Nếu bạn có GPU NVIDIA nhưng CUDA báo False, kiểm tra driver và bản PyTorch được cài. Việc máy có card NVIDIA không đủ để kết luận process Python đang dùng nó. Với Linux server không có màn hình, renderer mô phỏng còn là một lớp cấu hình riêng, chưa được kiểm tra bởi lệnh trên.
Checkpoint đến từ Hugging Face timiiowolabi/SmolWAM. Lần gọi đầu tải weights fp32 khoảng 3,5 GB, text cache và Wan2.1 VAE khoảng 0,5 GB. Dung lượng tải và disk cache khác VRAM inference. Bạn cần cả RAM hệ thống để nạp weights; đừng lập kế hoạch máy chỉ từ con số bộ nhớ GPU.
4. Chạy inference mẫu trước khi mở simulator
Quickstart chính thức đi kèm observation LIBERO thật, gồm ảnh camera và trạng thái. Vì vậy bạn không phải tự tạo tensor ngẫu nhiên hoặc tìm dữ liệu trước lần chạy đầu:
python examples/quickstart.py --device cuda --dtype bf16
Trên Apple silicon hoặc máy CPU:
python examples/quickstart.py --device mps --dtype fp32
# Hoặc:
python examples/quickstart.py --device cpu --dtype fp32
Chọn một backend phù hợp, không cần chạy cả ba. Script có warm-up và in action shape cùng timing. Đầu ra mong đợi có shape (16, 7): 16 timestep, mỗi timestep gồm sáu thành phần delta của end-effector và một lệnh gripper. Đây không phải 16 góc joint, cũng không phải command có thể gửi thẳng cho robot bất kỳ.
Theo policy API, observation bao gồm:
| Key | Nội dung | Điểm cần kiểm tra |
|---|---|---|
primary_image |
Ảnh RGB camera ngoài | Array (H, W, 3), uint8, đúng chiều |
wrist_image |
Ảnh RGB camera cổ tay | Không đưa BGR trực tiếp |
proprio |
Vector 9 phần tử | Hai gripper joint, vị trí end-effector và quaternion |
Để thử API mà vẫn dùng sample hợp lệ, chạy từ thư mục gốc vừa tải:
python - <<'PY'
import sys
sys.path.insert(0, 'examples')
from quickstart import load_sample
from smolwam import SmolWAM

obs, instruction = load_sample()
policy = SmolWAM.from_pretrained(
    'timiiowolabi/SmolWAM', device='cuda', dtype='bf16'
)
actions = policy.predict_action(obs, instruction)
print(actions.shape)
print(policy.last_timing)
PY
API chuẩn hóa proprio và giải chuẩn hóa action bằng statistics của release. Dùng dữ liệu từ một robot khác cần xác định lại representation, camera convention và distribution; việc đầu vào vẫn có chín số không chứng minh chúng có cùng ý nghĩa.
5. Cài LIBERO và chạy một episode
Dùng script cài LIBERO của dự án, thay vì tự chọn phiên bản MuJoCo mới nhất:
bash scripts/install_libero.sh
python examples/libero_rollout.py \
  --suite libero_10 --task 2 \
  --device cuda --dtype bf16 \
  --out outputs/rollout.mp4
Script pin robosuite 1.4.0, MuJoCo 3.3.2 và cài libero==0.1.1 theo đường dependency được dự án chuẩn bị. Object assets khoảng 0,4 GB được tải ở lần dùng đầu. Package cấu hình đường dẫn LIBERO và chọn EGL trên Linux, CGL trên macOS.
Rollout thành công phải có hai bằng chứng khác nhau: process không lỗi và môi trường báo task success. Một video tay robot chuyển động chưa đủ để kết luận hoàn thành nhiệm vụ. Rollout example in cả success/failure, số step và thời gian mỗi query, rồi ghi MP4 để bạn xem.
Vòng điều khiển lấy observation mới, dự đoán 16 action, thực hiện chunk rồi mới query lại. Toàn episode là closed loop, nhưng trong từng chunk action được thực hiện open loop. Không nên tự cắt chunk xuống tám action rồi kỳ vọng phản ứng nhanh hơn mà giữ nguyên độ chính xác: horizon là một phần của distribution đã training.
LIBERO render ảnh ngược chiều; helper policy_observation(env_obs) trong package xử lý convention này. Nếu bạn viết loop riêng, dùng helper để tránh mô hình nhìn ảnh lộn ngược dù chương trình vẫn chạy bình thường.
6. Đánh giá: smoke trước, full sau
Bắt đầu bằng protocol nhỏ để phát hiện lỗi tải weights, rendering hoặc observation:
python -m smolwam.eval_libero \
  --protocol smoke --out outputs/eval_smoke.json
python -m smolwam.eval_libero \
  --protocol screen --out outputs/eval_screen.json
python -m smolwam.eval_libero \
  --protocol full --out outputs/eval_full.json
Theo hướng dẫn experiments, smoke có 12 episode, screen có 60, full có 400. Full dùng bốn suite, mỗi suite mười task, mỗi task mười trial, seed 195 và initial states cố định. Training seed trong config là một thông số khác; không nhầm seed training với seed evaluation.
| LIBERO suite | SmolWAM | Teacher trong bảng so sánh |
|---|---|---|
| Spatial | 99,0% | 97,0% |
| Object | 100,0% | 100,0% |
| Goal | 94,0% | 99,0% |
| Long | 89,0% | 97,0% |
| Tổng | 95,5% | 98,2% |
Nguồn số liệu: record đánh giá full và bảng repo. Teacher dùng kết quả từ pipeline đánh giá trước đó; paper Cosmos Policy gốc báo 98,5%. Khi so sánh, giữ rõ provenance thay vì thay các số này cho nhau.
Khoảng tin cậy Wilson 95% cho 382/400 được tác giả báo là 93,0–97,1%. Kết quả cao không biến benchmark thành lời bảo đảm từng task đều đạt trên 95%. Long là phần yếu rõ nhất, nên nếu ứng dụng cần nhiều subgoal nối tiếp, hãy đọc video thất bại thay vì chỉ xem trung bình.
Đo chi phí inference bằng một process riêng:
python -m smolwam.bench --out outputs/bench.json
Record A100 ghi 2,30 TFLOP cho SmolWAM và 42,61 TFLOP cho teacher, tương đương giảm khoảng 18,5 lần. Phải để GPU rảnh khi benchmark latency; chạy nhiều evaluation process cùng GPU đo cả contention. Khoảng 282 action/giây là throughput tính từ chunk, không phải tần số robot nhận observation mới: query rate chỉ khoảng 17,7 chunk/giây.
7. Xem ảnh tương lai mà world head dự đoán
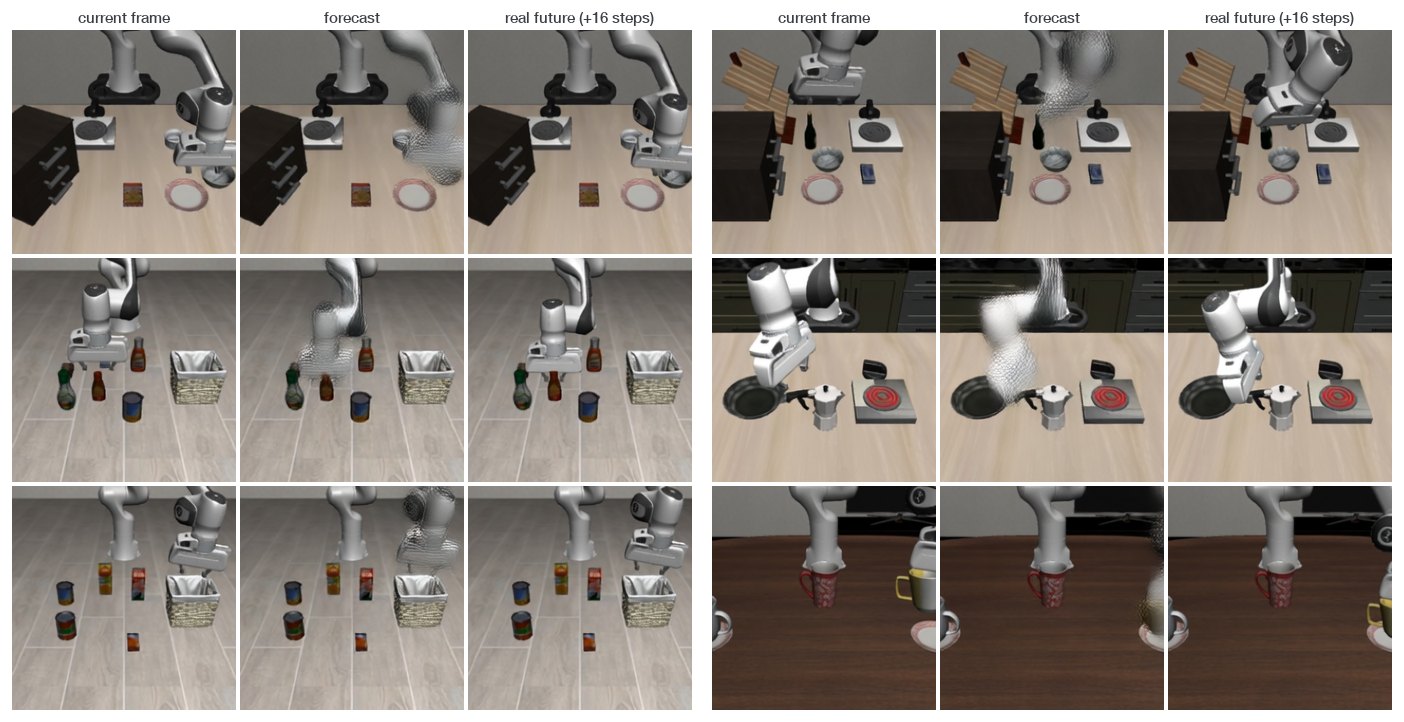
Nguồn: assets/dreams.jpg trong repo. Future images giúp nhìn điều mô hình dự đoán, nhưng chất lượng hình ảnh không đồng nghĩa với task success.
Chạy world-model example:
python examples/world_model.py \
  --device cuda --dtype bf16 \
  --out outputs/world_model.png
Example dùng return_future=True rồi decode_future(...). Ảnh xuất ra đặt hiện tại và forecast cạnh nhau; các hàng tương ứng camera wrist và primary. Forecast là trạng thái sau 16 step, không phải video dày đặc chứa tất cả 16 frame trung gian.
Record world-head evaluation đo trên 96 context giữ lại. Latent L1 giảm từ 0,133 khi copy frame hiện tại xuống 0,101; flow EPE camera primary giảm từ 1,63 xuống 1,43 pixel. LPIPS primary lại là 0,128 so với 0,115 của baseline copy, nên không thể nói mọi chỉ số ảnh đều tốt hơn.
Cách đọc thực tế là mô hình có tín hiệu về chuyển động tương lai, trong khi texture vẫn có thể mờ. Nếu tay robot được đặt gần vị trí sắp tới nhưng màu vật thể thiếu sắc nét, đó là hai khía cạnh riêng. Đừng dùng ảnh đẹp làm bằng chứng duy nhất cho khả năng planning hoặc tránh va chạm.
8. Training: tái lập recipe thay vì đoán flags
Inference nhẹ không đồng nghĩa training nhẹ. Training script tái lập release trên một A100 40 GB, khoảng năm giờ cho toàn pipeline; riêng optimizer training là 3,6 giờ.
python -m pip install -e '.[train]'
python -m pip install -U huggingface_hub
bash experiments/train_smolwam.sh
Pipeline tải demonstrations nvidia/LIBERO-Cosmos-Policy, tạo latent bank, fit adapter, cache text, tạo teacher targets, train student và export release. Có 1.700 demonstration thành công; lấy observation mỗi bốn step cho ra 68.830 row. Đây là reuse dữ liệu robot và pretrained teacher, không phải học từ số không trong vài giờ.
| Thành phần | Recipe công bố |
|---|---|
| Optimizer | AdamW |
| Batch size | 32 |
| Số step | 5.000 |
| Learning rate trunk kế thừa | 2e-5 |
| Learning rate module mới | 1e-4 |
| Layout đầu | 1.764 token trong 1.000 step |
| Layout cuối | 1.008 token trong 4.000 step còn lại |
| Precision | bf16 trên CUDA |
Nguồn: training config. Curriculum cho student phục hồi sau pruning trước khi đổi layout. Thay hai thứ cùng lúc là một thay đổi distribution lớn; loss có thể giảm mà policy vẫn không điều khiển tốt trong rollout.
Trong training implementation, loss L1 gồm action demonstration, future latent demonstration, teacher action và teacher future latent. Future proprio/value có trọng số 0,1 khi các slot ấy còn tồn tại. Checkpoint best.pt được chọn theo validation action L1 ở compact phase; last.pt còn lưu optimizer để resume.
Sau khi pipeline hoàn tất:
python examples/quickstart.py --model runs/smolwam/release
python -m smolwam.eval_libero \
  --model runs/smolwam/release \
  --protocol full --out outputs/retrained_full.json
Validation action L1 là tín hiệu chọn checkpoint, không thay thế success rate closed-loop. Để tuyên bố tái lập 95,5%, cần evaluation full trên checkpoint bạn vừa tạo, ghi điều kiện chạy và kết quả thực tế. Tăng thêm step cũng không bảo đảm tốt hơn; bảng ablation cho thấy phiên bản training thêm 7.500 step đạt 94,2% full.
9. Chẩn đoán lỗi và giới hạn triển khai
Nếu quickstart bị out-of-memory, kiểm tra process GPU khác, dtype và instruction có nằm trong cache không. Instruction mới kích hoạt BERT live, nên peak memory và latency có thể khác phép đo cached-text. Decode future cũng thêm công việc. Không lấy mức 2,36 GiB của đường inference mặc định để bảo đảm mọi đường API vừa trên card cùng dung lượng.
Nếu simulator lỗi nhưng quickstart chạy, tập trung vào LIBERO assets, phiên bản dependency và renderer. Nếu rollout chạy nhưng thất bại, xem chiều ảnh, thứ tự proprio, normalization và task/initial state. Chia lỗi theo ranh giới này giúp tránh reinstall mọi thứ một cách không cần thiết.
Dự án mới đánh giá LIBERO mô phỏng, một training seed; chưa kiểm chứng robot thật hoặc tốc độ trên thiết bị embedded. M2 Pro được repo báo khoảng 0,9 giây mỗi query, không phải 57 ms. INT8 trong ablation là quantization mô phỏng với kernel bf16, không phải benchmark INT8 deployment thực tế.
Cuối cùng, code Apache-2.0 và weights có điều kiện khác nhau: repo ghi weights kế thừa Cosmos Policy theo NVIDIA One-Way Noncommercial License. Với nghiên cứu và giáo dục, hãy đọc model card cùng license tương ứng; trước kế hoạch thương mại phải xác định quyền dùng weights cụ thể. Không suy ra quyền thương mại của checkpoint từ license code.
Lộ trình thực hành phù hợp là xác nhận sample (16, 7), xem một rollout, hoàn tất smoke, chạy full, rồi mới training. Mỗi bước tạo một bằng chứng riêng: API đúng, simulator đúng, protocol đúng và checkpoint mới có chất lượng đo được.