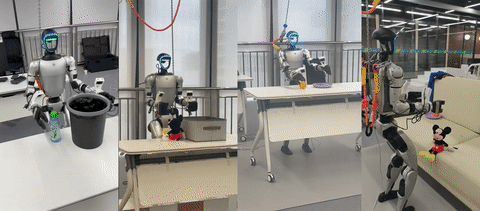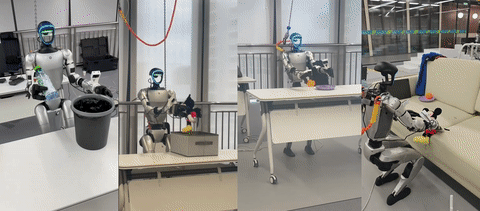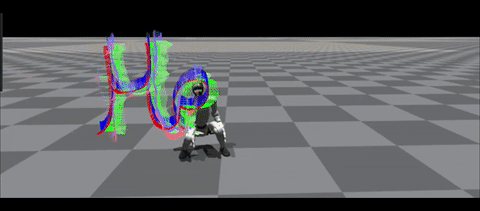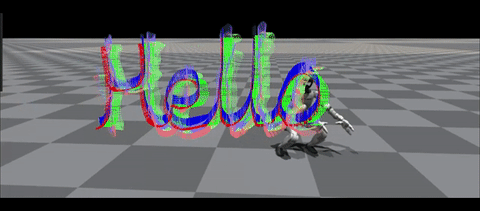
Một robot có thể cầm chiếc đĩa khi đứng yên, nhưng làm rơi nó ngay lúc bước sang bên cạnh. Một policy có thể mở ngăn kéo bằng tay, nhưng thất bại khi phải hạ người để tiếp cận đúng độ cao. Những tình huống này cho thấy vì sao benchmark cho robot-arm cố định chưa đủ để đánh giá humanoid manipulation.
BiGym 2.0 đưa bài toán đó vào một môi trường MuJoCo có thể tải về, quan sát và chạy thử: Unitree G1 thực hiện công việc trong bếp, trong khi một whole-body controller đảm nhiệm cân bằng và bước đi. Bài hướng dẫn này giúp bạn đi từ cài đặt đến một policy ACT có checkpoint, sau đó hiểu cách dùng dữ liệu LeRobot để nghiên cứu VLA. Bạn chưa cần mua robot hoặc có headset VR để bắt đầu.
Nguồn chính là repo BiGym2 của SWIRL Lab, paper gốc và tài liệu đi kèm repo. Các lệnh bên dưới được đối chiếu với mã nguồn công khai tại thời điểm 14/10/2026; đây không phải tuyên bố rằng bài viết đã chạy training hoặc tái lập các điểm số trên một máy cụ thể.
1. Ý tưởng nghiên cứu: giữ nền điều khiển thống nhất
BiGym 2.0 kế thừa các cảnh và tác vụ của BiGym, nhưng thay nền thực thi bằng một G1 có controller cho locomotion. Điểm đáng chú ý là GR00T-WBC được giữ frozen và dùng xuyên suốt quá trình thu thập demonstration, training và evaluation. Điều này giảm một nguồn sai lệch thường gặp: demo được ghi bằng một hệ thống điều khiển, còn policy được chấm bằng một hệ thống khác.
Trong benchmark, high-level policy quyết định tay cần làm gì và thân cần di chuyển ra sao. GR00T-WBC thực thi các body command, giúp robot bước đi và giữ thăng bằng. Vì vậy, một policy thao tác vẫn phải học cách chọn chuyển động thân phù hợp với việc cầm nắm, dù không trực tiếp dự đoán từng joint target của chân.
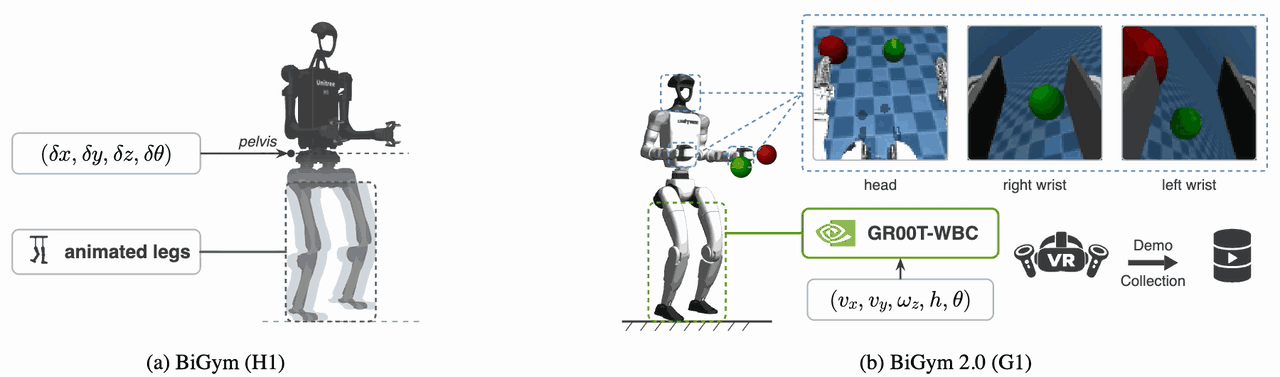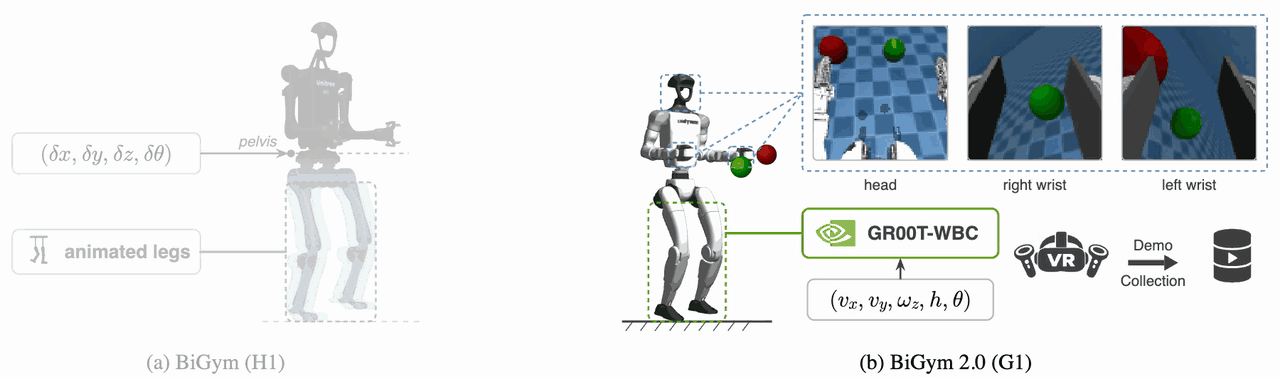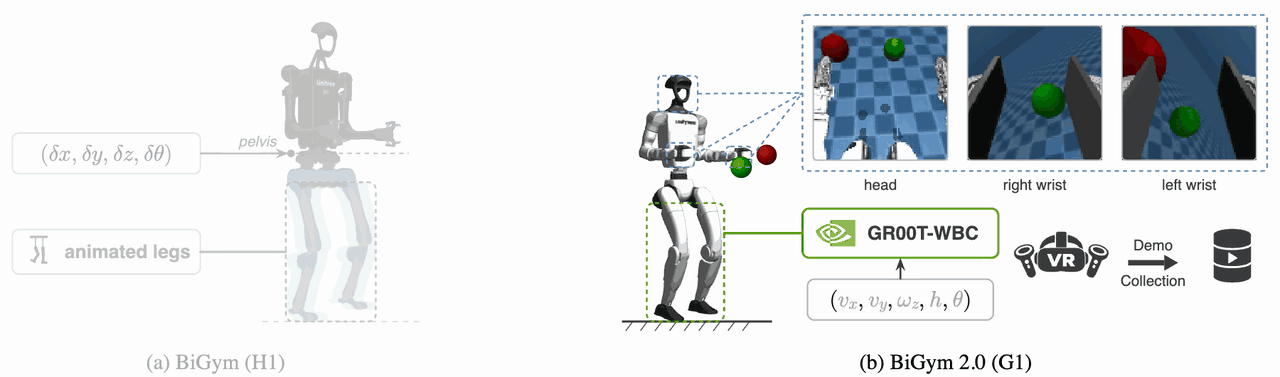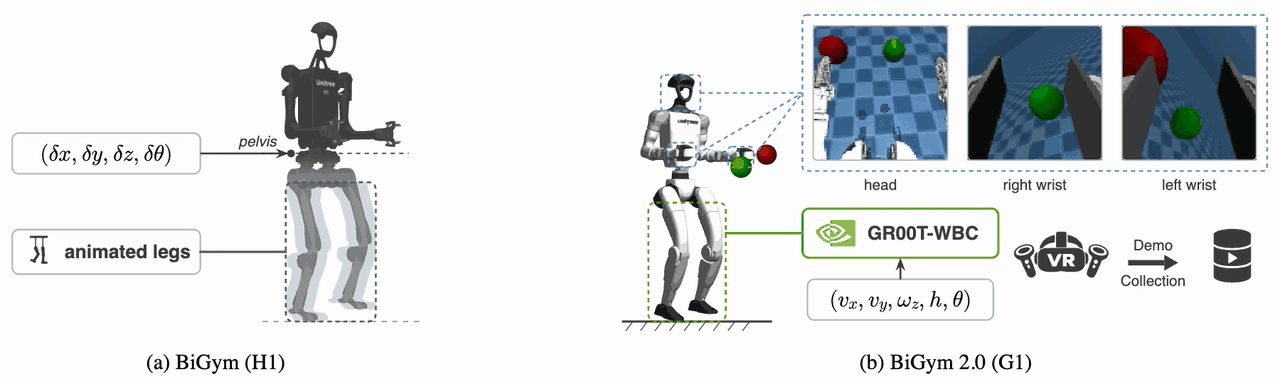
GIF kỹ thuật từ README dự án. Quan sát chuyển động chân để thấy khác biệt giữa nền thực thi cũ và controller của G1.
Bộ dữ liệu cung cấp 20 tác vụ, mỗi tác vụ 60 demonstration VR thành công, tổng cộng 1.200 episode. Các nhóm gồm reaching, tabletop manipulation, dishwasher và kitchen counter. move_plate là điểm khởi đầu tốt vì bạn dễ nhìn được chuỗi tiếp cận, nắm, di chuyển và thả. stack_blocks khó hơn nhiều vì robot phải vận chuyển và đặt chính xác qua nhiều giai đoạn.
Để hiểu nền tảng dữ liệu trước khi làm bài thực hành, bạn có thể đọc LeRobot: framework cho học policy từ demonstration. Trong bài này, LeRobot trước hết là định dạng dữ liệu có cấu trúc; việc một dataset mang định dạng LeRobot không tự động biến mọi mô hình training thành VLA.
2. Kiến trúc: policy ở trên, WBC ở dưới
Một cách đọc hệ thống là tách ba phần: observation, quyết định high-level và thực thi vật lý.
Head RGB + right-wrist RGB + left-wrist RGB
                    + proprioception
                    + task text for a VLA
                              |
                              v
                   High-level policy
                  /         |         \
          Arm targets   Gripper     Body commands
                                    vx, vy, height, wz
                                    optional torso pitch
                                        |
                                        v
                             Frozen GR00T-WBC
                               Balance + Walk
                                        |
                                        v
                           Leg / waist joint targets
                                        |
                                        v
                         MuJoCo simulation + contacts
                                        |
                                        v
                              Next observation
Theo tài liệu backend, BiGym2 chạy cặp policy Balance và Walk của NVIDIA qua ONNX Runtime. Cặp weight này không được fine-tune cùng policy thao tác trong benchmark. Cũng không nên nhầm GR00T-WBC với một mô hình GR00T VLA: controller ở đây thực thi body command, còn mô hình high-level có thể là ACT, Diffusion Policy hoặc VLA.
Với move_plate, action có 20 phần tử: bốn body command, 14 arm joint target và hai gripper command. Các tác vụ có torso-pitch command dùng 21 phần tử. Proprioception tương ứng có 50 hoặc 56 chiều. Hãy đọc layout từ environment thay vì chép cứng số chiều từ một tác vụ sang tác vụ khác.
| Nhóm action | Ý nghĩa trong layout không có pitch |
|---|---|
vx, vy |
Vận tốc tiến/lùi và sang ngang trong body frame |
height |
Độ cao pelvis tuyệt đối |
wz |
Vận tốc quay yaw |
| 14 arm slots | Joint position target tuyệt đối của hai cánh tay |
| Hai gripper slots | Mức mở/đóng hai gripper |
Action của API thông thường được normalize về [-1, 1], rồi ánh xạ tới khoảng vật lý từng slot. Một vector toàn số 0 không phải lệnh giữ nguyên pose: nó đưa nhiều slot về giữa khoảng, trong đó có joint tay và height. Đây là lý do nên bắt đầu bằng demo và policy mẫu thay vì tự giả định rằng action bằng 0 sẽ giữ nguyên mọi thứ. Chi tiết nằm trong official configuration.
3. Cài đặt: bắt đầu bằng core environment
Repo yêu cầu Python từ 3.10; phần export/re-render với extra LeRobot cần Python từ 3.12. Nếu bạn bắt đầu một môi trường mới và muốn làm cả phần re-render, Python 3.12 là lựa chọn thực dụng. Core chạy trên Linux và macOS; VR collection có yêu cầu Linux riêng.
Các lệnh sau dành cho terminal trên máy thực hành của bạn:
curl -LsSf https://astral.sh/uv/install.sh | sh
git clone https://github.com/swirl-uk/BiGym2.git
cd BiGym2
uv sync --python 3.12
uv sync cài dependency theo cấu hình repo, bao gồm environment, loader dữ liệu, evaluator và controller. Bạn chưa cần cài extra VR để đọc demo hoặc chạy ví dụ ACT. Trên Linux headless, cấu hình rendering theo installation guide:
export MUJOCO_GL=egl
uv run python examples/loco_random_agent.py
Trên macOS, bỏ dòng export EGL. Ví dụ random-agent chủ yếu xác nhận rằng environment có thể reset và step; reward thấp là điều có thể dự đoán vì action ngẫu nhiên không thực hiện đúng công việc.
Đừng hiểu GPU dùng trong thí nghiệm throughput của tác giả là cấu hình tối thiểu bắt buộc. Chi phí thực tế phụ thuộc rendering, số environment, mô hình và lượng dữ liệu giải mã. Mục tiêu đầu tiên là khởi tạo được một task, sau đó mới đo tốc độ và bộ nhớ trên máy của bạn.
4. Reset và đọc observation đầu tiên
Đoạn Python sau có thể chạy trong interpreter của uv run python, hoặc dùng như nội dung một notebook thực hành:
from bigym.loco import make

env = make("move_plate")
timestep = env.reset(seed=620000)
print(env.action_spec())
print(timestep.rgb_obs.shape)
print(timestep.low_dim_obs.shape)
print(env.wholebody_action_layout())
print(env.low_dim_component_slices())
env.close()
Với cấu hình chính thức của move_plate, RGB có shape (3, 3, 84, 84) và proprioception có shape (50,). Thứ tự camera là head, right_wrist, left_wrist. Hai số 3 đầu có nghĩa khác nhau: ba camera và ba channel màu. Đảo camera hoặc nhầm CHW với HWC có thể không gây lỗi shape nhưng vẫn phá input của mô hình.
Reset bao gồm 200 control step warmup, tương đương bốn giây thời gian mô phỏng ở 50 Hz. Controller cần giai đoạn này để robot ổn định trước khi policy tiếp quản. Không bỏ warmup để tiết kiệm thời gian rồi coi điểm số đó là kết quả benchmark tương đương.
Mỗi high-level step kéo dài 0,02 giây; scene dùng physics integration 1 ms. Điều đó không có nghĩa máy của bạn tự động đáp ứng inference real-time. Bạn vẫn cần đo latency và kiểm tra nhịp gửi action nếu xây dựng một hệ thống chạy theo đồng hồ thực. Getting started mô tả đầy đủ API này.
5. Tải và hiểu dữ liệu LeRobot
Hãy tải riêng một task trước khi tải toàn bộ dataset:
uv run bigym-download --list
uv run bigym-download --task move_plate
uv run bigym-view --task move_plate
Dataset chính thức nằm ở SWIRL-Lab/bigym-g1-native60. Mỗi task là một folder LeRobot v3; hình ảnh training được lưu dưới dạng PNG lossless. bigym-view mở viewer trên trình duyệt, giúp xem episode và trạng thái simulator thay vì chỉ đọc số trong bảng.
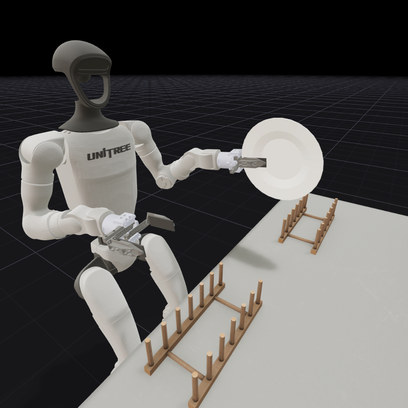
Ảnh tác vụ chính thức. Khi xem demo, chú ý lúc gripper đóng, lúc robot đổi vị trí thân và lúc chiếc đĩa được thả.
Đọc dữ liệu qua Gymnasium interface:
from bigym.loco import make_gym

env = make_gym("move_plate")
demos = env.get_demos(60, only_successful=True, decode_images=False)
demo = demos[0]
print(demo["action"].shape)
print(demo["obs"]["state"].shape)
print(demo["obs"]["rgb"][0].shape)
env.close()
Loader trả trajectory theo quan hệ obs[t] --action[t]--> obs[t+1]. decode_images=False giữ ảnh ở dạng nén và giải mã khi truy cập. Đây là lựa chọn hữu ích khi RAM hạn chế; tài liệu nêu rằng một task dài như stack_blocks có thể dùng khoảng 15 GB khi giải mã toàn bộ 60 demo, so với khoảng 5 GB khi giữ ảnh nén. Đây là bộ nhớ của dữ liệu, chưa tính mô hình và batch training.
Một bẫy khác nằm ở normalization: action lưu trong dataset dùng thống kê của batch metadata; get_demos() chuyển về khoảng action của environment. Nếu bạn đọc parquet trực tiếp rồi đưa output đã normalize theo dataset vào một env dùng normalization khác, robot nhận sai lệnh dù tensor đúng số chiều. Hãy giữ preprocessing và inverse transform cùng checkpoint. Xem tài liệu demonstrations trước khi tự viết converter.
6. Training ACT: một bài thực hành có đầu ra rõ ràng
ACT dự đoán một đoạn action tương lai, gọi là action chunk. Ví dụ trong repo dùng CNN xử lý từng camera, một nhánh cho state và transformer decoder để tạo chuỗi action. Training dùng L1 loss; inference dùng temporal ensembling để tổng hợp các dự đoán chồng lên nhau.
Ví dụ này là ACT rút gọn: nó bỏ CVAE và pretrained ResNet backbone của ACT gốc. Vì vậy, chạy thành công ví dụ không đồng nghĩa tái lập kết quả ACT trong paper. Đây là lựa chọn phù hợp để học pipeline và xác định lỗi dữ liệu trước khi chuyển sang mô hình lớn hơn. Mã nguồn và các flag nằm ở examples/train_act.py.
Để thử nhanh toàn bộ luồng bằng một task:
uv run --with torch --with imageio-ffmpeg python examples/train_act.py \
  --task move_plate \
  --steps 1000 \
  --batch 16 \
  --workers 0 \
  --eval-episodes 5 \
  --record 1 \
  --out act_runs/move_plate_smoke
Đây là smoke run do bài viết đề xuất, không phải training recipe của paper. Một nghìn gradient step và năm evaluation episode nhằm kiểm tra loader, forward pass, checkpoint và video output; chưa đủ cơ sở kết luận policy tốt hay kém trên benchmark.
Khi luồng chạy ổn, dùng mặc định ví dụ và một folder output mới:
uv run --with torch --with imageio-ffmpeg python examples/train_act.py \
  --task move_plate \
  --record 3 \
  --out act_runs/move_plate_example
Mặc định của script gồm 20.000 gradient step, batch 64, chunk 20 và evaluation trên 100 episode. Script tự chọn CUDA nếu PyTorch thấy GPU. Nếu thiếu RAM hoặc gặp worker error, giảm batch và dùng --workers 0; ghi lại mọi thay đổi để lần chạy sau có thể so sánh.
Output chứa policy.pt, các video MP4 và dữ liệu trạng thái episode cho viewer. Folder output mới phải rỗng, giúp tránh lẫn checkpoint của các lần chạy. Training loss giảm là tín hiệu mô hình học khớp action trong demo; success rate mới đo việc robot hoàn thành task qua cả chuỗi tương tác.
7. Inference: tải checkpoint và xem robot thực thi
Bạn có thể evaluate lại checkpoint mà không training lại:
uv run --with torch --with imageio-ffmpeg python examples/train_act.py \
  --load act_runs/move_plate_example/policy.pt \
  --eval-episodes 100 \
  --record 3

uv run bigym-view --demo-dir act_runs/move_plate_example
Trong inference, model nhận RGB và state, dự đoán chunk, rồi wrapper tạo action cho timestep hiện tại. Temporal ensembling giảm dao động giữa các chunk. Wrapper cần xóa history khi episode mới bắt đầu; script đã có reset() cho việc đó.
Xem video chậm và hỏi từng câu cụ thể: robot có tiếp cận đúng phía của đĩa không, hai tay có tự va chạm không, gripper có đóng trước khi chạm vật không, thân có dịch chuyển khi vật chưa ổn định không? Những quan sát này giúp phân biệt lỗi perception, sai normalization và lỗi trình tự thao tác. Một video thành công đẹp mắt không thay cho evaluation trên đầy đủ seed.
Nếu triển khai model của riêng bạn, evaluator nhận callable từ timestep sang action:
from bigym.loco.eval import evaluate

# my_policy must return actions in the environment's expected layout.
result = evaluate(
    my_policy,
    task_name="move_plate",
    method="my-policy",
)
print(result["success_rate"])
print(result["protocol_violations"])
my_policy trong đoạn này là policy bạn phải cung cấp, không phải class có sẵn. Khi policy có state nội bộ hoặc action queue, thêm reset() để evaluator gọi giữa các episode.
8. Chuyển sang VLA và ảnh 224×224
VLA thêm task language và kiến thức pretrained vào quy trình dự đoán action. Nhưng bạn vẫn phải giải quyết camera order, action layout, normalization và nhịp thực thi như ACT. Trước khi đầu tư GPU cho fine-tuning, nên xác nhận policy nhỏ đã đọc đúng data và điều khiển đúng environment.
BiGym2 lưu simulator state theo frame, nên có thể re-render camera ở độ phân giải khác thay vì chỉ phóng to ảnh 84×84:
uv sync --extra lerobot
uv run bigym-rerender-lerobot --task move_plate --size 224 224
Lệnh yêu cầu Python từ 3.12 và mặc định tạo bản sao trong bigym-g1-native60-224/move_plate. Cấu hình environment dùng để đọc bản sao phải có camera shape tương ứng. Đây là thay đổi input cần công bố khi báo cáo kết quả.
Quan trọng: paper ghi π0.5 dùng các view 84×84 với xử lý input của model ở 224×224. Re-render native ở 224×224 cung cấp chi tiết hình ảnh khác với resize input gốc, nên không được coi hai thí nghiệm là hoàn toàn giống nhau. Hướng dẫn repo hiện cũng mô tả derived view 224×224; khi tái lập, đối chiếu phiên bản paper, metadata và cấu hình trainer thực tế.
Repo không cung cấp một lệnh train_act.py có thể đổi flag để thành π0.5. Bạn cần trainer tương ứng và adapter cho observation/action. Lập bản mô tả hợp đồng dữ liệu: tên camera, kích thước, language prompt, số chiều proprioception, action representation, thống kê normalization và số action thực thi trước khi dự đoán lại. Đây là bước nên hoàn tất trước khi chọn learning rate.
Nếu muốn nối phần này với pipeline teleoperation, bài thu thập dữ liệu G1 cho GR00T cung cấp bối cảnh để hiểu vì sao camera và action cần nhất quán từ lúc ghi demo.
9. Kết quả: xem cả điểm mạnh lẫn task thất bại
Bảng dưới trích các success rate trong Table II của paper BiGym 2.0. Đơn vị là phần trăm; đây là số công bố của tác giả, không phải kết quả chạy các lệnh trong bài.
| Task | π0.5 | ACT |
|---|---|---|
pick_box |
19 | 61 ± 4 |
move_plate |
65 | 60 ± 1 |
move_two_plates |
68 | 39 ± 0 |
dishwasher_load_cups |
92 | 56 ± 3 |
| Mean trên chín task | 75 | 68 |
π0.5 có mean cao nhất trong so sánh chính, nhưng yếu hơn ACT ở pick_box. Không có policy thắng mọi task. Ngoài chín task đó, stack_blocks vẫn rất khó: ACT đạt 0%, CQN-AS khoảng 1%; paper không đánh giá π0.5 trên task này.
Cách tổng hợp cũng khác: ACT dùng ba training run, mỗi run lấy mean năm checkpoint cuối với 100 episode/checkpoint. π0.5 dùng một training run/task, gộp năm checkpoint cuối với 50 episode/checkpoint. Vì vậy, không nên diễn giải hai cột như có cùng mức bằng chứng về độ ổn định giữa training run.
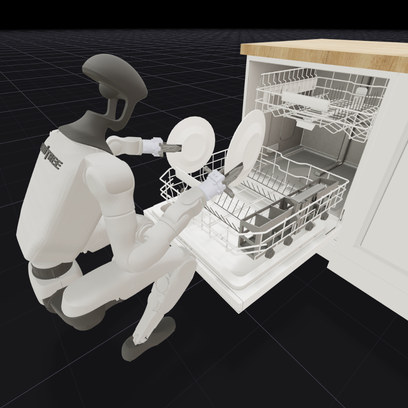
Ví dụ contact-rich manipulation: độ cao và posture của thân ảnh hưởng trực tiếp tới việc tay tiếp cận fixture.
10. Evaluation và các lỗi dễ làm sai kết luận
Theo protocol repo, full evaluation dùng 100 episode với seed 620000 + i. Success đòi hỏi task hoàn thành và robot không bị fall trong episode. Điều kiện task phải giữ một giây; vật vừa chạm vị trí mục tiêu rồi bật ra chưa phải thành công.
Fall được latch khi pelvis nghiêng quá 53 độ hoặc thấp hơn 0,30 m. Fall không nhất thiết kết thúc episode ngay; do đó không nên tự chấm bằng reward cuối cùng. Dùng evaluator và báo thêm tỷ lệ fell khi phân tích rollout.
Có bốn kiểm tra nên làm trước khi so sánh model:
- Input: camera đúng thứ tự, đúng dtype và đúng shape; không vô tình đưa simulator state của vật vào visual policy.
- Action: checkpoint và environment dùng cùng normalization; task có pitch không bị thiếu hoặc lệch slot.
- Reset: giữ warmup và controller state restoration; xóa action queue giữa episode.
- Protocol: xem
protocol_violations, ghi số episode và công bố mọi thay đổi camera/controller.
Không đặt controller=None rồi so sánh như benchmark chính thức: lựa chọn đó bỏ lower-body controller và thay đổi nền thực thi. Tương tự, một lần chạy năm episode không có leaderboard record chính thức. Điều chỉnh camera resolution cũng có thể làm run thành unofficial theo evaluator, dù đó vẫn là thí nghiệm nghiên cứu hữu ích.
Nếu bạn thu demo mới, extra vr và lerobot có xung đột dependency setuptools; không cài cả hai bằng một uv sync chung. Tách môi trường collection và export theo installation guide. Nếu chỉ đọc demo được phát hành, bạn không cần các extra này.
Sau bài thực hành, đầu ra đáng tin cậy nhất là một checkpoint gắn với đúng task, một cấu hình preprocessing rõ ràng, các rollout có thể xem lại và một báo cáo success rate ghi đúng protocol. BiGym 2.0 giúp bạn xây dựng chuỗi đó trước khi chuyển một policy whole-body sang phần cứng thật; kết quả mô phỏng tự nó chưa chứng minh sim2real.