Robot có thể gắp đúng chiếc cốc nhưng vẫn thất bại khi phải mở hộp, đặt cốc vào trong rồi đóng nắp. Mỗi thao tác riêng lẻ không quá khó; vấn đề nằm ở việc duy trì tiến trình và hiểu trạng thái trung gian. Một ảnh hiện tại đôi khi không cho biết vật thể vừa được di chuyển, đang bị che khuất hay đã hoàn thành bước trước.
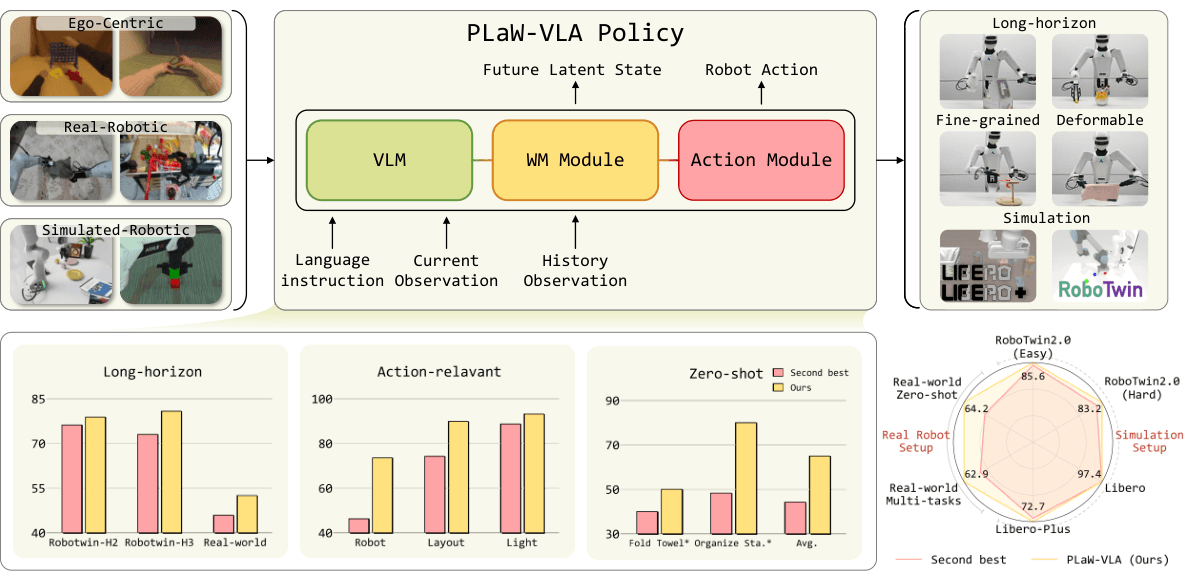
PLaW-VLA — Predictive Latent World Modeling for Vision-Language-Action Policies bổ sung một nguồn thông tin cho policy: biểu diễn của những trạng thái tương lai có thể xảy ra. Thay vì dựng video đẹp để robot xem lại, hệ thống dự đoán feature trong latent space của một V-JEPA 2 encoder đã được huấn luyện trước và đóng băng. Action expert dùng các feature đó cùng ảnh, lịch sử quan sát và instruction để tạo action chunk.
Hướng dẫn này dựa trên paper gốc, project page và tài liệu repo RainyRobo/PLaW-VLA. Các lệnh dưới đây dành cho máy thực hành của bạn, chạy tại thư mục gốc của repo PLaW-VLA.
Tình trạng phát hành khi kiểm tra ngày 12/10/2026: code, converter và pipeline LIBERO đã công khai, nhưng checkpoint PLaW-VLA pretrained chính thức còn pending. Quickstart hiện dùng foundation weights π₀.₅ và khởi tạo mới world-model modules. Vì vậy, hoàn thành quickstart không đồng nghĩa tái lập đầy đủ model đã qua Stage I–II trong paper.
1. Hiểu bài toán trước khi cài đặt
VLA nhận vision, language và robot state để tạo action. Với một reactive policy, quyết định chủ yếu xuất phát từ quan sát hiện tại. Khi tác vụ gồm nhiều bước, hai ảnh gần giống nhau có thể cần hai hành động khác nhau: trước khi gắp vật thể thì đóng gripper; sau khi đặt vật thể thì mở gripper và rút tay.
Observation history giúp nhận ra diễn biến trước đó. Future prediction bổ sung khả năng ước lượng diễn biến tiếp theo. Ví dụ minh họa, khi đặt một vật vào hộp, policy có thể hưởng lợi từ feature mô tả tay đã hạ xuống và vật thể nằm trong hộp. Đây là cách diễn giải trực quan, không có nghĩa model xuất ra một câu mô tả hoặc một ảnh tương lai dễ đọc.
Có ba khái niệm nên nhớ. Latent là vector feature được encoder trích xuất; action chunk là một chuỗi target cho nhiều thời điểm; EEF, hay end-effector, là đầu thao tác như gripper. LIBERO dùng robot Franka trong mô phỏng để kiểm tra manipulation theo instruction, nên bạn có thể học toàn bộ luồng mà chưa cần robot thật.
PLaW-VLA không thực hiện một vòng tìm kiếm tường minh qua hàng loạt action candidate như một planner truyền thống. Trong công thức của paper, latent world model dự đoán tương lai từ lịch sử và task context; action expert sau đó dùng dự đoán ấy làm conditioning. Không nên tự thêm giả định rằng mỗi future token là kết quả mô phỏng một action candidate.
2. Kiến trúc: ba expert phối hợp

Hệ thống dùng Mixture-of-Transformers, gồm ba expert có nhiệm vụ khác nhau nhưng trao đổi thông tin qua attention được cấu trúc. Vision-language expert dựa trên PaliGemma, xử lý ảnh hiện tại từ nhiều góc nhìn cùng instruction để tạo semantic context. World-model expert nhận context đó và feature lịch sử để dự đoán feature tương lai. Action expert tạo chuỗi action liên tục, có điều kiện trên context, lịch sử và future tokens.
V-JEPA 2 encoder là không gian đích của future prediction. Encoder đóng băng giúp feature target ổn định trong training. Learnable future queries đại diện các mốc tương lai, được xử lý song song thay vì phải sinh từng frame rồi decode toàn bộ pixel. Model học dự đoán những vector mà encoder sẽ trích xuất từ future observation thật trong demonstration.
Luồng dữ liệu có thể đọc như sau:
Current multi-view RGB + instruction -> vision-language context
Observation history -> frozen V-JEPA 2 -> history latents
Context + history + future queries -> predicted future latents
Context + history + predicted future -> action expert -> action chunk
Action chunk -> output transforms -> absolute EEF targets -> controller
Structured causal attention giữ đúng hướng truyền thông tin giữa các expert. Điểm quan trọng cho beginner là future observation thật chỉ cung cấp supervision khi training; nó không được đưa vào inference như một dữ liệu đầu vào có sẵn. Nếu vô tình trộn future frame vào observation history của client, phép đánh giá không còn phản ánh khả năng dự đoán thực tế.
3. Model học những gì?
World-model loss so sánh predicted latent với feature của future frame thật, theo mean squared error và stop-gradient ở target. Action expert dùng flow matching để học action chunk liên tục. Có thể hình dung quá trình này là học một trường vector chuyển mẫu nhiễu thành chuỗi hành động phù hợp, thay vì chọn token ngôn ngữ như chatbot.
Trong Stage II và III, hai mục tiêu được tối ưu cùng nhau. Paper dùng world-model branch dropout với xác suất 0,3: ở một số batch, cả historical và predicted latent tokens của nhánh này được bỏ khỏi action conditioning, đồng thời world-model loss không hoạt động; action loss vẫn được tính. Cơ chế này hạn chế việc policy phụ thuộc quá mức vào dự đoán tương lai vốn có thể sai.
Đây cũng là lý do cần xem cả rollout lẫn loss. World-model loss thấp cho biết feature prediction gần target hơn, nhưng không tự chứng minh robot hoàn thành tác vụ. Một policy có thể dự đoán diễn biến hình ảnh khá tốt mà vẫn sai gripper timing hoặc sai chuyển đổi action sang controller.
4. Chuẩn bị máy và hai môi trường Python
Theo hướng dẫn cài đặt của repo, môi trường training yêu cầu Linux x86_64, NVIDIA GPU với driver tương thích CUDA 12.8 và Python 3.12. Cần FFmpeg để đọc video, EGL/OpenGL để rendering và đủ dung lượng cho dataset lẫn checkpoint. Repo không đưa ra một cấu hình GPU tối thiểu đảm bảo chạy mọi recipe, nên không nên suy ra rằng một GPU phổ thông chắc chắn chứa được model và optimizer.
Trước tiên kiểm tra GPU và cài thư viện hệ thống:
nvidia-smi
sudo apt-get update
sudo apt-get install -y git ffmpeg libgl1 libegl1 libglib2.0-0
Cài uv theo tài liệu chính thức, sau đó lấy repo và tạo môi trường root:
git clone https://github.com/RainyRobo/PLaW-VLA.git
cd PLaW-VLA
git submodule update --init third_party/libero
GIT_LFS_SKIP_SMUDGE=1 uv sync --python 3.12 --frozen
bash scripts/setup/install_transformers_patch.sh
--frozen giữ đúng dependency lock; patch Transformers là bước của repo, không nên bỏ vì nghĩ rằng package đã được cài. Nếu Python hệ thống thiếu development headers, dùng Python do uv quản lý:
uv python install 3.12
UV_PYTHON_PREFERENCE=only-managed GIT_LFS_SKIP_SMUDGE=1 \
  uv sync --python 3.12 --frozen
bash scripts/setup/install_transformers_patch.sh
Simulator client dùng Python 3.8 trong môi trường riêng, còn training và policy server dùng root .venv Python 3.12:
uv sync --project examples/libero --python 3.8 --frozen
.venv/bin/python -c "import torch; print(torch.cuda.is_available())"
Giữ hai môi trường tách biệt giúp tránh xung đột dependency của simulator với stack training. Nếu kiểm tra CUDA trả False, giải quyết driver và môi trường trước khi tải dataset lớn hoặc khởi chạy training.
5. Đường ngắn nhất: fine-tune LIBERO
Quickstart chuẩn bị foundation checkpoint, V-JEPA 2 facebook/vjepa2-vitl-fpc64-256, tokenizer, LIBERO EEF dataset và normalization statistics tương ứng. Nếu mục tiêu là làm quen với pipeline, đây là điểm bắt đầu hợp lý hơn việc tải toàn bộ pretraining mixture.
STAGE3_BASE_SOURCE=pi05 \
NUM_GPUS=8 EXP_NAME=libero_finetune \
  bash scripts/train/run_stage3_libero_quickstart.sh
Bài này chọn pi05 tường minh để nguồn initialization không thay đổi khi checkpoint chính thức được phát hành. README dùng auto, hiện cũng resolve sang π₀.₅; sau release, auto có thể resolve sang checkpoint PLaW-VLA đầy đủ. Hãy lưu source được resolve trong log để so sánh experiment đúng cách.
Recipe Stage III mặc định chạy 50.000 optimization steps, global batch 256, warmup 10.000 steps và lưu checkpoint mỗi 5.000 steps. Với 8 GPU, global batch chia đều thành 32 sample trên mỗi process ở cấu hình này. NUM_GPUS phải phù hợp số GPU visible và chia hết global batch.
Để kiểm tra đường đi với một GPU trước khi đầu tư chạy đầy đủ, có thể dùng experiment riêng:
STAGE3_BASE_SOURCE=pi05 NUM_GPUS=1 EXP_NAME=libero_smoke \
  bash scripts/train/run_stage3_libero_quickstart.sh \
  --batch-size 1 --num-train-steps 20 --save-interval 10 \
  --no-wandb-enabled
Đây chỉ là smoke run, không phải recipe tái lập benchmark và cũng không bảo đảm đủ VRAM trên mọi card. DDP giữ một bản đầy đủ của model và optimizer trên mỗi GPU; thêm GPU không tự chia model như tensor parallelism. Nếu hết VRAM, cần đánh giá bộ nhớ thực tế thay vì chỉ tăng process count.
Checkpoint của experiment đầy đủ nằm tại:
checkpoints/stage3_finetuning_libero/libero_finetune/<step>/
Giữ nguyên cả step directory, gồm weights, assets và training state. Resume phải giữ source, batch size, process count cùng các override ban đầu:
STAGE3_BASE_SOURCE=pi05 NUM_GPUS=8 EXP_NAME=libero_finetune \
  bash scripts/train/run_stage3_libero_quickstart.sh --resume
Các lựa chọn và cơ chế handoff được giải thích trong pretraining guide. Nếu đã đổi flag ở lần chạy đầu, lặp lại chúng khi resume.
6. Đường đầy đủ: Stage I → II → III
Muốn tiếp cận setup của paper, cần chuẩn bị năm nguồn cho Stage I: InternData-A1, AgiBotWorld, RoboTwin, LIBERO và EgoDex. Stage II chỉ dùng bốn nguồn robot có action; EgoDex cung cấp video action-free cho Stage I. Converted pretraining mixture không được phân phối sẵn, và repo lưu ý việc khớp chính xác mixture của paper còn phụ thuộc author-verified source manifest.
Vì vậy, ba lệnh dưới đây chỉ là bước training sau khi bạn hoàn thành acquisition, conversion, validation và normalization trong data guide. Đừng tạo thư mục rỗng rồi kỳ vọng launcher tự tải đủ corpus.
export DATA_ROOT="$PWD/data/pretrain"
NUM_GPUS=8 EXP_NAME=stage1_world_model \
  bash scripts/train/run_stage1_world_model_pretraining.sh

NUM_GPUS=8 STAGE1_EXP_NAME=stage1_world_model EXP_NAME=stage2_joint \
  bash scripts/train/run_stage2_pretraining.sh

NUM_GPUS=8 STAGE2_EXP_NAME=stage2_joint EXP_NAME=libero \
  bash scripts/train/run_stage3_finetuning_libero.sh
| Stage | Mục tiêu | Steps | Global batch |
|---|---|---|---|
| I | Học dự đoán latent từ video, chỉ train LWM | 100.000 | 512 |
| II | Joint future prediction và action learning | 100.000 | 256 |
| III | Thích nghi tác vụ LIBERO | 50.000 | 256 |
Trước Stage II, tính training normalization trên dữ liệu đã qua canonical transforms:
.venv/bin/python scripts/train/compute_norm_stats.py \
  --config-name stage2_pretraining --batch-size 32
Không thay thế kết quả này bằng meta/stats.json của converter: raw feature statistics và statistics sau transform khác nhau. Recipe thời gian mặc định dùng sáu history frames kể cả frame hiện tại, sáu future frames cách nhau 0,2 giây và action interval 0,1 giây. Giữ temporal configuration nhất quán khi chuyển checkpoint giữa các stage.
7. Action representation: nơi dễ mắc lỗi nhất
Một EEF pose một tay gồm position, quaternion scalar-first qw, qx, qy, qz và gripper, tổng cộng 8 chiều. Dataset Stage III lưu absolute targets, nhưng training chuyển từng target trong chunk thành delta so với cùng current state. Target thứ hai không phải delta so với target thứ nhất.
Khi inference, output transform khôi phục absolute EEF targets từ current state đó. Policy server trả target vật lý có timestamp; LIBERO client nội suy và chuyển pose error thành lệnh robosuite OSC. Controller OSC_POSE nhận command chuẩn hóa, không nhận trực tiếp vector absolute pose 8 chiều.
Quy ước gripper cũng phải khớp. Physical width, open fraction và signed controller command là ba dạng khác nhau. Raw RLDS converter trong repo xuất signed controller commands, nên không được thay tùy tiện cho EEF dataset của Stage III. Normalization guide mô tả contract cần giữ cùng checkpoint.
8. Inference: server và simulator client
Ở terminal thứ nhất, thay đường dẫn bằng checkpoint thực sự đã tạo. Chọn 30000 khi bạn có checkpoint đó; đây là mốc được paper dùng để báo cáo LIBERO dù lịch training kết thúc ở 50k.
.venv/bin/python scripts/serve/serve_policy.py \
  --env LIBERO --port 8001 policy:checkpoint \
  --policy.config=stage3_finetuning_libero \
  --policy.dir=checkpoints/stage3_finetuning_libero/libero_finetune/30000
Chờ server thông báo listening. Ở terminal thứ hai, bắt đầu bằng một task và vài trial để kiểm tra rendering, kết nối và action adapter:
MUJOCO_GL=egl uv run --project examples/libero --frozen \
  python examples/libero/main.py \
  --task-suite-name libero_spatial --seed 42 \
  --task-ids 0 --num-trials-per-task 3 --record-video all
Smoke checkpoint 10 hoặc 20 bước phải dùng đường dẫn experiment libero_smoke tương ứng; nó chỉ giúp kiểm tra cơ chế, khó tạo hành vi thành công. Đừng đánh giá chất lượng model dựa trên ba trial của một task.
Sau khi pipeline chạy ổn, đánh giá đầy đủ:
for suite in libero_spatial libero_object libero_goal libero_10; do
  MUJOCO_GL=egl uv run --project examples/libero --frozen \
    python examples/libero/main.py \
    --task-suite-name "$suite" --seed 42 --record-video failure
done
libero_10 tương ứng suite thường được gọi LIBERO-Long trong bảng paper. Client mặc định chạy 50 trials mỗi task; mỗi suite có 10 task. Để so sánh nghiêm túc, lặp lại với ba evaluation seeds và ghi rõ seed bạn chọn, nguồn initialization, checkpoint step cùng mọi thay đổi recipe. Paper có ba seeds; một lượt seed 42 không tương đương giao thức đó.
Failed-rollout videos mặc định nằm trong results/libero/videos. LIBERO evaluation guide còn có batch scheduling và checkpoint sweeps. Server chạy eager mặc định; đừng bật compile trong lần chạy đầu nếu bạn chưa tách được lỗi simulator khỏi độ trễ compilation.
9. Đọc kết quả đúng phạm vi
| Phương pháp | Spatial | Object | Goal | Long | Average |
|---|---|---|---|---|---|
| π₀.₅ | 98,8 | 98,2 | 98,0 | 92,4 | 96,9 |
| PLaW-VLA | 98,9 | 99,0 | 97,1 | 94,6 | 97,4 |
Theo Table 1 của paper, mức tăng trung bình là 0,5 điểm phần trăm, còn Long tăng 2,2 điểm. Goal lại thấp hơn backbone. Điều này giúp nhìn rõ lợi ích tập trung vào một số đặc tính temporal, thay vì tuyên bố model tốt hơn ở mọi suite.
Trên LIBERO-Plus zero-shot, tác giả báo cáo task-weighted average 72,7%; đây là benchmark perturbation khác LIBERO chuẩn. Trên RoboTwin Hard Horizon III, kết quả tăng từ 67,4% lên 79,2%, tức 11,8 điểm phần trăm. Không gán mức tăng đó cho LIBERO. Các số này là kết quả tác giả công bố, không phải benchmark do hướng dẫn này chạy lại. Nguồn: phần Experiments.
Ablation thay V-JEPA 2 bằng Cosmos VAE cho LIBERO-Plus đạt 70,93%, thấp hơn 1,77 điểm; masking toàn bộ future states tại inference làm LIBERO giảm còn 93,05%. Những so sánh ấy hỗ trợ vai trò của latent space và future conditioning, nhưng không chứng minh một world model luôn hữu ích trên mọi robot. Nguồn: Table 4.

Robot thật được đánh giá bằng normalized task progress, khác success rate nhị phân trong mô phỏng. Nhớ kiểm tra định nghĩa metric trước khi đặt hai biểu đồ cạnh nhau. Một rollout hoàn thành ba bước trong bốn bước có thể nhận progress score cao nhưng vẫn thất bại theo tiêu chí hoàn thành toàn tác vụ.
10. Kiểm tra lỗi và chọn experiment tiếp theo
Nếu gặp EGL error, kiểm tra driver cùng runtime rendering trước; tài liệu cho phép MUJOCO_GL=glx với hệ thống có X display. Nếu client không kết nối, kiểm tra server đã listening, host và port. Nếu robot chuyển động vô lý dù inference trả output, kiểm tra normalization assets, quaternion order và gripper convention trước khi sửa kiến trúc.
Nếu action loss giảm nhưng success rate không tăng, xem video theo từng giai đoạn: tiếp cận, gắp, di chuyển và thả. Đếm failure mode giúp bạn phân biệt lỗi perception, sai controller adapter và thiếu dữ liệu phục hồi. Khi so sánh baseline, giữ dataset, seed, budget và execution adapter giống nhau; thay đổi nhiều yếu tố cùng lúc sẽ làm mất khả năng quy kết cải thiện.
Mốc hoàn thành đầu tiên nên là một checkpoint hợp lệ, một policy server hoạt động và một rollout được lưu. Mốc tiếp theo là đánh giá toàn suite có ghi provenance. Chỉ khi hai bước đó rõ ràng mới đáng mở rộng sang pretraining đầy đủ hoặc robot thật. Latent future prediction cung cấp thêm context cho hành động, còn chất lượng dữ liệu và execution contract vẫn quyết định robot có thực hiện đúng hay không.