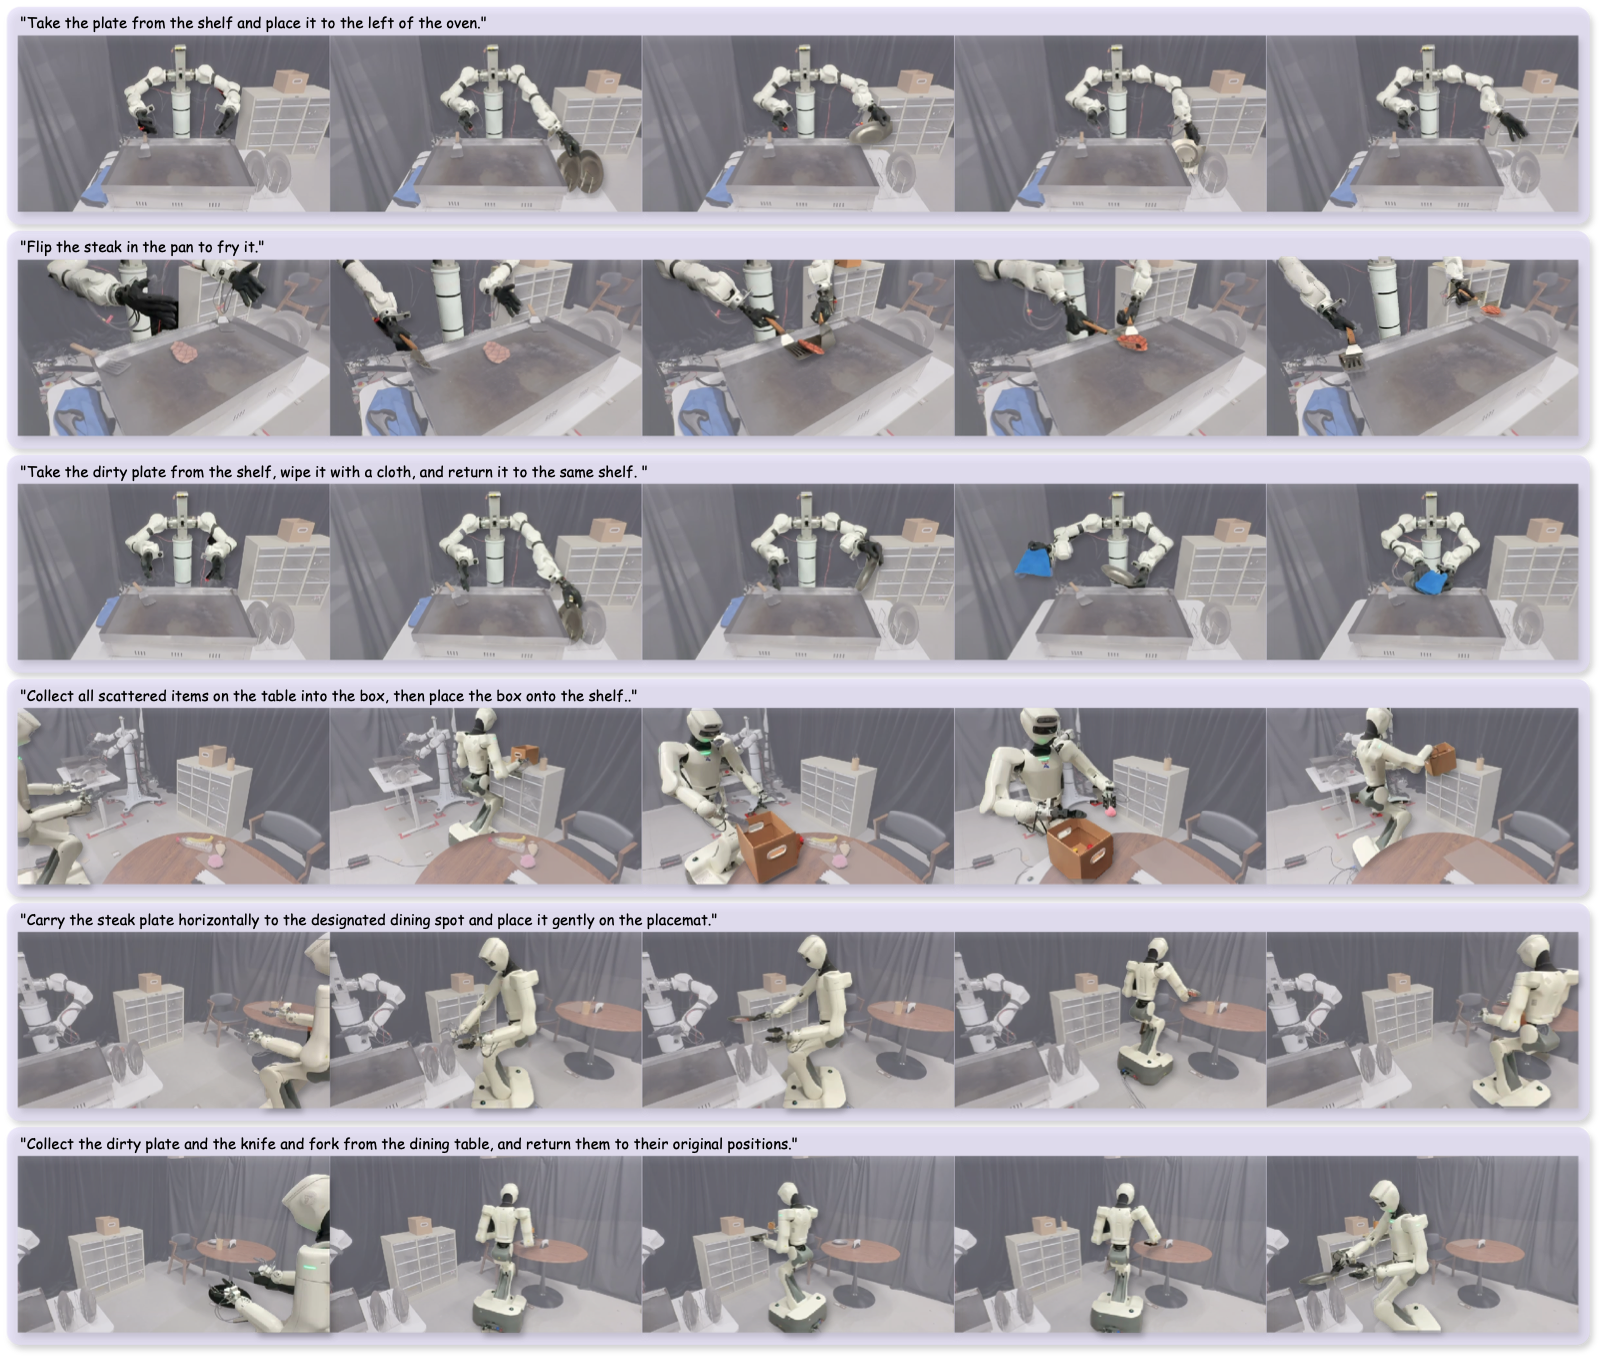
Video cho thấy một người nhấc cốc, nhưng không cho biết motor của robot phải quay bao nhiêu. Ngay cả dữ liệu robot cũng khó ghép: một hệ điều khiển nhận joint positions, hệ khác nhận end-effector pose, robot hai tay lại có số chiều khác. RynnVLA-Latent tìm một lớp biểu diễn trung gian để học chuyển động từ nhiều nguồn video trước khi học lệnh điều khiển của robot đích.
Bài này bắt đầu bằng dữ liệu tổng hợp đi kèm repository. Bạn sẽ hiểu kiến trúc, cài môi trường, kiểm tra dataset, chạy smoke training, rồi biết cần bổ sung gì để post-train và inference. Không cần sở hữu robot để thực hiện phần đầu. Tuy nhiên, checkpoint Stage 1 chưa phải policy điều khiển; muốn đánh giá closed-loop phải hoàn thành Stage 2 với demonstrations có nhãn hành động.
Nguồn chính là paper RynnVLA-Latent của Haoyu Zhao và cộng sự, bản preprint ngày 25/10/2026, cùng repository chính thức. Các lệnh bên dưới được đối chiếu với mã nguồn công khai ngày 01/11/2026; bài viết không tuyên bố đã chạy GPU training hay tái lập benchmark.
1. Ý tưởng: học chuyển động trước, căn chỉnh điều khiển sau
VLA là Vision-Language-Action: mô hình nhận quan sát hình ảnh, instruction và, tùy giai đoạn, trạng thái robot để dự đoán hành động. Khó khăn nằm ở chữ Action. Cùng thao tác đặt cốc xuống bàn nhưng tay người, gripper và bàn tay nhiều ngón không dùng chung command space.
RynnVLA-Latent chia việc học thành hai giai đoạn policy. Stage 1 học dự đoán latent actions, tức vector mô tả chuyển tiếp giữa các quan sát, từ hình ảnh và ngôn ngữ. Stage 2 dùng demonstrations của embodiment đích để chuyển đầu ra thành native robot actions. Robot vẫn cần dữ liệu điều khiển thật ở giai đoạn cuối; video không tự loại bỏ nhu cầu đó.
Công cụ tạo nhãn là RynnLAM, một latent-action model học self-supervised. Nó xem cặp frame hiện tại và tương lai để tạo descriptor. Sau đó policy học dự đoán descriptor ấy chỉ từ thông tin quan sát được tại thời điểm quyết định. Việc RynnLAM nhìn frame tương lai khi tạo nhãn offline không có nghĩa robot cần nhìn tương lai lúc chạy.
Nếu muốn củng cố khái niệm observation, episode và policy trước, hãy đọc thực hành LeRobot cho người mới.
2. Vì sao latent actions cần thông tin 3D?
Trong video egocentric, camera có thể quay khi người đang đứng yên. Nếu mô hình chỉ nhìn chuyển động pixel, nó dễ nhầm camera motion với hành động thao tác. RynnLAM dùng geometric supervision để khuyến khích biểu diễn gắn với chuyển động vật lý.

Nguồn: Figure 3 trong paper RynnVLA-Latent của nhóm tác giả.
Descriptor ktoken_zcam có 608 chiều, gồm ba phần:
| Thành phần | Số chiều | Vai trò |
|---|---|---|
| Local motion tokens | 8 × 64 = 512 | Nén thông tin chuyển động cục bộ |
| Global action latent | 64 | Tóm tắt chuyển tiếp liên quan đến thao tác |
| Camera latent | 32 | Biểu diễn chuyển động camera tương đối |
Backbone của RynnLAM dựa trên Depth Anything 3. Encoder sử dụng gated temporal difference giữa đặc trưng của hai frame, làm nổi bật thay đổi và giảm ảnh hưởng của nội dung tĩnh. Các readout tokens và motion queries tạo những thành phần của latent.
Năm mục tiêu huấn luyện bổ sung cho nhau. Residual feature reconstruction dự đoán thay đổi đặc trưng thay vì sao chép toàn bộ ảnh. Dynamic 3D flow sử dụng pseudo-label từ depth, camera poses và optical flow, có bù camera motion. Contrastive feature loss khuyến khích đặc trưng sau flow warping gần frame đích hơn frame nguồn. Camera pose loss buộc camera latent mang thông tin pose. Gradient reversal làm global action latent khó tiết lộ camera pose.
Một chi tiết cần giữ chính xác: cơ chế camera decoupling tác động lên global action latent. Toàn bộ descriptor 608 chiều vẫn chứa camera latent, vì vậy không nên gọi toàn bộ vector là hoàn toàn camera-invariant. Geometric pseudo-label cũng là ước lượng; chúng có thể sai khi bị che khuất hoặc khi ước lượng depth kém.
3. Policy kết hợp VLM và action expert như thế nào?
RynnVLA-Latent dùng Mixture-of-Transformers. RynnBrain xử lý instruction và ảnh nhiều góc nhìn thành VLM prefix. Một action expert hẹp hơn tương tác với prefix qua attention theo từng layer, nhưng có đường projection và feed-forward riêng. Prefix giữ causal attention; action suffix được nhìn prefix và tương tác hai chiều bên trong phần hành động.

Nguồn: Figure 4 trong paper RynnVLA-Latent của nhóm tác giả.
Tên 2B và 4B chỉ backbone, không phải tổng số tham số policy. Paper báo tổng khoảng 2,51B và 5,04B sau khi cộng action expert. Expert có hidden size 768. Giao diện quan sát hỗ trợ sáu camera slots; view không có được mask khỏi attention và loss. Điều đó giúp trộn dữ liệu có camera khác nhau, nhưng không bảo đảm thành công với mọi góc nhìn mới.
Policy học bằng flow matching. Có thể hình dung mô hình nhận một action chunk bị trộn với Gaussian noise và học hướng biến đổi từ noise về chunk hợp lý, có điều kiện theo ảnh và ngôn ngữ. Inference bắt đầu từ noise, tích phân velocity field bằng Euler steps. VLM prefix được tái sử dụng qua các bước này.
Stage 1 dự đoán chunk gồm sáu latent targets. Trong config còn có action_chunk_size: 30; đây không phải cách nói rằng có 30 descriptor 608 chiều. Cần đọc cùng latent_action_chunk_size: 6 và latent_action_stride: 5. Stage 2 chuyển sang native action chunk dài 10 trong preset V5, thêm proprioception và đổi projection đầu ra. Không có một decoder latent-to-motor độc lập được gắn thêm sau policy.
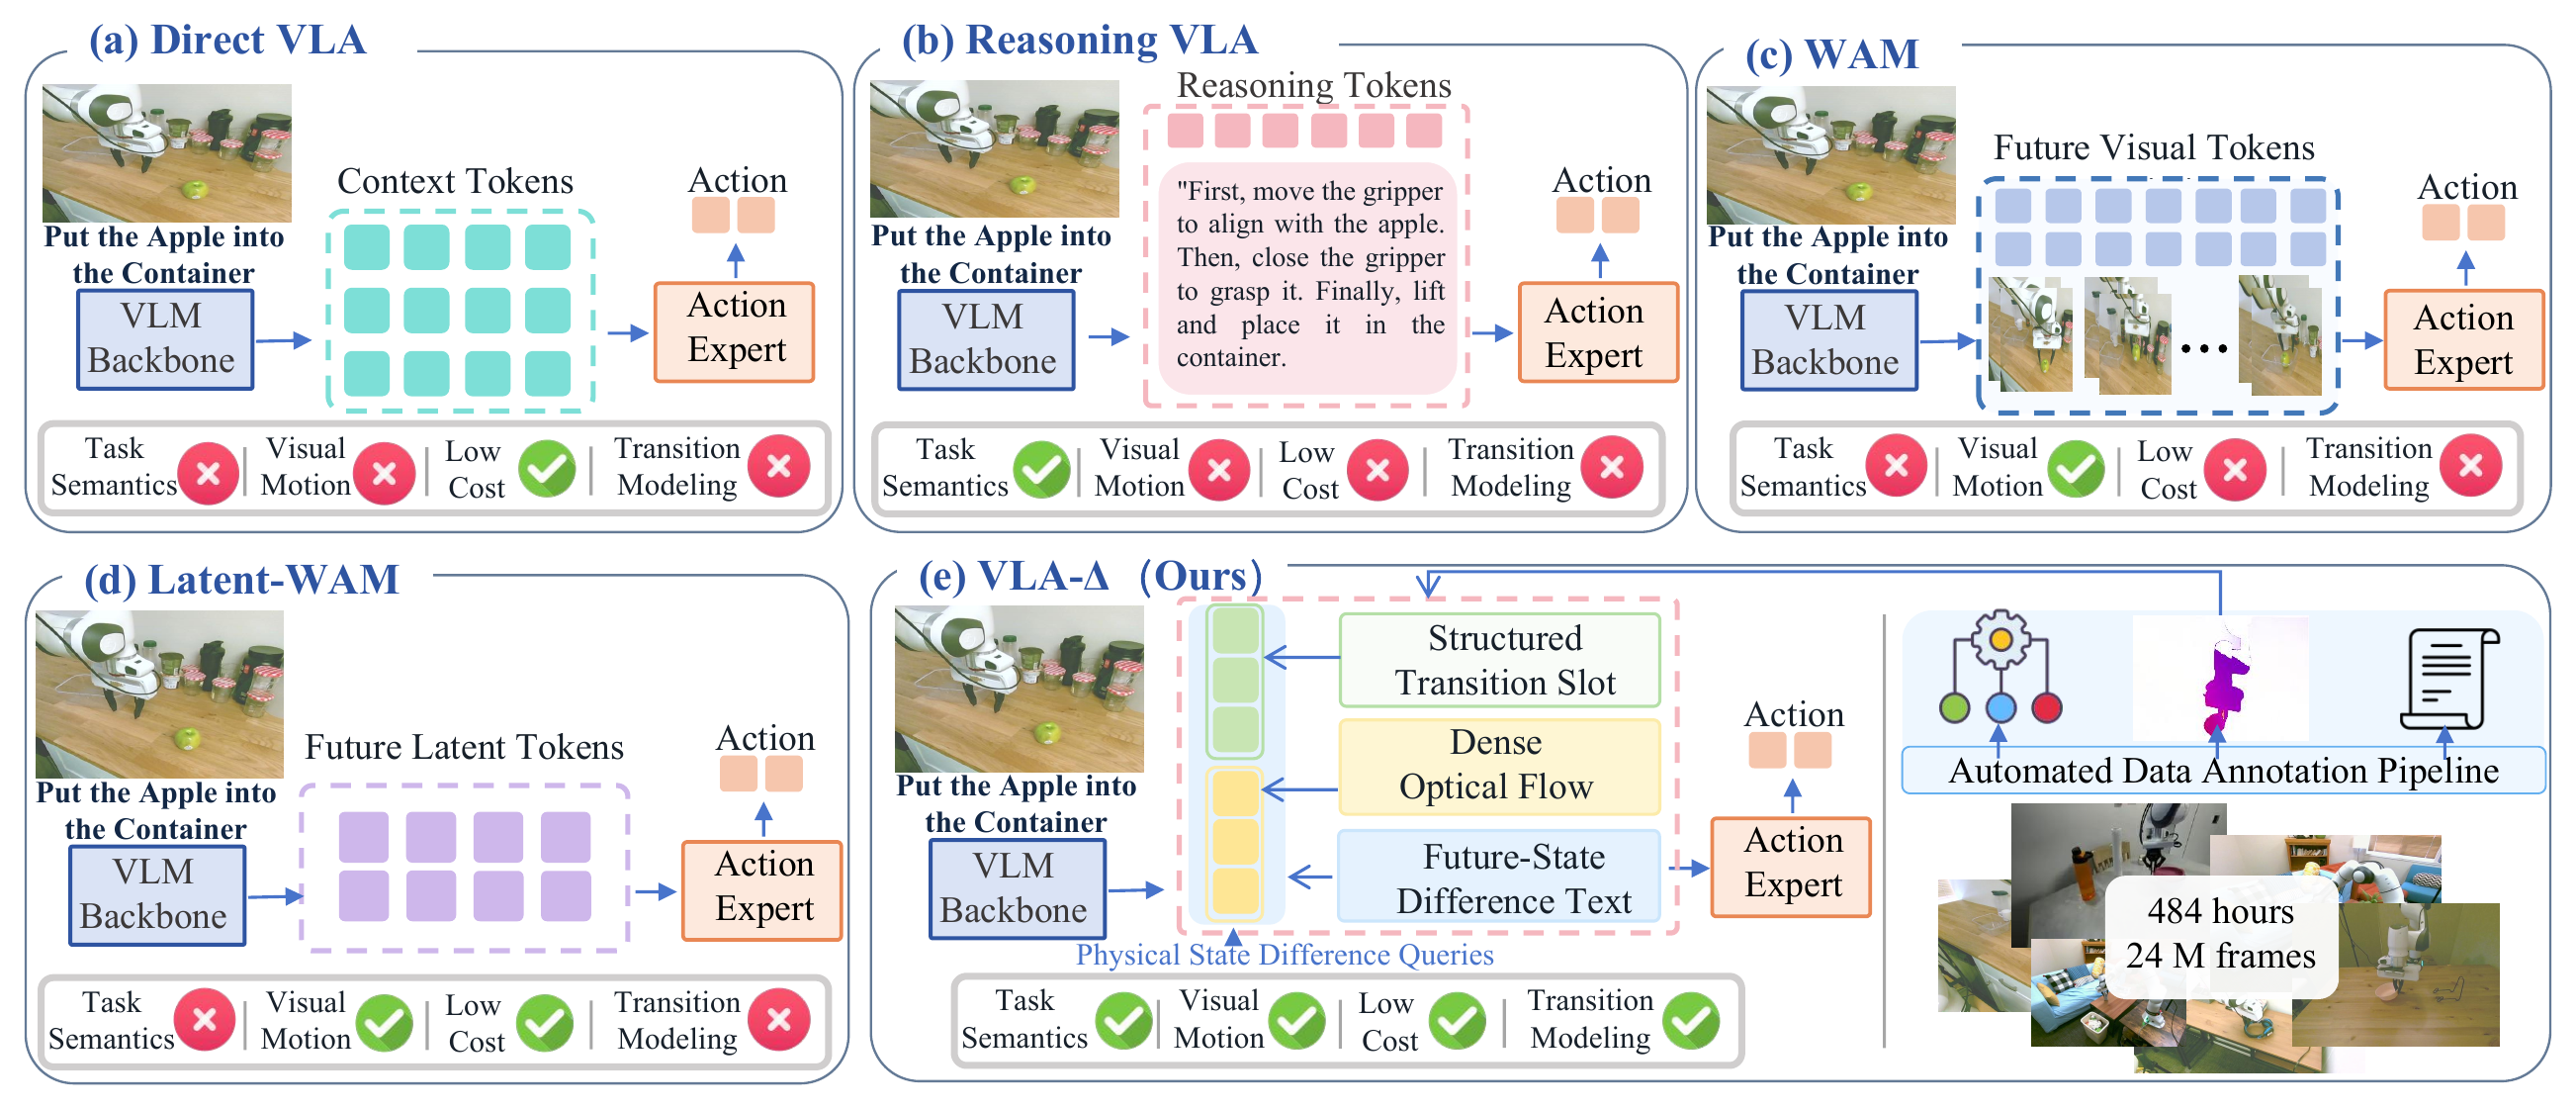
Để so sánh với hướng học đặc trưng video, xem VLA-JEPA và latent world models.
4. Cài đặt trong môi trường riêng
Phần training hướng đến Linux và NVIDIA CUDA. requirements.txt hiện tham chiếu Python 3.10, PyTorch 2.7.1 CUDA 12.6, Transformers 5.2.0 và flash-attn wheel cho Linux x86_64. Vì wheel có ràng buộc ABI, không nên mặc định nó chạy trên ARM64, macOS hoặc mọi tổ hợp Python/CUDA.
Bạn có thể tải source archive mà không cần Git. Thực hiện trong thư mục học tập riêng, chưa có thư mục RynnVLA-Latent-main:
curl -fL https://github.com/alibaba-damo-academy/RynnVLA-Latent/archive/refs/heads/main.tar.gz -o rynnvla-latent-main.tar.gz
tar -xzf rynnvla-latent-main.tar.gz
cd RynnVLA-Latent-main
conda create -y -n rynnvla python=3.10
conda activate rynnvla
python -m pip install -r requirements.txt
Archive main có thể thay đổi về sau. Khi làm thí nghiệm cần tái lập, ghi lại phiên bản source bạn tải cùng toàn bộ config và model identifier. Không dùng tên model làm bằng chứng rằng hai lần chạy có cùng weights.
Kiểm tra môi trường trước khi training:
python -c "import torch; print(torch.__version__); print(torch.cuda.is_available())"
python -c "import rynnvla, rynnlam; print('packages OK')"
python -c "import flash_attn_2_cuda; print('flash-attn extension OK')"
Import compiled extension giúp phát hiện wheel thiếu hoặc sai ABI. Nếu gặp lỗi wheel tải về có dung lượng bằng không, xử lý download trước; nếu báo undefined symbol, kiểm tra tổ hợp Torch, CUDA, Python và ABI. Đừng thay hàng loạt package trong môi trường training đang sử dụng cho dự án khác.
5. Bắt đầu với hai bộ dữ liệu mẫu
Repository cung cấp hai corpus synthetic, có mục đích kiểm tra đường đi dữ liệu và training:
| Thư mục | Nội dung | Dùng cho |
|---|---|---|
data/sample/ |
3 episodes, mỗi episode 24 latents 608 chiều; video, index và stats | Dataset Stage 1 của VLA |
data/sample_lam/ |
3 scenes, mỗi scene 12 frames kích thước 56 × 56 | RynnLAM training |
Bắt đầu bằng kiểm tra CPU, chưa cần backbone weights:
bash scripts/smoke.sh --only data
Script đọc dữ liệu bằng LatentPretrainDataset, không chỉ kiểm tra file có tồn tại. Nó xác nhận có ảnh giải mã được, trường text, slot mask và latent targets hữu hạn có chiều cuối bằng 608. Kết quả mong đợi là thông báo [verify] OK; số sample thực tế phải lấy từ log, không suy ra bằng cách nhân số episode với số latent.
Mixture mẫu có cấu trúc sau, được trích từ data/sample/sample_mixture.json:
[
  {
    "data_type": "LatentPretrainDataset",
    "data_path": "data/sample/build/index_c6.npz",
    "latent_stats_path": "data/sample/build/latent_stats.json",
    "latent_chunk": 6,
    "latent_step_seconds": 0.25,
    "dataset_weights": {"SampleToy": 1.0}
  }
]
data_path trỏ đến index, không phải thư mục video bất kỳ. latent_stats_path cung cấp thống kê tương ứng với latent corpus. Khi đổi dữ liệu, phải bảo đảm video, latent timestamps, index và stats cùng khớp. Launcher không tự tải dataset, trích latent hay xây index. JSON cũng không tự mở rộng biến môi trường trong chuỗi đường dẫn.
6. Chạy RynnLAM smoke training
Sau khi kiểm tra dataset, chạy:
bash scripts/smoke.sh
Mặc định script kiểm tra dữ liệu rồi chạy RynnLAM hai optimizer steps. Config rynnlam/configs/smoke.yaml sử dụng encoder khởi tạo ngẫu nhiên, batch size 1, không cần DA3 weights bên ngoài. Cả năm nhánh loss đều được bật để kiểm tra training, checkpointing và internal evaluation.
Checkpoint nằm dưới runs/smoke_lam. Hãy xác nhận process kết thúc thành công, loss hữu hạn và checkpoint được ghi. Loss nhỏ trên dữ liệu synthetic không chứng minh encoder hiểu chuyển động thật. Smoke recipe cũng không phải phiên bản thu nhỏ đủ để tái lập benchmark.
Nếu muốn gọi riêng trainer, dùng lệnh sau thay cho wrapper:
python scripts/train_rynnlam.py --config rynnlam/configs/smoke.yaml
Để huấn luyện RynnLAM thật, repository yêu cầu DA3-Large encoder weights đúng kiến trúc, bao gồm QK normalization. Paper mô tả giai đoạn encoder frozen 36.000 steps rồi unfrozen 20.000 steps. Hai giai đoạn của RynnLAM này khác với Stage 1/Stage 2 của VLA policy. Đặt tên run rõ ràng giúp tránh nạp nhầm checkpoint của hai loại mô hình.
7. Smoke VLA và bước sang training thật
Để smoke cả VLA, cần một local RynnBrain-2B hoặc checkpoint thuộc họ Qwen3-VL được script hỗ trợ để lấy tokenizer/processor assets. Thay đường dẫn ví dụ bằng thư mục đã tải đầy đủ:
bash scripts/smoke.sh --src /path/to/RynnBrain-2B
Script tạo tiny backbone khoảng 44M tham số với weights ngẫu nhiên rồi chạy hai steps. Đây không phải fine-tune nguyên mô hình 2B. Nếu không truyền --src và chưa có tiny backbone, VLA stage được ghi là skipped; wrapper chạy thành công không đồng nghĩa mọi stage đã chạy.
Khi chuyển sang Stage 1 thật, trước hết chuẩn bị local RynnBrain weights và mixture/index/stats của corpus đã được RynnLAM gán nhãn. Lệnh sau là mẫu cho các assets phải có sẵn, không phải lệnh tải tự động:
python -m rynnvla.api.launch \
  --stage stage1_2b \
  --model-path models/RynnBrain-2B \
  --data-mixture configs/data_latent_pretrain.local.json \
  --output-dir runs/stage1-2b \
  --nproc-per-node 8
Có thể thêm --dry-run để xem command mà chưa khởi động training. Preset tham chiếu dùng micro batch 4, gradient accumulation 4 và tám ranks, tương ứng global batch 128. Giảm xuống một GPU không tự giữ nguyên batch hay learning rate. Gradient checkpointing và bf16 hỗ trợ tiết kiệm bộ nhớ, nhưng bài này không đưa ra cam kết VRAM tối thiểu vì còn phụ thuộc ảnh, sequence length và optimizer.
8. Stage 2: biến mô hình thành policy robot
Bạn có thể dùng Stage-1 export mình huấn luyện hoặc checkpoint Stage 1 do tác giả phát hành. Tải đủ assets về local trước; runtime dùng local_files_only=True.
Nếu dùng run Stage 1 của mình, ví dụ export EMA tại step 60.000:
mkdir -p models
python -m rynnvla.api.export_checkpoint \
  --checkpoint-dir runs/stage1-2b/checkpoint-60000 \
  --output-dir models/stage1-2b-ema \
  --weights ema --format safetensors
Checkpoint phải tồn tại và có ema_model.bin; lựa chọn EMA không âm thầm fallback sang live weights. Thư mục đích export chưa được tồn tại. Tiếp theo, chuẩn bị các LIBERO demonstrations theo layout của configs/data_libero_joint40.example.json, sửa đường dẫn vào một mixture local hợp lệ, rồi chạy:
python -m rynnvla.api.launch \
  --stage stage2_2b \
  --model-path models/stage1-2b-ema \
  --data-mixture configs/data_libero_joint40.local.json \
  --output-dir runs/stage2-2b \
  --nproc-per-node 8
Đây là optimizer run mới, không phải resume Stage 1. --resume chỉ dành cho tiếp tục cùng stage và cùng output directory. Sample synthetic không thay thế demonstrations có nhãn của Stage 2. Bạn cũng cần kiểm tra camera mapping, state schema, normalization và action representation theo embodiment, nhất là khi chuyển từ một tay sang hai tay.
9. Inference: kiểm tra offline trước, closed-loop sau
Sau Stage 2, export một checkpoint có thật sang HF directory; ví dụ dưới đây giả định run đã lưu checkpoint tại step 2.000:
mkdir -p exports
python -m rynnvla.api.export_checkpoint \
  --checkpoint-dir runs/stage2-2b/checkpoint-2000 \
  --output-dir exports/stage2-2b \
  --weights model --format safetensors
python -m rynnvla.api.predict --help
Offline predictor nhận JSON có instruction, state, front, wrist, với hai trường cuối trỏ đến ảnh tương đối so với JSON. state phải đúng LIBERO schema; không điền vector tùy ý. Output là .npy chứa raw OSC commands dạng (T, 7). Dùng --sample và --output theo CLI để kiểm tra một observation đã chuẩn bị, trước khi nối simulator.
Closed-loop cần cài upstream LIBERO cùng robosuite/MuJoCo, BDDL tasks và offscreen rendering; repository này không cung cấp simulator. Sau khi tương thích môi trường được giải quyết, dùng:
python -m rynnvla.api.eval_libero \
  --model-path exports/stage2-2b \
  --suite libero_spatial --task-id 0 --episodes 1 \
  --seed 7 --output-dir results/libero-spatial-task0 \
  --replan-steps 10 --denoising-steps 10 --save-frames
Adapter chịu trách nhiệm image orientation, state conversion và chuyển rot6d thành OSC. Không tự xoay ảnh hoặc rescale action lần nữa trước adapter. Một episode chỉ xác nhận integration; để báo benchmark cần suite đầy đủ, nhiều episodes, checkpoint cụ thể, seeds và ngân sách rollout/replanning rõ ràng.
10. Kết quả paper và cách đọc đúng
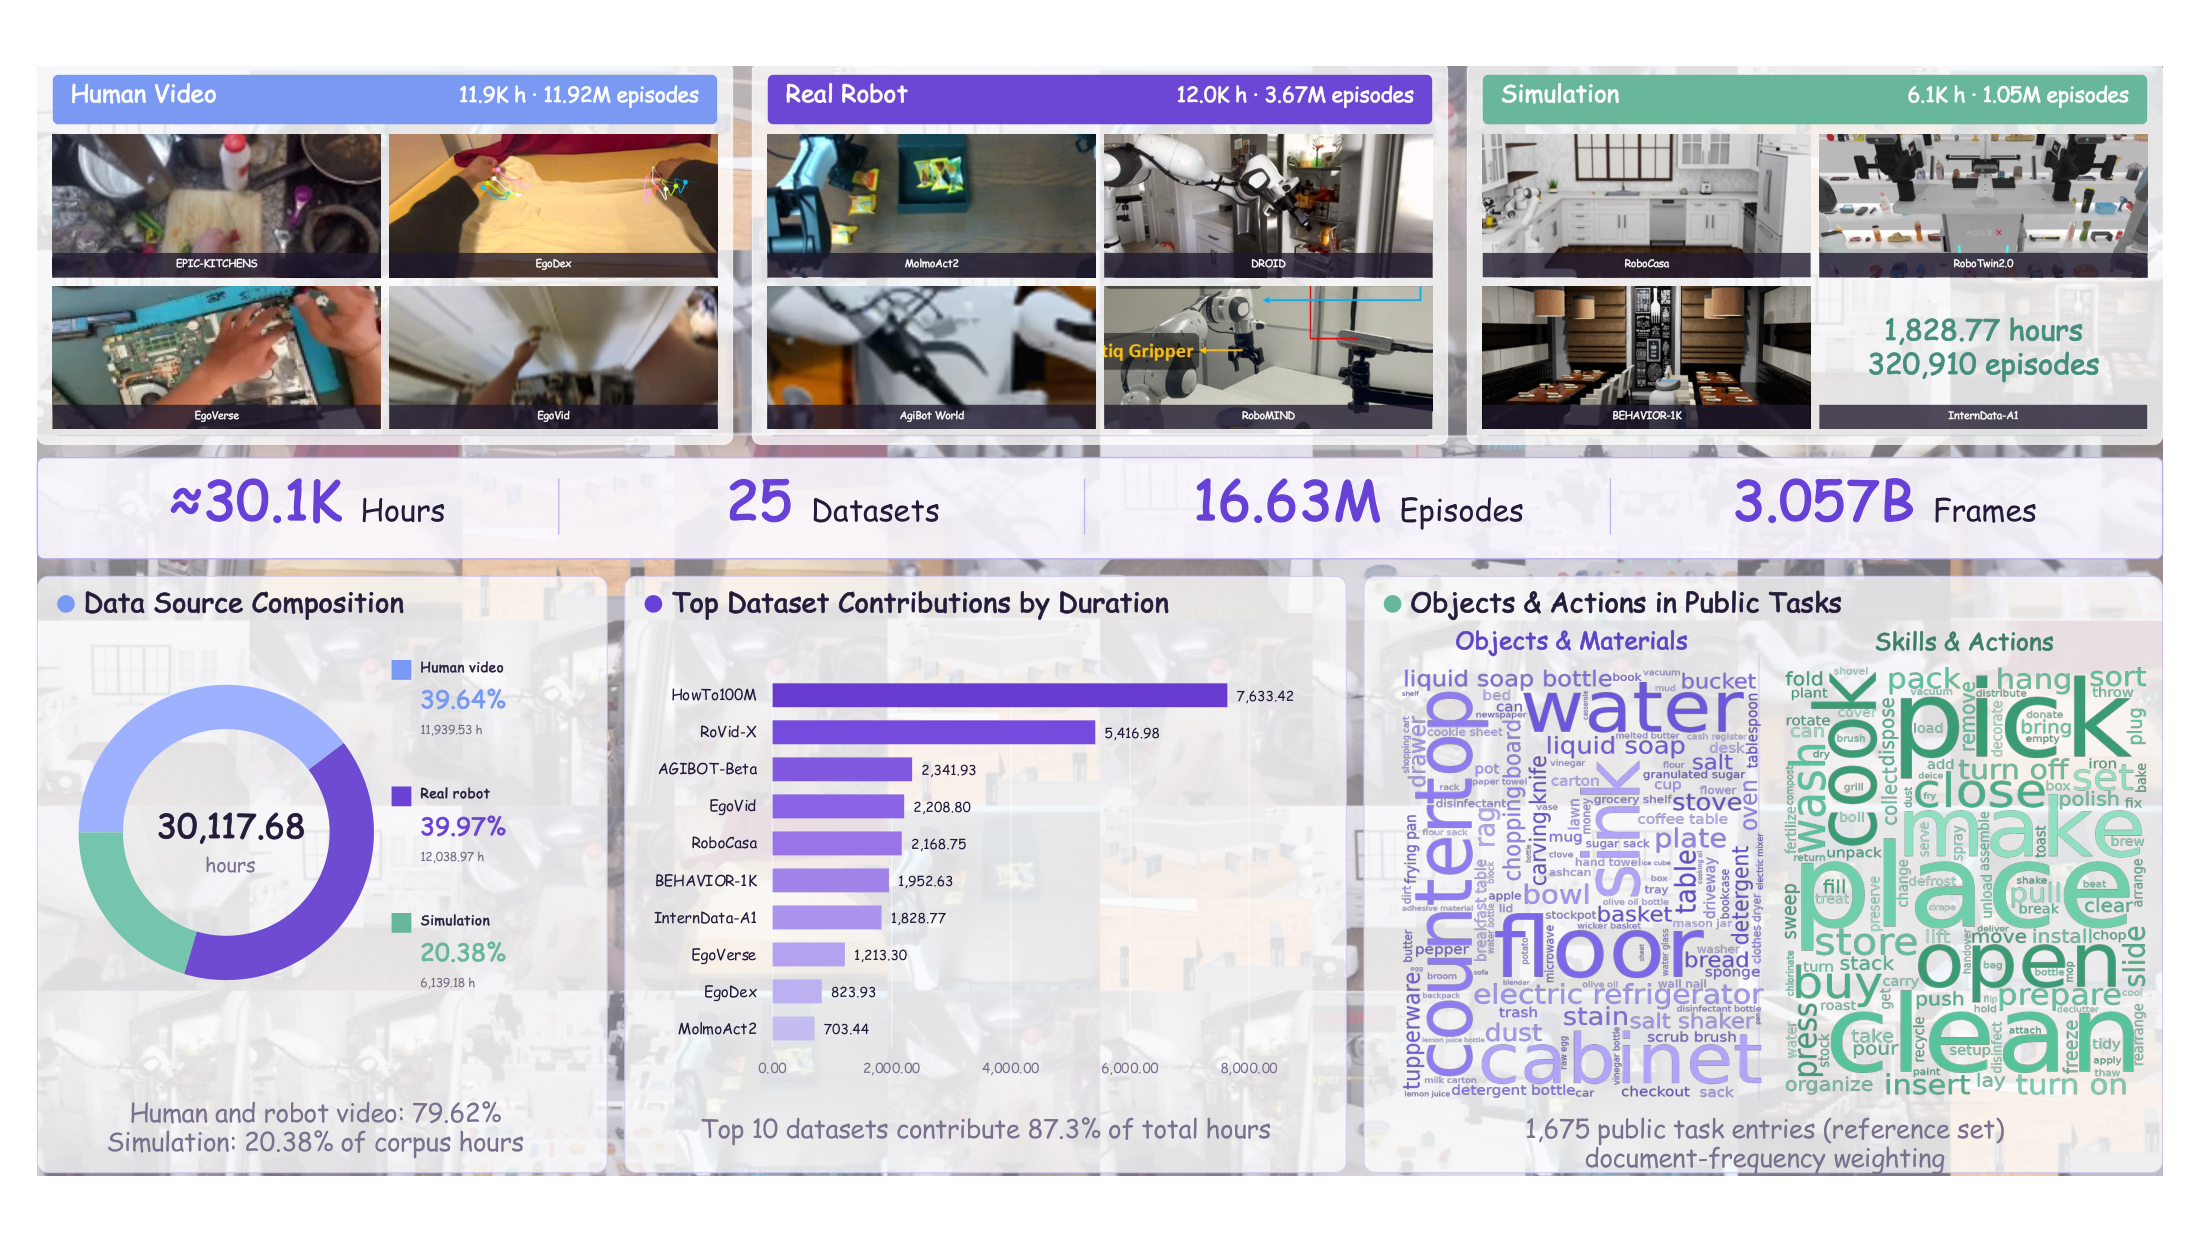
Nguồn: hình Training Data trên project page chính thức.
Paper dùng 30,1 nghìn giờ video từ 25 datasets, tạo khoảng 745,52 triệu descriptors. Đây là quy mô nghiên cứu, khác hoàn toàn ba episode synthetic. Các kết quả dưới đây là tác giả báo cáo cho policy 4B đã post-train, không phải kết quả của hướng dẫn này:
| Benchmark | Kết quả báo cáo | Phạm vi cần nhớ |
|---|---|---|
| LIBERO | 98,8% | Trung bình trên các suites theo protocol paper |
| LIBERO-Plus | 84,7% | Checkpoint fine-tune LIBERO, không adaptation riêng cho Plus |
| RoboTwin 2.0 | 88,6% | Trung bình theo Native protocol |
| VLABench | 51,9% | Trung bình năm tracks |
Nguồn số liệu: paper, phần Experiments và bảng Results của project. “Zero-shot” trên LIBERO-Plus không có nghĩa policy chưa từng được học robot actions. Paper còn đánh giá sáu tác vụ thật trên hai platforms, nhưng không suy ra tỷ lệ thành công tương tự trên robot, vật thể và camera của bạn.
Các hạn chế thực tế gồm chất lượng geometric pseudo-label, chi phí auto-labeling và training, sự cần thiết của demonstrations đích, cùng khoảng cách giữa synthetic smoke và closed-loop manipulation. RoboTwin/VLABench có policy adapters nhưng simulator, runner và corpus không được phân phối đầy đủ trong repo; không nên hứa một lệnh sẽ tái lập mọi bảng số liệu.
Bước học tiếp hợp lý là giữ bộ sample làm kiểm tra cài đặt, sau đó chọn một embodiment và một task có demonstrations đáng tin cậy. Ghi riêng dataset validation, training loss, offline prediction và closed-loop success. Chỉ khi các lớp này đều được kiểm chứng mới mở rộng sang nhiều task hoặc robot thật. Nếu muốn đối chiếu một cách dùng future prediction khác, đọc PLAW và V-JEPA 2 cho LIBERO.