Một robot gắp vật không cần phân tích mọi góc của bàn với cùng mức độ chi tiết ở mọi thời điểm. Khi tìm chiếc cốc, policy cần ngữ cảnh rộng. Khi đầu kẹp đã ở sát cốc, vùng tiếp xúc có thể quan trọng hơn phần nền phía xa. Tuy nhiên, một Vision-Language-Action model thường đưa cả chuỗi visual token qua LLM backbone mỗi lần dự đoán hành động, ngay cả khi nhiều token không giúp ích cho quyết định hiện tại.
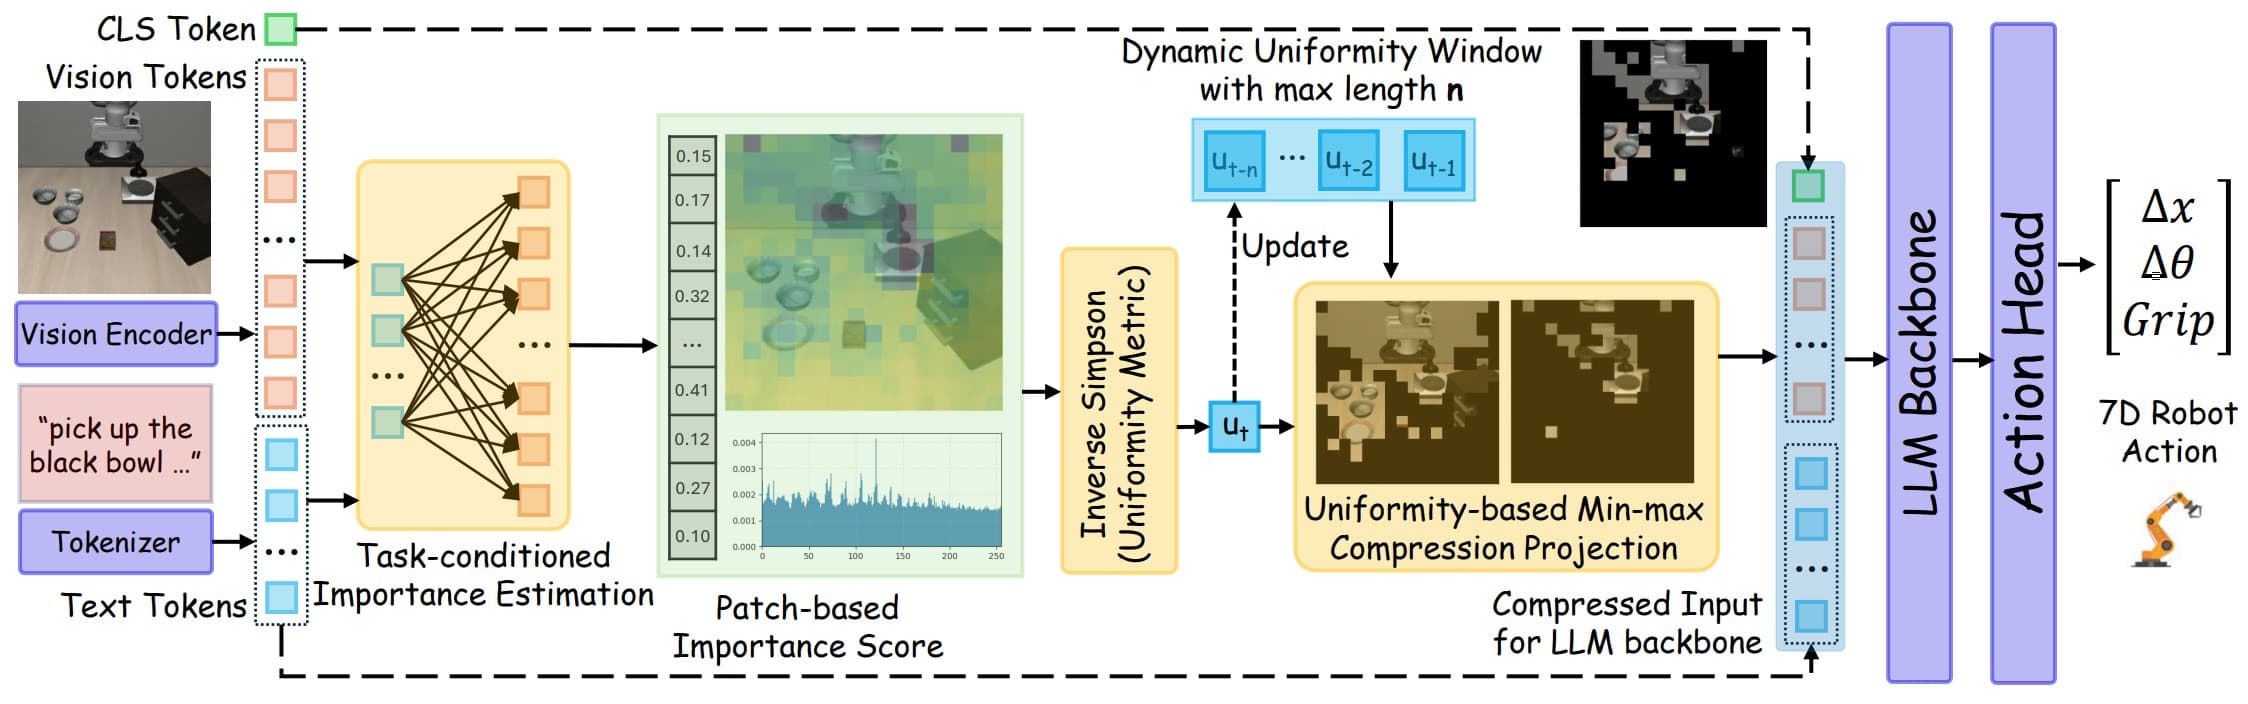
FastVLA của Jiuyi Xu và cộng sự giải quyết chi phí này bằng visual token pruning thích ứng theo nhiệm vụ và thời gian. Bạn giữ nguyên policy đã học, bổ sung bước lựa chọn token trước LLM, rồi để số token được giữ thay đổi theo từng lần dự đoán. Bài này hướng dẫn đọc thuật toán, dựng môi trường và đánh giá OpenVLA-OFT trên LIBERO; không yêu cầu bạn tự huấn luyện một VLA từ đầu.
Nguồn gốc cần đọc là paper FastVLA và repo jiuyixu25/FastVLA. Đây là phương pháp nén token của nhóm Xu; khi tìm kiếm, hãy đối chiếu tác giả và repo vì có công trình Fast-VLA khác dùng task memory. Các kết quả bên dưới là số liệu tác giả công bố, không phải benchmark tôi đã chạy trên phần cứng riêng.
1. Nắm ba khái niệm trước khi chạy
Visual token là vector biểu diễn một phần thông tin hình ảnh. Vision encoder biến ảnh camera thành các vector, sau đó projector đưa chúng về không gian biểu diễn mà language backbone tiếp nhận được. Nhiều camera thường tạo ra nhiều token hơn, kéo theo chi phí xử lý lớn hơn.
Closed-loop control nghĩa là robot liên tục nhận quan sát, dự đoán hành động, thực hiện rồi quan sát lại. Độ trễ của policy ảnh hưởng khoảng thời gian giữa những lần robot có thể phản ứng với thay đổi. Một policy chính xác nhưng phản hồi chậm vẫn có thể gặp khó khăn khi vật trượt hoặc cảnh bị che khuất.
Action chunk là một nhóm hành động được dự đoán trong một lần gọi model. OpenVLA-OFT trong đánh giá này dự đoán tám hành động mỗi lần. Vì vậy, cần phân biệt số hành động thực thi mỗi giây với số lần model nhận ảnh mới mỗi giây. Nếu bạn chưa quen pipeline từ ảnh đến hành động, đọc thêm phân tích OpenVLA.
Bạn có thể bắt đầu trên một máy Linux có NVIDIA GPU và môi trường CUDA tương thích PyTorch. README mô tả đánh giá LIBERO cần một GPU khoảng 16 GB VRAM; kết quả công bố được đo trên RTX 4090. Đây là thông tin để chọn môi trường thử nghiệm, không phải cam kết mọi GPU 16 GB đều đạt cùng tốc độ hoặc chạy được mọi cấu hình khác.
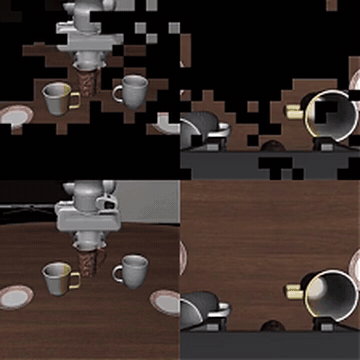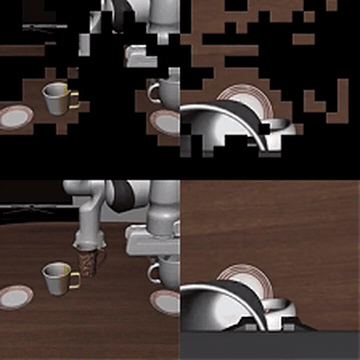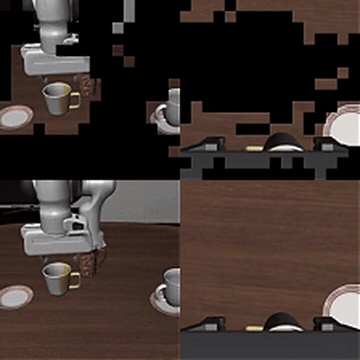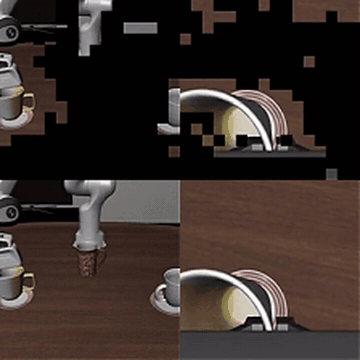
GIF từ repo giúp bạn thấy rõ khác biệt giữa ảnh đầu vào và phần thông tin policy thực sự đưa qua LLM. Vùng màu đen biểu thị token bị bỏ, không có nghĩa camera ngừng chụp vùng đó.
2. Kiến trúc: nén ở đâu trong pipeline?
Luồng xử lý có thể hình dung như sau:
Ảnh camera -> vision encoder -> projector -> visual tokens
                                               |
Instruction -> task token embeddings ----------+-> FastVLA
                                                    |
                                    BOS + visual tokens giữ lại
                                        + task tokens
                                                    |
                                               LLM backbone
                                                    |
                                                action head
                                                    |
                                            action chunk -> robot
Sơ đồ trên mô tả khái niệm; các nhánh như proprioception phụ thuộc integration cụ thể. File fastvla/core.py làm việc với chuỗi [BOS | N visual tokens | task tokens]. Module giữ BOS và phần task, chỉ rút ngắn phần visual. Các token được chọn vẫn xuất hiện theo thứ tự ban đầu và giữ position ID gốc. Không nên tự sắp xếp chúng theo điểm importance rồi chuyển thẳng sang LLM, vì như vậy bạn thay đổi cấu trúc vị trí mà policy đã quen.
Điều này cũng xác định giới hạn tăng tốc: vision encoder vẫn phải tạo token trước khi FastVLA chấm điểm. Phương pháp giảm công việc của LLM backbone, không loại bỏ toàn bộ chi phí camera, preprocessing, vision encoding hay action head. Xem implementation độc lập của FastVLA để đối chiếu đầu vào và đầu ra.
3. Thuật toán: chọn token nào và giữ bao nhiêu?
Chấm importance theo instruction
FastVLA áp dụng RMSNorm cho task embeddings và visual embeddings, tính scaled dot-product, softmax theo trục visual token rồi lấy trung bình qua task tokens. Bạn có thể đọc phép tính bằng biểu diễn sau:
A = softmax(RMSNorm(T) @ RMSNorm(V).T / sqrt(d), visual_axis)
s[i] = mean(A[:, i], task_axis)
T chứa biểu diễn ngôn ngữ của nhiệm vụ, V chứa biểu diễn ảnh, d là hidden dimension. Điểm s[i] cao nghĩa là visual token đó nhận nhiều attention từ phần task. Đây là phép chấm điểm trên embeddings ở đầu vào LLM, không cần chạy toàn bộ decoder để lấy attention map từ một layer sâu.
Ví dụ trực giác: instruction yêu cầu đặt cốc vào đĩa thì vùng cốc, đĩa và tương tác có thể hữu ích hơn họa tiết trên bàn. Tuy nhiên, attention chỉ là tín hiệu xấp xỉ importance; nó không chứng minh token nào chắc chắn không cần cho điều khiển. Vì thế, việc đo success rate sau pruning vẫn bắt buộc.
Đo sự tập trung bằng inverse Simpson
Nếu vài token chiếm hầu hết điểm importance, policy có thể cần ít token hơn. Nếu điểm trải tương đối đều, loại quá nhiều token có nguy cơ mất ngữ cảnh. FastVLA lấy top-K điểm, chuẩn hóa tổng thành một và tính:
K = ceil((1 - (rho + tau)) * N)
q[j] = top_score[j] / sum(top_scores)
K_eff = 1 / sum(q[j] ** 2)
U = K_eff / K
Nếu bốn token có điểm chuẩn hóa bằng nhau là 0,25, K_eff bằng bốn và U bằng một. Nếu một token gần như chiếm toàn bộ khối lượng, K_eff tiến gần một. Đây là ví dụ toán học minh họa, không phải số liệu đo của một rollout.
Ở đây K là tập tham chiếu để đo concentration, không phải số token cuối cùng luôn được giữ. Implementation còn chặn K tối thiểu bằng một để tránh trường hợp rỗng. Phân biệt hai ngân sách này giúp bạn đọc code mà không hiểu nhầm FastVLA thực chất vẫn dùng budget cố định.
Ánh xạ sang compression rate từng bước
rho là tỷ lệ token mục tiêu bị loại, tau là biên độ dao động, còn window lưu các giá trị U gần nhất. FastVLA so sánh U hiện tại với min và max của những bước trước trong cửa sổ:
alpha = clip((U - U_min) / (U_max - U_min), 0, 1)
rate = rho + tau - 2 * tau * alpha
kept = max(1, round((1 - rate) * N))
U thấp tương đối dẫn tới loại mạnh hơn; U cao dẫn tới giữ nhiều token hơn. Hai bước đầu dùng rho - tau, tức lựa chọn thận trọng hơn khi chưa đủ lịch sử. Khi khoảng min–max gần bằng không, code dùng rho để tránh chia cho không.
Với ví dụ 512 token, rho=0.8, tau=0.1, khoảng loại là 70–90%, tương ứng khoảng 154 đến 51 token được giữ sau làm tròn. Không được hiểu rho=0.8 là giữ 80%. rho cũng không đảm bảo tỷ lệ loại trung bình thực tế đúng tuyệt đối 80%, vì dữ liệu quyết định vị trí trong dải.
FastVLA không lưu cache visual features xuyên bước; trạng thái thời gian chỉ phục vụ calibration. Bạn phải reset trạng thái đầu mỗi episode, và không dùng chung một instance cho nhiều episode song song vì implementation lõi hiện xử lý batch size một.
4. Cài đặt môi trường đánh giá
Các lệnh dưới đây là hướng dẫn chạy trên máy thử nghiệm của bạn, từ Installation trong README. Trước hết kiểm tra GPU và tạo môi trường riêng:
nvidia-smi
conda create -n fastvla python=3.10 -y
conda activate fastvla

# Chọn wheel CUDA phù hợp driver theo hướng dẫn PyTorch.
pip install torch==2.2.0 torchvision==0.17.0 torchaudio==2.2.0

git clone https://github.com/jiuyixu25/FastVLA.git
cd FastVLA
pip install -e .
Editable install giúp Python import package ngay từ checkout. Hãy giữ nguyên môi trường sau khi cài, thay vì chạy các lệnh đánh giá bằng Python của môi trường khác. Tiếp theo cài benchmark và simulator:
git clone https://github.com/Lifelong-Robot-Learning/LIBERO.git
pip install -e LIBERO
pip install -r experiments/robot/libero/libero_requirements.txt
pip install bddl==1.0.1 mujoco==2.3.2 gym==0.25.2 robosuite==1.4.1

# Giúp script tìm package local từ thư mục gốc FastVLA.
export PYTHONPATH="$PWD:$PWD/LIBERO${PYTHONPATH:+:$PYTHONPATH}"

python -c "import torch, libero; from fastvla import FastVLA; print('CUDA:', torch.cuda.is_available())"
Việc pin simulator quan trọng vì phiên bản mới hơn có thể làm thay đổi kết quả nhiệm vụ ngay cả với baseline. Nếu TensorFlow báo xung đột NumPy, README đề xuất pip install numpy==1.26.4 opencv-python==4.10.0.84. Chỉ áp dụng khi cần, rồi chạy pip check để nhìn các dependency còn xung đột.
Một chi tiết dễ bỏ sót nằm trong pyproject.toml: nhánh OFT sử dụng fork transformers-openvla-oft để hỗ trợ bidirectional attention. Đừng tự thay bằng Transformers mới nhất. Nếu runtime yêu cầu FlashAttention, hãy làm theo môi trường OpenVLA-OFT và cài phiên bản tương thích sau editable install; package ghi chú flash-attn==2.5.5. Việc build extension cần CUDA toolkit tương thích, không chỉ có driver hiển thị trong nvidia-smi.
Lần đầu LIBERO có thể hỏi nơi đặt cấu hình và assets. Hoàn tất theo hướng dẫn của benchmark, rồi xác nhận các đường dẫn được tạo trỏ tới checkout LIBERO thật. Đánh giá bằng checkpoint có sẵn không yêu cầu tải toàn bộ demonstration dataset để training; simulator vẫn cần các assets và initial states của benchmark.
5. Training: phần nào được bỏ qua?
Trong bài này, bạn không chạy training FastVLA. Không có compressor cần học bằng backpropagation trước khi dùng. Bạn tải một OpenVLA-OFT checkpoint đã fine-tune cho suite, giữ weights và chạy inference với module pruning.
Điều này không có nghĩa base policy chưa từng học dữ liệu robot. Checkpoint moojink/openvla-7b-oft-finetuned-libero-spatial đã được thích nghi với LIBERO Spatial. FastVLA tận dụng năng lực sẵn có, không tự tạo khả năng gắp vật chỉ bằng một instruction.
Nếu chuyển sang robot riêng, workflow hợp lý là: thu demonstration, fine-tune policy theo OpenVLA-OFT, xác nhận baseline chạy được với camera và action normalization đúng, rồi mới bật FastVLA để đo trade-off. Repo mô tả thí nghiệm Franka Research 3 dùng OpenVLA-OFT đã fine-tune bằng LoRA trên teleoperation demonstrations. Đó là training của policy nền; bước nén token vẫn training-free.
Để hiểu lựa chọn thích nghi policy khác với nén inference, bạn có thể đọc VLA-Adapter trên LIBERO. Đừng trộn hai thay đổi cùng lúc khi benchmark: nếu vừa đổi checkpoint vừa đổi pruning, bạn khó biết nguyên nhân của chênh lệch success rate.
6. Inference: chạy baseline trước, FastVLA sau
Từ thư mục gốc FastVLA, chạy baseline quy mô nhỏ để kiểm tra tải checkpoint, render môi trường và hoàn thành rollout:
python experiments/robot/libero/run_libero_eval.py \
  --pretrained_checkpoint moojink/openvla-7b-oft-finetuned-libero-spatial \
  --task_suite_name libero_spatial \
  --fastvla_enable False \
  --num_trials_per_task 2 \
  --seed 7 \
  --run_id_note baseline-smoke
Hai trial mỗi task chỉ là smoke test; không đủ để xác nhận kết quả paper. Sau khi baseline chạy được, bật FastVLA với cùng checkpoint, suite và seed:
python experiments/robot/libero/run_libero_eval.py \
  --pretrained_checkpoint moojink/openvla-7b-oft-finetuned-libero-spatial \
  --task_suite_name libero_spatial \
  --fastvla_rho 0.8 \
  --fastvla_tau 0.1 \
  --fastvla_window 10 \
  --num_trials_per_task 2 \
  --seed 7 \
  --run_id_note fastvla-smoke
Theo script đánh giá, cấu hình OFT mặc định dùng hai ảnh, proprioception và continuous action head với L1 regression. Không giảm xuống một ảnh chỉ để tiết kiệm VRAM nếu checkpoint đang chờ cấu hình khác. Giữ preprocessing và action un-normalization phù hợp checkpoint trước khi điều chỉnh compression.
Khi môi trường ổn, dùng script chạy bốn suite với thông số đã chọn cho OpenVLA-OFT:
# Mặc định 50 trial/task; mỗi suite có 10 task.
bash scripts/eval_libero_fastvla.sh --seed 7

# Cùng protocol, tắt pruning để lấy baseline.
bash scripts/eval_libero_fastvla.sh --seed 7 --fastvla_enable False
| Suite | Tên CLI | rho OFT | tau | window |
|---|---|---|---|---|
| Spatial | libero_spatial |
0.80 | 0.10 | 10 |
| Object | libero_object |
0.70 | 0.10 | 10 |
| Goal | libero_goal |
0.75 | 0.10 | 10 |
| Long | libero_10 |
0.60 | 0.10 | 10 |
Các giá trị này không chuyển nguyên xi sang OpenVLA gốc: README dùng lần lượt 0.35, 0.50, 0.40 và 0.30 cho backbone đó. OpenVLA có integration riêng và môi trường dependency riêng. Không trộn checkpoint OpenVLA gốc với script OFT chỉ vì cả hai đều chứa tên OpenVLA.
7. Đọc kết quả mà không nhầm metric
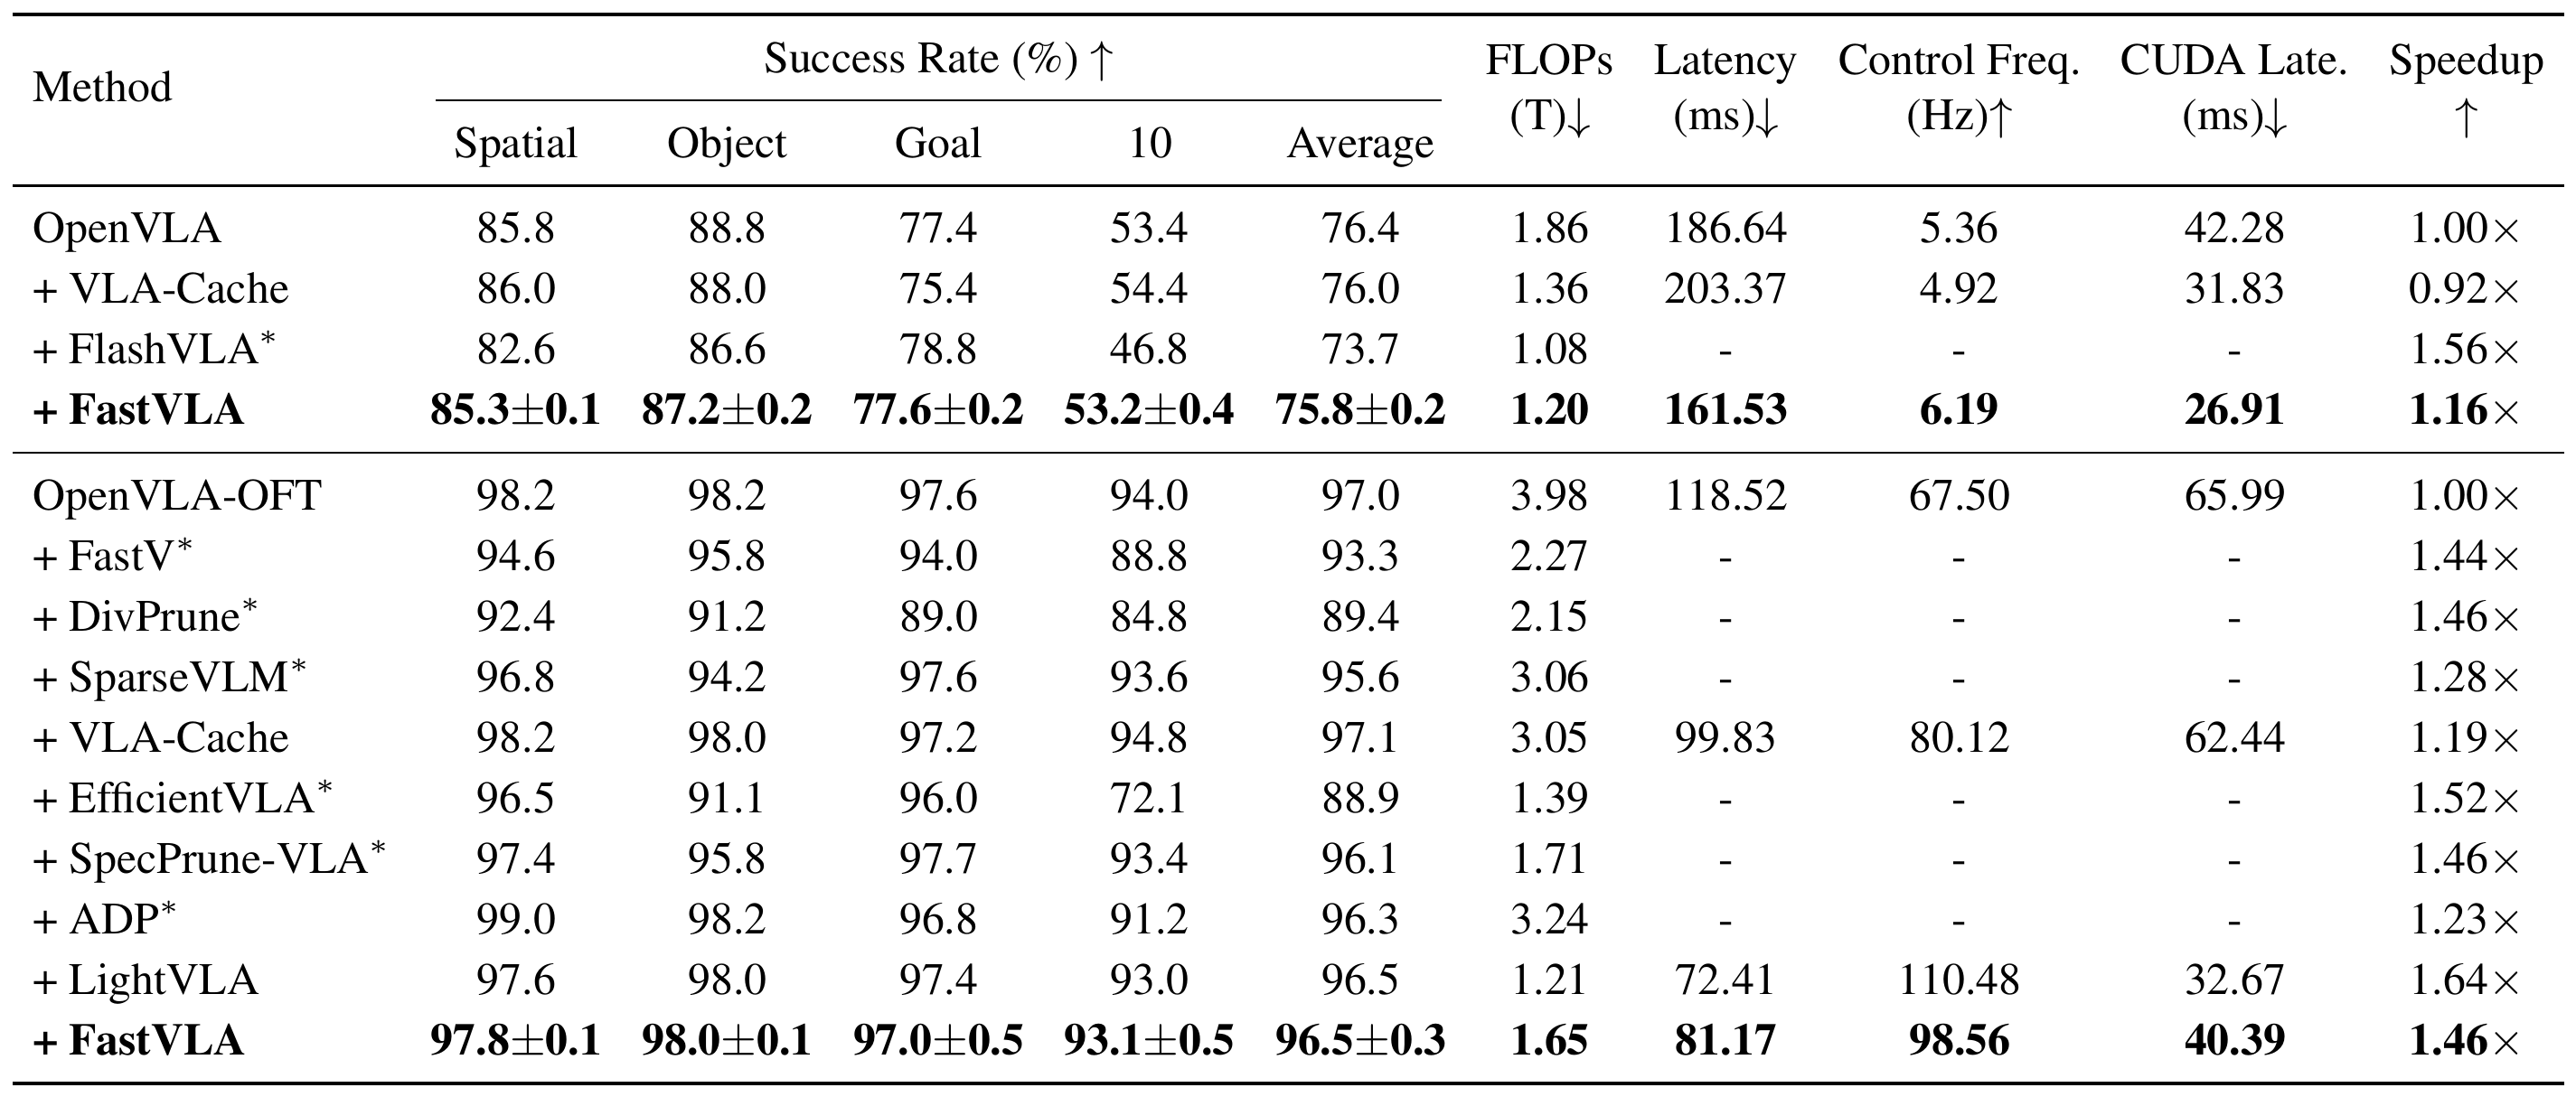
Một vài mốc công bố để đối chiếu, đo trên RTX 4090:
| Policy | Success trung bình | LLM FLOPs | Action latency | Speedup |
|---|---|---|---|---|
| OpenVLA | 76.4% | 1.86 T | 186.64 ms | 1.00× |
| OpenVLA + FastVLA | 75.8 ± 0.2% | 1.20 T | 161.53 ms | 1.16× |
| OpenVLA-OFT | 97.0% | 3.98 T | 118.52 ms | 1.00× |
| OpenVLA-OFT + FastVLA | 96.5 ± 0.3% | 1.65 T | 81.17 ms | 1.46× |
FastVLA báo cáo mean ± standard error qua ba random seed. Trên OFT, chênh lệch success là giảm 0,5 điểm phần trăm, không phải giữ nguyên tuyệt đối. FLOPs giảm khoảng 58,5%, trong khi action latency giảm khoảng 31,5%. Phần còn lại của pipeline giải thích vì sao hai tỷ lệ không bằng nhau. Nguồn: bảng kết quả trong README.
Tự kiểm tra phép tính cho OFT: 118.52 / 81.17 ≈ 1.46. Với chunk tám action, 8 / 0.08117 ≈ 98.56 action/giây, nhưng số lần dự đoán chunk chỉ khoảng 1 / 0.08117 ≈ 12.32 lần/giây. Robot không nhận một ảnh mới cho từng action trong tám action đó; scheduling và thời gian thực thi còn quyết định tốc độ vòng điều khiển ngoài đời.
Logs được ghi vào experiments/logs/ dưới dạng .txt và summary .json. Hãy lưu cùng nhau success rate, action latency, LLM CUDA latency, FLOPs và token count thực tế. Không so CUDA latency của một phương pháp với action latency của phương pháp khác. Khi đo nhiều seed, ghi từng seed và số episode; đừng trình bày hai trial smoke test như một phép tái lập benchmark.
Một thí nghiệm hữu ích là so adaptive pruning với fixed pruning có cùng số token trung bình. Cách này hỏi liệu cải thiện đến từ phân phối budget đúng thời điểm hay chỉ vì adaptive vô tình giữ nhiều token hơn. Đây cũng là lý do nên quan tâm token count thực đo thay vì chỉ báo rho mục tiêu.
8. Từ mô phỏng sang robot thật
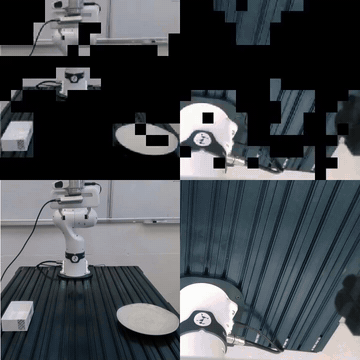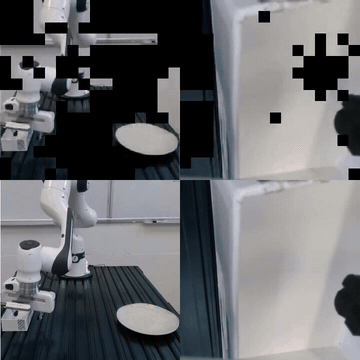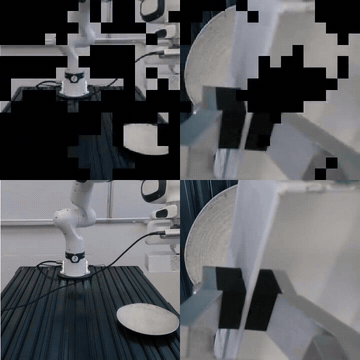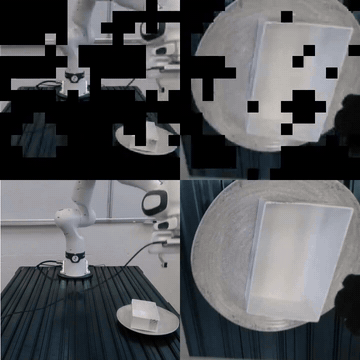
GIF robot thật của repo được ghi rõ tốc độ phát 2×; không suy ra latency từ chuyển động nhìn thấy. Thí nghiệm phần cứng dùng hai tác vụ, mỗi điều kiện 50 rollout. Với tác vụ pick, latency giảm từ 121.13 xuống 96.90 ms, success từ 84% xuống 80%; pick-and-place giảm từ 120.01 xuống 97.77 ms, success từ 68% xuống 66%. Nguồn: phần Real robot.
Đó là bằng chứng triển khai có ích, nhưng vẫn là một robot, hai task và tập demonstration cụ thể. Không có cơ sở để hứa giữ nguyên success trên mọi vật nhỏ, mọi camera hoặc mọi bối cảnh bị che khuất. Khi chuyển task, bắt đầu với mức nén nhẹ, kiểm tra video rollout và tăng rho từng bước giữa các episode. Theo dõi riêng lỗi tìm sai vật, lỗi tiếp cận, lỗi gắp và lỗi đặt; success tổng hợp có thể che khuất một failure mode rất quan trọng.
9. Checklist xử lý lỗi và thử nghiệm tiếp
- Import không được: kiểm tra conda environment, editable install và
PYTHONPATH. Chạy lại lệnh import nhỏ trước khi tải model 7B. - Simulator khác kết quả: đối chiếu bốn phiên bản đã pin và cấu hình assets. Chỉ kết luận pruning gây lỗi sau khi baseline cùng môi trường hoạt động ổn.
- OOM: đóng tiến trình GPU khác, kiểm tra checkpoint và số camera. Không coi token pruning là giải pháp bảo đảm model weights vừa VRAM.
- Tốc độ không tăng như paper: kiểm tra GPU, CUDA, warm-up, tải hệ thống và loại latency đang đo. Vision encoder hoặc action head có thể chiếm phần lớn thời gian trên setup khác.
- Success tụt mạnh: giảm
rho, xác nhận action normalization và reset mỗi episode. Đừng điều chỉnhrho, camera và checkpoint cùng lúc.
Sau khi tái lập một suite, hướng mở rộng dễ quản lý là chạy toàn bộ bốn suite rồi thử một dải rho trên tập validation riêng. Chọn điểm cân bằng dựa trên mức giảm success bạn chấp nhận và latency thực tế của ứng dụng. Nếu quan tâm các chiến lược chọn token khác, xem VLA-ACL và token pruning trên LIBERO.
FastVLA đáng thử khi bạn đã có VLA policy tốt và muốn giảm thời gian inference mà không thêm một vòng training compressor. Giá trị thực hành nằm ở việc cấp token theo nhu cầu từng bước, đồng thời giữ một đường baseline rõ ràng để biết mình đang đổi bao nhiêu độ chính xác lấy tốc độ.