Tóm tắt nhanh
UMR/WEPVLA là một hướng rất đáng chú ý cho robot manipulation vì nó tấn công thẳng vào câu hỏi mà nhiều nhóm nhỏ đang vướng: nếu không có robot chạy hàng nghìn giờ, liệu có thể dùng demo người để train policy không? Paper UMR: Universal Manipulation Representation, project page umr-wepvla.github.io và repo LiuSong-Scrat/UMR đưa ra câu trả lời khá thực dụng: biểu diễn cùng một chuyển động manipulation bằng hai hệ quy chiếu liên kết hình học với nhau.
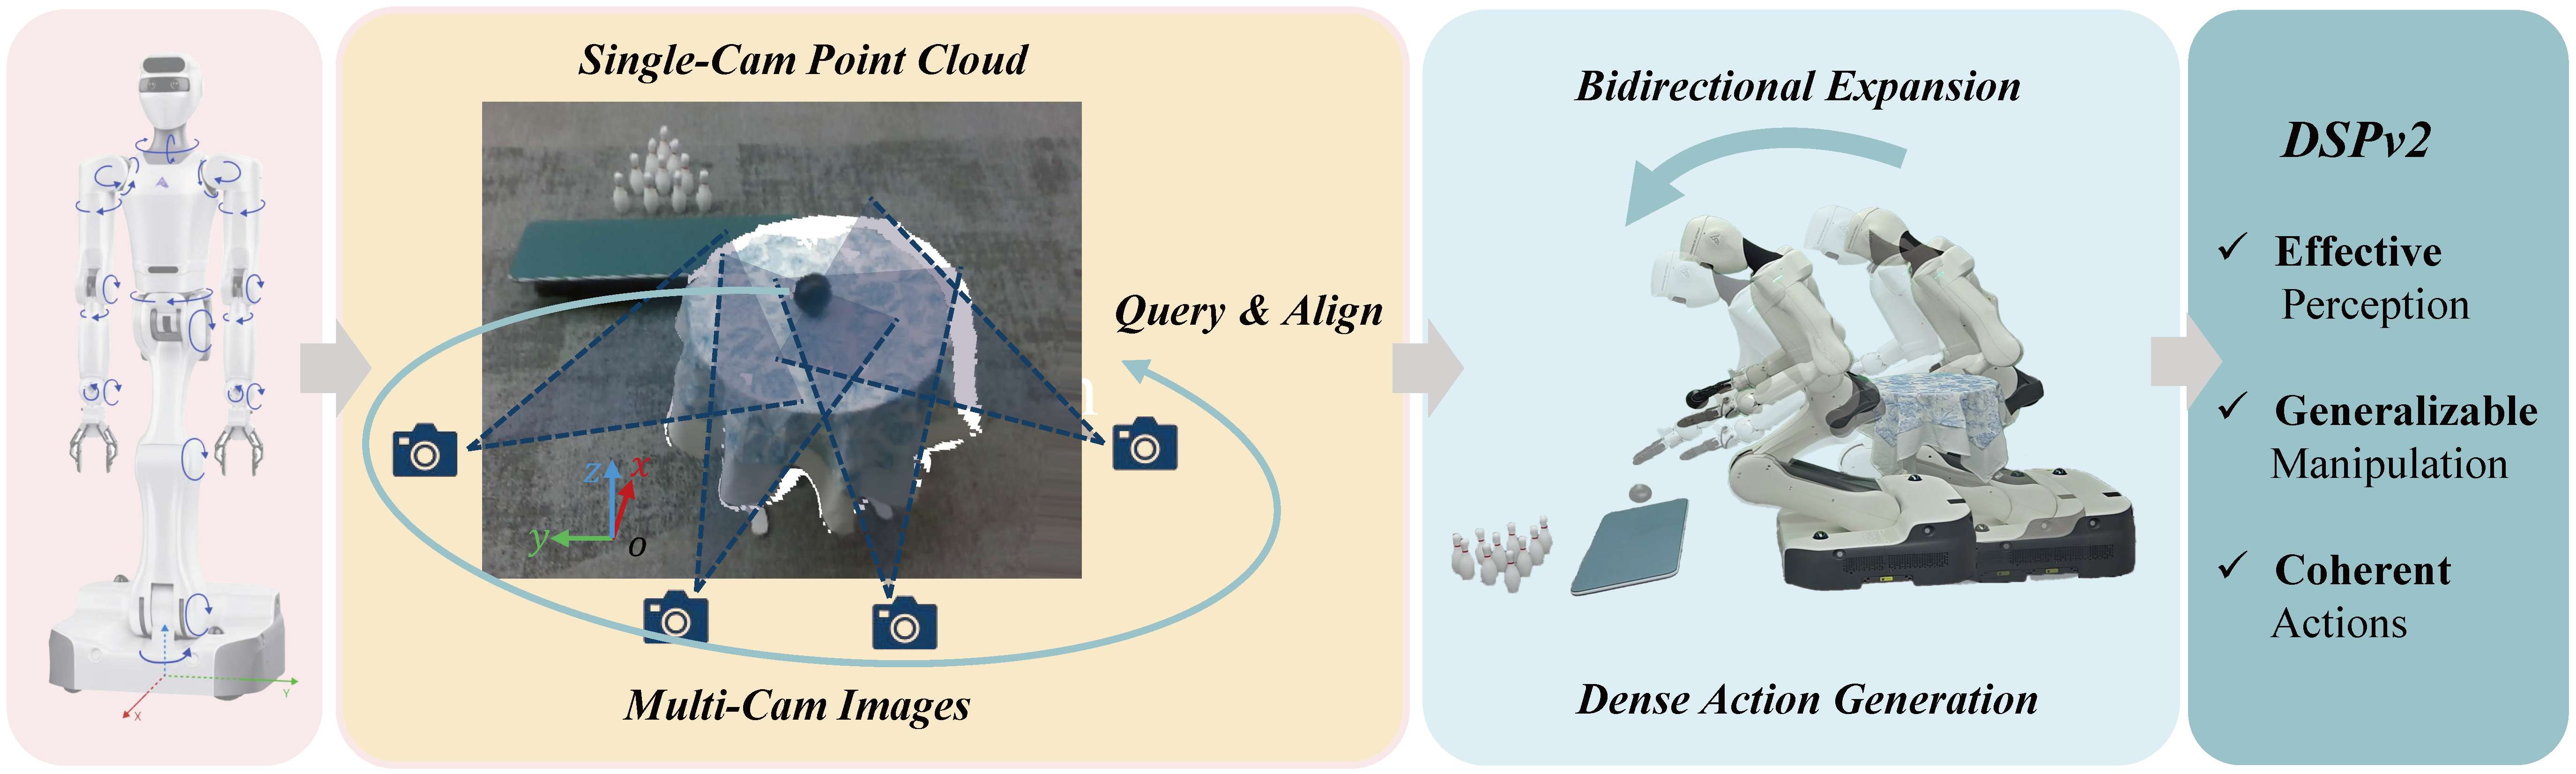
Một nhánh gọi là World Flow, mô tả chuyển động task-relevant của object trong world frame. Nhánh còn lại gọi là Ego Trajectory, mô tả chuyển động end-effector tương đối với pose hiện tại, tức gần hơn với thứ controller có thể thực thi. Hai nhánh được nối bằng phép biến đổi SE(3) conjugation. Từ biểu diễn đó, nhóm tác giả xây dựng World-Ego Point VLA (WEPVLA), một point-cloud VLA khoảng 0.5B parameters, có dual-stream Point Action Adapter và shared Point Action Expert.
Điểm làm bài này đáng đọc: trong real-world experiments, một policy train bằng khoảng 10 phút human demonstrations mỗi task, không dùng robot demonstrations, đạt 91.7% average success qua sáu setting. Baseline HumanEgo trong cùng setting đạt 60.8%. Trên simulation, project page báo 85.7% trên RLBench 10 tasks và 97.5% trên bốn suite LIBERO.
Nếu bạn đã quen với OpenVLA, SmolVLA/LeRobot training, hoặc các pipeline UMI/VLA, hãy xem UMR như một lớp "ngôn ngữ hình học" nằm giữa dữ liệu người, dữ liệu robot và action chunk.
Vấn đề: demo người giàu dữ liệu nhưng action không khớp robot
Một video con người xếp khối, gấp khăn hoặc đưa cốc vào giá có rất nhiều thông tin: object nào cần tương tác, contact nằm ở đâu, object phải di chuyển như thế nào, khi nào cần recovery. Nhưng video người không trực tiếp cho bạn action của robot. Tay người không có cùng kinematics với robot arm, wrist camera không có cùng extrinsics với third-person camera, và trajectory của người không phải command joint hoặc end-effector của robot.
Các hướng human-to-robot thường rơi vào một trong ba cách:
| Cách tiếp cận | Ý tưởng | Điểm yếu thường gặp |
|---|---|---|
| Retarget trực tiếp | Ước lượng tay người rồi map sang robot | Dễ phụ thuộc embodiment, grasp và calibration |
| World-only motion | Học object/point flow độc lập với robot | Cần module riêng để đổi world motion thành action |
| Robot-only VLA | Train trực tiếp trên robot demonstrations | Tốn robot time, khó scale cho nhiều task |
UMR đứng giữa ba hướng này. Nó không bỏ qua world motion, vì object motion là thứ chuyển giao tốt giữa người và robot. Nhưng nó cũng không bắt controller đoán từ world motion một cách rời rạc, vì policy vẫn học Ego Trajectory có thể thực thi. Cặp World-Ego giúp model nhìn được "task muốn object đi đâu" và "gripper của embodiment hiện tại nên đi như thế nào".
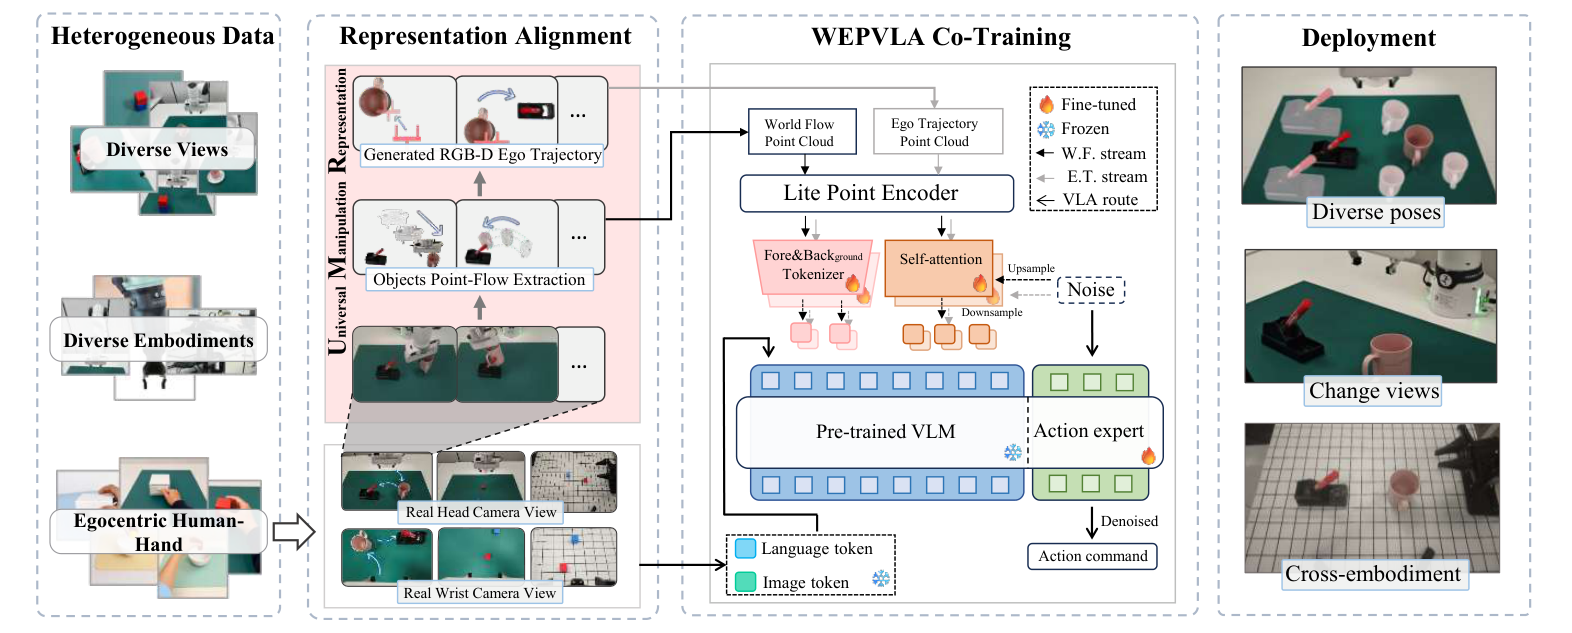
Ý tưởng paper: một chuyển động, hai góc nhìn
Hãy lấy ví dụ đơn giản: robot cần đẩy nắp laptop xuống. Nếu quan sát ở world frame, chuyển động quan trọng là nắp laptop quay quanh bản lề đến trạng thái đóng. Đây là World Flow: mô tả effect vật lý ở cấp object/task. Nếu quan sát từ end-effector hiện tại, action lại là một chuỗi delta pose: tiến tới mép nắp, đi xuống theo cung phù hợp, giữ contact và dừng đúng lúc. Đây là Ego Trajectory.
UMR nói rằng hai mô tả này không phải hai nhãn độc lập. Chúng là hai coordinate views của cùng một chuyển động vật lý. Nếu biết transform giữa world frame và end-effector frame tại thời điểm hiện tại, ta có thể liên kết chúng bằng SE(3) conjugation. Paper nhấn mạnh điểm này vì nó cho phép một policy học task motion từ demonstrator này và thực thi bằng embodiment khác.
Với beginner, có thể nhớ công thức bằng trực giác:
World Flow:
  "Object/task nên chuyển động thế nào trong thế giới?"

Ego Trajectory:
  "End-effector của robot hiện tại nên di chuyển thế nào từ pose hiện tại?"

UMR:
  Dùng hình học SE(3) để buộc hai câu trả lời mô tả cùng một chuyển động.
Khác với dense point flow tự do, UMR dùng trajectory SE(3) compact hơn. Điều này quan trọng khi train model nhỏ hơn, vì action space có cấu trúc rõ: translation, rotation 6D và gripper state cho từng bước trong action chunk.
Kiến trúc WEPVLA
WEPVLA là cách nhóm tác giả hiện thực hóa UMR thành một policy end-to-end. Theo paper và project page, model có ba thành phần chính.
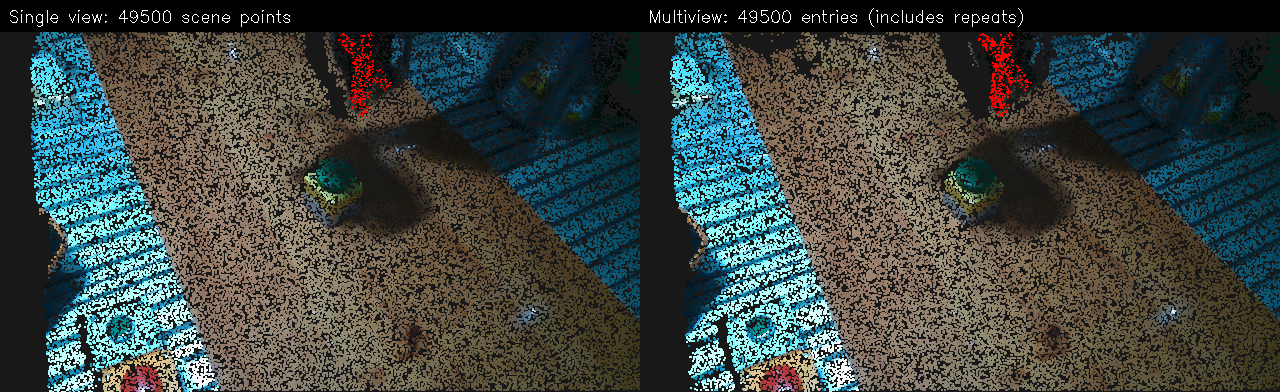
Motion-Aware Segmentation lọc point cloud để tập trung vào foreground liên quan tới interaction. Thay vì đưa toàn bộ scene vào action decoder và hy vọng attention tự học object nào cần nhìn, module này đánh giá điểm nào co-moving với interaction, điểm nào world-static, rồi giữ lại geometry quan trọng hơn. Với manipulation, vài centimet quanh contact point thường quan trọng hơn rất nhiều so với background.
Dual-stream Point Action Adapter có hai nhánh: World stream và Ego stream. World stream biểu diễn observation/action trong world frame. Ego stream re-express chúng trong current end-effector frame. Cả hai dùng Coarse-to-Fine Point Encoder để lấy token foreground chi tiết và token background thô. Sau đó action tokens được fuse với point features bằng bidirectional self-attention.
Shared Point Action Expert nhận action tokens, scene tokens, image/language tokens từ VLM frozen, rồi dự đoán action trong cả hai stream. Trong training, model học cả World Flow và Ego Trajectory. Trong inference, hai stream được joint denoise, nhưng chỉ Ego Trajectory được gửi xuống robot. Đây là lựa chọn đẹp: World Flow giữ vai trò task prior, Ego Trajectory là action thực thi.
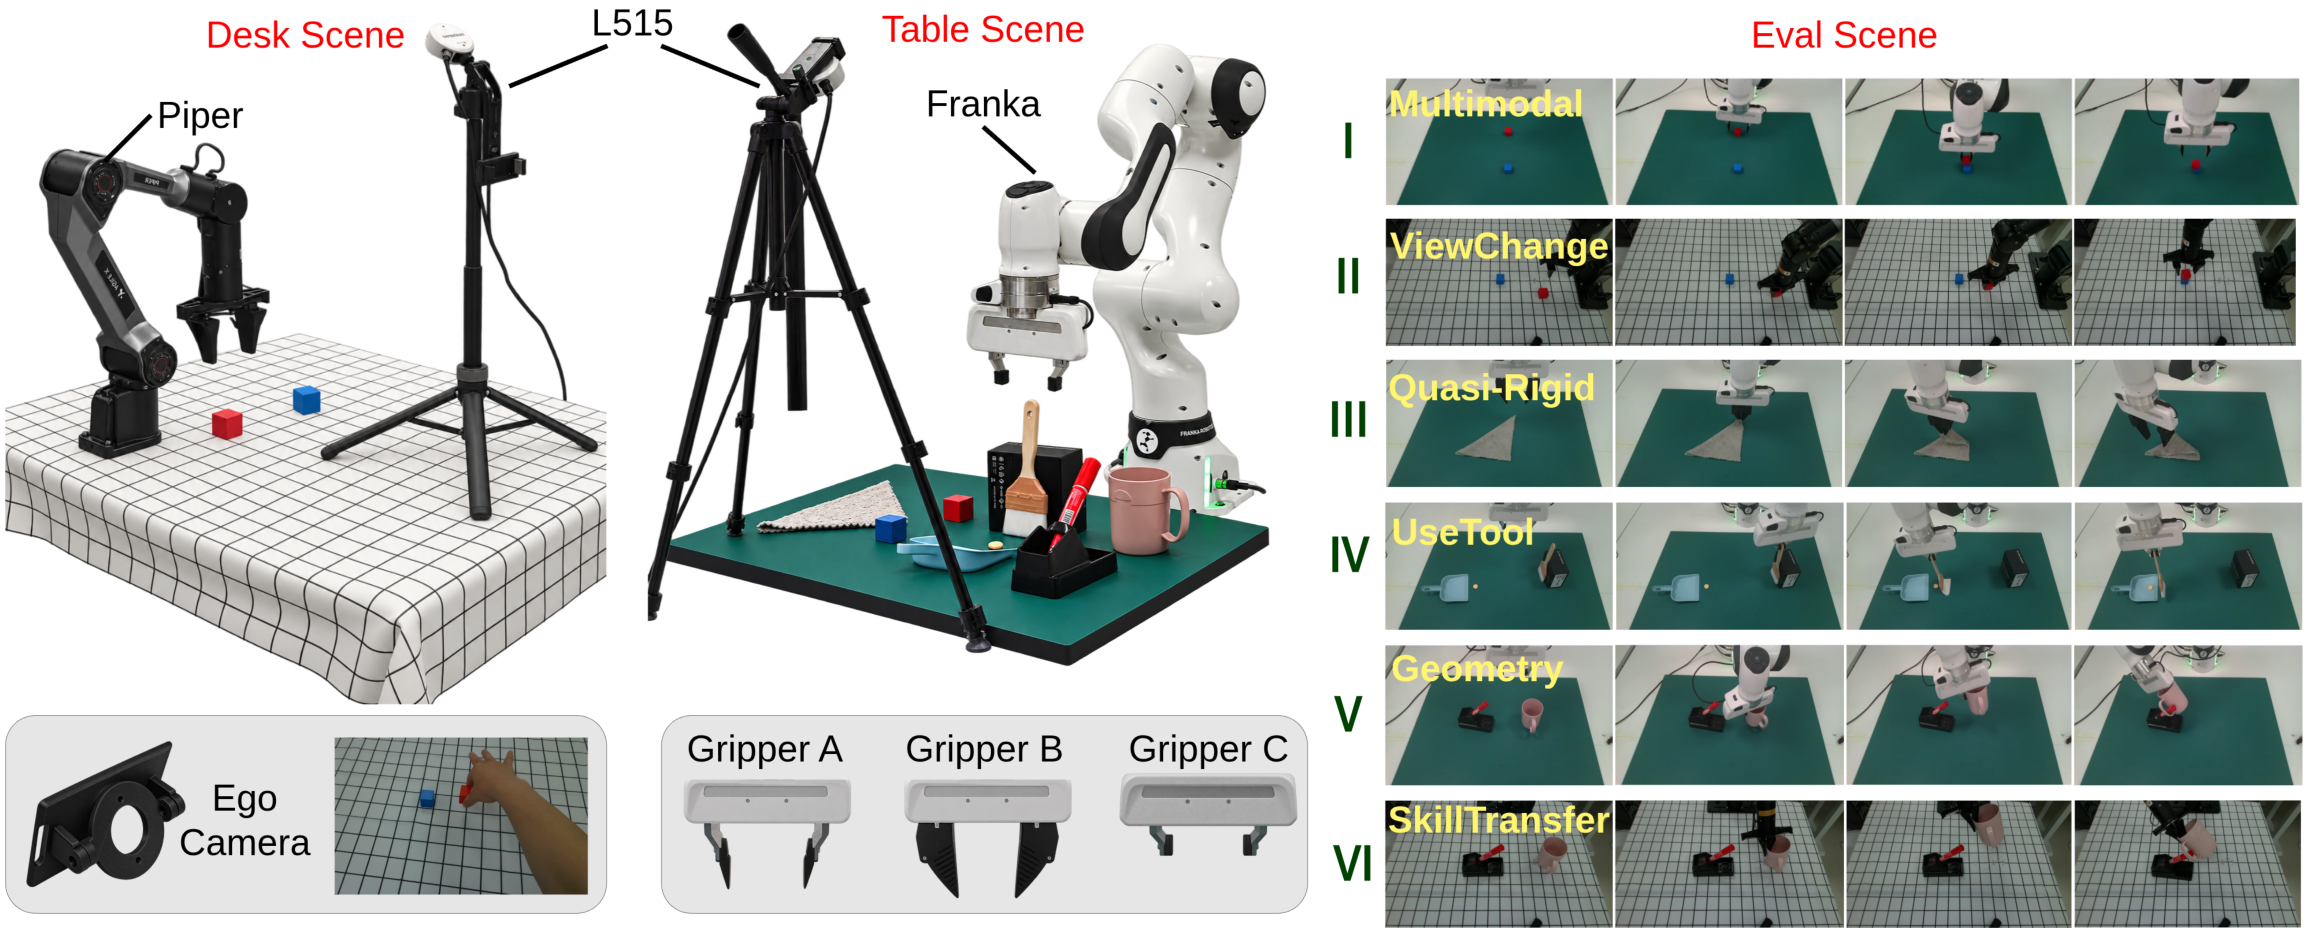
Data-Efficient Strategy: tăng dữ liệu mà không phá contact
Phần thực tế nhất của paper là Data-Efficient Strategy (DES). Khi chỉ có khoảng 10 phút demo người mỗi task, dataset rất dễ nghèo biến thể: object luôn ở vài vị trí quen thuộc, góc đặt gần giống nhau, recovery ít gặp. Nếu augment bằng crop ảnh 2D hoặc jitter ngẫu nhiên, bạn có thể tạo input lạ nhưng không chắc contact geometry còn đúng.
DES làm augmentation ở point-cloud level theo stage của task. Nó nhận diện interaction stage và object liên quan, sau đó perturb configuration trong 3D nhưng giữ quan hệ contact đã demo. Ví dụ, nếu task là đưa mug vào rack, bạn có thể dịch vị trí mug/rack trong tabletop frame, nhưng không được phá hướng tiếp cận hoặc relative geometry khiến gripper không còn khả thi. Nếu task là sweep trash, bạn có thể thay đổi vị trí rác và dustpan, nhưng vẫn phải giữ sequence sweep-to-container hợp lý.
Project page nói với 100 human demonstrations, DES tạo thêm khoảng 500 episodes. Điều quan trọng không phải "nhân dữ liệu" theo kiểu cosmetic, mà là tạo thêm object configurations để policy bớt overfit vào setup ban đầu. Đây là lý do UMR có thể cạnh tranh trong setting ít demo người.
Cài đặt repo open-source
Repo hiện tại dùng Python 3.10, LeRobot-style editable install, benchmark RLBench/LIBERO và model resources từ SmolVLM2/SmolVLA. Bạn nên chuẩn bị máy Linux có NVIDIA GPU, CUDA/PyTorch tương thích, đủ disk cho dataset và CoppeliaSim nếu chạy RLBench.
Các bước tối thiểu từ README:
sudo apt-get update
sudo apt-get install -y git git-lfs tmux xvfb xauth libegl1 libgl1-mesa-glx
git lfs install

cd /path/to/lerobot
conda create -n wepvla python=3.10 -y
conda activate wepvla
pip install -e ".[smolvla,libero]"
Nếu bạn chạy RLBench bundled trong repo:
pip install -e benchmarks/RLBench
python -c "import pyrep, rlbench; print('RLBench import ok')"
Trước khi train, kiểm tra PyTorch nhìn thấy GPU:
python -c "import torch; print(torch.__version__, torch.cuda.is_available(), torch.cuda.device_count())"
nvidia-smi
Download model resources:
bash benchmarks/RLBench/scripts/download_vlm_models.sh
Layout mong đợi:
benchmarks/vlm_model/
├── SmolVLM2-500M-Video-Instruct/
└── smolvla_base/
Nếu chạy offline hoặc cluster không cho tải tự động, truyền thẳng path:
VLM_MODEL_NAME=/path/to/SmolVLM2-500M-Video-Instruct \
VLM_WEIGHTS_PATH=/path/to/smolvla_base \
PYTHON=python \
bash benchmarks/RLBench/scripts/collect_data.sh \
  --dataset-root /path/to/rlbench_dataset
Một lưu ý nhỏ nhưng rất quan trọng: README nói CUDA extensions phải rebuild theo đúng PyTorch/CUDA của máy đích. Đừng copy nguyên build artifact từ máy khác rồi debug lỗi import cả ngày.
Training trên RLBench
Với RLBench, bạn cần CoppeliaSim tương thích. Truyền COPPELIASIM_ROOT, LD_LIBRARY_PATH và Qt variables vào lệnh. Trên server headless, bật Xvfb:
Xvfb :99 -screen 0 1280x1024x24 -nolisten tcp >/tmp/rlbench-xvfb.log 2>&1 &
Sau đó collect data và build cache:
PYTHON=python \
DATASET_ROOT=/path/to/rlbench_dataset \
COPPELIASIM_ROOT=/path/to/CoppeliaSim \
LD_LIBRARY_PATH="/path/to/CoppeliaSim:${LD_LIBRARY_PATH:-}" \
QT_QPA_PLATFORM=xcb \
QT_QPA_PLATFORM_PLUGIN_PATH=/path/to/CoppeliaSim \
QT_PLUGIN_PATH="" \
bash benchmarks/RLBench/scripts/collect_data.sh \
  --dataset-root /path/to/rlbench_dataset
Train:
DATASET_ROOT=/path/to/rlbench_dataset \
OUTPUT_ROOT=/path/to/rlbench_output \
GPU_IDS=0 \
bash benchmarks/RLBench/scripts/train.sh
Evaluate 10 tasks:
EVAL_POLICY_PATH=/path/to/checkpoint/pretrained_model \
EVAL_ROOT=/path/to/rlbench_eval \
EVAL_SAVE_VIDEO=0 \
EVAL_SAVE_ACTION_RECORDS=0 \
EVAL_SAVE_ACTION_CHUNKS=0 \
DISPLAY=:99 \
bash benchmarks/RLBench/scripts/evaluate.sh \
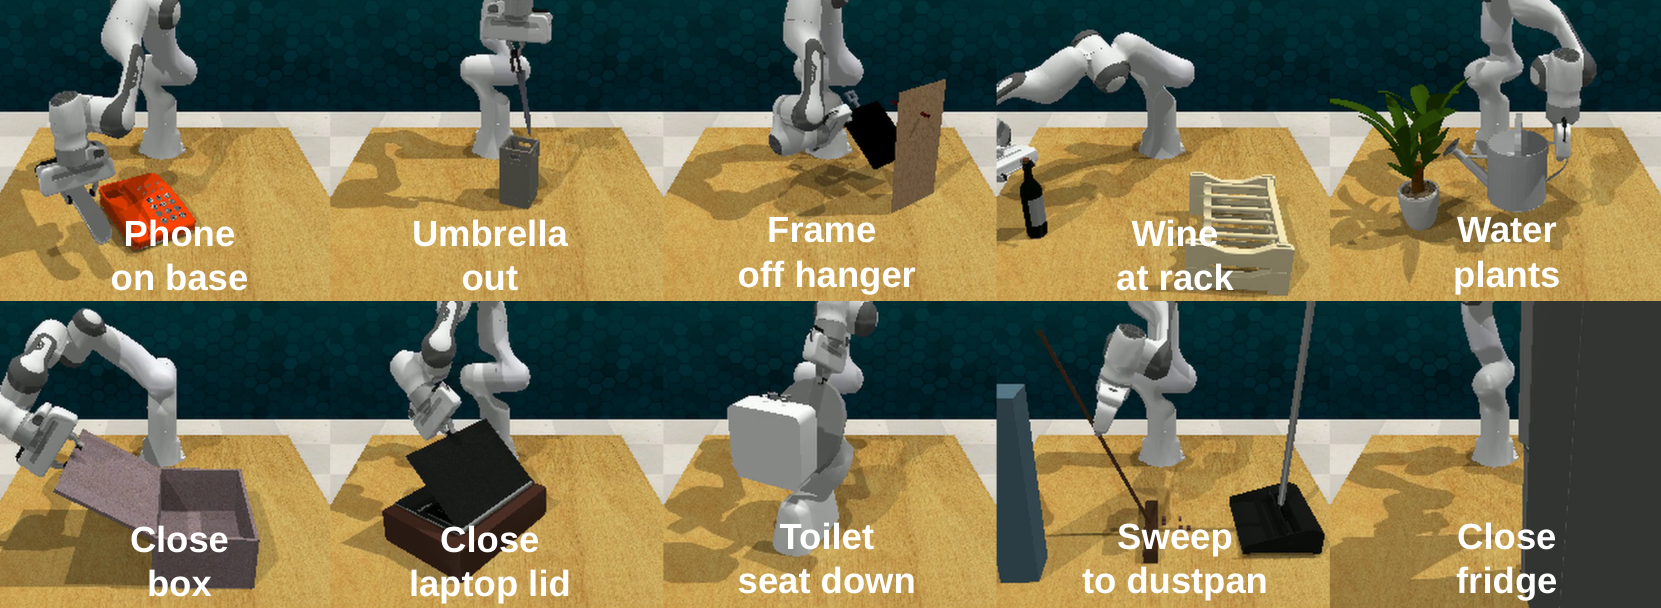
  --tasks close_box close_fridge close_laptop_lid phone_on_base stack_wine \
  sweep_to_dustpan take_frame_off_hanger \
  take_umbrella_out_of_umbrella_stand toilet_seat_down water_plants \
  --episodes 100
Với người mới, hãy chạy một task trước, bật save video/action records khi debug, rồi mới chạy full 10-task evaluation bằng tmux. RLBench lỗi rất thường đến từ CoppeliaSim, display hoặc mismatch OpenGL, không nhất thiết từ model.
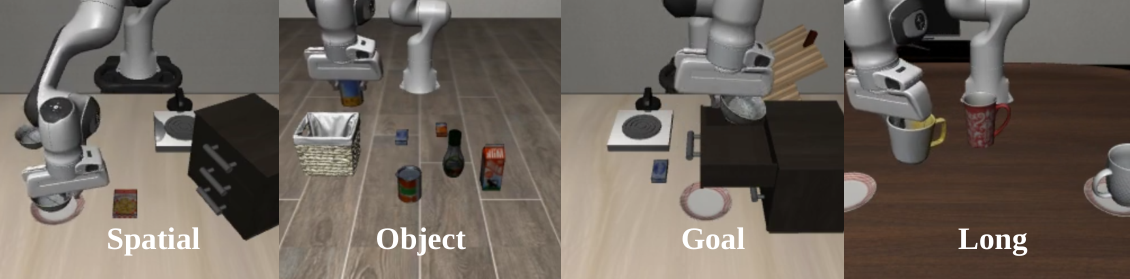
Training và inference trên LIBERO
LIBERO trong repo nằm ở benchmarks/song_real_libero/. Flow cũng theo bốn bước: convert demonstrations, build PointSeg cache, train, evaluate. Ví dụ:
PYTHON_BIN=/path/to/python \
DEMO_ROOT=/path/to/libero_demos \
DATASET_ROOT=/path/to/libero_dataset \
bash benchmarks/song_real_libero/prepare_dataset.sh
Build cache:
PYTHON_BIN=/path/to/python \
DATASET_ROOT=/path/to/libero_dataset \
CACHE_ROOT=/path/to/libero_cache \
GPU_IDS=0 NPROC=1 \
bash benchmarks/song_real_libero/build_cache.sh
Train:
PYTHON_BIN=/path/to/python \
DATASET_ROOT=/path/to/libero_dataset \
CACHE_ROOT=/path/to/libero_cache \
BASE_POLICY=/path/to/base_policy/pretrained_model \
OUTPUT_ROOT=/path/to/libero_output \
GPU_IDS=0 \
bash benchmarks/song_real_libero/train.sh
Evaluate:
PYTHON_BIN=/path/to/python \
POLICY_PATH=/path/to/checkpoint/pretrained_model \
OUTPUT_DIR="benchmarks/song_real_libero/outputs/eval_$(date +%Y%m%d_%H%M%S)" \
CUDA_DEVICE=0 EPISODES=50 \
bash benchmarks/song_real_libero/evaluate.sh
Trong inference, điểm cần nhớ là policy không chỉ phát action từ ảnh. Nó dựng point-cloud observation, chạy motion-aware segmentation, đưa tokens qua World/Ego streams, joint denoise action chunk, rồi xuất Ego action cho controller. Nếu bạn deploy thật, log nên có đủ: camera/depth health, point-cloud shape, gripper state, predicted chunk, executed Ego trajectory và success/failure label.
Kết quả nên đọc thế nào?
Kết quả headline của UMR/WEPVLA mạnh, nhưng nên đọc đúng phạm vi. Trên simulation, WEPVLA đạt 85.7% mean success trên RLBench 10 tasks, cao hơn PointACT 82.3% và HybridVLA 74.0% trong bảng project page, trong khi model chỉ 0.5B parameters. Trên LIBERO, WEPVLA đạt 97.5%, so với PointACT 96.0% và OpenVLA-OFT 96.8%.
Trên real world, bảng đáng chú ý hơn: cả WEPVLA và HumanEgo được train bằng human-only data khoảng 10 phút mỗi task. WEPVLA đạt 95.0% cross-environment, 91.7% cross-embodiment, 90.0% cross-setup và 91.7% trung bình Tasks I-VI. HumanEgo lần lượt là 70.0%, 60.8%, 58.3% và 60.8%.
Điều này không có nghĩa bạn có thể quay 10 phút video bằng điện thoại rồi có robot production-ready. Paper có stack RGB-D, point cloud, calibrated robot setup, task framing và evaluation protocol rõ ràng. Nhưng nó cho thấy một đường đi rất hấp dẫn: thay vì cố thu thật nhiều robot action cho mỗi embodiment, hãy học một representation đủ hình học để human demonstrations trở nên hữu dụng hơn.
Khi nào nên thử UMR/WEPVLA?
Bạn nên thử nếu team đang có ít nhất một trong các điều kiện sau:
- Có RGB-D hoặc multi-view data, hoặc sẵn sàng đầu tư vào calibration.
- Task là tabletop manipulation có object motion rõ: stack, fold, sweep, place, rack, close.
- Muốn so sánh human demonstration với robot teleoperation thay vì chỉ train robot-only.
- Đang dùng LeRobot/SmolVLA/OpenVLA và muốn thêm point-cloud representation.
- Có GPU đủ để chạy training/evaluation nghiêm túc, không chỉ notebook demo.
Bạn nên chậm lại nếu task cần tactile feedback nặng, deformable object rất khó, closed-loop force control, hoặc mobile manipulation chưa có camera/depth ổn định. WEPVLA là bước tiến về representation, không thay thế calibration, controller safety và data QA.
Checklist cho người mới bắt đầu
- Đọc paper trước, đặc biệt phần UMR, WEPVLA và DES.
- Chạy repo ở mode evaluation với checkpoint trước khi tự train.
- Verify dataset path, model path, CUDA và simulator riêng rẽ.
- Với RLBench, chạy một task, một episode, save video/action records.
- Với LIBERO, đảm bảo mỗi eval run ghi vào output directory mới.
- Khi train task riêng, log cả World Flow prediction và Ego action execution.
- Nếu kết quả tệ, kiểm tra point cloud, transform frame và gripper state trước khi đổi model.
UMR/WEPVLA đáng chú ý không phải vì nó thêm một VLA nữa vào danh sách. Nó đặt lại câu hỏi biểu diễn: robot policy nên học object motion hay end-effector action? Câu trả lời của UMR là học cả hai, buộc chúng nhất quán bằng hình học, rồi chỉ gửi phần Ego xuống controller. Đó là một ý tưởng gọn, có code, có benchmark, và đủ thực dụng để các lab nhỏ bắt đầu thử nghiệm nghiêm túc.