Robot manipulation dùng VLA thường không fail vì “không hiểu task”. Nó fail theo một kiểu rất đời: tay robot đang đi mượt, mô hình phải gọi inference tiếp, hành động mới chưa kịp về, robot khựng lại một nhịp, rồi mới đi tiếp. Với một tác vụ pick-and-place ngắn, vài nhịp khựng như vậy đã đủ làm gripper lệch khỏi bát, nâng sai thời điểm, hoặc đặt vật không ổn định. RACE-VLA đặt câu hỏi rất cụ thể: nếu ta kéo dài action chunk để robot phải gọi policy ít hơn, làm sao tránh việc phần cuối của chunk trở nên mù và sai?
Paper gốc là When to Switch: Reliable Action-Chunk Extension for Vision-Language-Action Models, công bố trên arXiv ngày 2026-10-05 bởi Seonghoon Yu và cộng sự từ KAIST, GIST, NVIDIA và POSTECH. Repo chính thức là Seonghoon-Yu/RACE-VLA. Tại thời điểm viết bài, repo mới có README và demo robot thật, còn code ghi rõ sẽ được release sau. Vì vậy, bài này không bịa ra lệnh chạy chính thức; thay vào đó, ta đọc kỹ paper để hiểu cách tự triển khai RACE trên một VLA flow-matching kiểu pi0.5.

Vấn đề: action chunk dài giúp nhanh hơn, nhưng dễ sai ở điểm chuyển skill
Action chunking nghĩa là policy không chỉ sinh một action tại mỗi lần gọi, mà sinh một chuỗi hành động liên tiếp: ví dụ 5 bước, 10 bước, 20 bước. Khi chunk dài hơn, robot có thể tiếp tục chạy trong lúc GPU đang sinh chunk kế tiếp. Số lần gọi policy giảm, idle time giảm, chuyển động nhìn mượt hơn.
Nhưng chunk dài có mặt trái. Robot phải thực thi open-loop lâu hơn, tức là ít có cơ hội nhìn lại camera và sửa. Với manipulation, lỗi không phân bố đều trong chunk. RACE quan sát rằng lỗi tăng mạnh quanh các điểm subskill transition: ví dụ từ approach sang grasp, từ grasp sang lift, từ lift sang place. Đây là nơi hành động cần đổi “chế độ” nhanh: cổ tay đang tiến tới vật phải chuyển sang đóng gripper; gripper đóng xong phải chuyển sang nâng; nâng đủ cao rồi mới dịch sang plate.
Nếu policy dự đoán sai thời điểm chuyển skill chỉ 2-3 frame, task vẫn có thể fail. Đóng gripper quá sớm thì chưa chạm vật. Đóng quá muộn thì đẩy vật đi. Lift trước khi grasp ổn định thì vật rơi. Vì vậy, RACE không chỉ hỏi “action tiếp theo là gì?”, mà thêm một câu hỏi phụ: khi nào trong chunk sẽ xảy ra transition?

Paper đo lỗi action quanh transition và thấy spike rõ ràng. Với pi0.5, spike này lớn hơn khi H dài hơn. RACE giảm spike bằng cách làm action expert “transition-aware”: trước khi sinh chunk chính, nó chạy một auxiliary pass rất nhẹ để ước lượng transition timing prior, rồi dùng prior đó điều kiện hóa toàn bộ quá trình denoising.
Ý tưởng cốt lõi của RACE
Một VLA flow-matching hiện đại thường có hai phần. Phần đầu là VLM nhận ảnh và instruction, rồi tạo context feature. Phần sau là action expert biến nhiễu Gaussian thành action chunk qua nhiều denoising steps. Trong paper, action chunk được ký hiệu là A_t = (a_t, ..., a_{t+H-1}), với H là chunk length.
RACE thêm ba mảnh:
- Auxiliary one-step denoising pass: chạy action expert một bước từ noise ban đầu, chưa dùng transition prior. Mục tiêu không phải sinh action cuối cùng, mà lấy hidden states theo từng action token trong chunk.
- Transition-timing prediction head: nhận hidden states của action expert và cached VLM features, dùng cross-attention, self-attention, linear projection và sigmoid để tạo vector
p_hatdàiH. Mỗi vị trí trong vector nói action tại vị trí đó gần transition hay không. - Transition-conditioned action generation: restart full denoising từ cùng noise ban đầu, nhưng ở mỗi denoising step, action expert được điều kiện hóa bởi
p_hat. Paper dùng modulation qua adaptive RMSNorm với learnable gatealpha^kcho từng denoising step.
Nói ngắn gọn: RACE nhìn trước sơ bộ đường đi, đoán vị trí chuyển skill, rồi sinh lại action chunk với thông tin “đến bước này thì chuẩn bị đổi chế độ”.
Một điểm hay là RACE không cần annotation subskill thủ công. Paper dùng PELT change-point detection trên trajectory action để tạo pseudo-label transition. Sau đó hard transition point được làm mềm thành soft label: điểm transition có giá trị cao nhất, các frame gần đó giảm dần theo khoảng cách. Nhãn mềm hợp lý hơn vì trong robot thật, transition hiếm khi là một frame duy nhất.
Pipeline triển khai từ đầu
Vì code chính thức chưa release, hãy coi phần này là blueprint để bạn tự triển khai trên VLA có action expert dạng diffusion/flow-matching. Nếu bạn đang dùng LeRobot hoặc một VLA tự huấn luyện, ý tưởng vẫn giống nhau: cần model sinh action chunk, dataset demonstration có image, robot state và action, cộng thêm một module dự đoán transition prior.
Observation + instruction
        |
        v
Frozen VLM encoder -> cached visual-language features
        |
        +--> auxiliary one-step action expert
        |        |
        |        v
        |   action-token hidden states
        |        |
        |        v
        |   transition head -> p_hat[0:H]
        |
        v
full denoising action expert conditioned by p_hat
        |
        v
long action chunk -> async execution on robot
1. Chuẩn bị dataset
Dataset tối thiểu cần có:
| Trường dữ liệu | Vai trò |
|---|---|
images.front, images.wrist |
visual observation cho VLM |
instruction |
lệnh ngôn ngữ, ví dụ “pick up the gray bowl...” |
state |
joint state hoặc end-effector state hiện tại |
action |
target action theo từng timestep |
episode_id, timestamp |
giúp cắt chunk và detect transition |
Trong real-robot experiment, paper dùng 30 demonstrations cho task pick-and-place, ảnh từ wrist camera và front camera, robot state, action ở 30 Hz. Action là absolute positions của sáu joints và gripper. Robot là AgileX PiPER 6-DoF arm, reach 626 mm, payload 1.5 kg, có gripper.
Với beginner, hãy bắt đầu bằng một task hẹp, không phải 10 task cùng lúc. Ví dụ: “pick up gray bowl and place it on plate”. Thu 30-100 demos sạch, cùng camera layout, ánh sáng tương đối ổn định, object pose thay đổi vừa phải. RACE giúp chunk dài đáng tin hơn, nhưng nó không cứu được dataset bị lệch calibration, action bị trễ timestamp, hoặc gripper command không đồng bộ với ảnh.
2. Tạo transition label bằng change-point detection
Ta cần pseudo-label p_t cho mỗi chunk. Paper phát hiện subskill transition bằng PELT trên action dynamics. Trực giác là: khi robot chuyển từ approach sang grasp, phân phối vận tốc joint/gripper đổi đột ngột. PELT tìm các điểm đổi đó trong trajectory.
Một bản triển khai thực tế có thể làm như sau:
for each episode:
  load action trajectory A[0:T]
  build feature x[t] = concat(
    joint_delta[t],
    gripper_delta[t],
    smoothed_velocity[t]
  )
  change_points = PELT(x, penalty=beta)
  for each chunk start t:
    p_t[0:H] = soft peaks around change_points inside [t, t+H)
Paper báo cáo với VLABench, penalty beta=4 được dùng và hiệu năng khá ổn định khi đổi beta từ 2 đến 8. Điều này quan trọng: bạn không cần ám ảnh tuning change-point detection ngay từ đầu. Hãy verify bằng visualization: vẽ action curve, đánh dấu transition, kiểm tra xem các mốc có rơi gần approach/grasp/lift/place không.
3. Thêm transition-timing head
Transition head nhận hai nguồn thông tin:
Thứ nhất là hidden states theo action token từ auxiliary one-step denoising. Đây là “bản nháp motion” của action expert. Thứ hai là final-layer VLM features, chứa ngữ cảnh ảnh và instruction. Head project action hidden states sang cùng dimension với VLM features, cross-attend vào VLM features, self-attend giữa các action token, rồi sigmoid ra vector H điểm.
Output không phải class subskill. Nó chỉ là prior theo thời gian: “ở vị trí chunk này có khả năng gần transition”. Cách này nhẹ hơn nhiều so với ép model học label approach/grasp/lift thủ công.
4. Điều kiện hóa full denoising
Sau auxiliary pass, RACE không dùng luôn action vừa nháp. Nó restart từ cùng noise A_t^0, rồi chạy full denoising K steps. Ở step k, action expert nhận thêm alpha^k * p_hat. alpha^k là learnable gate, qua sigmoid, cho phép model tự quyết định denoising step nào nên nghe transition prior mạnh hơn.
Paper cho thấy gate learnable tốt hơn dùng prior với trọng số cố định. Điều này hợp lý: ở denoising sớm, model có thể cần prior để đặt cấu trúc thời gian; ở denoising muộn, nó cần tinh chỉnh action liên tục, không nên bị prior kéo quá cứng.
Training: ba loss trong một bước
Một training step của RACE gồm hai pass. VLM được frozen và cache feature cho cả hai pass. Action expert và module mới được train.
| Loss | Mục tiêu |
|---|---|
L_timing |
BCE giữa p_hat và soft transition label p_t |
L_aux |
flow-matching loss cho auxiliary one-step pass, để hidden states vẫn có ý nghĩa motion |
L_full |
flow-matching loss chính cho full denoising có điều kiện hóa transition |
Tổng loss là:
L = L_full + lambda_aux * L_aux + lambda_timing * L_timing
Trong full pass khi training, paper dùng teacher forcing: thay vì dùng p_hat, nó dùng target transition label đã jitter nhẹ. Jitter là dịch nhãn ±1 step với xác suất 0.5. Chi tiết này nhỏ nhưng đáng giá. Nếu model chỉ học với transition label hoàn hảo, inference dùng p_hat hơi lệch có thể làm action generation nhạy quá mức. Jitter giúp action expert chịu được sai số timing nhỏ.
Với real robot, paper fine-tune từ pretrained pi0.5 base trong 20K steps trên 30 demonstrations. Hyperparameter được công bố: AdamW, gradient clipping 1.0, batch size 32, cosine learning-rate schedule với 1K warmup, learning rate giảm từ 2.5e-5 xuống 2.5e-6, không dùng EMA. Với RACE real-robot, policy train chunk H=40, nhưng lúc chạy chỉ execute H_exec=20 trước khi request chunk tiếp theo.
Inference: kéo dài chunk mà vẫn chạy async
Ở inference, mỗi policy call làm:
- Encode observation và instruction bằng VLM, cache features.
- Sample noise
A_t^0. - Chạy auxiliary pass một bước để lấy hidden states.
- Transition head dự đoán
p_hat[0:H]. - Restart full denoising từ cùng noise, ở mỗi step inject
alpha^k * p_hat. - Trả về action chunk
A_t^K. - Robot execute chunk theo cơ chế asynchronous execution.
Điểm quan trọng là RACE không thay thế real-time chunking; nó bổ sung cho real-time chunking. Real-time chunking sinh chunk kế tiếp trong lúc chunk hiện tại đang chạy. Nhưng nếu chunk hiện tại quá ngắn, inference vẫn có thể chưa xong khi robot đã chạy hết action, gây idle. RACE cho phép chunk dài hơn đáng tin hơn, nên buffer thời gian lớn hơn.
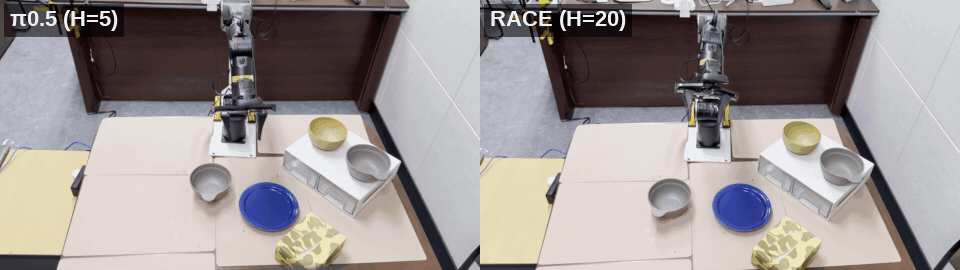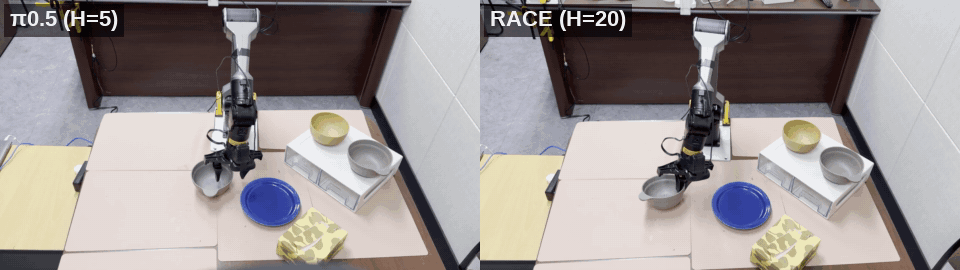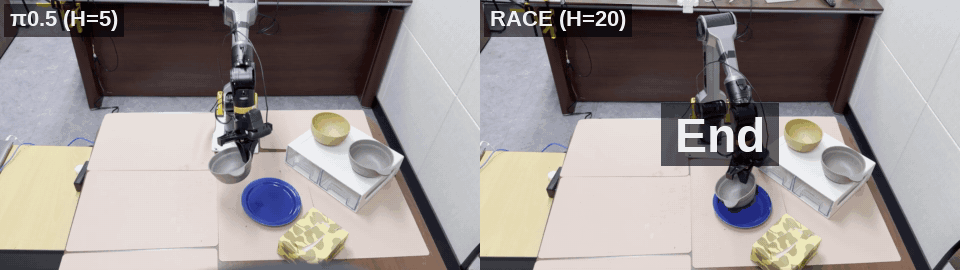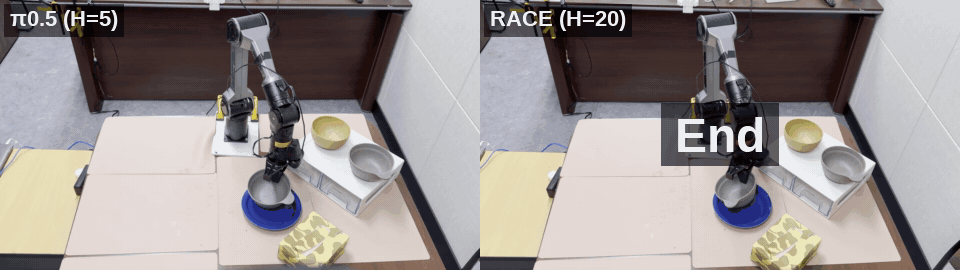
Trong demo repo, baseline pi0.5 replan mỗi 5 actions, còn RACE replan mỗi 20 actions, tức khoảng 4x dài hơn. Cả hai dùng asynchronous execution. Kết quả thị giác dễ thấy: bên RACE, cánh tay ít khựng hơn khi chuyển từ approach sang grasp rồi lift/place.
Kết quả chính
Trên VLABench, baseline pi0.5 với H_exec=5 đạt average success rate 24.6 và progress score 40.8. RACE ở cùng H_exec=5 đạt 30.5 SR và 45.8 PS, tức bản thân transition-aware training đã giúp ngay cả khi không kéo dài chunk. Khi kéo lên H_exec=20, RACE đạt 33.0 SR và 47.8 PS, trong khi vẫn có speedup inference theo episode lớn hơn nhiều so với baseline. Paper cũng báo cáo chạy ba seed với H_exec=20, trung bình 33.3 ± 0.5 SR và 48.6 ± 0.9 PS.
Trên RoboCasa-H50 và LIBERO, paper so sánh với nhiều baseline VLA và efficient inference khác. Điểm cần nhớ không phải một con số đơn lẻ, mà là pattern: fine-tune đơn giản ở chunk dài có thể tăng tốc nhưng dễ mất reliability; RACE giữ được success rate tốt hơn vì xử lý đúng điểm yếu quanh transition.
Kết quả robot thật là phần đáng chú ý nhất:
| Method | H_exec |
Success rate | Time | Idle |
|---|---|---|---|---|
pi0.5 fine-tuning |
5 | 36% | 12.6 s | 2.11 s |
pi0.5 fine-tuning |
20 | 48% | 11.6 s | 0.40 s |
| RACE | 20 | 66% | 11.8 s | 0.41 s |
RACE không giảm idle hơn pi0.5 chunk 20 vì cả hai đều có buffer dài tương tự. Nhưng RACE đạt success rate cao hơn hẳn ở cùng chunk dài: 66% so với 48%. So với pi0.5 chunk 5, idle giảm từ 2.11 s xuống 0.41 s, khoảng 5x. Đây là ý chính: chunk dài giải quyết idle, còn RACE làm chunk dài bớt nguy hiểm.

Checklist tự triển khai trong lab
Nếu bạn muốn thử ý tưởng RACE trước khi code chính thức release, hãy làm theo thứ tự nhỏ:
- Train hoặc fine-tune một VLA action-chunk baseline với chunk ngắn, ví dụ
H_exec=5. - Verify async execution trước: log thời gian inference, thời gian execute chunk, idle time.
- Tăng chunk lên 2x hoặc 4x bằng fine-tuning thường, đo success rate để thấy failure mode.
- Chạy change-point detection trên action trajectories, visualize transition labels.
- Thêm transition head và
L_timing; kiểm tra prediction có peak gần transition thật. - Thêm modulation vào action expert qua adaptive norm hoặc một FiLM-like layer nếu model của bạn không dùng RMSNorm.
- Train với
L_full + L_aux + L_timing, dùng jitter label. - Deploy với
H=2H_exec, request chunk mới sau khi execute nửa đầu chunk để nửa sau che inference latency.
Đừng bắt đầu bằng H_exec=20 trên robot thật nếu baseline còn chưa ổn. Hãy chạy trong simulation hoặc replay trước. Với robot thật, thêm watchdog: nếu action target vượt joint limit, gripper command nhảy bất thường, hoặc camera frame quá cũ, dừng chunk và replan.
Khi nào nên dùng RACE?
RACE hợp với tác vụ có nhiều giai đoạn liên tục: pick-place, open drawer, insert object, fold/stack object, hoặc mobile manipulation có approach-contact-transfer. Nó đặc biệt đáng thử khi bạn thấy robot thành công trong từng phase ngắn, nhưng fail khi tăng action horizon.
RACE không phải thuốc tiên cho mọi lỗi. Nếu model không nhìn thấy object vì camera đặt sai, transition prior cũng không cứu được. Nếu demonstration quá ít hoặc quá nhiễu, PELT label sẽ lộn xộn. Nếu robot dynamics thay đổi mạnh so với dữ liệu, chunk dài vẫn nguy hiểm. Và vì repo chưa release code, triển khai hiện tại đòi hỏi bạn can thiệp được vào action expert, training loop và inference server.
Nhưng ý tưởng rất sạch: thay vì chỉ làm VLA nhanh hơn bằng pruning hoặc cache, RACE giảm số lần gọi policy bằng cách làm mỗi lần gọi đáng tin hơn trong thời gian dài hơn. Với robot thật, đó là khác biệt giữa một cánh tay cứ khựng từng đoạn và một cánh tay đi liền mạch đủ để con người tin rằng nó đang kiểm soát được task.