Thao tác robot đáng tin cậy đòi hỏi không chỉ hiểu ngữ nghĩa mà còn phải thực thi hành động chính xác trong không gian 3D. Vấn đề là hầu hết các mô hình VLA hiện nay — kể cả π0.5 — được khởi tạo từ VLM được pre-train trên ảnh 2D, thiếu hoàn toàn hiểu biết về không gian ba chiều.
SLA (Spatial-Language-Action Model) từ nhóm nghiên cứu HKUST (Guangzhou), OLA Dimensions, Viện AI Bắc Kinh và Đại học Thanh Hoa đề xuất một hướng giải quyết độc đáo: thay vì yêu cầu dữ liệu độ sâu tường minh hoặc thay đổi kiến trúc, SLA căn chỉnh ngầm các visual embedding trung gian với biểu diễn 3D từ mô hình perception đóng băng — ngay trong giai đoạn continual pre-training, không phải chỉ fine-tuning.
Kết quả: trung bình +24.0 điểm phần trăm so với π0.5 trên 8 điều kiện triển khai real-world.
Paper gốc: SLA: Scaling Spatial-Language-Action Model via Continual Pre-training — Fuhao Li et al., arXiv:2611.08373, 05/11/2026.
Vấn đề cốt lõi: VLA 2D không "thấy" không gian 3D
Hãy thử tưởng tượng: bạn muốn gắp một cái ly đặt sau một vật cản nhỏ. Với camera RGB thông thường, hai vật cùng bình diện nhìn có thể trông như nằm chồng lên nhau. Nhưng trong thực tế, cánh tay robot phải điều hướng trong 3D — xác định chính xác vị trí tương đối, tránh va chạm, chọn góc cầm nắm phù hợp.
Các mô hình VLA hiện tại như π0.5, OpenVLA đều inherit visual backbone từ VLM được pre-train trên ảnh 2D. Khi chúng học robot manipulation, hiểu biết về không gian 3D thực sự — nếu có — chỉ hình thành ngầm từ dữ liệu demo, không có supervision tường minh.
Có một số cách tiếp cận để bổ sung 3D:
- Dùng depth camera: thêm modality, nhưng depth sensor thường nhiễu, cồng kềnh, không phải robot nào cũng có
- Dùng point cloud: cần encode riêng, thêm kiến trúc, khó scale
- Post-training với 3D: chỉ fine-tuning cuối, không build được nền tảng 3D từ sớm
SLA chọn con đường khác: implicit spatial alignment trong suốt quá trình continual pre-training, không cần depth sensor khi inference.
Ý tưởng thiết kế: "Teacher đóng băng" dạy học sinh thấy không gian
Trực giác chính đứng sau SLA là: hành động được sinh ra từ visual và language representation — do đó nếu visual token chứa thông tin 3D tốt hơn, hành động sẽ chính xác hơn.
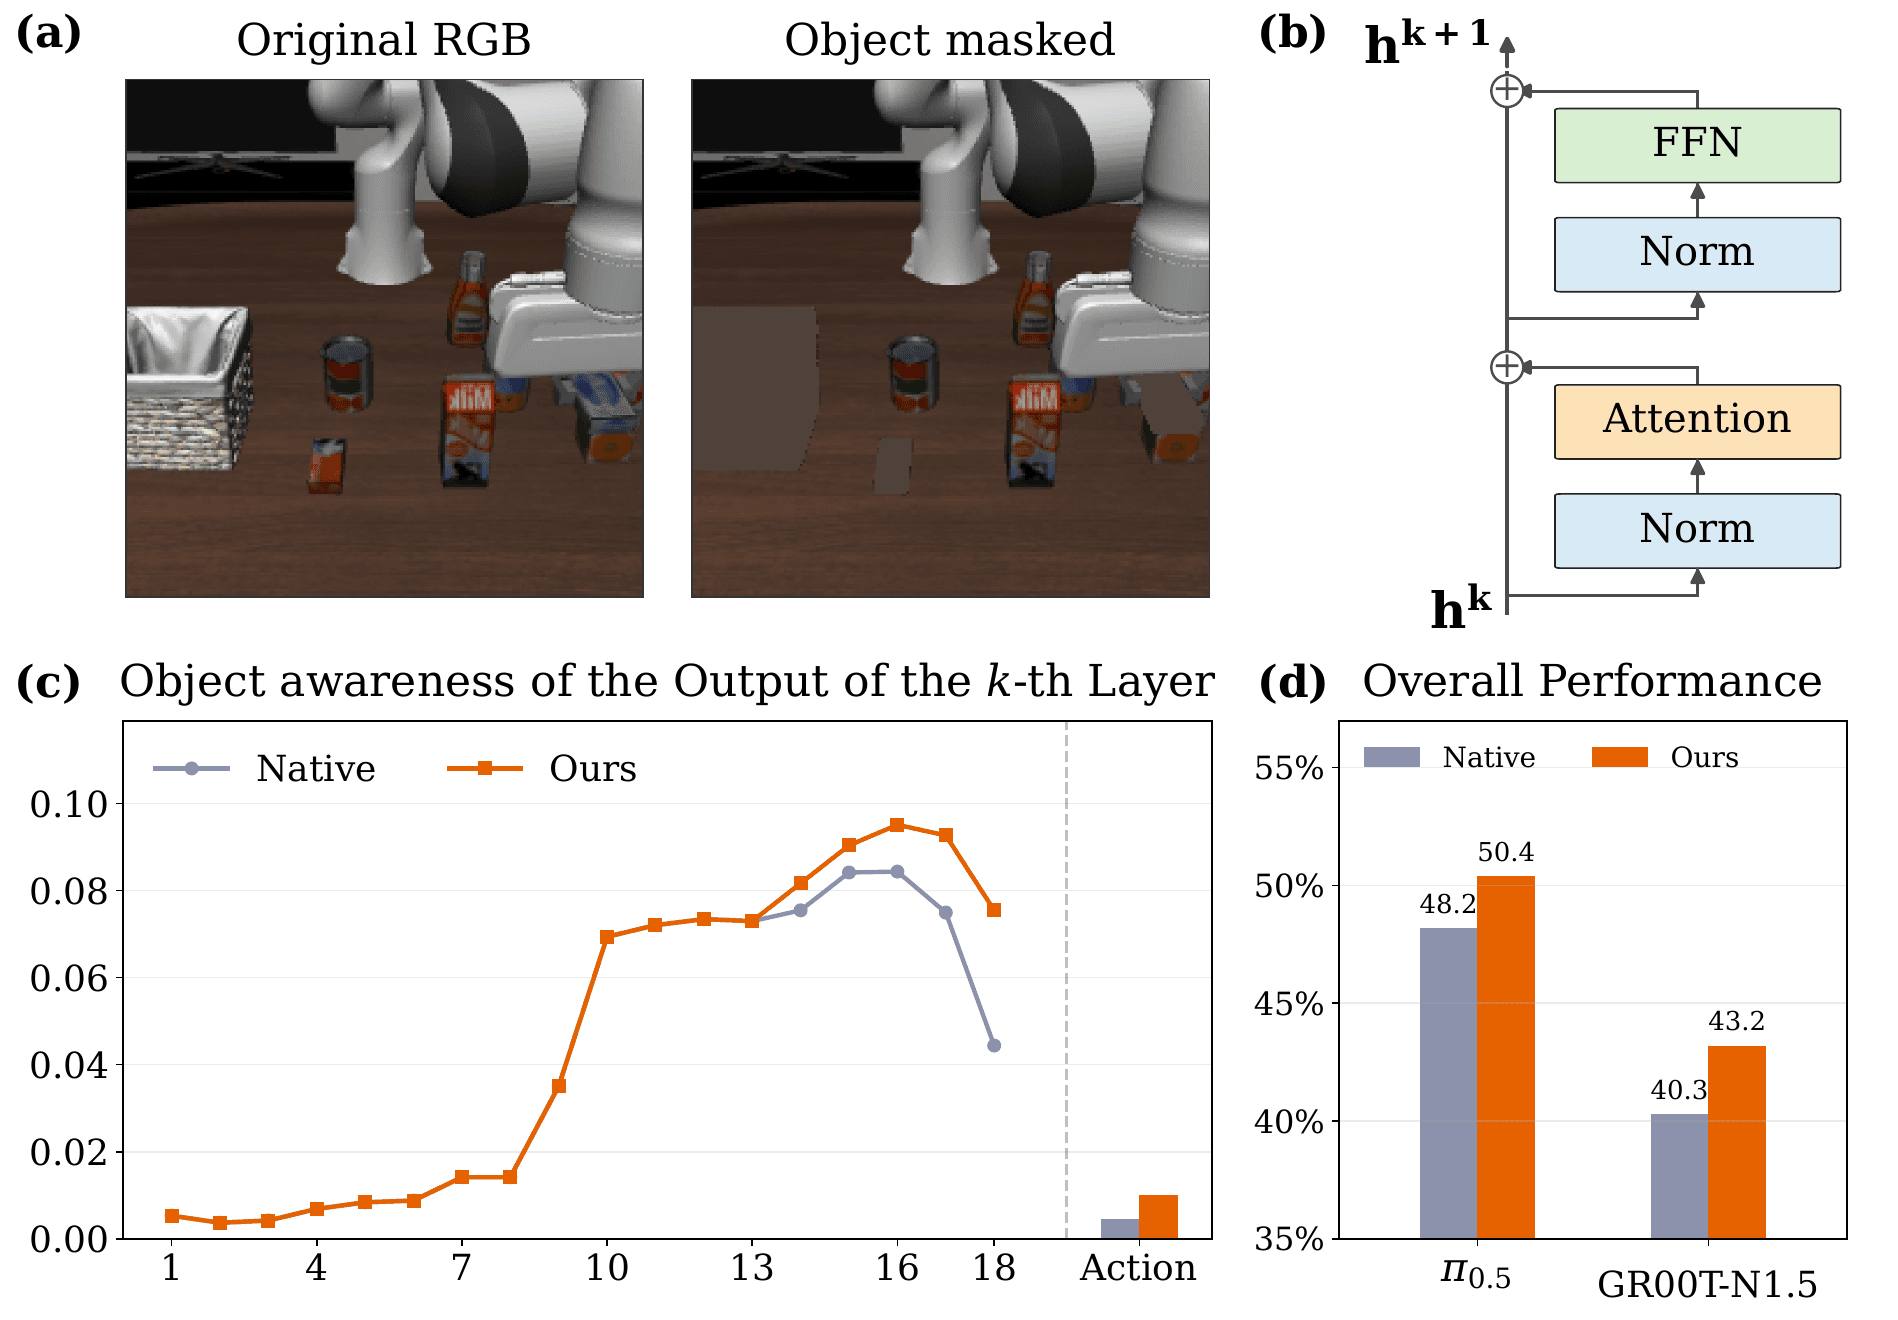
Thay vì yêu cầu visual token học 3D từ đầu, SLA dùng một mô hình 3D perception đã được train sẵn (OmniVGGT) làm "teacher" và căn chỉnh intermediate visual embedding của VLA với các spatial feature từ teacher đó. Teacher này không tham gia inference — chỉ dùng trong training.
Cụ thể, pipeline như sau:
- Base model: Khởi tạo từ π0.5 pretrained — giữ nguyên toàn bộ kiến trúc
- Frozen teacher: OmniVGGT nhận RGB + optionally depth/calibration → trích xuất spatial feature
- Alignment projector: Học ánh xạ từ visual embedding của VLA sang không gian feature của teacher
- Mục tiêu huấn luyện kép:
- Action loss (giống π0.5 — flow matching)
- Alignment loss (cosine similarity giữa projected VLA embedding và teacher feature)
- Tổng:
L = L_action + α × L_align
Điều quan trọng nhất: sau khi train xong, bỏ hết teacher, alignment projector và gate selection. Inference hoàn toàn giống π0.5.
Kiến trúc chi tiết: 4 thành phần kỹ thuật
1. External Spatial Supervision — OmniVGGT làm teacher
OmniVGGT là mô hình 3D perception foundation đã được train sẵn, nhận:
- RGB ảnh (bắt buộc)
- Depth map (tùy chọn — nếu có dataset support)
- Camera intrinsics/extrinsics (tùy chọn — nếu được calibrate)
Với các dataset không có depth, OmniVGGT vẫn chạy được nhờ RGB. Khi thêm calibration, kết quả có thể tăng thêm vài điểm (ví dụ từ 42.8% lên 46.0% trong ablation).
Spatial feature từ OmniVGGT phục vụ như "ground truth" về không gian 3D để guide VLA học.
2. Adaptive Layer Selection — Chọn layer phù hợp từng domain
Một phát hiện của nhóm tác giả: lớp intermediate của VLA "tốt nhất" để alignment không giống nhau cho mọi loại data. Dataset thao tác bàn tay khác với dataset di chuyển tay máy; robot 7-DOF khác robot 2 tay.
Feature-dependent gates giải quyết vấn đề này: thay vì chọn 1 layer cố định, gates học cách kết hợp adaptively visual embedding từ nhiều layer của VLA, với trọng số phụ thuộc vào feature đang xử lý.
Kết quả ablation cho thấy adaptive selection rõ ràng vượt trội so với chọn single layer cố định.

3. State Dropout — Tránh shortcut qua robot state
Trong robot manipulation, model thường có thể "gian lận": nếu proprioceptive state (vị trí khớp, góc cuối tay...) đủ mạnh, model có thể dự đoán hành động tiếp theo chủ yếu từ state mà bỏ qua visual input.
Probabilistic state dropout ngẫu nhiên mask robot state trong training, buộc model phải dựa vào visual cue. Điều này không chỉ cải thiện khả năng generalization mà còn làm cho spatial alignment có ý nghĩa hơn — model thực sự cần visual token để suy luận.
4. Rotation Representation — Góc biểu diễn hành động
Thay vì dùng euler angles hay quaternion, SLA dùng rotation vectors (axis-angle) để biểu diễn rotation trong action space. Ablation cho thấy điều này cải thiện học và precision của hành động cuối tay máy.
Dữ liệu Continual Pre-training
Để scale spatial alignment, SLA cần dữ liệu đa dạng. Nhóm tác giả đã tổng hợp 6 dataset robot lớn từ cộng đồng:
| Dataset | Embodiment | Scale |
|---|---|---|
| Open X-Embodiment | Nhiều loại | Lớn |
| RoboData | Nhiều loại | Trung |
| DROID | Franka | Lớn |
| BridgeV2 | WidowX | Trung |
| Oxe-Mix | Nhiều loại | Lớn |
| Internal demos | Phân kỳ | Nhỏ |
Tổng cộng khoảng 1.7 triệu episodes, ~14,330 giờ demo trải rộng 1,504 task.
Để unify, nhóm tác giả chuẩn hóa:
- State và action: end-effector representation thống nhất
- Coordinate: quy ước tọa độ nhất quán
- Downsampling: loại bỏ frame thừa, giữ actionable transitions
- Filtering: loại bỏ demo chất lượng thấp
Kết quả thực nghiệm
Benchmarks mô phỏng
| Benchmark | π0.5 | Spatial Forcing | SLA |
|---|---|---|---|
| LIBERO-Plus | ~60% | ~56% | 87.4% |
| RoboTwin 2.0 (C2R) | — | — | 72.3% |
| RoboCasa-Panda | — | — | 68.4% (50 demo) |
| RoboDojo-Real | 12.8% | — | 33.9% |
Điểm đặc biệt ở RoboCasa-Panda: SLA đạt 68.4% chỉ với 50 demo mỗi task, trong khi các phương pháp khác cần 300-3,000 demo. Đây là bằng chứng mạnh về data efficiency khi nền tảng 3D đã được xây dựng từ trước.
Real-world: +24.0 điểm phần trăm

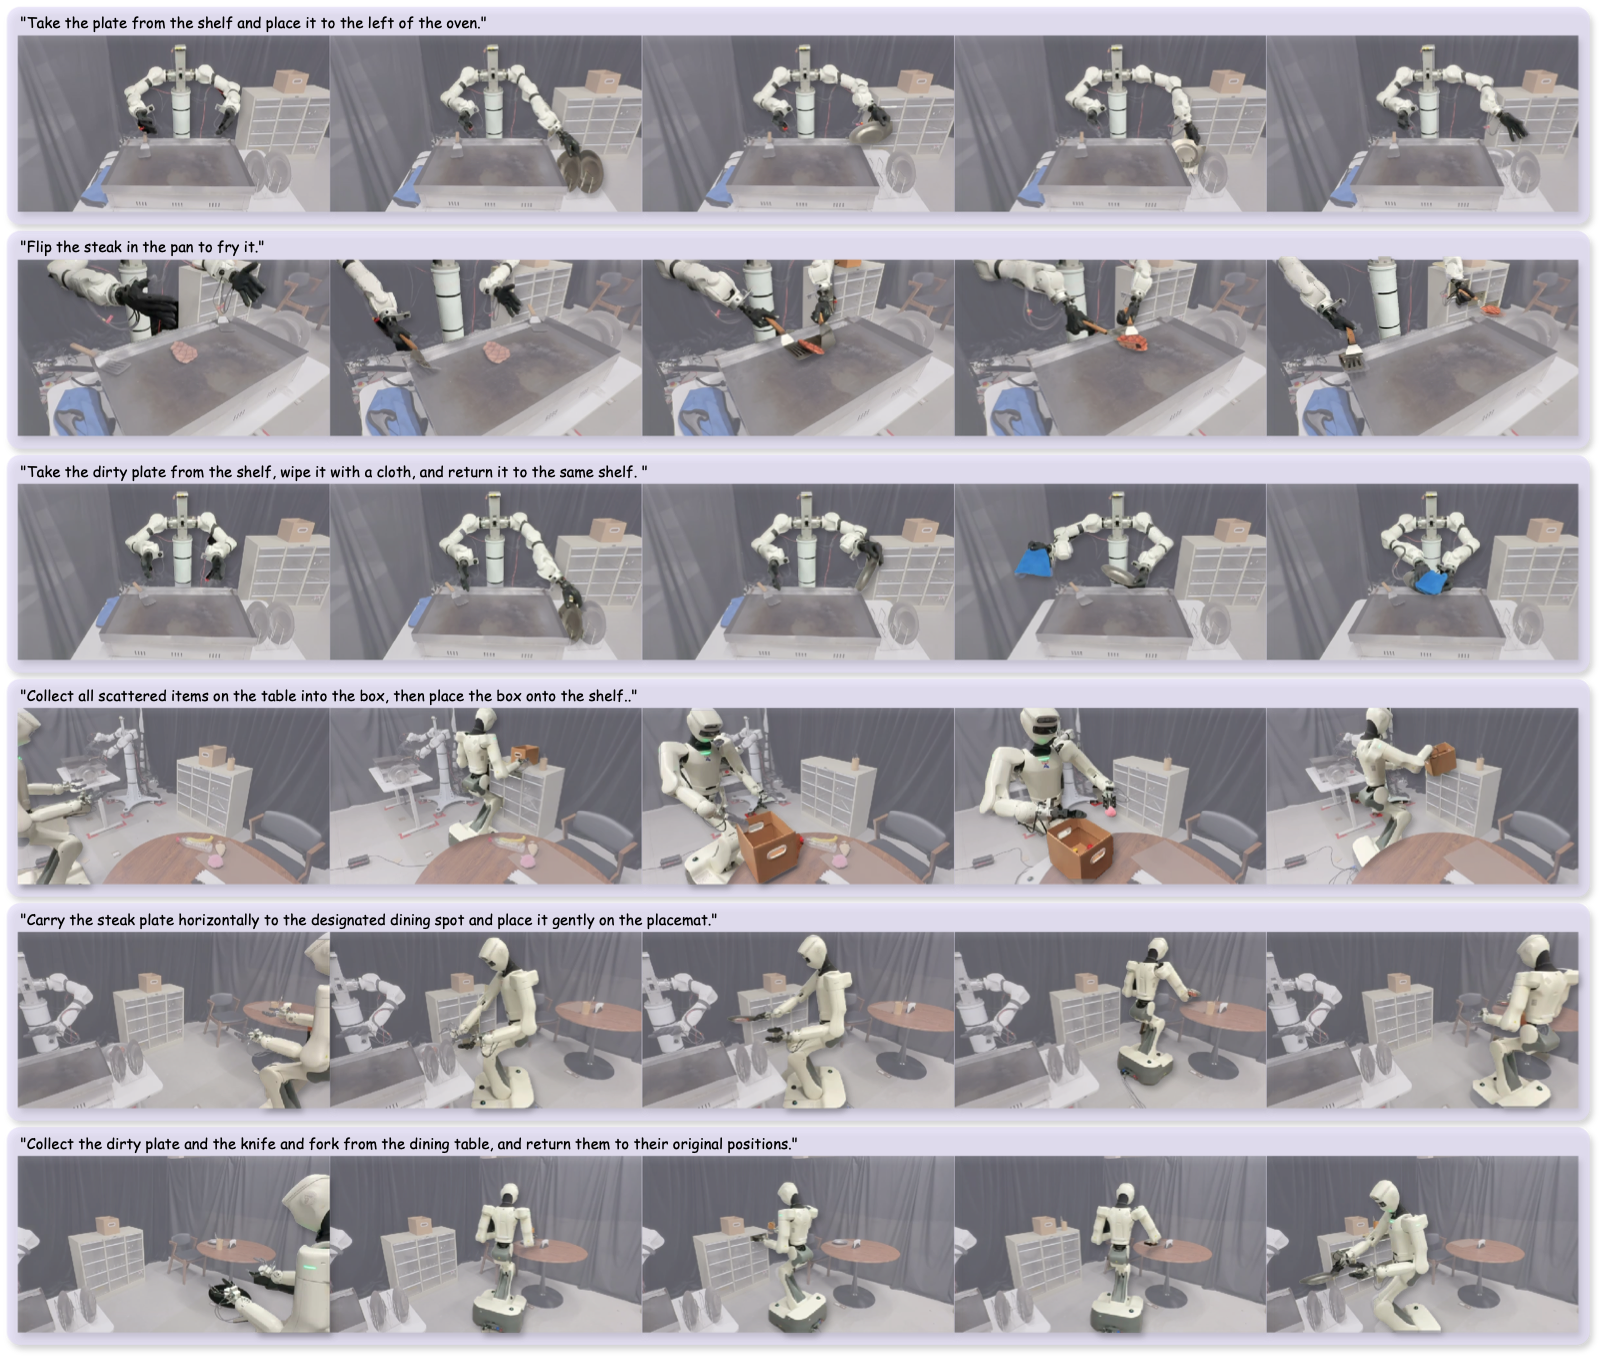
Trên 8 điều kiện triển khai thực tế bao gồm:
- Bimanual coordination — phối hợp 2 tay
- Spatial generalization — vị trí vật thể thay đổi
- Dynamic generalization — môi trường thay đổi khi thực hiện
- Few-shot cross-embodiment — adapt sang robot mới chỉ với ít demo
- Instruction following — tuân theo lệnh ngôn ngữ đa dạng
SLA đạt 83.8% trung bình vs 59.8% của π0.5. Đây là kết quả trên mọi 8 điều kiện — SLA giành chiến thắng ở tất cả, không thua ở bất kỳ điều kiện nào.

Ablation quan trọng: Pre-training vs Post-training alignment
Một trong những ablation thú vị nhất: so sánh giữa 3 cách áp dụng spatial alignment:
- Chỉ trong post-training (như Spatial Forcing)
- Chỉ trong continual pre-training
- Cả hai giai đoạn (SLA đầy đủ)
Kết quả rõ ràng: áp dụng cả hai giai đoạn vượt trội ở mọi tỷ lệ dữ liệu được test, xác nhận rằng xây dựng nền tảng 3D từ sớm trong pre-training là cần thiết.
Cách chạy SLA — Hướng dẫn thực tế
Hiện tại code SLA được phát hành qua project page tại embodiedsla.github.io. Nhóm tác giả liên kết với repository của Spatial Forcing làm nền tảng (OpenHelix-Team).
Yêu cầu môi trường
# Python 3.10+, CUDA 12.x
# GPU: A100/H100 để train; inference chạy được trên RTX 3090+
conda create -n sla python=3.10
conda activate sla

# Clone từ repo chính thức
git clone https://github.com/OpenHelix-Team/SpatialForcing
cd SpatialForcing
pip install -r requirements.txt
Cấu trúc kiến trúc inference
Điều thú vị nhất về SLA từ góc độ deploy: không cần thay đổi gì. Nếu bạn đã có setup π0.5 inference, SLA chạy với cùng code:
# Inference: hoàn toàn giống pi0.5
# Không cần OmniVGGT, không cần alignment projector
# Chỉ dùng checkpoint đã được train với SLA objective

from pi05_policy import Pi05Policy

policy = Pi05Policy.from_pretrained("path/to/sla-checkpoint")

# Giống hệt pi0.5 inference
action = policy.predict(
    image=rgb_obs,          # RGB only - không cần depth!
    language="pick up the cup",
    robot_state=joint_angles
)
Training pipeline
Nếu muốn train SLA từ đầu (hoặc continual pre-train thêm):
# Step 1: Load pi0.5 checkpoint
base_policy = load_pi05_checkpoint("pi05-pretrained.pt")

# Step 2: Setup teacher (chỉ dùng lúc training)
teacher = OmniVGGT.from_pretrained("omni-vggt-weights")
teacher.eval()  # Frozen! Không update gradient

# Step 3: Alignment projector + gates
alignment_projector = AlignmentMLP(
    vla_dim=1024,  # π0.5 hidden dim
    teacher_dim=teacher.output_dim
)
layer_gates = AdaptiveLayerGates(num_layers=base_policy.num_layers)

# Step 4: Combined loss
def compute_sla_loss(batch, policy, teacher, projector, gates):
    # Action loss (flow matching như pi0.5)
    action_loss = policy.flow_matching_loss(batch)

    # Spatial alignment loss
    with torch.no_grad():
        # Teacher nhận RGB + optional depth/calibration
        spatial_features = teacher(
            rgb=batch["images"],
            depth=batch.get("depth"),          # Optional
            calibration=batch.get("calib")     # Optional
        )

    # Lấy intermediate visual embeddings từ nhiều layer
    vla_embeddings = policy.get_intermediate_embeddings(batch["images"])

    # Adaptive layer selection
    aggregated = layer_gates(vla_embeddings)  # Weighted sum

    # Project + compute cosine similarity
    projected = projector(aggregated)
    align_loss = 1 - F.cosine_similarity(projected, spatial_features, dim=-1).mean()

    alpha = 0.1  # Alignment loss weight
    return action_loss + alpha * align_loss

# Step 5: Probabilistic state dropout
def apply_state_dropout(batch, dropout_prob=0.3):
    if random.random() < dropout_prob:
        batch["robot_state"] = torch.zeros_like(batch["robot_state"])
    return batch
Tips khi áp dụng SLA cho custom task
1. Continual pre-training có cần thiết không?
Nếu bạn chỉ có dataset task-specific nhỏ, bỏ qua continual pre-training và chỉ áp dụng SLA objective trong post-training vẫn cho lợi ích (đây là Spatial Forcing). Nhưng để đạt full benefit, cần pre-train trên tập dữ liệu đa dạng trước.
2. Rotation representation
Chuyển action space của bạn sang rotation vectors thay vì euler angles. Đây là thay đổi nhỏ nhưng ablation cho thấy cải thiện đáng kể:
from scipy.spatial.transform import Rotation

def euler_to_rotvec(euler_angles):
    return Rotation.from_euler('xyz', euler_angles).as_rotvec()
3. Camera calibration
Nếu dataset của bạn có camera intrinsics/extrinsics, cung cấp cho OmniVGGT. Nếu không, RGB-only vẫn chạy được (OmniVGGT dự đoán depth từ monocular cues).
4. State dropout schedule
Bắt đầu với dropout_prob=0.3, giảm dần trong giai đoạn post-training cuối để model học balance giữa visual và state cues.
So sánh với Spatial Forcing
SLA là continuation của Spatial Forcing (cùng nhóm OpenHelix-Team). Điểm khác biệt chính:
| Spatial Forcing | SLA | |
|---|---|---|
| Scope | Post-training only | Pre-training + Post-training |
| Data diversity | Task-specific | Heterogeneous multi-embodiment |
| Layer selection | Fixed layer | Adaptive gates |
| State dropout | Không | Có |
| Data efficiency | Trung bình | Cao (50 demo đủ) |
SLA không "thay thế" Spatial Forcing — nó là Spatial Forcing được nâng lên continual pre-training và thêm các kỹ thuật cải thiện.
Điểm mạnh và hạn chế
Điểm mạnh nổi bật:
- Không đổi kiến trúc inference — tương thích hoàn toàn với pipeline π0.5 hiện có
- Không bắt buộc depth sensor — RGB là đủ
- Data efficiency vượt trội: 50 demo thay vì 3,000
- Generalization tốt: thắng tất cả 8 điều kiện real-world
- Continual pre-training là scalable foundation — càng nhiều data, càng tốt
Hạn chế cần lưu ý:
- OmniVGGT là thành phần đóng (không open-source đầy đủ tại thời điểm viết) — cần xem xét accessibility
- Chi phí continual pre-training cao (1.7M episodes cần GPU cluster lớn)
- Code chính thức chưa đầy đủ documentation tại thời điểm paper published
- Chưa rõ performance trên các robot arm không phải Franka/UR series
Ý nghĩa rộng hơn: Hướng đi của VLA Foundation Model
SLA đặt ra một câu hỏi quan trọng cho cộng đồng nghiên cứu: nên build 3D understanding vào foundation model ngay từ giai đoạn pre-training, hay chỉ add-on lúc fine-tuning?
Kết quả ablation của SLA ủng hộ rõ ràng cho hướng đầu — tương tự như cách mà LLM benefit từ being pre-trained on code, math trước khi fine-tune cho specific task, VLA benefit từ having spatial understanding baked in từ foundation.
Đây là hướng nghiên cứu có thể dẫn đến thế hệ VLA tiếp theo — không chỉ "học tốt hơn từ demo" mà "hiểu không gian sâu hơn từ nền tảng".