Đến cuối Bài 4, chiếc xe của chúng ta đã biết hai thứ: nó đang ở đâu với sai số ngang khoảng 1,6 cm, và xung quanh nó có gì — xe, người đi bộ, vạch kẻ, đèn tín hiệu. Nhưng biết chưa phải là lái. Câu hỏi tiếp theo mới là câu hỏi khó nhất trong toàn bộ stack: bây giờ nên làm gì?
Đây là phần mà kỹ sư mới hay đánh giá thấp. Perception có leaderboard, có mAP, có dataset công khai — sai hay đúng đo được ngay. Planning thì không: một quỹ đạo "đúng" trên giấy vẫn có thể khiến hành khách say xe, khiến xe phía sau phanh gấp, hoặc khiến chiếc xe kẹt cứng ở một vòng xuyến đông đúc vì nó quá lịch sự để chen vào. Và như phần cuối bài này sẽ cho thấy, đây cũng là phần mà deep learning cho đến 2026 vẫn chưa thắng được các luật viết tay trong benchmark closed-loop nghiêm túc nhất hiện có.
Roadmap series
- Bài 1 — SAE Level 2 vs 2+ vs 3 vs 4: xác định ai chịu trách nhiệm lái, ODD và fallback.
- Bài 2 — Sensor fusion: camera, radar và LiDAR dựng perception suy giảm an toàn khi cảm biến lỗi.
- Bài 3 — Perception: 3D detection, occupancy grid và tracking trên nuScenes.
- Bài 4 — Localization và HD map: GNSS/IMU fusion, NDT trên LiDAR, hướng map-free.
- Bài 5 — Planning & control: từ rule-based tới MPC và PDM, bám quỹ đạo thực tế.
- Bài 6 — Validation: ISO 26262, SOTIF và Euro NCAP — chứng minh an toàn khi không lái đủ km.
Bốn tầng quyết định — và vì sao phải tách chúng ra
Không ai viết một hàm duy nhất nhận point cloud và trả về góc lái. Bài toán bị tách thành bốn tầng, mỗi tầng có tầm nhìn (horizon) và tần số khác nhau hàng bậc:
| Tầng | Câu hỏi trả lời | Horizon | Tần số | Công cụ điển hình |
|---|---|---|---|---|
| Route / Mission | Đi đường nào tới đích? | 1–50 km | 0,1–1 Hz | Dijkstra/A* trên Lanelet2 routing graph |
| Behavior | Bám làn, đổi làn, hay dừng nhường? | 5–15 s | 5–10 Hz | FSM, Behavior Tree, scenario manager |
| Motion / Local | Quỹ đạo cụ thể (x, y, v, t) là gì? | 3–8 s | 10–20 Hz | Frenet lattice, optimization, MPC |
| Control | Gửi bao nhiêu độ lái, bao nhiêu ga/phanh? | 0,5–2 s | 50–100 Hz | PID, Pure Pursuit, Stanley, LQR, MPC |
Lý do tách tầng không phải vì "kiến trúc đẹp" mà vì ngân sách tính toán. Một bộ giải tối ưu phi tuyến trên horizon 30 giây với đầy đủ vật cản động sẽ không bao giờ chạy kịp 100 Hz. Chia nhỏ ra, mỗi tầng chỉ phải giải một bài toán vừa với thời gian nó có.
Điểm đáng chú ý: mỗi tầng dùng đúng sản phẩm của Bài 4. Route chạy trên topology của Lanelet2, motion planner dùng centerline làm trục tham chiếu, còn controller cần pose chính xác cỡ centimet để biết mình lệch bao nhiêu.
Tầng 1 — Route planning trên Lanelet2 routing graph
Lanelet2 không chỉ là hình học: nó tự dựng được một routing graph trong đó mỗi lanelet là một node, và cạnh biểu diễn quan hệ "đi tiếp được", "đổi làn trái được", "đổi làn phải được". Tìm đường trở thành bài toán đồ thị kinh điển.
import lanelet2
from lanelet2.core import BasicPoint2d
from lanelet2.projection import UtmProjector
from lanelet2.io import Origin

# Load bản đồ Lanelet2 (định dạng OSM XML)
projector = UtmProjector(Origin(21.0278, 105.8342))   # gốc toạ độ: Hà Nội
lmap = lanelet2.io.load("map.osm", projector)

# Luật giao thông: lái bên phải, xe con
traffic_rules = lanelet2.traffic_rules.create(
    lanelet2.traffic_rules.Locations.Germany,
    lanelet2.traffic_rules.Participants.Vehicle,
)
graph = lanelet2.routing.RoutingGraph(lmap, traffic_rules)

start = lmap.laneletLayer[1001]
goal = lmap.laneletLayer[2042]

# withLaneChanges=True: cho phép lời giải đi qua việc đổi làn
route = graph.getRoute(start, goal, 0, withLaneChanges=True)
if route is None:
    raise RuntimeError("Không tồn tại đường đi hợp lệ trong ODD của bản đồ")

path = route.shortestPath()
print(f"Số lanelet trên tuyến: {len(path)}")
print(f"Chiều dài tuyến: {route.length2d():.1f} m")
print(f"Số lần đổi làn bắt buộc: {path.getRemainingLane(path[0]).size() != len(path)}")
Chi tiết dễ bỏ sót: chi phí đổi làn không phải bằng 0. Nếu bạn đặt cost đổi làn bằng chiều dài hình học, planner sẽ vui vẻ trả về một tuyến đòi đổi ba làn trong 80 m — hợp lệ về topology, bất khả thi về động học. Autoware giải quyết bằng cách nhân thêm hệ số phạt và yêu cầu một chiều dài tối thiểu cho mỗi lần đổi làn trước khi tới ngã rẽ.
Tầng 2 — Behavior planning và giới hạn của rule-based
Behavior planner nhận tuyến đường rồi quyết định chế độ lái hiện tại. Cách cài đặt phổ biến nhất vẫn là finite state machine:
from enum import Enum

class Behavior(Enum):
    LANE_FOLLOW      = "bám làn"
    LANE_CHANGE_LEFT = "đổi làn trái"
    PREPARE_CHANGE   = "chuẩn bị đổi làn"
    STOP_AT_LINE     = "dừng trước vạch"
    YIELD_CROSSING   = "nhường tại vạch sang đường"

def decide(state, ego, scene):
    """Trả về behavior kế tiếp. Thứ tự kiểm tra CHÍNH LÀ thứ tự ưu tiên."""
    # 1. An toàn trước: đèn đỏ / vạch dừng luôn thắng mọi mong muốn khác
    if scene.stop_line_ahead_m < ego.braking_distance_m():
        return Behavior.STOP_AT_LINE
    # 2. Người đi bộ đang trong hoặc sắp vào vạch sang đường
    if scene.pedestrian_at_crossing:
        return Behavior.YIELD_CROSSING
    # 3. Nhu cầu từ route: còn bao xa thì phải sang làn trái để rẽ
    if scene.distance_to_required_change_m < 200:
        if scene.left_gap_s > 3.0 and scene.left_gap_ahead_s > 1.5:
            return Behavior.LANE_CHANGE_LEFT
        return Behavior.PREPARE_CHANGE   # giảm tốc, bật xi-nhan, chờ khe
    return Behavior.LANE_FOLLOW
Đoạn code trên trông hiền lành, và đó chính là cái bẫy. Với 5 behavior, số cặp chuyển trạng thái cần suy nghĩ là 20. Với 15 behavior — con số thực tế của một stack đi phố — là 210. Apollo và Autoware đều đã bỏ FSM phẳng: Apollo chuyển sang kiến trúc scenario–stage (mỗi kịch bản như "ngã tư không đèn", "đỗ xe song song" là một máy trạng thái con độc lập), còn Autoware dùng behavior_path_planner với các module có thứ tự ưu tiên chạy song song rồi hợp nhất kết quả.
Bài học rút ra rất chung: khi số luật vượt qua ngưỡng con người ôm được trong đầu, thứ cần đổi không phải là thêm luật mà là đổi cấu trúc để luật không tương tác chéo nữa.
Tầng 3 — Motion planning trong Frenet frame
Đây là nơi HD map trả cổ tức. Thay vì lập kế hoạch trong toạ độ Descartes (x, y) — nơi "đi thẳng" trên đường cong là một hàm phức tạp — ta đổi sang Frenet frame lấy centerline của lanelet làm trục:
s: quãng đường dọc theo centerlined: độ lệch ngang so với centerline
Trong hệ này, "giữ làn" đơn giản là d ≈ 0, còn "đổi làn trái" là d đi từ 0 tới +3,5. Đường cong của con đường biến mất khỏi bài toán.
Thuật toán Frenet optimal trajectory (Werling et al., ICRA 2010) sinh ra một rừng ứng viên bằng cách lấy mẫu: với mỗi cặp (độ lệch ngang đích d_T, thời gian tới đích T), nối trạng thái hiện tại và trạng thái đích bằng một đa thức bậc năm cho d(t) và bậc bốn cho s(t). Vì sao bậc năm? Vì ta cần khớp sáu điều kiện biên — vị trí, vận tốc, gia tốc ở cả hai đầu — và đa thức bậc năm là bậc thấp nhất có sáu hệ số tự do. Một lợi ích kèm theo: nghiệm này tối ưu jerk, tức là êm cho hành khách.
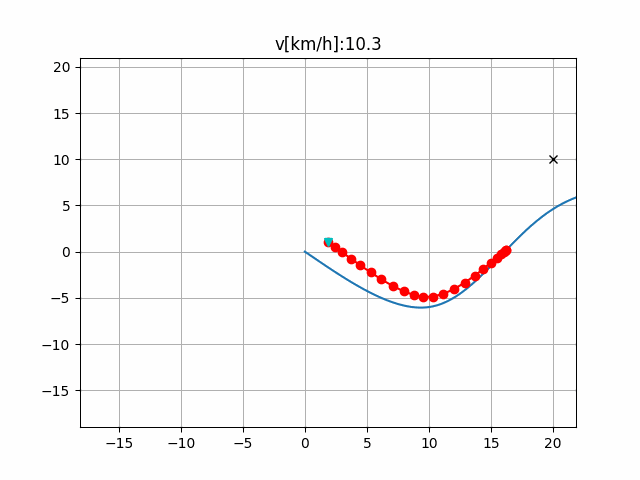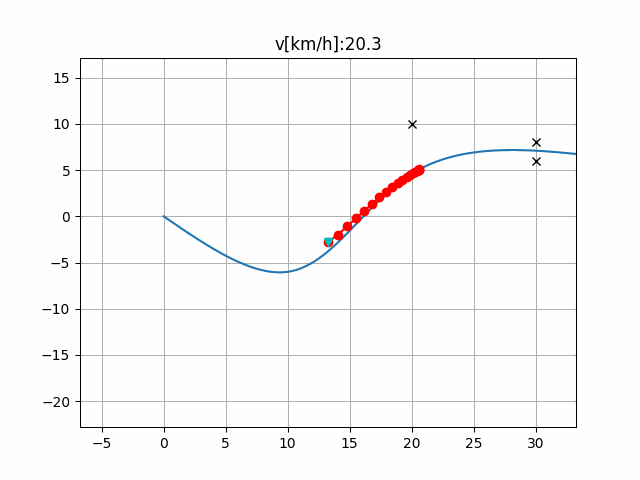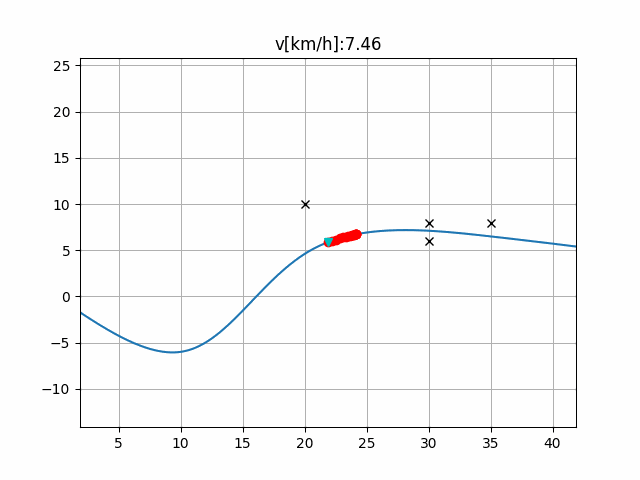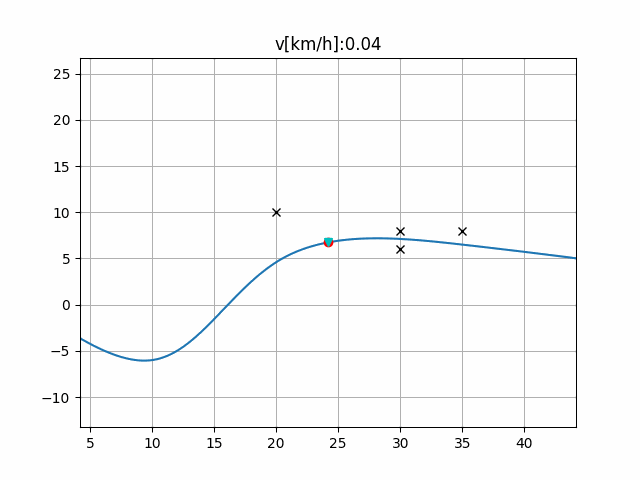
Frenet optimal trajectory ở tốc độ cao, có nhập làn và dừng: các đường mảnh là ứng viên bị loại (va chạm hoặc vượt giới hạn động học), đường đậm là quỹ đạo được chọn. Nguồn: repo AtsushiSakai/PythonRoboticsGifs
Hàm chi phí điển hình cho mỗi ứng viên:
J = k_j · ∫ jerk² dt + k_T · T + k_d · d_T² + k_v · (v_T − v_target)²
Bốn số hạng đó chính là bốn thứ ta muốn cân bằng: êm, nhanh, bám giữa làn, và giữ tốc độ mong muốn. Mọi ứng viên sau đó phải qua ba bộ lọc cứng — vượt gia tốc cho phép, vượt độ cong bánh lái, hoặc va chạm với quỹ đạo dự đoán của các đối tượng (lấy từ module tracking ở Bài 3) — đều bị loại thẳng.
Điểm tinh tế mà người mới hay bỏ qua: planner không kiểm tra va chạm với vị trí hiện tại của xe khác, mà với vị trí dự đoán tại thời điểm tương ứng trên quỹ đạo. Kiểm tra nhầm cái đầu tiên là cách chắc chắn nhất để tạo ra một chiếc xe phanh gấp trước mỗi xe đang chạy ngang qua mũi mình.
Tầng 4 — Control: bốn bậc thang từ hình học tới tối ưu
Pure Pursuit — hình học thuần tuý
Chọn một điểm trên quỹ đạo cách xe một khoảng L_d (lookahead distance), rồi tính góc lái để cung tròn nối xe với điểm đó:
δ = arctan( 2·L·sin(α) / L_d )
với L là chiều dài cơ sở (wheelbase) và α là góc giữa hướng xe và hướng tới điểm ngắm. Thường L_d = k·v + L_min để ở tốc độ cao xe nhìn xa hơn.
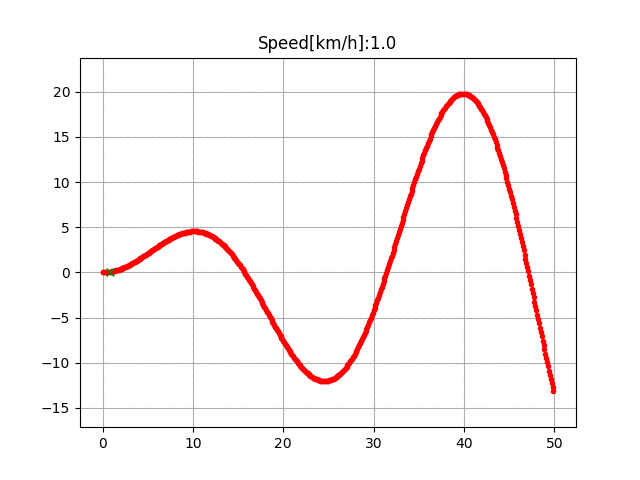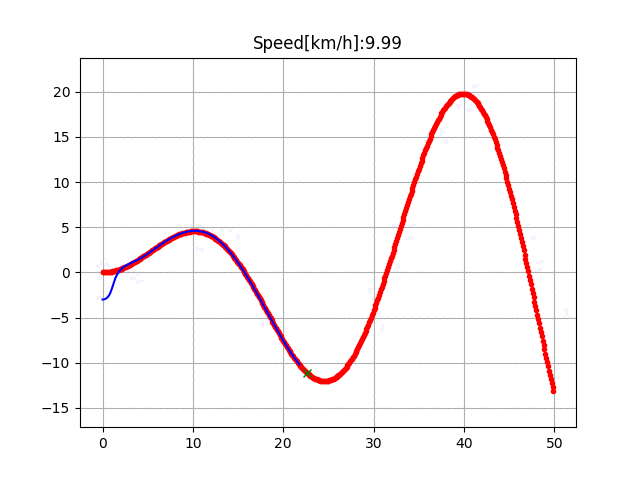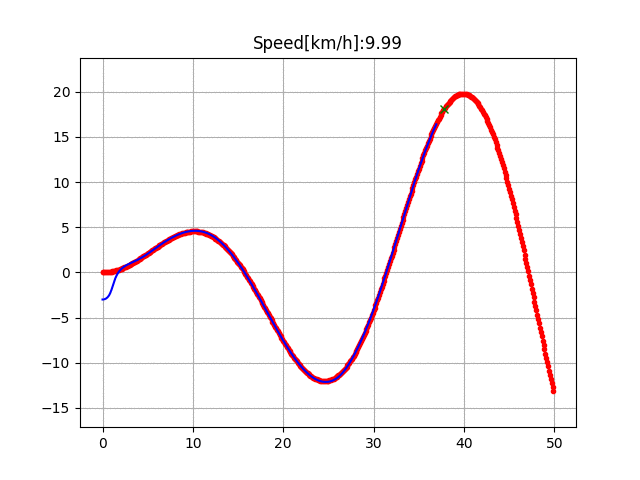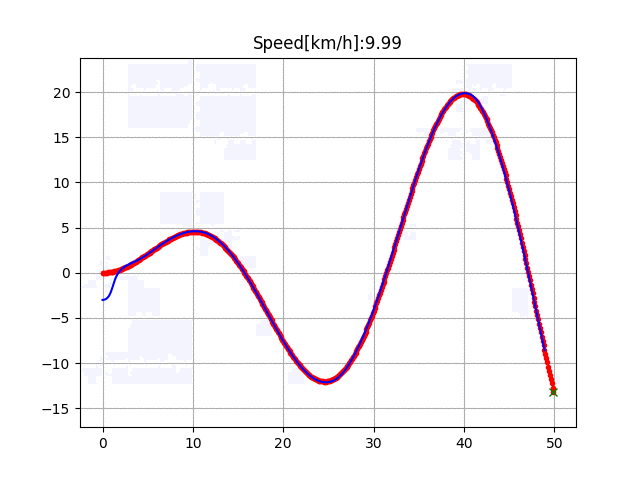
Pure pursuit: điểm ngắm (lookahead point) trượt dọc quỹ đạo, xe luôn lái theo cung tròn nối tới điểm đó. Nguồn: repo AtsushiSakai/PythonRoboticsGifs
Ưu điểm: hai dòng code, không cần model động lực học. Nhược điểm: luôn cắt cua (cut corner) ở các khúc cong gấp, và L_d là một nút vặn phải tinh chỉnh thủ công cho từng dải tốc độ.
Stanley — sửa cả sai số ngang lẫn sai số hướng
Stanley (ra đời trên chiếc xe thắng DARPA Grand Challenge 2005) cộng hai thành phần: sai lệch hướng và sai lệch ngang được chuẩn hoá theo tốc độ.
δ = (ψ_path − ψ_ego) + arctan( k·e_fa / (v + k_soft) )
Khác biệt quan trọng so với pure pursuit: Stanley đo sai số tại trục bánh trước, không phải trọng tâm xe — nhờ vậy nó bám mép đường tốt hơn nhiều ở tốc độ thấp.
LQR — bắt đầu có model
LQR tuyến tính hoá động lực học sai số quanh quỹ đạo tham chiếu rồi giải phương trình Riccati để có ma trận gain K tối ưu cho hàm chi phí bậc hai ∫(xᵀQx + uᵀRu)dt. Đổi Q và R là đổi được cân bằng giữa "bám sát" và "lái mượt" một cách có nguyên tắc, thay vì vặn nút mò.
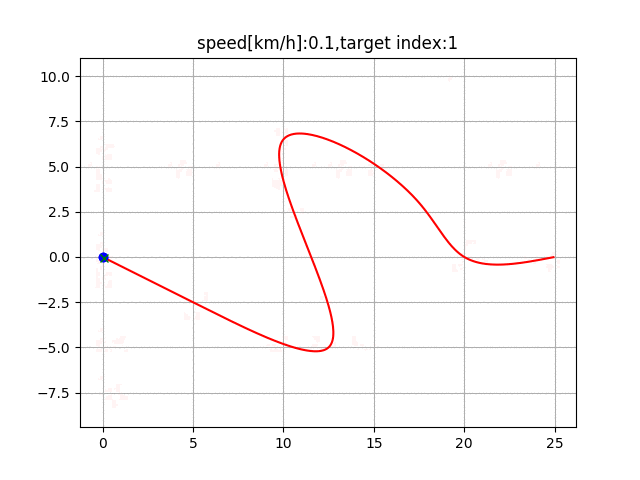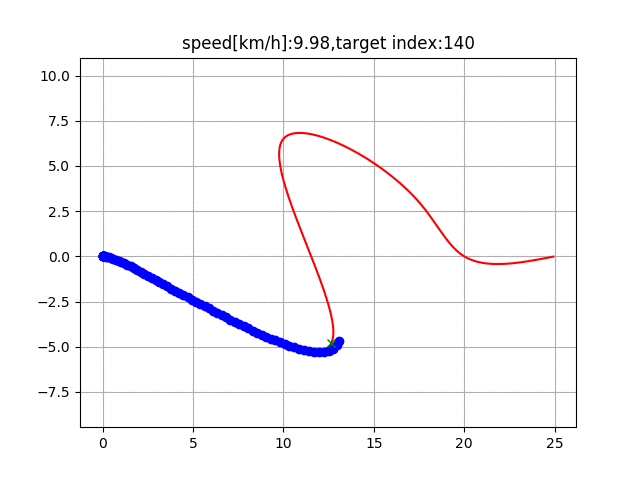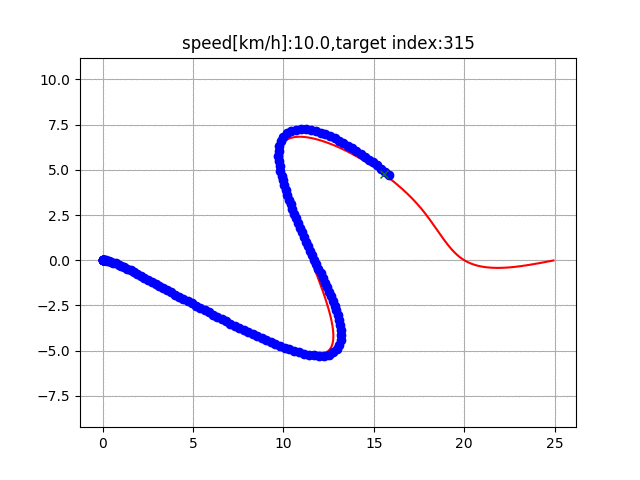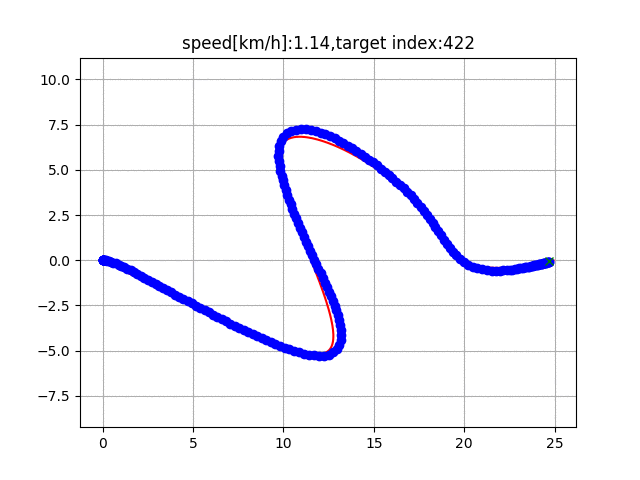
LQR speed & steering control: gain tối ưu được tính lại theo tốc độ hiện tại, điều khiển đồng thời trục dọc và trục ngang. Nguồn: repo AtsushiSakai/PythonRoboticsGifs
MPC — nhìn trước và tôn trọng ràng buộc
Điểm yếu chung của cả ba phương pháp trên: chúng phản ứng, không dự đoán, và không có cách nào diễn đạt ràng buộc kiểu "góc lái không được vượt 30 độ" hay "tốc độ đổi góc lái không quá 200 độ/giây". MPC giải đúng chỗ đó: mỗi chu kỳ, nó giải một bài toán tối ưu trên horizon N bước, áp dụng chỉ bước điều khiển đầu tiên, rồi lặp lại ở chu kỳ sau (receding horizon).
Dưới đây là một MPC bám làn chạy được, dùng mô hình sai số ngang tuyến tính hoá của xe đạp (bicycle model) trong Frenet frame — cài pip install cvxpy numpy là chạy:
import numpy as np
import cvxpy as cp

# --- Tham số xe và bộ điều khiển ---
L    = 2.7      # wheelbase (m)
DT   = 0.05     # chu kỳ điều khiển 20 Hz
N    = 20       # horizon 20 bước = 1.0 s
V    = 15.0     # tốc độ dọc (m/s) — coi như hằng trong 1 s tới

DELTA_MAX  = np.deg2rad(30.0)    # giới hạn cơ khí của cơ cấu lái
DRATE_MAX  = np.deg2rad(200.0) * DT   # giới hạn tốc độ đổi góc lái mỗi bước

# Mô hình sai số ngang: x = [e_y, e_psi]
#   e_y'   = V * e_psi
#   e_psi' = (V / L) * delta  -  V * kappa_ref   (kappa_ref = độ cong tham chiếu)
A = np.array([[1.0, V * DT],
              [0.0, 1.0]])
B = np.array([[0.0],
              [V * DT / L]])
E = np.array([[0.0],
              [-V * DT]])          # ma trận nhiễu đo được (feedforward độ cong)

Q  = np.diag([10.0, 1.0])   # phạt sai số ngang nặng hơn sai số hướng
Qf = np.diag([50.0, 5.0])   # phạt trạng thái cuối horizon mạnh hơn
R  = np.array([[1.0]])      # phạt biên độ lái
Rd = np.array([[50.0]])     # phạt thay đổi góc lái (đây là thứ làm xe êm)

def solve_mpc(x0, kappa_ref, delta_prev):
    """x0: [e_y, e_psi] hiện tại. kappa_ref: mảng độ cong N bước tới (1/m)."""
    x = cp.Variable((2, N + 1))
    u = cp.Variable((1, N))

    cost = 0.0
    constraints = [x[:, 0] == x0]

    for k in range(N):
        cost += cp.quad_form(x[:, k], Q) + cp.quad_form(u[:, k], R)
        if k > 0:
            cost += cp.quad_form(u[:, k] - u[:, k - 1], Rd)
        else:
            cost += cp.quad_form(u[:, 0] - delta_prev, Rd)

        constraints += [
            x[:, k + 1] == A @ x[:, k] + B @ u[:, k] + E.flatten() * kappa_ref[k],
            cp.abs(u[:, k]) <= DELTA_MAX,
        ]
        if k > 0:
            constraints += [cp.abs(u[:, k] - u[:, k - 1]) <= DRATE_MAX]

    cost += cp.quad_form(x[:, N], Qf)

    prob = cp.Problem(cp.Minimize(cost), constraints)
    prob.solve(solver=cp.OSQP, warm_start=True)

    if prob.status not in ("optimal", "optimal_inaccurate"):
        return None, prob.status          # fallback: giữ lệnh cũ / kích hoạt MRC
    return float(u.value[0, 0]), prob.status

if __name__ == "__main__":
    # Xe lệch phải 0.4 m, lệch hướng 2 độ, đang vào cua bán kính 300 m
    x0 = np.array([0.4, np.deg2rad(2.0)])
    kappa = np.full(N, 1.0 / 300.0)

    delta, status = solve_mpc(x0, kappa, np.array([0.0]))
    print(f"status = {status}")
    print(f"góc lái lệnh = {np.rad2deg(delta):.2f} deg")
Chạy thử trên máy tính để bàn, bài toán QP 60 biến này giải xong trong khoảng 1–3 ms với OSQP — dư sức cho vòng lặp 20 Hz, và vẫn còn biên an toàn lớn cho một ECU ô tô yếu hơn nhiều.
Ba chi tiết trong đoạn code trên đáng để nhớ:
Rdquan trọng hơnR. Phạt biên độ góc lái chỉ làm xe lười lái; phạt thay đổi góc lái mới là thứ loại bỏ hiện tượng rung tay lái mà hành khách cảm nhận rõ nhất.- Feedforward độ cong (
E @ kappa_ref) không phải tuỳ chọn. Thiếu nó, MPC phải "học" lại độ cong qua sai số tích luỹ mỗi chu kỳ, và xe sẽ luôn bám hụt ở phía trong khúc cua. - Luôn xử lý
prob.status. Một QP không hội tụ ở tốc độ 100 km/h không được phép trả vềNonerồi lặng lẽ để controller giữ nguyên lệnh cũ vô hạn — đó chính xác là loại lỗi mà SOTIF ở Bài 6 bắt bạn phải thiết kế phương án dự phòng.
So sánh bốn bộ điều khiển
| Bộ điều khiển | Cần model xe? | Ràng buộc cứng | Tính toán mỗi chu kỳ | Điểm yếu chính |
|---|---|---|---|---|
| Pure Pursuit | Không | Không | < 0,01 ms | Cắt cua, nhạy với L_d |
| Stanley | Tối thiểu | Không | < 0,01 ms | Dao động ở tốc độ cao |
| LQR | Có (tuyến tính hoá) | Không | ~0,1 ms | Không diễn đạt được giới hạn cơ cấu |
| MPC | Có | Có | 1–5 ms | Cần solver, cần xử lý khi không hội tụ |
PDM: khi luật viết tay đánh bại planner học máy
Đây là phần làm nhiều người bất ngờ.
nuPlan (Motional, 2023) là benchmark planning quy mô lớn đầu tiên chấm điểm theo closed-loop: planner được thả vào mô phỏng, hành động của nó thực sự thay đổi trạng thái thế giới ở bước kế tiếp. Trước đó, hầu hết công trình planning học máy chỉ được chấm open-loop — so quỹ đạo dự đoán với quỹ đạo mà tài xế thật đã đi, giống hệt cách chấm một bài toán hồi quy.
Nhóm của Đại học Tübingen (Dauner, Hallgarten, Geiger, Chitta) đã làm một thí nghiệm đơn giản đến mức khó chịu, công bố tại Parting with Misconceptions about Learning-based Vehicle Motion Planning — Dauner et al., CoRL 2023, và thắng luôn nuPlan Challenge 2023. Kết quả trên benchmark Val14 (CLS = closed-loop score, OLS = open-loop score):
| Phương pháp | Biểu diễn | CLS-R ↑ | CLS-NR ↑ | OLS ↑ | Thời gian (ms) ↓ |
|---|---|---|---|---|---|
| Urban Driver | Polygon | 50 | 53 | 82 | 64 |
| GC-PGP | Graph | 55 | 59 | 83 | 100 |
| PlanCNN | Raster | 72 | 73 | 64 | 43 |
| IDM (rule-based thuần) | Centerline | 77 | 76 | 38 | 27 |
| PDM-Open (học máy) | Centerline | 54 | 50 | 86 | 7 |
| PDM-Closed (rule-based) | Centerline | 92 | 93 | 42 | 91 |
| PDM-Hybrid | Centerline | 92 | 93 | 84 | 96 |
| Log Replay (tài xế thật) | GT | 80 | 94 | 100 | – |
Hãy đọc kỹ hai dòng in đậm. PDM-Open — mô hình học máy — đứng đầu bảng open-loop với OLS 86, cao hơn cả PDM-Closed (42). Nhưng khi thả vào mô phỏng closed-loop, chính nó rơi xuống 50, trong khi bộ luật viết tay đạt 93. Thậm chí IDM, một mô hình bám xe trước từ năm 2000, vẫn đánh bại mọi planner học máy trong bảng ở chỉ số closed-loop.
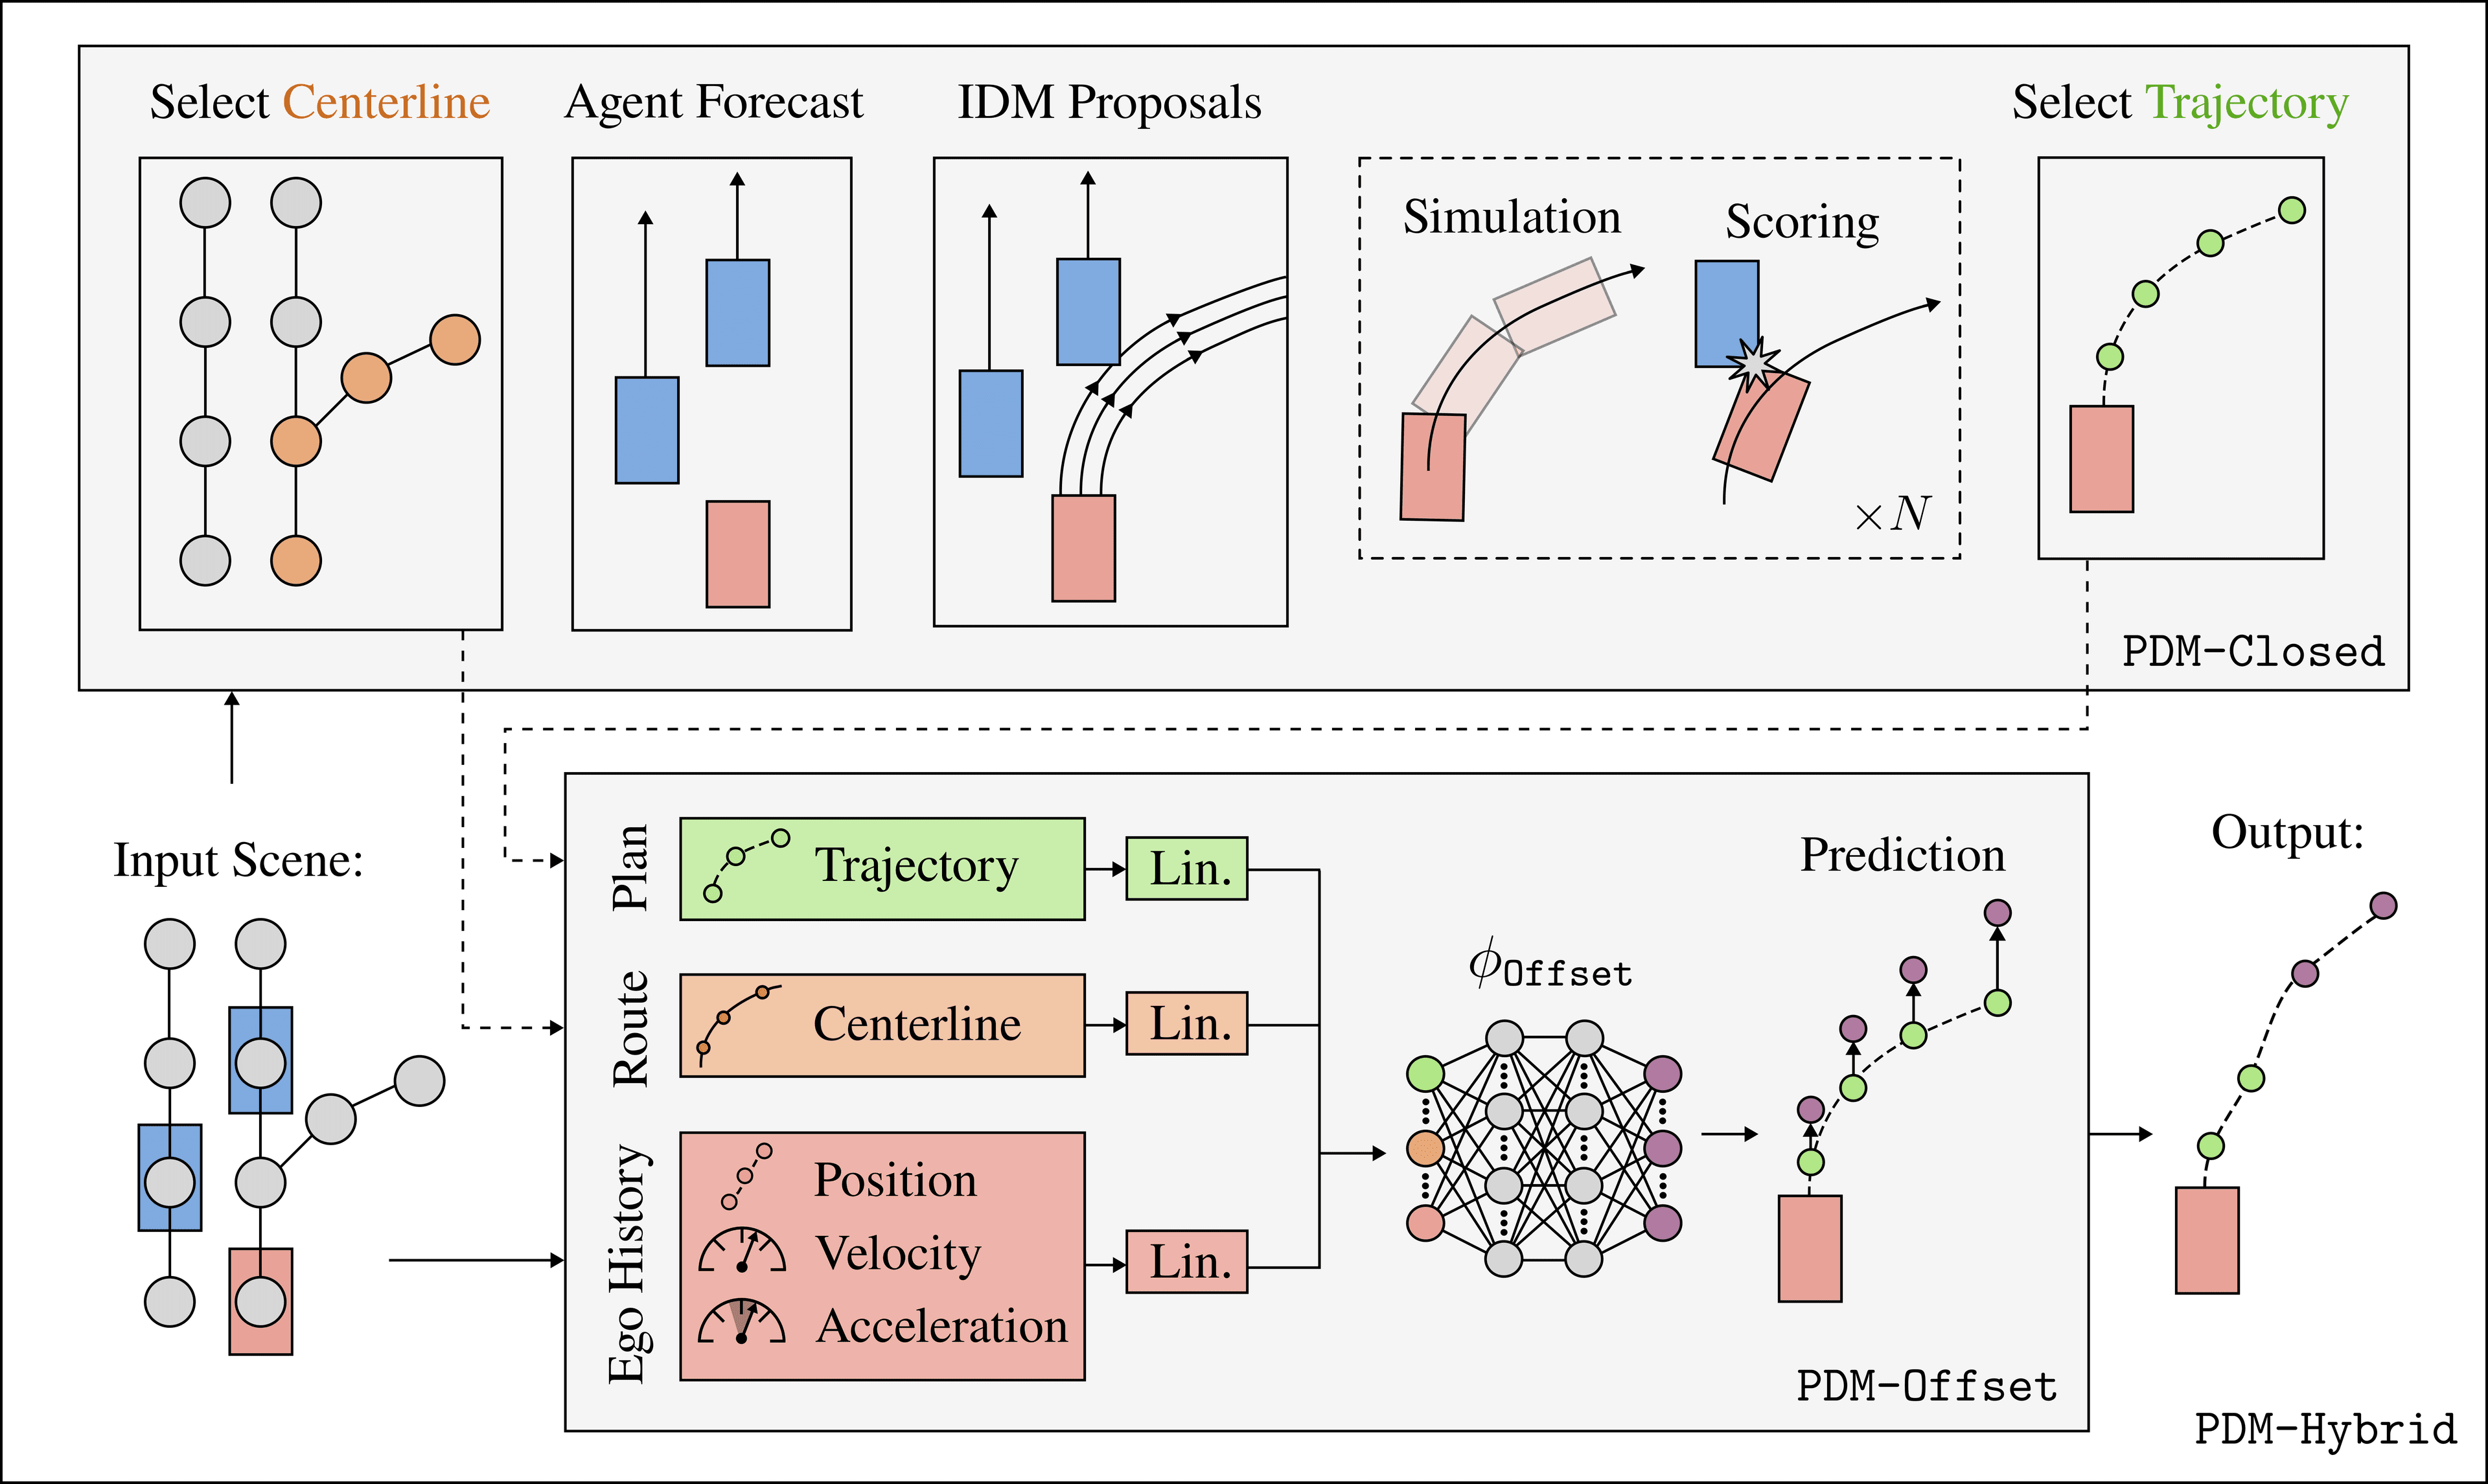
Cơ chế của PDM-Closed không hề phức tạp: sinh một tập nhỏ các đề xuất bằng chính sách IDM với nhiều tốc độ mục tiêu và nhiều độ lệch ngang khác nhau, mô phỏng tiến từng đề xuất bằng bộ điều khiển LQR trên bicycle model, chấm điểm từng đề xuất bằng đúng bộ tiêu chí của nuPlan (va chạm, bám làn, tiến độ, êm ái), rồi chọn cái tốt nhất. Nói cách khác: nó thử trước rồi mới quyết, thay vì hồi quy ra một quỹ đạo trong một lần truyền xuôi.
Hai kết luận cần mang theo:
- Open-loop và closed-loop là hai bài toán khác nhau, và tối ưu cái này không tự động cải thiện cái kia. Một planner học máy bắt chước tài xế rất giỏi vẫn có thể sụp đổ ngay khi sai số của chính nó bắt đầu tích luỹ — vấn đề covariate shift kinh điển của imitation learning.
- Rule-based chưa chết. PDM-Hybrid giữ phần rule-based cho điều khiển ngắn hạn và chỉ dùng mạng học cho dự báo dài hạn — và đó là cấu hình duy nhất trong bảng đạt cả CLS 93 lẫn OLS 84.
Xu hướng end-to-end như UniAD (CVPR 2023 Best Paper) và VAD đưa perception–prediction–planning vào một mạng duy nhất huấn luyện chung, và cho kết quả ấn tượng trên nuScenes open-loop. Nhưng chừng nào chưa có kết quả closed-loop thuyết phục ở quy mô nuPlan, các stack sản xuất — Waymo, Mobileye, comma.ai — vẫn giữ một lớp luật kiểm chứng được nằm giữa mạng nơ-ron và cơ cấu chấp hành.
Ngân sách thời gian của cả chuỗi
Con số thực tế mà một stack L2+ phải sống chung:
| Khâu | Ngân sách điển hình |
|---|---|
| Cảm biến → point cloud/ảnh sẵn sàng | 20–50 ms |
| Perception + tracking (Bài 3) | 50–100 ms |
| Localization (Bài 4) | 10–20 ms |
| Prediction + motion planning | 50–100 ms |
| Control (MPC) | 1–5 ms |
| Truyền lệnh qua CAN tới cơ cấu | 10–20 ms |
| Tổng độ trễ từ cảm biến tới bánh xe | 150–300 ms |
Ở 100 km/h, 250 ms tương đương 7 mét. Đó là lý do mọi planner nghiêm túc đều lập kế hoạch trên trạng thái dự đoán tại thời điểm lệnh được thực thi, chứ không phải trạng thái lúc cảm biến chụp.
Tóm tắt
- Planning tách thành bốn tầng vì ngân sách tính toán, không phải vì thẩm mỹ kiến trúc; mỗi tầng có horizon và tần số riêng.
- Lanelet2 routing graph biến tìm đường thành bài toán đồ thị, nhưng chi phí đổi làn phải được phạt đúng nếu không muốn nhận tuyến bất khả thi.
- Frenet frame loại bỏ độ cong khỏi bài toán, cho phép sinh hàng trăm ứng viên bằng đa thức bậc năm và lọc bằng chi phí + ràng buộc động học.
- MPC là bộ điều khiển duy nhất diễn đạt được ràng buộc cứng;
Rdvà feedforward độ cong quan trọng hơn người mới tưởng. - PDM chứng minh rằng ở closed-loop, một bộ luật biết mô phỏng trước khi quyết vẫn đánh bại planner học máy — và điểm open-loop cao không hề bảo chứng cho điều đó.
Ở Bài 6 — bài cuối của series, chúng ta chuyển từ "làm cho nó chạy" sang "chứng minh nó an toàn": ISO 26262 với các mức ASIL, ISO 21448 (SOTIF) cho những nguy hiểm không đến từ lỗi linh kiện, và bộ giao thức Euro NCAP 2026 — bản sửa đổi lớn nhất kể từ 2009.