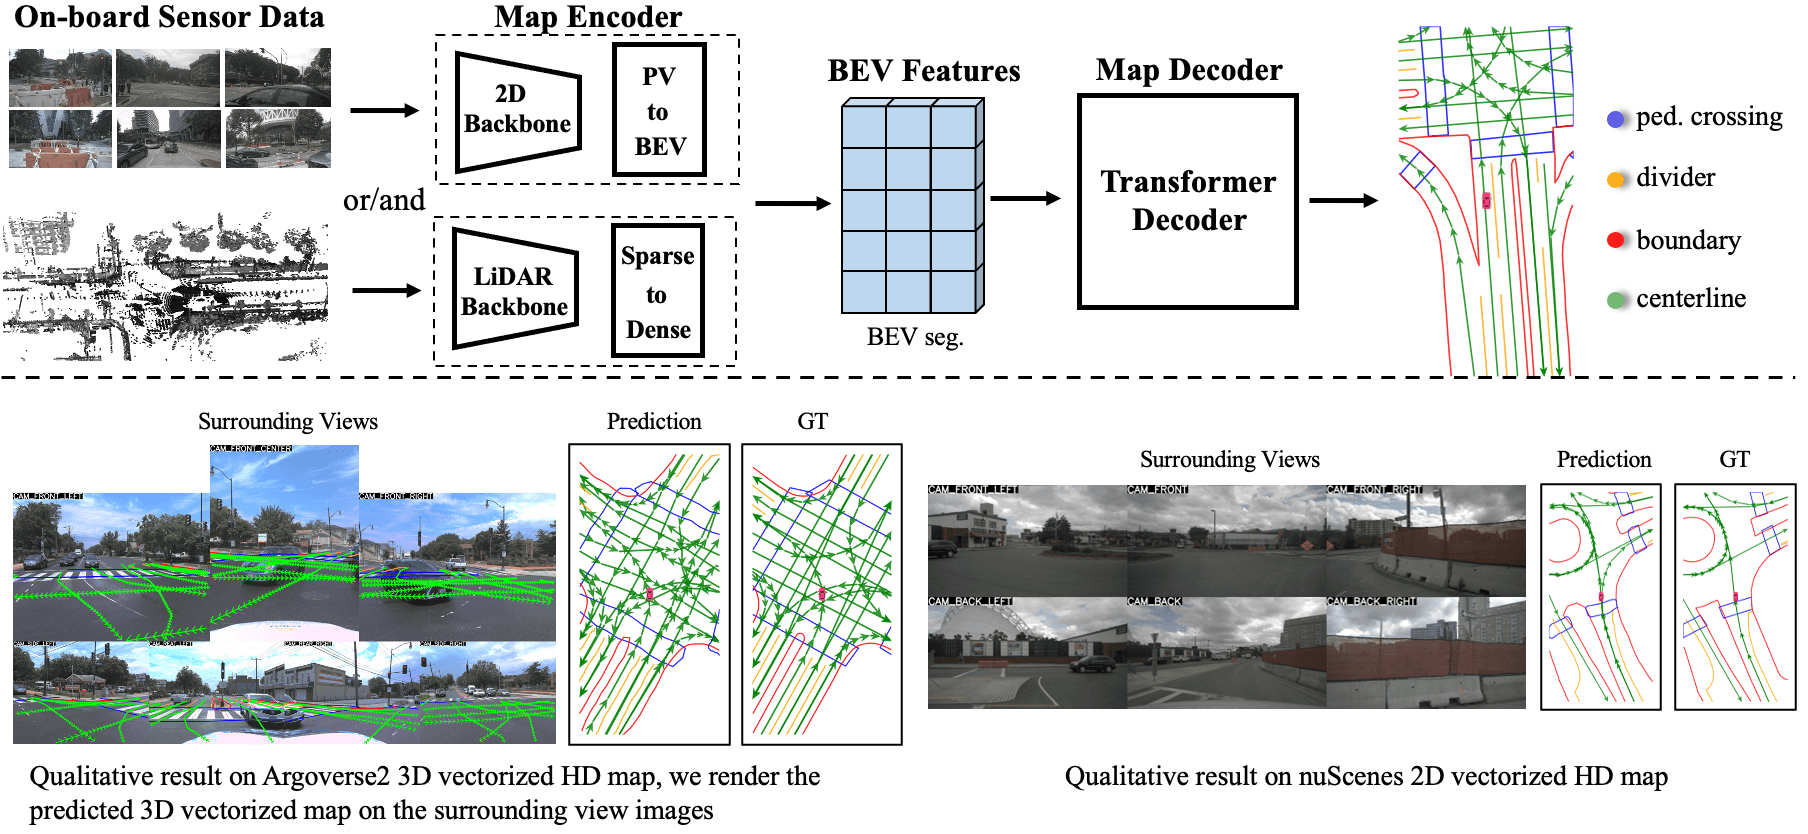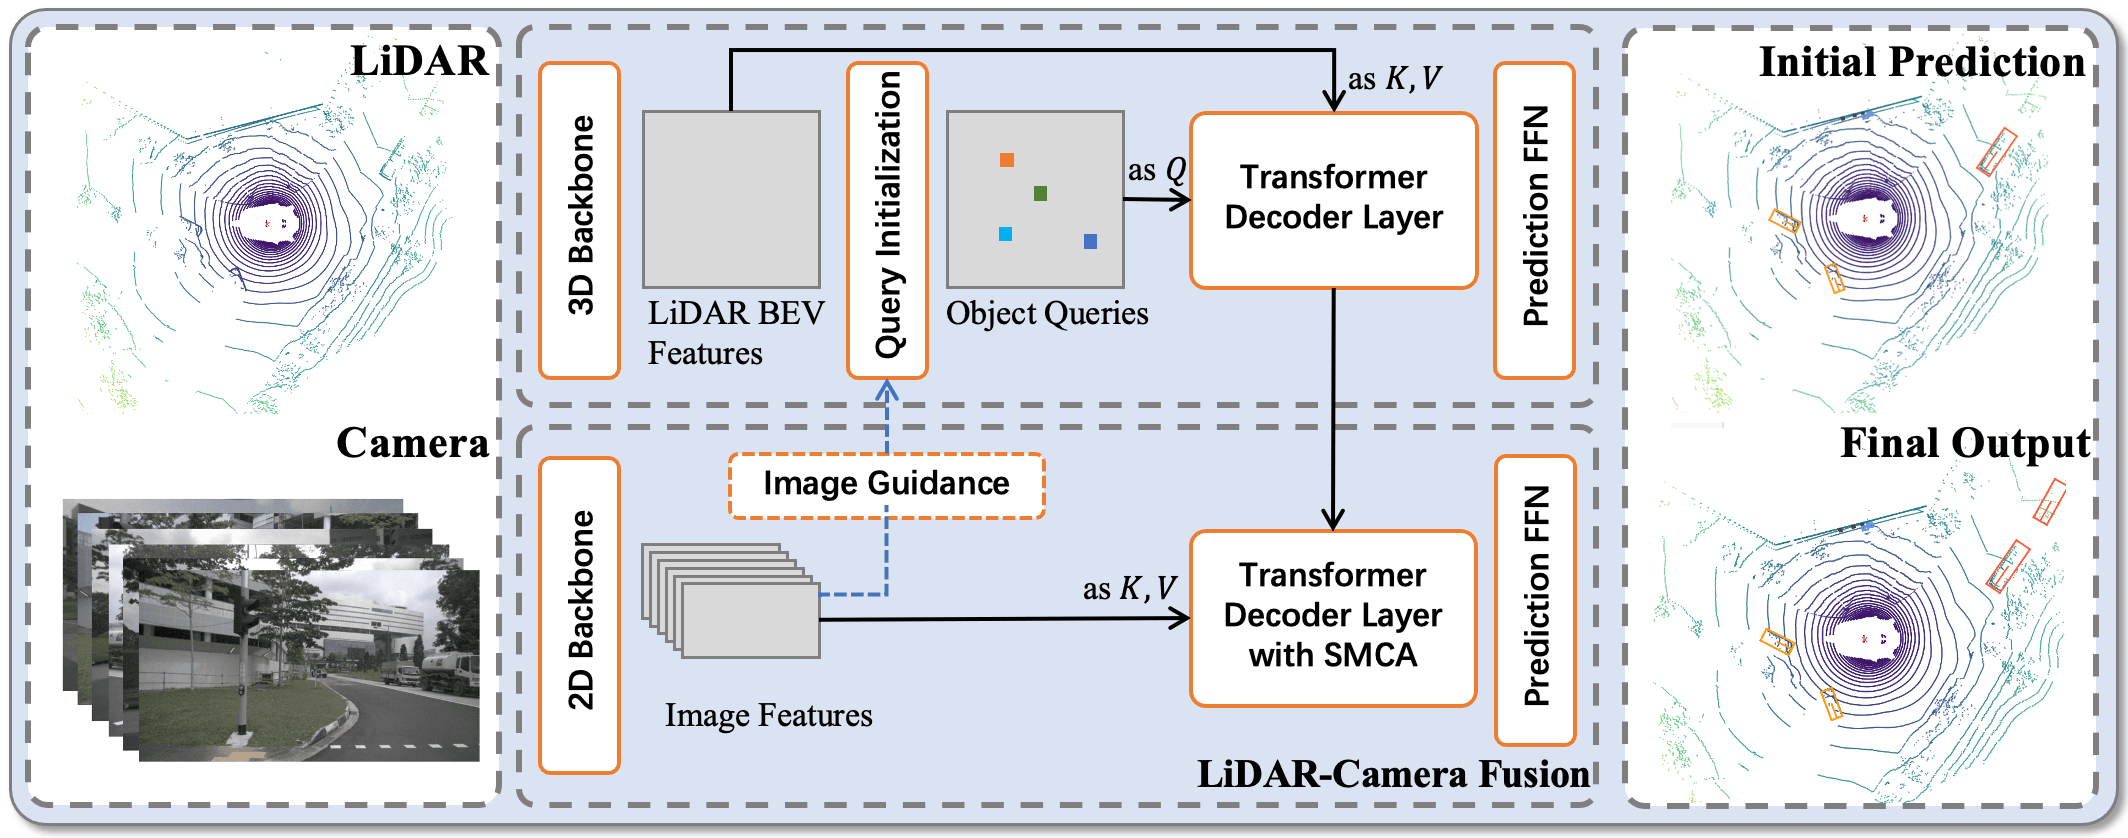
Ở bài trước trong series này, chúng ta đã đi qua kiến trúc fusion: early fusion ghép dữ liệu thô, late fusion hợp nhất kết quả, và BEV fusion chiếu mọi cảm biến vào một mặt phẳng chim nhìn. Pipeline đó cho ra fused feature tensor — giàu thông tin, đa phương thức, tọa độ nhất quán. Nhưng xe không lái bằng tensor: xe cần biết ở đó có gì, chúng đang di chuyển về đâu, và liệu khoảng không gian phía trước có an toàn không.
Bài 3 đi tiếp vào đúng chỗ đó — perception layer: chuyển fused data thành hiểu biết có thể lập lịch được. Chúng ta sẽ đi qua ba task liên tiếp, mỗi task xây lên từ output của task trước:
- 3D Object Detection — ai đang ở đó? (CenterPoint, DETR3D)
- Occupancy Prediction — không gian nào bị chiếm? (Occ3D, SurroundOcc)
- Multi-Object Tracking — chúng đang đi về đâu? (ByteTrack, OC-SORT)
Roadmap series
- Bài 1 — SAE Level 2 vs 2+ vs 3 vs 4: xác định ai chịu trách nhiệm lái, ODD và fallback.
- Bài 2 — Sensor fusion: camera, radar và LiDAR dựng perception suy giảm an toàn khi cảm biến lỗi.
- Bài 3 — Perception: 3D detection, occupancy grid và tracking trên nuScenes.
- Bài 4 — Localization và HD map: GNSS/IMU fusion, NDT trên LiDAR, hướng map-free.
- Bài 5 — Planning & control: từ rule-based tới MPC và PDM, bám quỹ đạo thực tế.
- Bài 6 — Validation: ISO 26262, SOTIF và Euro NCAP — chứng minh an toàn khi không lái đủ km.
Phần 1 — 3D Object Detection: CenterPoint và DETR3D
Tại sao 3D, không phải 2D?
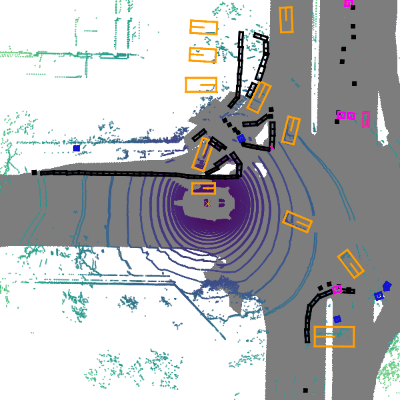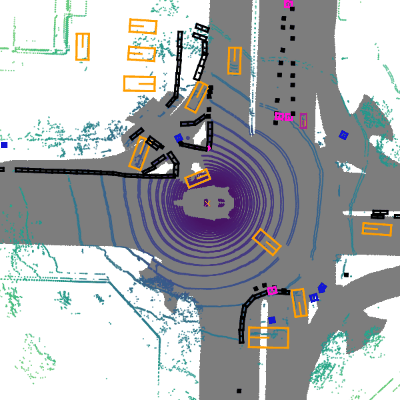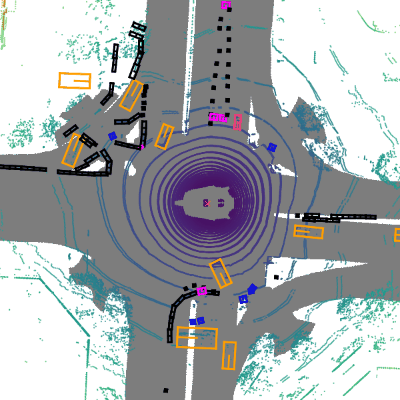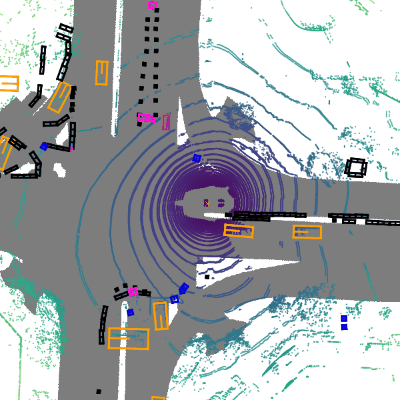
Camera 2D detection (YOLO, Faster-RCNN) cho ra pixel bounding box — đủ để nhận diện nhưng không đủ để điều khiển. Xe cần biết: vật thể cách bao nhiêu mét, cao bao nhiêu, rộng bao nhiêu, đang quay góc nào, và chạy nhanh cỡ nào theo hai chiều. 3D object detection trả về box 7-DOF (x, y, z, l, w, h, yaw) cộng với velocity (vx, vy) — đủ cho bộ lập lịch tính toán "khi nào thì giao nhau với đối tượng đó".
CenterPoint — phát hiện tâm, không phải góc
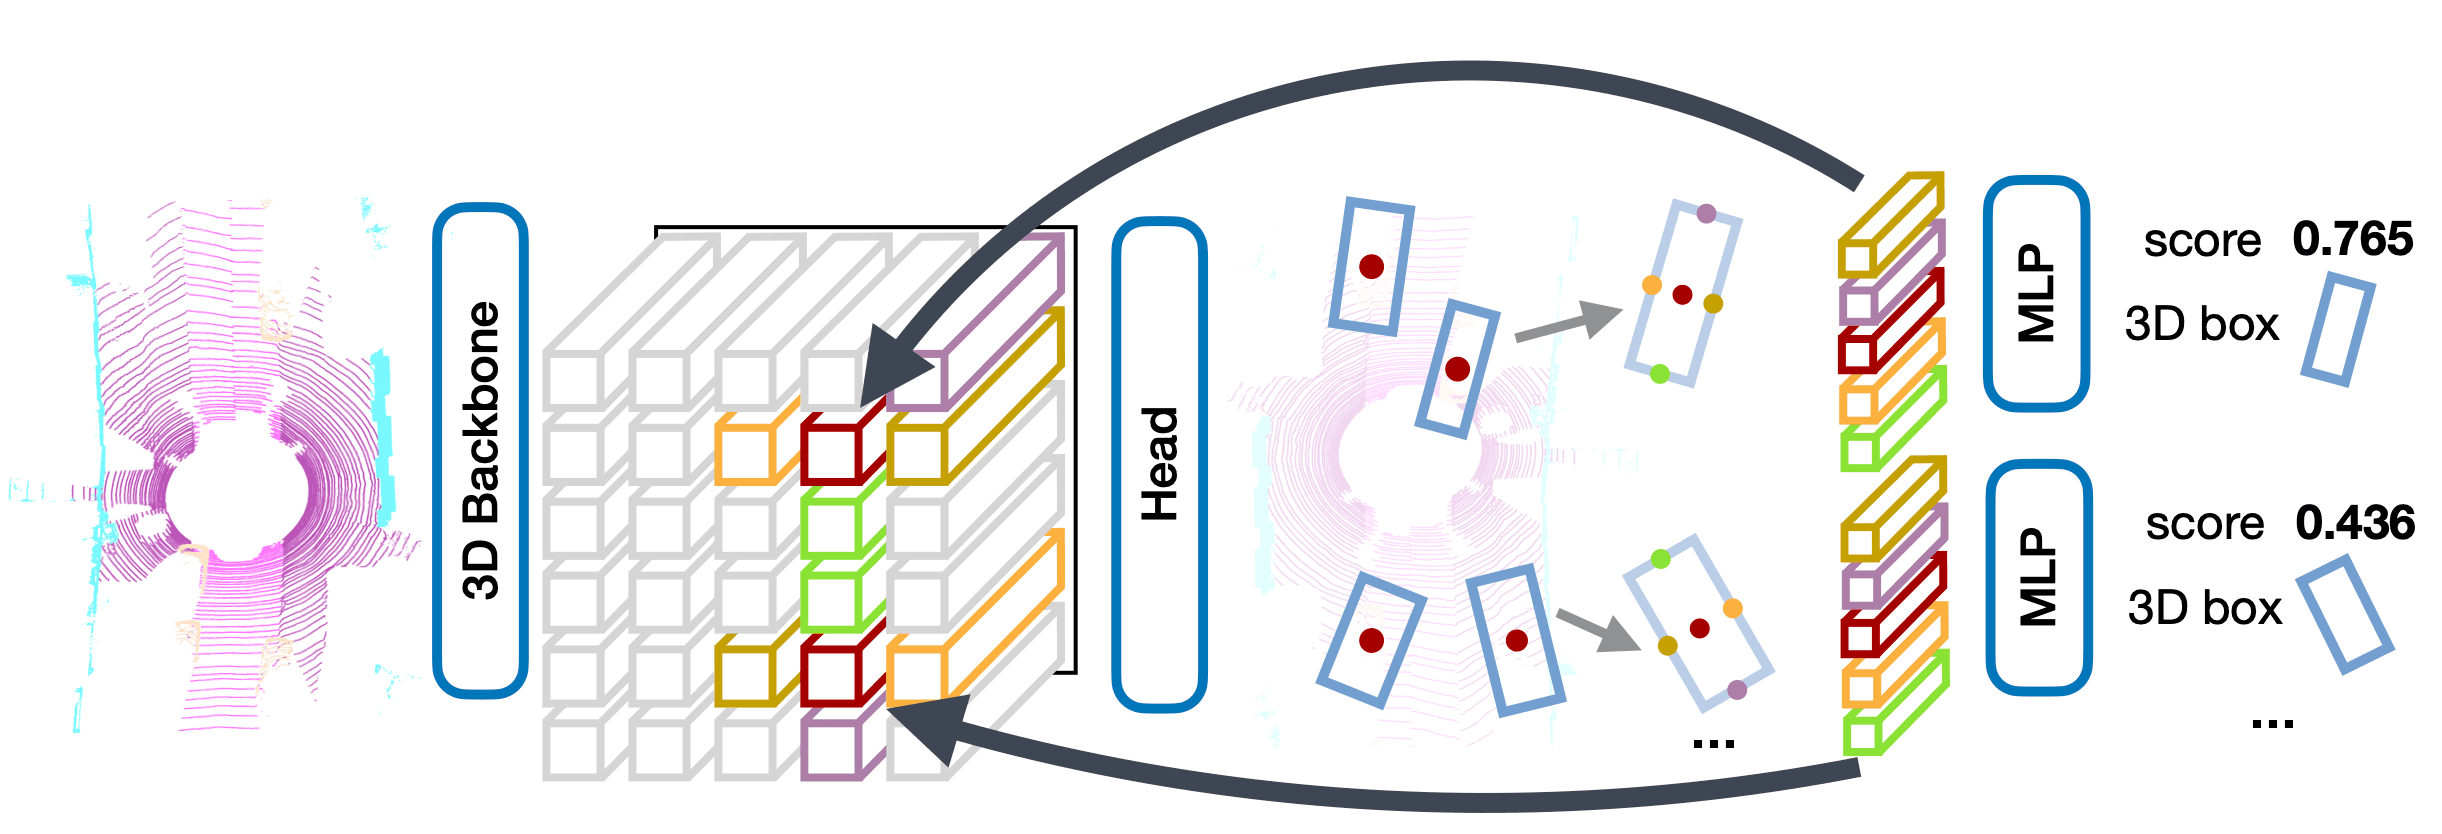
CenterPoint (CVPR 2021, Tianwei Yin et al.) đặt ra một câu hỏi thú vị: thay vì dự đoán bốn góc của bounding box — thứ rất nhạy với rotation — tại sao không chỉ phát hiện tâm của vật thể rồi hồi quy các thuộc tính từ đó?
Pipeline gồm 2 stage:
Stage 1 — Heatmap detection:
LiDAR point cloud được voxel hóa, chạy qua backbone (VoxelNet hoặc PointPillars), rồi một pillar/voxel feature network, cuối cùng qua Bird's Eye View (BEV) feature map. Một keypoint head dự đoán Gaussian heatmap — đỉnh heatmap chính là tọa độ tâm đối tượng trong BEV. Bên cạnh heatmap, model đồng thời hồi quy: (Δx, Δy) sub-voxel offset, z, (l, w, h), sin(yaw), cos(yaw), và (vx, vy).
Stage 2 — Point-feature refinement: Từ vị trí tâm dự đoán, stage 2 lấy thêm điểm feature từ point cloud xung quanh để tinh chỉnh các thuộc tính. Đây là cái giúp CenterPoint vượt trội ở vật thể nhỏ và tốc độ cao.
Kết quả nuScenes validation set (MMDetection3D):
| Variant | mAP | NDS | Memory | Note |
|---|---|---|---|---|
| Pillar (0.2) baseline | 48.70 | 59.62 | 4.6 GB | Nhanh nhất |
| Voxel (0.1) baseline | 56.11 | 64.61 | 5.2 GB | Cân bằng |
| Voxel (0.075) baseline | 56.54 | 65.17 | 8.2 GB | Tốt hơn |
| Voxel (0.075) + DCN + TTA | 60.43 | 67.65 | — | Tốt nhất |
Trên test set: mAP 58.0, NDS 65.5, tốc độ 11 FPS. Tracking: AMOTA 63.8 — số một leaderboard nuScenes lúc công bố (2021).
DETR3D — camera-only, không cần LiDAR
Trong khi CenterPoint phụ thuộc LiDAR, DETR3D (CoRL 2022) chứng minh rằng sáu camera surround-view có thể cho 3D detection decent — quan trọng cho xe giá rẻ không trang bị LiDAR.
DETR3D kế thừa DETR (Detection Transformer) nhưng thêm một cơ chế đặc biệt: mỗi object query (N learnable vector) chứa một tham chiếu 3D reference point. Head chiếu điểm 3D đó vào mặt phẳng ảnh của mỗi camera, lấy feature bằng bilinear sampling, rồi đưa vào transformer decoder cross-attention. Không có explicit 3D representation — 3D knowledge hoàn toàn đến từ camera geometry.
Kết quả nuScenes validation set:
| Method | Input | mAP | NDS |
|---|---|---|---|
| DETR3D | Camera × 6 | 0.346 | 0.425 |
| PETR | Camera × 6 | ~0.354 | ~0.433 |
| CenterPoint | LiDAR | 0.561 | 0.646 |
| BEVFusion (cam+LiDAR) | Multimodal | ~0.68 | ~0.72 |
Khoảng cách camera-only vs LiDAR còn lớn (~20 NDS points), nhưng DETR3D là nền tảng cho toàn bộ dòng model transformer-based sau này (BEVFormer, PETR, Sparse4D...).
Code: CenterPoint inference với MMDetection3D
# Cài đặt: pip install mmdet3d mmengine
# Download checkpoint từ: https://github.com/open-mmlab/mmdetection3d/tree/main/configs/centerpoint

from mmdet3d.apis import init_model, inference_detector

CONFIG = 'configs/centerpoint/centerpoint_voxel01_second_secfpn_8xb4-cyclic-20e_nus-3d.py'
CHECKPOINT = 'checkpoints/centerpoint_voxel01_second_secfpn_8xb4-cyclic-20e_nus-3d-cbgs_20220810_030004-9dfb4232.pth'

# Khởi tạo model (GPU)
model = init_model(CONFIG, CHECKPOINT, device='cuda:0')

# File LiDAR nuScenes (.pcd.bin = float32 x,y,z,intensity + time)
PCD_FILE = 'demo/data/nuscenes/n015-2018-07-24-11-22-45+0800__LIDAR_TOP__1532402927647951.pcd.bin'

result, _ = inference_detector(model, PCD_FILE)

# Lấy kết quả
bboxes = result.pred_instances_3d.bboxes_3d   # tensor (N, 9): x,y,z,l,w,h,yaw,vx,vy
scores = result.pred_instances_3d.scores_3d   # tensor (N,)
labels = result.pred_instances_3d.labels_3d   # tensor (N,) — index vào class_names

CLASS_NAMES = [
    'car', 'truck', 'construction_vehicle', 'bus', 'trailer',
    'barrier', 'motorcycle', 'bicycle', 'pedestrian', 'traffic_cone'
]

SCORE_THRESH = 0.3
print(f"Phát hiện {(scores > SCORE_THRESH).sum().item()} objects (threshold={SCORE_THRESH}):\n")

for box, score, label in zip(bboxes, scores, labels):
    if score < SCORE_THRESH:
        continue
    x, y, z, l, w, h, yaw, vx, vy = box.tolist()
    print(
        f"  {CLASS_NAMES[label]:25s} | score={score:.3f} | "
        f"pos=({x:+.1f}, {y:+.1f}, {z:+.1f}) m | "
        f"size=({l:.1f}×{w:.1f}×{h:.1f}) | "
        f"yaw={yaw:.2f} rad | "
        f"vel=({vx:+.1f}, {vy:+.1f}) m/s"
    )
Output mẫu (nuScenes sample):
Phát hiện 18 objects (threshold=0.3):

  car                       | score=0.871 | pos=(+8.4, +2.1, -0.8) m | size=(4.5×2.0×1.6) | yaw=0.02 rad | vel=(+0.1, +0.0) m/s
  pedestrian                | score=0.743 | pos=(-3.2, +8.5, -0.3) m | size=(0.7×0.7×1.8) | yaw=-1.57 rad | vel=(-0.5, +1.2) m/s
  bicycle                   | score=0.412 | pos=(+15.3, -1.4, -0.5) m | size=(1.8×0.6×1.3) | yaw=0.05 rad | vel=(+2.1, +0.0) m/s
  ...
Từ một frame LiDAR duy nhất, chúng ta đã có đủ thông tin 3D cho từng đối tượng — chính xác đến cỡ cm, kèm velocity cho planning.
Phần 2 — Occupancy Prediction: Occ3D và SurroundOcc
Tại sao bounding box chưa đủ?
Hãy tưởng tượng một đống đổ nát công trình nằm giữa đường. Bounding box detector sẽ làm gì? Nếu "debris" không có trong class list của model — model bỏ qua. Nếu có, box sẽ bao quanh một hình dạng bất quy tắc bằng một hình hộp chữ nhật — không nắm bắt được hình học thực sự.
Đây là long-tail problem của bounding box detection:
- Dataset training chỉ label các class định nghĩa trước (car, truck, pedestrian...)
- Vật thể lạ (xe đổ, tường công trường, vật rơi) không được label
- Model không học được gì về chúng → blind spot nguy hiểm
Occupancy prediction giải quyết vấn đề này bằng cách đặt câu hỏi khác hoàn toàn: thay vì "có vật thể nào ở đây không?", hỏi "voxel này có bị chiếm không?" — và nếu có, nó là loại gì.
Occ3D — benchmark chuẩn (NeurIPS 2023)
Occ3D đề xuất một large-scale benchmark từ nuScenes, chia không gian xung quanh xe thành lưới voxel 3D:
- Vùng dự đoán: X ∈ [-40m, 40m], Y ∈ [-40m, 40m], Z ∈ [-1m, 5.4m]
- Độ phân giải voxel: 0.4m × 0.4m × 0.4m
- Grid size: 200 × 200 × 16 = 640,000 voxels mỗi frame
- Classes: 17 semantic classes + 1 empty
- Metric chính: mIoU (mean Intersection over Union) trên 18 classes
Mỗi voxel mang một label — từ car (class 1) đến terrain (class 11) đến empty (class 0). Nếu voxel chứa điểm LiDAR của một ô tô, nó là car. Nếu chứa bê tông vỉa hè, nó là sidewalk. Nếu không có gì, nó là empty.
Lợi ích: xe lạ không định nghĩa được cũng được label là other_flat_surface hoặc other_object — không bỏ qua.
SurroundOcc — camera-only occupancy (ICCV 2023)
SurroundOcc (Wei et al., ICCV 2023) giải quyết bài toán tương tự nhưng chỉ dùng camera, không cần LiDAR annotation trực tiếp.
Architecture:
- Multi-scale image encoding: Mỗi ảnh từ 6 camera đi qua backbone (ResNet-101), tạo multi-scale features.
- Spatial cross-attention (BEV lift): Learnable 3D queries tương ứng với mỗi voxel trong grid "hỏi" thông tin từ feature ảnh có liên quan (giống BEVFormer nhưng 3D thay vì 2D).
- Temporal aggregation: Ghép features từ frame hiện tại và frames trước để cải thiện depth estimation.
- Occupancy head: 3D CNN decoder tạo ra dense voxel predictions.
So sánh vùng dự đoán:
| Benchmark | X/Y range | Z range | Voxel size | Grid | Classes |
|---|---|---|---|---|---|
| Occ3D-nuScenes | ±40m | -1m → 5.4m | 0.4m³ | 200×200×16 | 17+1 |
| SurroundOcc | ±50m | -5m → 3m | 0.5m³ | 200×200×16 | 16+1 |
SurroundOcc mở rộng vùng dự đoán (±50m thay vì ±40m) và đi sâu hơn theo trục Z (bắt đầu từ -5m — hữu ích cho underpass, dốc ngầm).

Occupancy vs Detection: khi nào dùng cái nào?
| Tiêu chí | Bounding Box | Occupancy |
|---|---|---|
| Chi phí compute | Thấp | Cao (640k voxels/frame) |
| Xử lý long-tail | Kém | Tốt |
| Hình học chính xác | Trung bình | Cao |
| Dễ tích hợp với planning | Dễ | Phức tạp hơn |
| Annotate cost | Thấp (label boxes) | Cao (cần LiDAR dense scan) |
Thực tế trong hệ thống sản xuất: Tesla FSD dùng occupancy network thay thế hoàn toàn bounding boxes từ FSD v11 (2023). Waymo dùng cả hai — bounding box cho tracking, occupancy cho free-space estimation.
Phần 3 — Multi-Object Tracking: ByteTrack và OC-SORT
Nếu detection cho biết "ở frame T có một chiếc xe ở vị trí (8.4m, 2.1m)", tracking phải trả lời: "Chiếc xe này là xe nào? Và ở frame T+1, nó ở đâu?" — tức là duy trì identity qua thời gian.
Metrics quan trọng trên nuScenes
nuScenes Tracking Benchmark dùng 5 metrics chính:
| Metric | Ý nghĩa | Tốt khi | |
|---|---|---|---|
| AMOTA | Average Multi-Object Tracking Accuracy | Cao → tracking ổn định | Primary metric |
| AMOTP | Average Multi-Object Tracking Precision | Thấp → ít sai lệch vị trí | Secondary |
| MOTA | Multi-Object Tracking Accuracy tại recall ngưỡng nhất định | Cao | Reference |
| IDS | ID Switches — số lần đổi identity | Thấp | Quan trọng |
| FRAG | Fragmentation — số track bị phân mảnh | Thấp | Reference |
AMOTA là metric quan trọng nhất: nó trung bình MOTA trên nhiều recall thresholds (0.1 đến 1.0, bước 0.1) — nên không thiên vị model detect ít nhưng chính xác hay model detect nhiều nhưng có noise.
ByteTrack — không bỏ phí detection nào
ByteTrack (ECCV 2022) xuất phát từ quan sát đơn giản: hầu hết tracker chỉ associate high-confidence detections (score > 0.5) với tracks, rồi bỏ qua low-confidence ones. Nhưng low-confidence detections thường chứa real objects đang bị che khuất, xa, hoặc ở góc khó.
Two-stage association:
- Stage 1: Giải bài toán Hungarian assignment giữa tất cả tracks hiện tại và high-conf detections (score > τ_high ≈ 0.5) dùng IoU distance trong BEV.
- Stage 2: Các tracks chưa được match ở stage 1 (unconfirmed) được đem ra associate với low-conf detections (τ_low < score < τ_high). Nếu IoU đủ cao → track được giữ; nếu không → track tạm thời "lost".
Kết quả: ByteTrackV2 đạt 54.2 AMOTA và 696 IDS trên nuScenes validation (camera-based), vượt trội phương pháp thứ hai 3.1 AMOTA.
OC-SORT — khắc phục drift trong occlusion
OC-SORT (Observation-Centric SORT, CVPR 2023) tập trung vào vấn đề của Kalman Filter chuẩn: khi vật bị che khuất vài frame, Kalman update theo trạng thái dự đoán (không có observation thực) — dẫn đến drift (ước lượng sai lệch tích lũy). Khi vật xuất hiện lại, track đã ở sai vị trí → ID switch.
OC-SORT giải quyết bằng hai kỹ thuật:
- Observation-Centric Re-Update: Khi track re-emerge sau occlusion, thay vì chỉ update Kalman với detection hiện tại, OC-SORT tính lại trajectory dựa trên observation trực tiếp trước và sau occlusion — loại bỏ ảnh hưởng của "phantom updates".
- Observation-Centric Momentum: Velocity term trong Kalman được tính từ hai observation thực gần nhất, không phải từ chuỗi states — giảm accumulation error.
Khi nào dùng cái nào?
| Kịch bản | Khuyến nghị |
|---|---|
| Straight highway, ít occlusion | ByteTrack (đơn giản, nhanh) |
| Urban driving, nhiều vật che khuất | OC-SORT (ít ID switch hơn) |
| Camera panning mạnh, motion phi tuyến | OC-SORT (velocity model ổn định hơn) |
| Real-time requirement | ByteTrack (ít compute hơn) |
Kết quả so sánh trên nuScenes tracking benchmark:
| Method | Detector | AMOTA ↑ | AMOTP ↓ | IDS ↓ |
|---|---|---|---|---|
| CenterPoint (LiDAR) | CenterPoint | 63.8 | 0.555 | — |
| ByteTrackV2 (camera) | — | 54.2 | — | 696 |
| S2-Track (best 2024) | — | 66.3 | — | — |
CenterPoint built-in tracker vẫn rất cạnh tranh nhờ LiDAR data chất lượng cao. Camera-based tracker (ByteTrackV2) còn tụt hơn ~10 AMOTA — khoảng cách đến từ depth estimation uncertainty.
Pipeline hoàn chỉnh: Detection → Tracking → Prediction
Bức tranh perception layer đầy đủ cho một ADAS system:
LiDAR + Camera + Radar
         │
    [Sensor Fusion]  ← (BEVFusion, bài 2)
         │
    [3D Detection]   ← CenterPoint / DETR3D
         │           → boxes: (x,y,z,l,w,h,yaw,vx,vy,class,score)
    [MOT Tracker]    ← ByteTrack / OC-SORT
         │           → tracks: {id, state_history, velocity_estimate}
    [Prediction]     ← Social-LSTM, Trajectron++
         │           → future trajectories (T+1s đến T+5s)
    [Planning]       ← (bài 5)
Tracking là cầu nối giữa perception (biết đang ở đâu bây giờ) và prediction (biết sẽ ở đâu sau này). Một ID switch không chỉ là số đẹp kém — nó có nghĩa là prediction module mất lịch sử chuyển động của đối tượng đó và phải bắt đầu lại từ đầu, có thể gây phanh đột ngột hoặc hành vi không ổn định.
Kết luận
Ba layer perception trong bài này xây lên từng bước:
- 3D Detection (CenterPoint/DETR3D) cho biết ai đang ở đây và hình dạng của họ là gì.
- Occupancy Prediction (Occ3D/SurroundOcc) lấp khoảng trống — mọi voxel bị chiếm đều được biết, dù đó là class quen thuộc hay vật thể lạ long-tail.
- Tracking (ByteTrack/OC-SORT) gắn identity theo thời gian để planning biết "xe này đã di chuyển như thế nào trong 2 giây vừa rồi".
Bài tiếp theo (Bài 4: Localization và HD Map) sẽ giải quyết câu hỏi bổ sung quan trọng không kém: xe đang ở đâu trong bản đồ? — chính xác đến cỡ cm, không phải GPS 3m.