SimpleVLA-RL: Khi VLA học được từ chính thất bại của mình
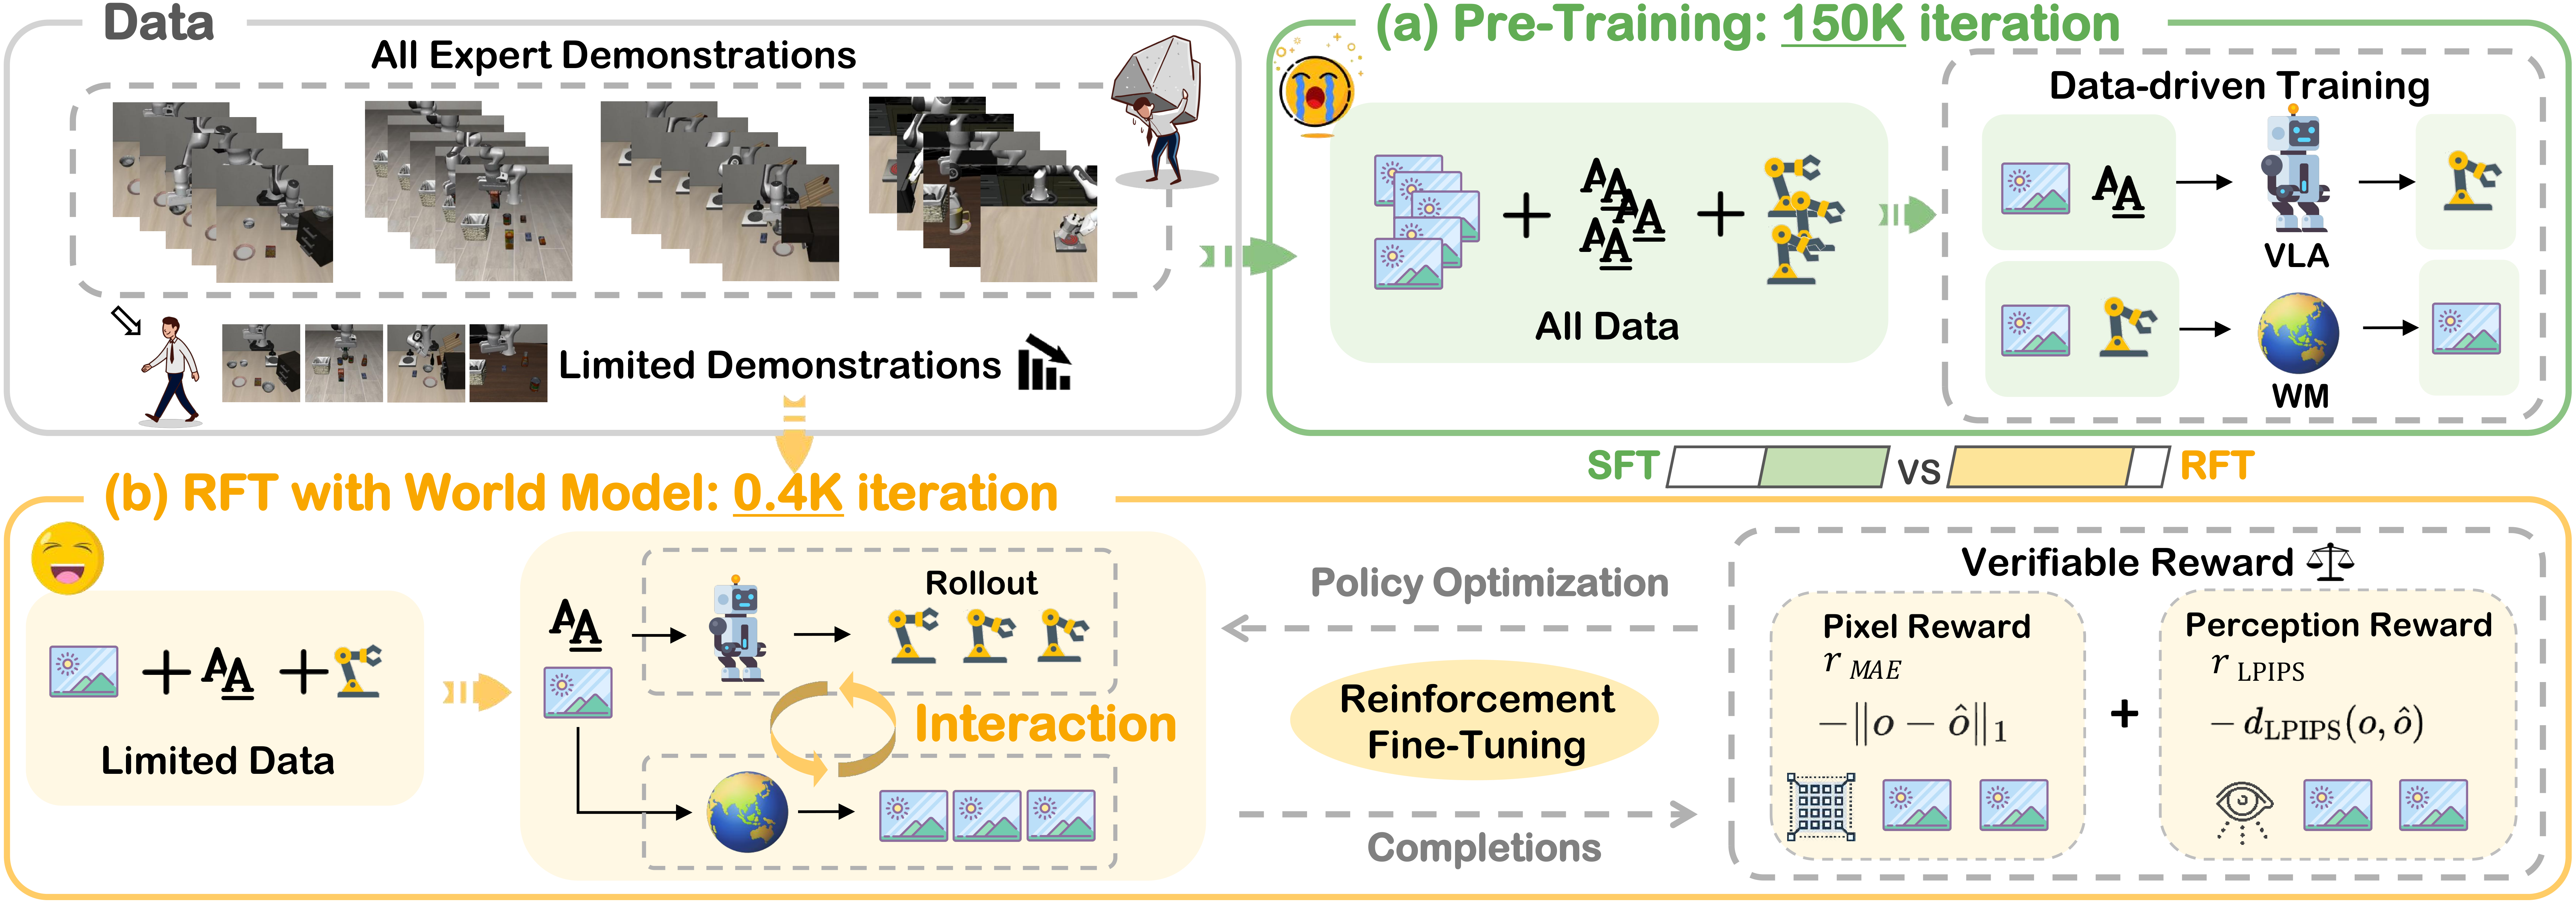
Có một nghịch lý thú vị trong robot manipulation hiện đại: bạn có thể tốn hàng tháng thu thập 10.000 bản demo teleoperation, train một VLA model khổng lồ, nhưng kết quả vẫn bị "đóng băng" ở mức 70-80% thành công. Thêm 10.000 demo nữa? Tỷ lệ tăng thêm chỉ vài phần trăm. Đây là data ceiling — trần dữ liệu mà mọi phương pháp Supervised Fine-Tuning (SFT) đều gặp.
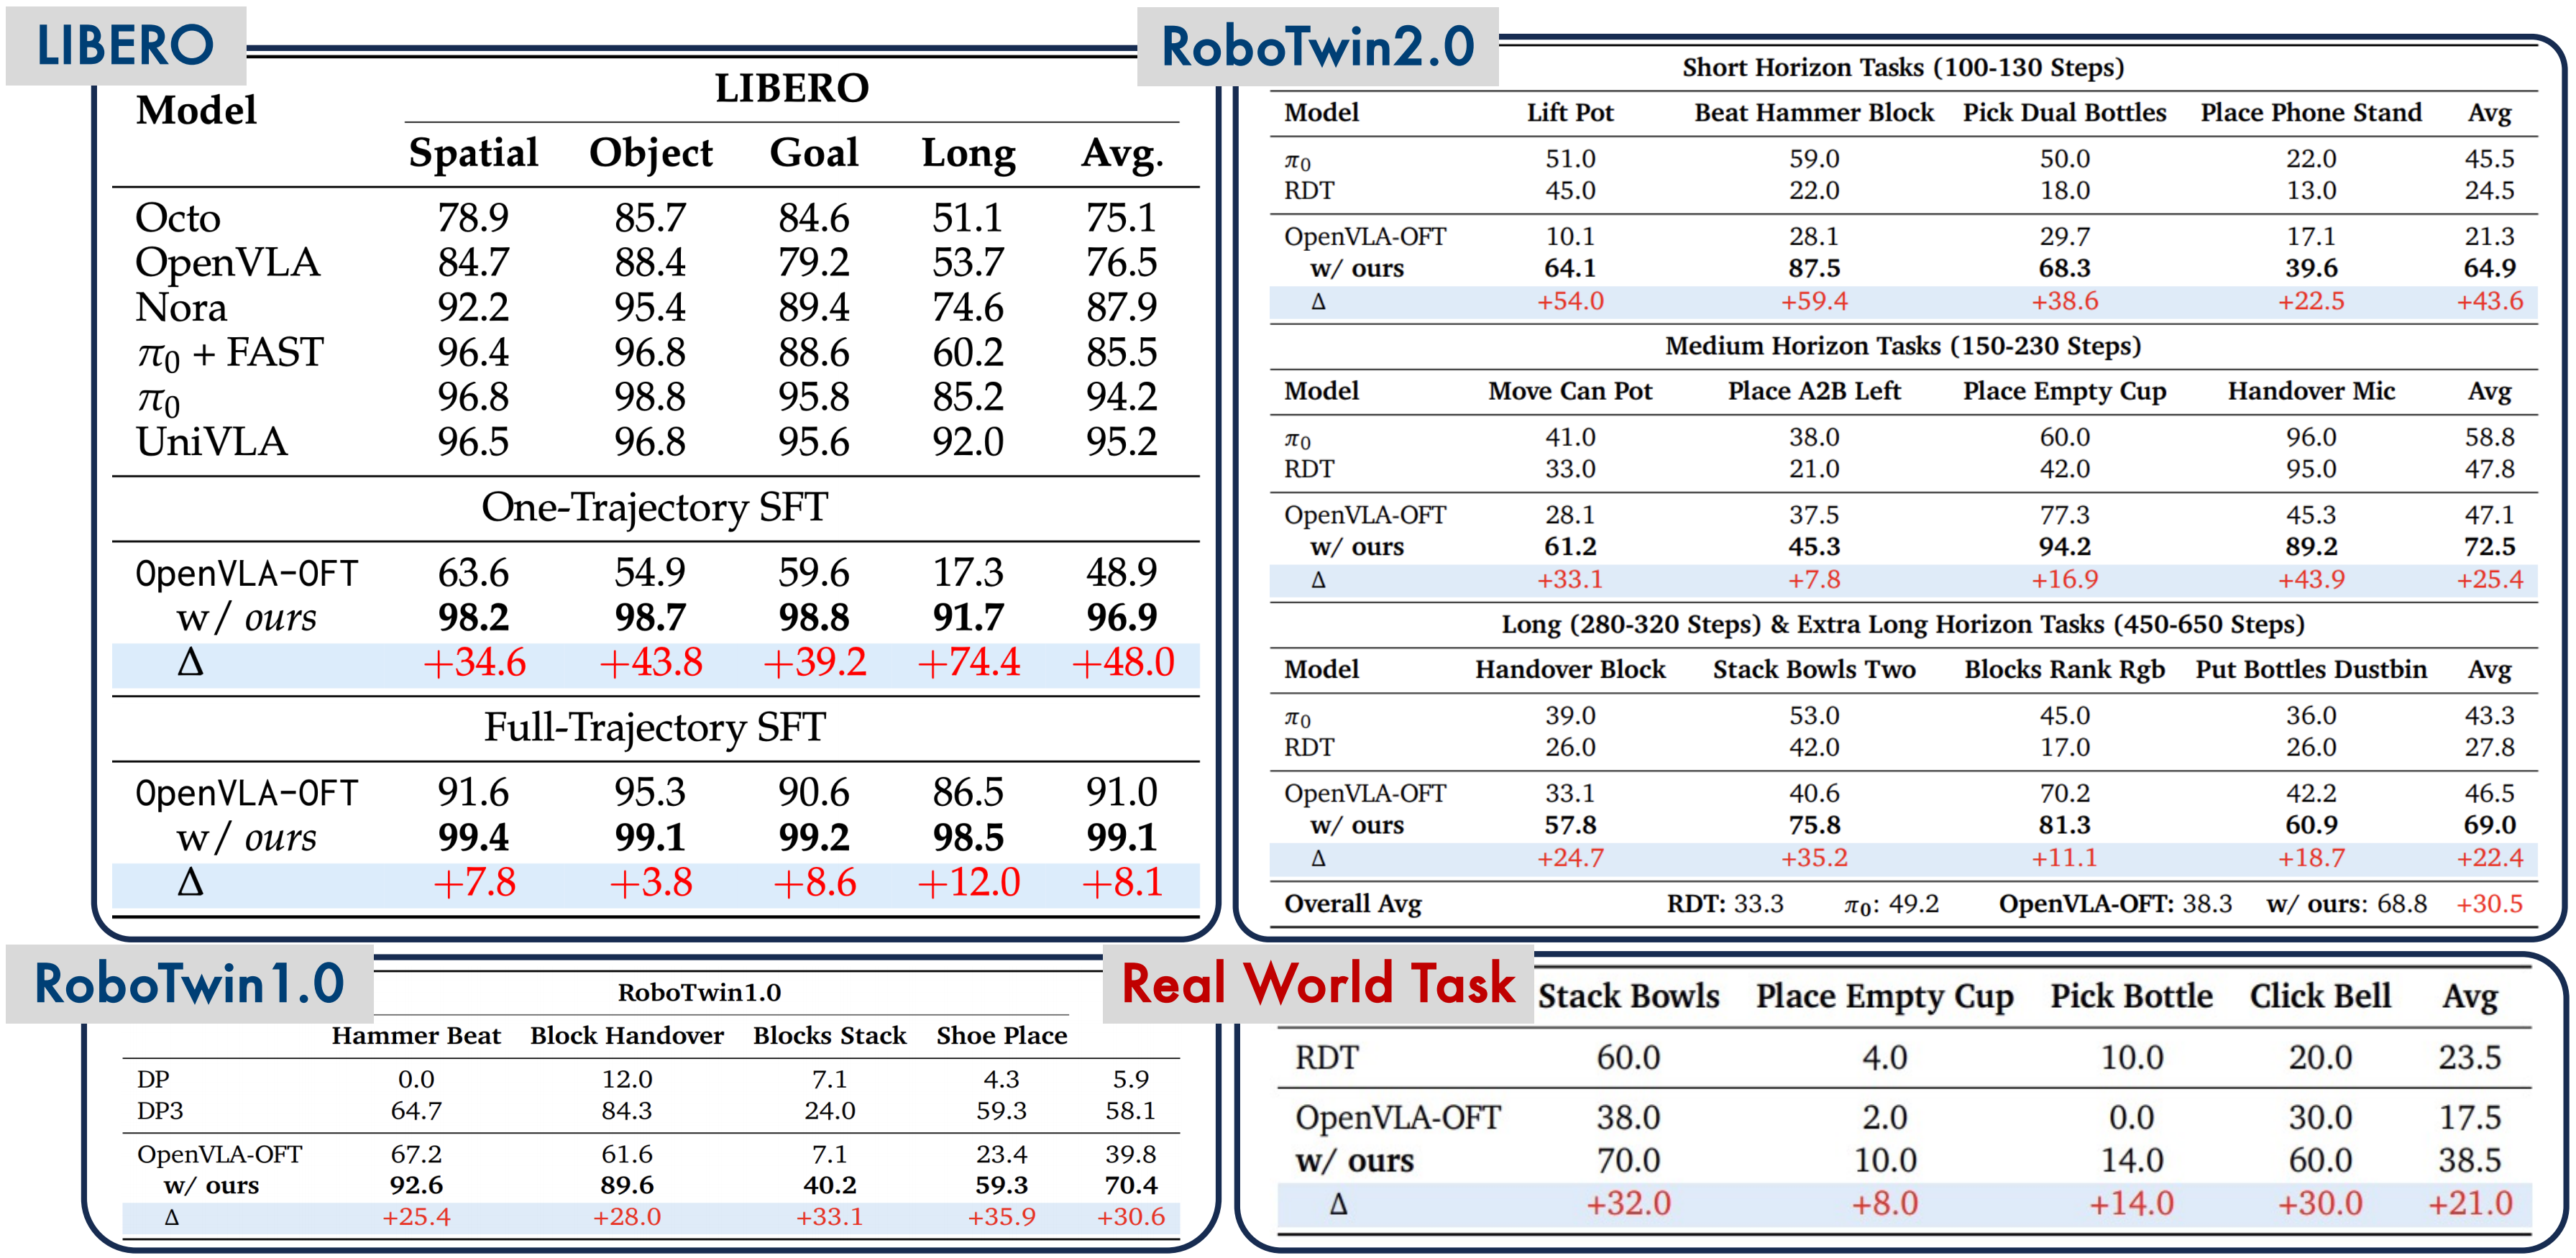
SimpleVLA-RL, được công bố tại ICLR 2026 bởi nhóm PRIME-RL, đề xuất một lối thoát đơn giản đến bất ngờ: để robot tự luyện tập trong simulation với tín hiệu phản hồi nhị phân (thành công = 1, thất bại = 0), không cần reward engineering phức tạp. Kết quả? Từ 91% lên 99.1% trên LIBERO, và cải thiện 430% trong chế độ dữ liệu khan hiếm.
Bài viết này là hướng dẫn thực hành đầy đủ — từ hiểu ý tưởng paper đến chạy được code trên GPU cluster của bạn.
Tại sao SFT không đủ?
Trước khi vào code, cần hiểu vấn đề mà SimpleVLA-RL giải quyết.
Khi bạn train một VLA model như OpenVLA bằng SFT, model học cách bắt chước các bản demo của chuyên gia. Điều này hoạt động tốt khi robot gặp đúng những tình huống đã thấy trong training data. Nhưng:
- Distribution shift: Robot thực tế gặp ánh sáng khác, góc camera khác, vật thể ở vị trí hơi khác → model không khái quát hóa được
- Compounding errors: Mỗi bước nhỏ sai một chút, sau 100 bước sai tích lũy thành thất bại hoàn toàn
- Mode collapse trong SFT: Model chỉ học cách trung bình hóa các bản demo, không học được chiến lược "phục hồi khi đã sai"
Học tăng cường (RL) giải quyết cả ba vấn đề này bằng cách cho robot tự khám phá những chiến lược mà dữ liệu demo không bao giờ thể hiện — bao gồm cách phục hồi từ trạng thái lỗi.
Kiến trúc SimpleVLA-RL
SimpleVLA-RL được xây dựng trên ba thành phần chính:
1. VLA Backbone: OpenVLA-OFT
OpenVLA-OFT là phiên bản fine-tuned của OpenVLA với Optimal Fine-Tuning — tối ưu hóa cho robot manipulation thực tế. Đây là điểm khởi đầu (starting checkpoint) trước khi áp dụng RL.
2. RL Engine: veRL
veRL là framework RL phân tán hiệu năng cao, ban đầu được thiết kế cho LLM training. PRIME-RL đã mở rộng veRL với các thành phần đặc thù cho VLA:
- VLA-specific trajectory sampling: Lấy mẫu trajectory từ nhiều simulation environment song song, không phải text token
- Multi-environment rendering: Render nhiều cảnh simulation đồng thời để tăng throughput dữ liệu RL
- Optimized loss computation: Tính toán policy gradient cho action token sequence của VLA model
3. Thuật toán: GRPO
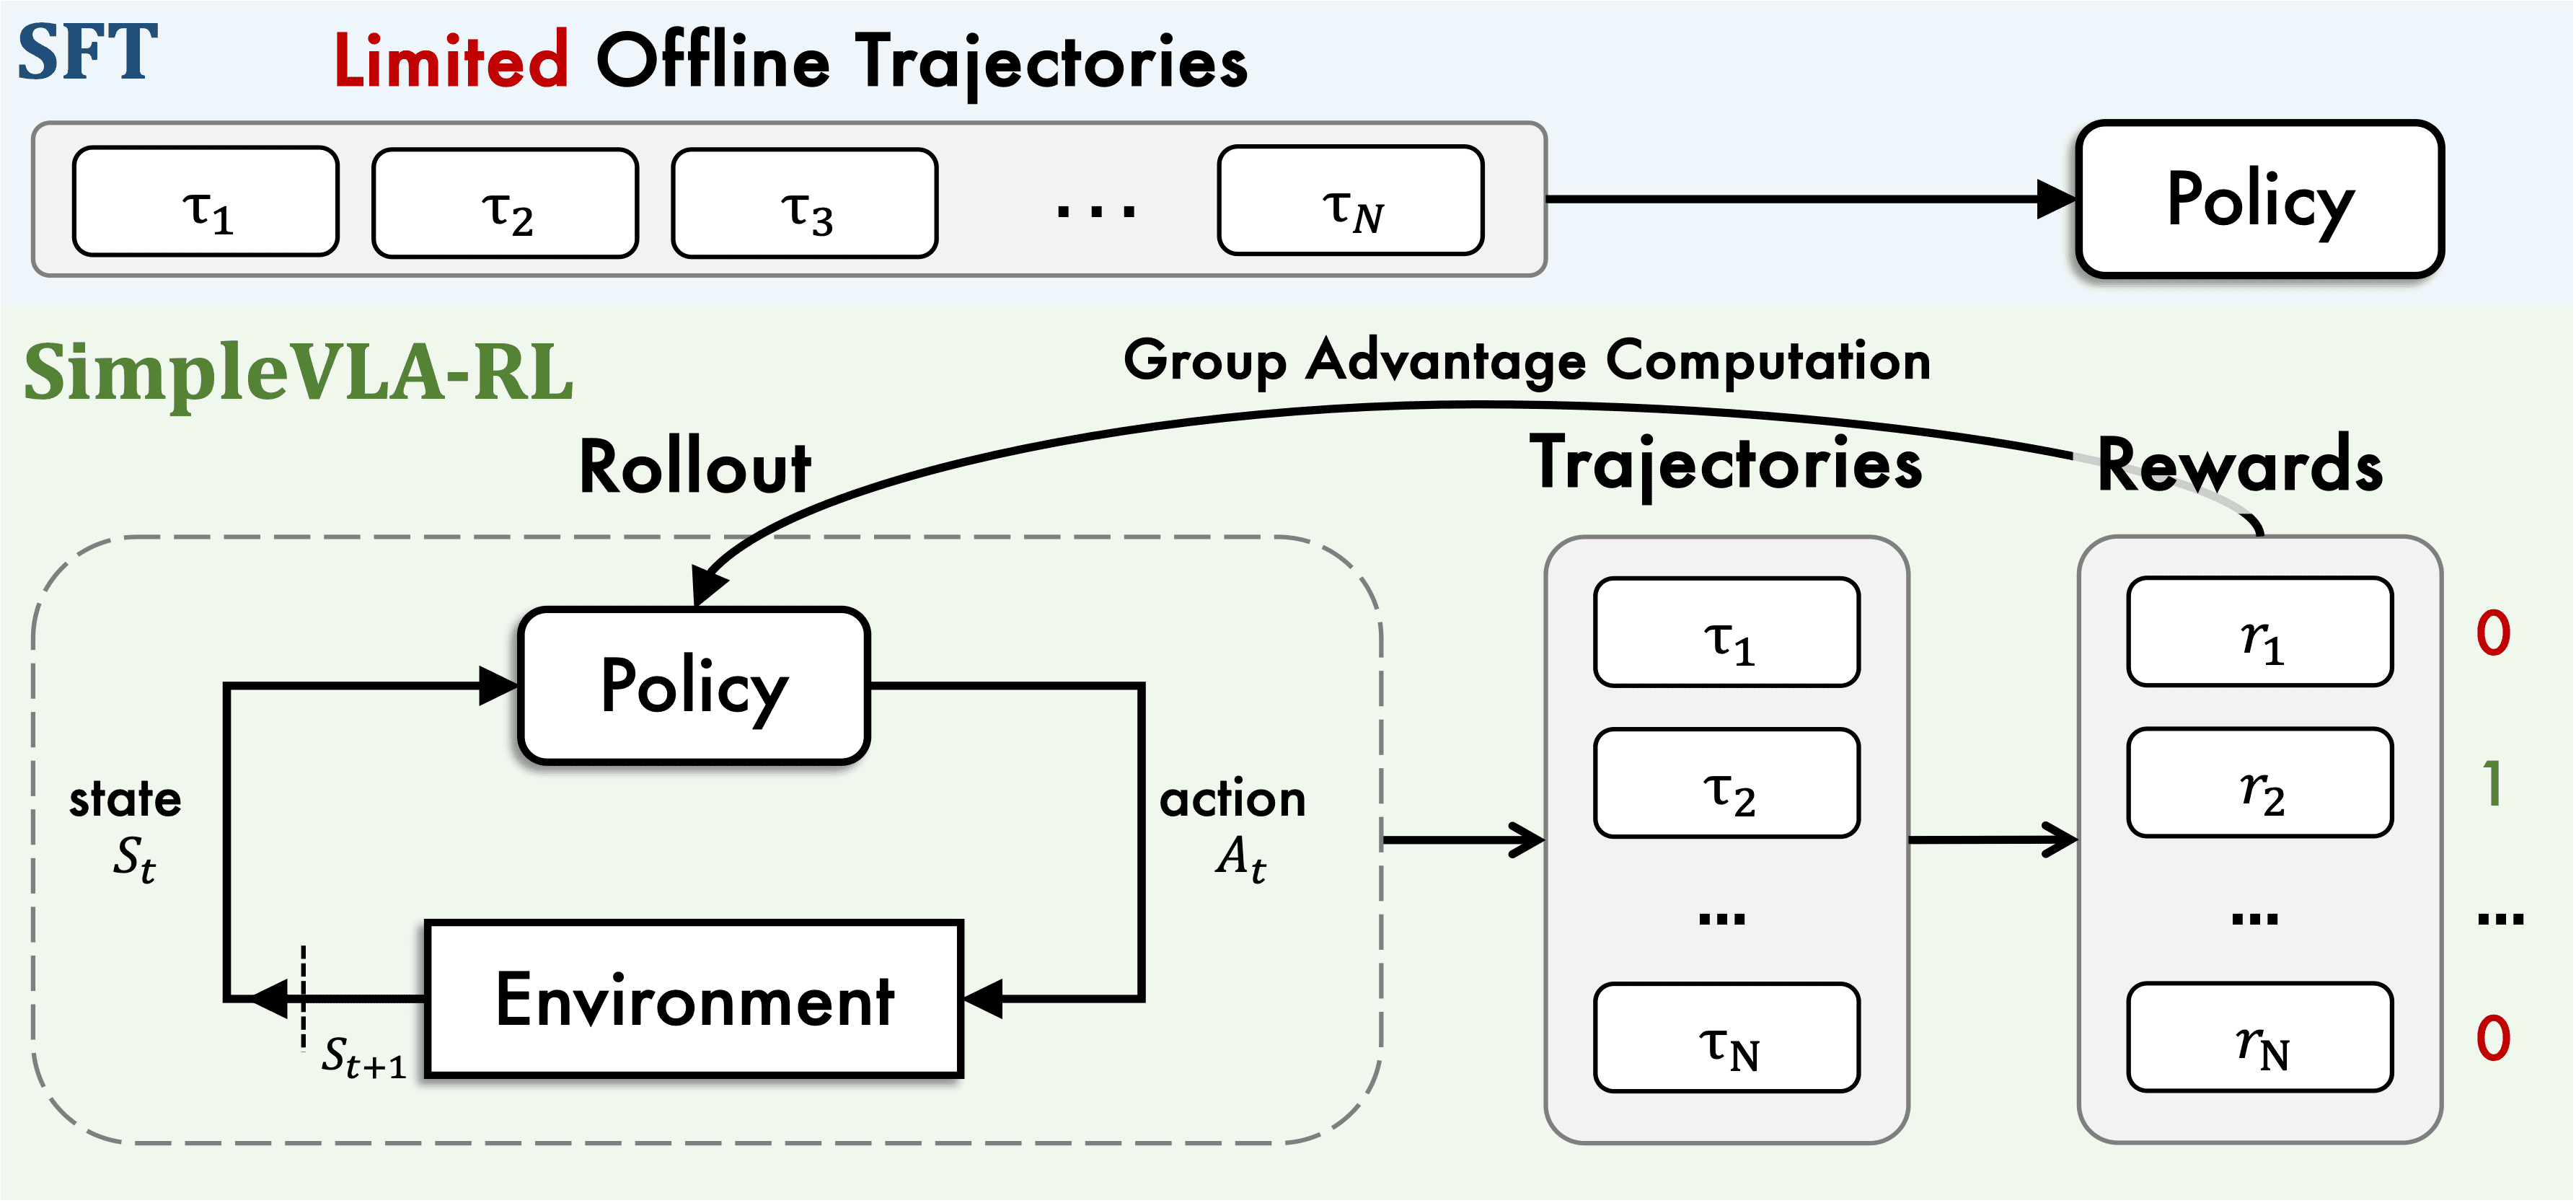
Thay vì PPO phức tạp, SimpleVLA-RL dùng Group Relative Policy Optimization (GRPO) — thuật toán tương tự đã được dùng trong DeepSeek-R1. GRPO so sánh nhiều rollout của cùng một trạng thái và tính reward tương đối giữa chúng:
# Pseudo-code GRPO reward calculation
for state in batch_states:
    rollouts = [policy.sample(state) for _ in range(G)]  # G rollouts
    rewards = [env.check_success(r) for r in rollouts]   # 0 hoặc 1
    baseline = mean(rewards)
    advantages = [r - baseline for r in rewards]          # reward tương đối
    # Update policy để tăng xác suất rollout tốt, giảm rollout xấu
Tại sao GRPO thay vì PPO? PPO cần value function riêng (critic network), tốn thêm memory và compute. GRPO không cần critic — nó dùng chính các rollout song song làm baseline, đơn giản hơn và phù hợp với VLA models có kiến trúc decoder-only.
Hiện tượng "Pushcut": VLA khám phá chiến lược mới
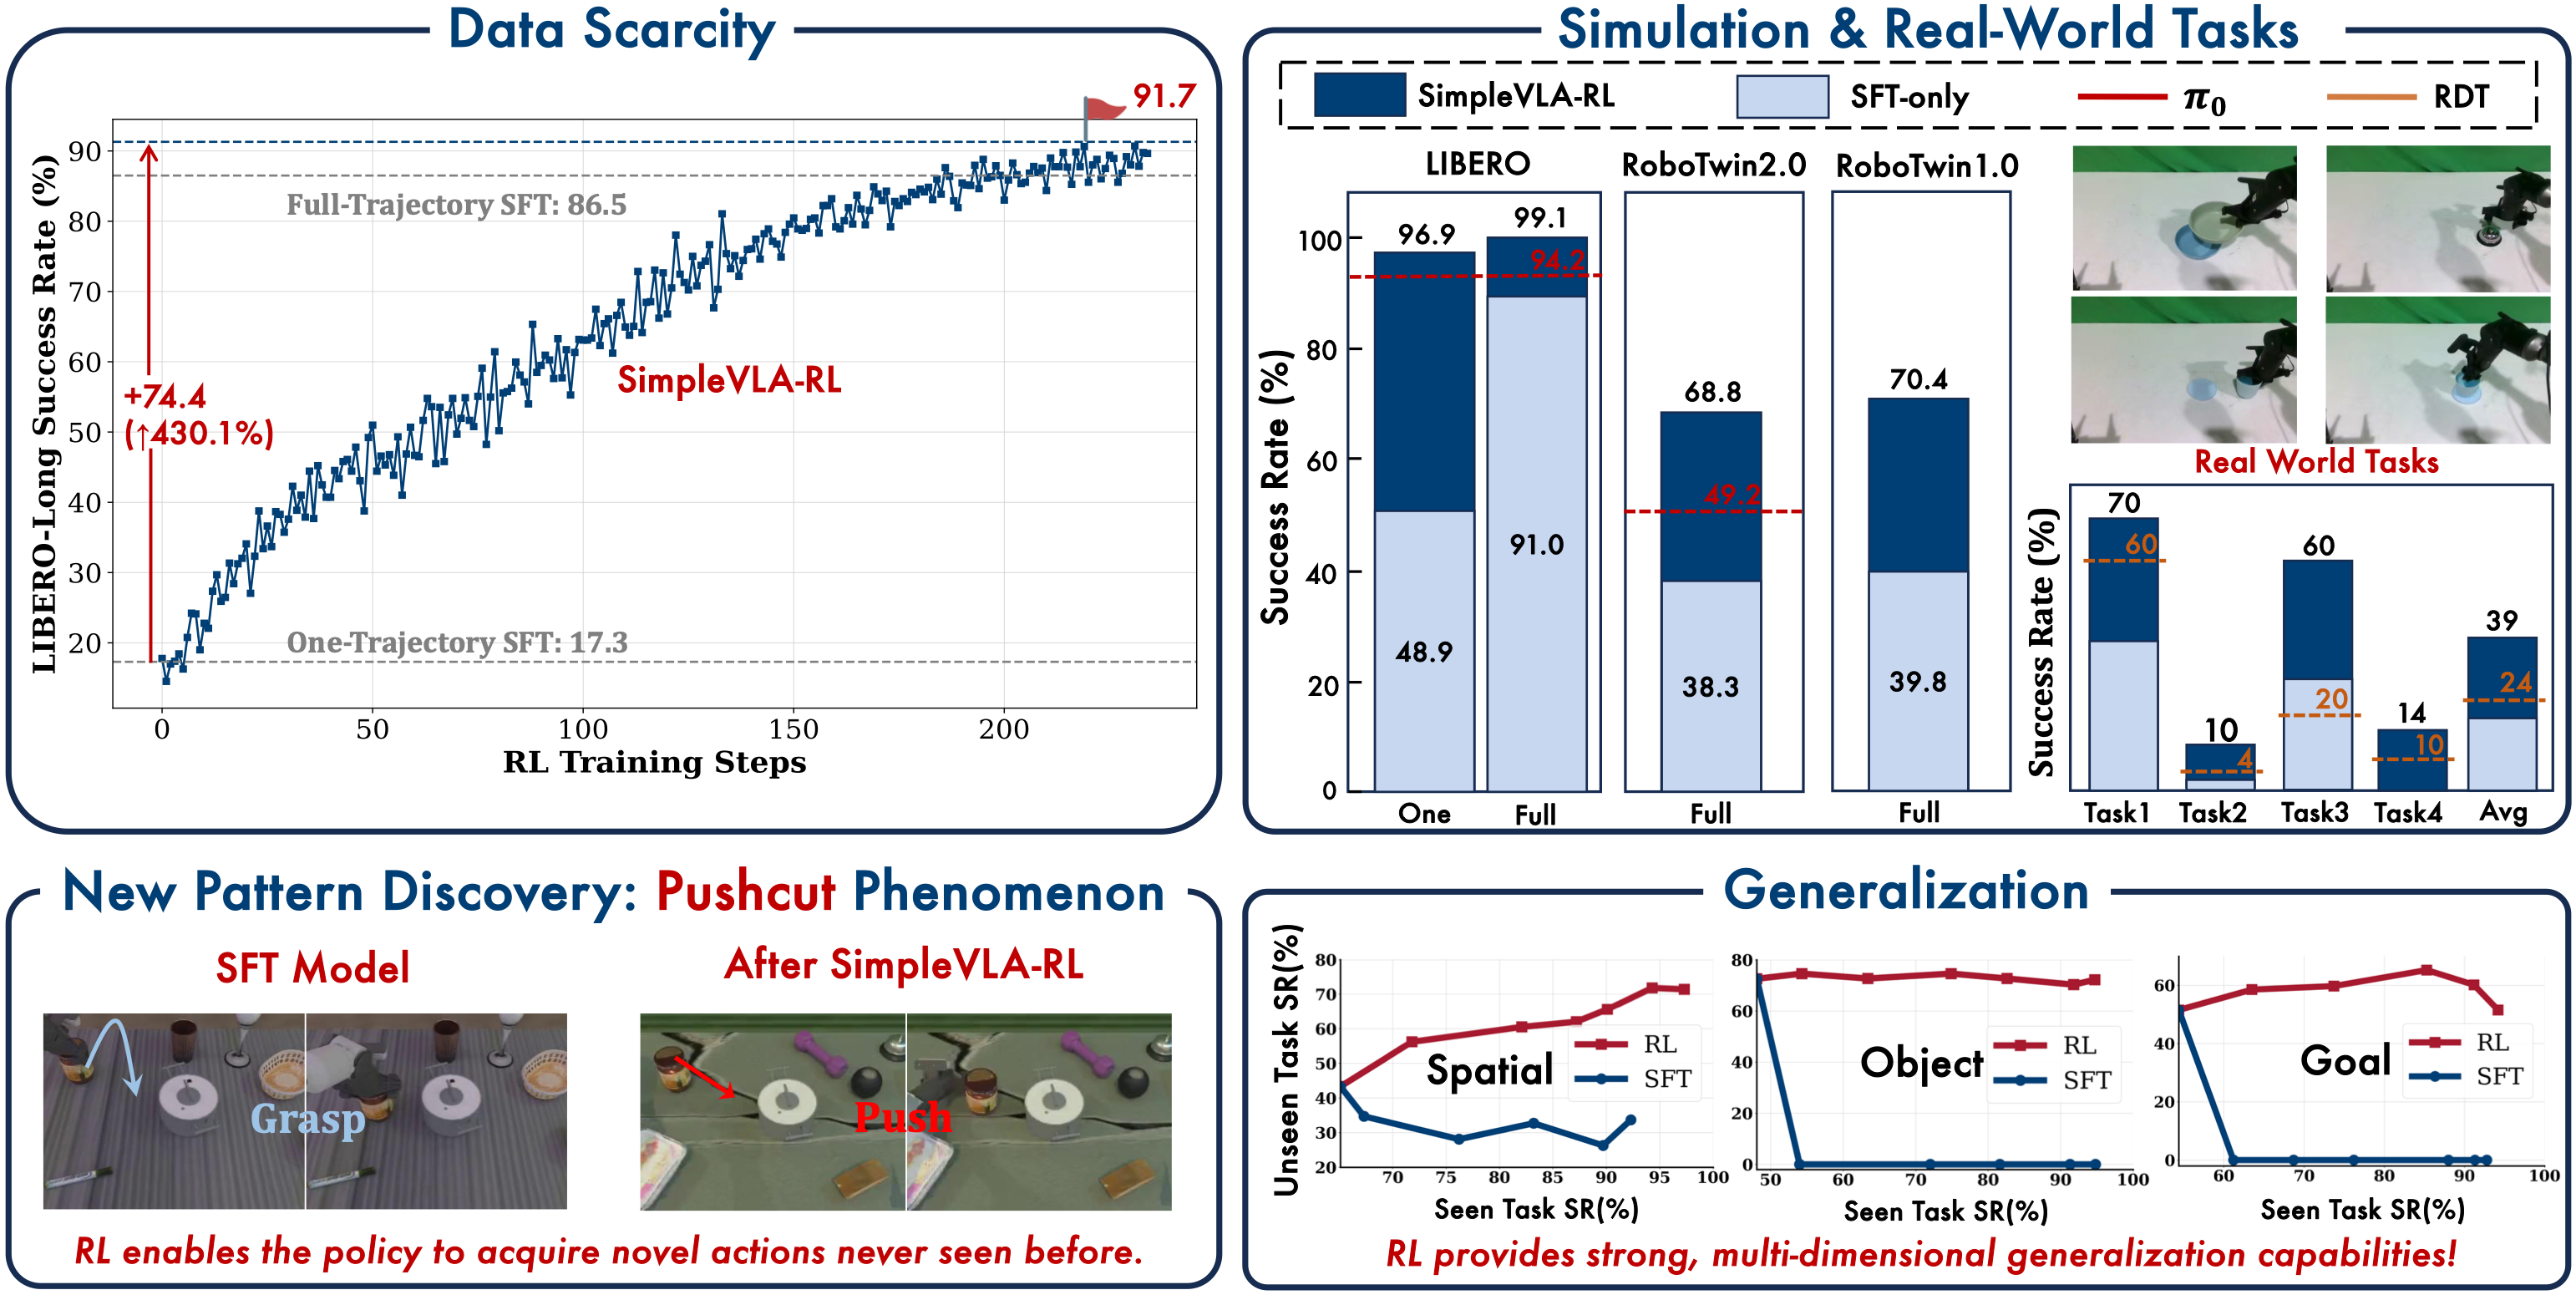
Một trong những phát hiện thú vị nhất của paper là hiện tượng pushcut: sau RL training, model học được cách tiếp cận vật thể không có trong dữ liệu demo. Thay vì cầm thẳng, robot đôi khi đẩy nhẹ vật thể để điều chỉnh góc, rồi mới cầm — một chiến lược mà không có bản demo nào dạy.
Đây là bằng chứng rõ ràng rằng RL không chỉ cải thiện execution — nó thực sự mở rộng không gian chiến lược của robot.
Yêu cầu phần cứng
SimpleVLA-RL không phải dự án có thể chạy trên laptop. Yêu cầu tối thiểu:
| Thành phần | Yêu cầu |
|---|---|
| GPU | 8× NVIDIA A800 80GB (hoặc A100 80GB) |
| CUDA | 12.4+ |
| RAM | 256GB+ |
| Storage | 500GB+ (SFT checkpoint + logs) |
| Python | 3.10 |
Nếu bạn không có GPU cluster nội bộ, có thể thuê cloud GPU (Lambda Labs, RunPod, hay AWS p4d.24xlarge).
Cài đặt môi trường
Bước 1: Tạo conda environment
conda create -n simplevla python=3.10 -y
conda activate simplevla
Bước 2: Clone repo chính
git clone https://github.com/PRIME-RL/SimpleVLA-RL.git
cd SimpleVLA-RL
Bước 3: Cài đặt dependencies
# Cài veRL và các dependencies
pip install -e .

# Cài OpenVLA-OFT
git clone https://github.com/moojink/openvla-oft.git
cd openvla-oft && pip install -e . && cd ..
Bước 4: Cài đặt LIBERO (nếu dùng benchmark LIBERO)
# Cài LIBERO simulation environment
pip install git+https://github.com/Lifelong-Robot-Learning/LIBERO.git
Bước 5: Cài đặt RoboTwin 2.0 (nếu dùng benchmark RoboTwin)
# Theo hướng dẫn tại repo RoboTwin 2.0
pip install git+https://github.com/TeleVU-Org/RoboTwin.git
Bước 6: Cấu hình WandB
SimpleVLA-RL dùng WandB để tracking experiments. Mở file align.json và điền API key:
{
    "wandb_api_key": "YOUR_WANDB_API_KEY_HERE"
}
Nếu bạn chưa có WandB account, đăng ký miễn phí tại wandb.ai.
Giai đoạn 1: SFT Cold-Start
RL không thể bắt đầu từ model random — cần một starting point có khả năng cơ bản. Đây là vai trò của SFT cold-start.
Tải SFT checkpoint
PRIME-RL cung cấp sẵn SFT checkpoint trên HuggingFace:
# Checkpoint cho LIBERO với 10 trajectories
huggingface-cli download PRIME-RL/SimpleVLA-RL-Collection \
    --include "libero-10-traj1-sft/*" \
    --local-dir ./checkpoints/

# Checkpoint cho LIBERO với toàn bộ trajectories
huggingface-cli download PRIME-RL/SimpleVLA-RL-Collection \
    --include "libero-10-trajall-sft/*" \
    --local-dir ./checkpoints/
Hiểu tại sao "1 trajectory per task" lại quan trọng
Paper báo cáo kết quả với chỉ 1 trajectory mỗi task cho cold-start SFT — đây là chế độ dữ liệu cực kỳ khan hiếm. Kết quả SFT chỉ đạt 17.3% thành công. Nhưng sau khi áp dụng RL, con số này tăng lên 91.7% — đây là minh chứng mạnh nhất cho sức mạnh của RL trong việc vượt qua data ceiling.
| Chế độ | SFT | RL |
|---|---|---|
| 1 trajectory/task | 17.3% | 91.7% |
| 100 demos | 7.3% | 25.4% |
| 1000 demos | 28.2% | 50.4% |
| Toàn bộ LIBERO | 91.0% | 99.1% |
Giai đoạn 2: RL Training trên LIBERO
Cấu hình training script
Mở examples/run_openvla_oft_rl_libero.sh và điều chỉnh:
# Số node (1 node = 8 GPU)
export NUM_NODES=1

# Đường dẫn đến SFT checkpoint
export ALIGN_PATH="./checkpoints/libero-10-traj1-sft"

# Số parallel environment (tăng để tăng throughput)
export N_ENVS=8

# LIBERO task suite: libero_spatial, libero_object, libero_goal, libero_long
export TASK_SUITE="libero_long"
Chạy training
bash examples/run_openvla_oft_rl_libero.sh
Script này sẽ:
- Khởi động veRL với distributed training
- Launch 8 LIBERO simulation environments song song
- Mỗi rollout: robot cố gắng thực hiện task, nhận reward 1.0 (thành công) hoặc 0.0 (thất bại)
- Tính GRPO loss và update policy
- Lặp lại ~1000 iterations
Monitoring
Mở wandb.ai để xem metrics theo thời gian thực:
train/success_rate: Tỷ lệ thành công hiện tạitrain/policy_loss: Loss của policy gradienttrain/entropy: Entropy của policy (quá thấp = collapsed)
Giai đoạn 3: RL Training trên RoboTwin 2.0
RoboTwin 2.0 là benchmark khó hơn LIBERO, với các task manipulation phức tạp hơn và đa dạng hơn về môi trường.
# Chỉnh cấu hình cho RoboTwin
export ALIGN_PATH="./checkpoints/robottwin-sft"
export N_ENVS=8

bash examples/run_openvla_oft_rl_twin2.sh
Kết quả trên RoboTwin 2.0
Theo paper và dữ liệu từ bài đánh giá độc lập (dVLA-RL, 2025):
| Model | Average Success Rate |
|---|---|
| OpenVLA-OFT (SFT only) | 34.2% |
| SimpleVLA-RL | 68.7% |
| π0 | Dưới SimpleVLA-RL |
Đây là kết quả đáng kinh ngạc: vượt qua cả π0 — một trong những VLA model mạnh nhất hiện nay.
Inference: Chạy model đã train
Sau khi training, checkpoint được lưu tại outputs/<experiment_name>/. Để inference:
from openvla_oft import OpenVLAOFT
import numpy as np

# Load model
model = OpenVLAOFT.from_pretrained(
    "outputs/simplevla_rl_libero_long/checkpoint-1000"
)
model.eval()

# Inference loop
obs = env.reset()
for step in range(max_steps):
    # obs chứa: image (480x640x3), language instruction
    action = model.predict_action(
        image=obs["image"],
        instruction=obs["instruction"]
    )
    obs, reward, done, _ = env.step(action)
    if done:
        print(f"Task completed in {step+1} steps!")
        break
Triển khai lên robot thực
Điều đáng chú ý là SimpleVLA-RL được train hoàn toàn trong simulation nhưng vẫn transfer sang robot thực:
| Môi trường | SFT | SimpleVLA-RL |
|---|---|---|
| Simulation (RoboTwin 2.0) | 34.2% | 68.7% |
| Real robot (sim-only training) | 17.5% | 38.5% |
Sim-to-real gap vẫn còn (68.7% → 38.5%), nhưng RL giúp cải thiện real robot performance một cách đáng kể so với SFT (17.5%) mà không cần thêm bất kỳ real robot data nào.
Những lỗi thường gặp và cách xử lý
Lỗi 1: CUDA out of memory
RuntimeError: CUDA out of memory. Tried to allocate X GiB
Giảm N_ENVS hoặc batch_size trong script. Với 8× A100 40GB (thay vì 80GB), cần giảm xuống khoảng 60-70% settings gốc.
Lỗi 2: Import error với LIBERO
ModuleNotFoundError: No module named 'robosuite'
LIBERO phụ thuộc vào robosuite. Cài: pip install robosuite
Lỗi 3: Reward luôn bằng 0
Kiểm tra xem task setup có đúng không — robot có thể đang không nhìn thấy vật thể do camera misconfiguration. Chạy python examples/visualize_env.py để kiểm tra.
Lỗi 4: Training không hội tụ sau 500 iterations
Thử giảm learning rate: --lr 1e-6 thay vì mặc định 5e-6. VLA models khá nhạy cảm với learning rate.
Giới hạn và hướng phát triển
SimpleVLA-RL hiện tại có một số giới hạn cần lưu ý:
- Chỉ hỗ trợ OpenVLA/OpenVLA-OFT: Support cho π0 và các VLA model khác đang được phát triển (feature pending trên GitHub)
- Yêu cầu GPU cao: 8× A800 80GB không phải ai cũng có; cộng đồng đang tìm cách giảm xuống 4× A100 40GB
- Reward chỉ là 0/1: Không có dense reward — học có thể chậm với task phức tạp. Có fork community thêm dense reward nhưng chưa chính thức
Tóm tắt: SimpleVLA-RL đáng để học gì?
Nếu chỉ có một điều bạn mang về từ bài này, hãy là: reward đơn giản nhất (0/1) vẫn đủ mạnh để vượt qua SFT với số lượng lớn dữ liệu, nếu bạn có đủ compute để rollout trong simulation.
Điều này mở ra một paradigm mới: thay vì tốn tiền thu thập demonstration data, đầu tư vào simulation infrastructure và RL compute để model tự cải thiện.