Tóm tắt nhanh
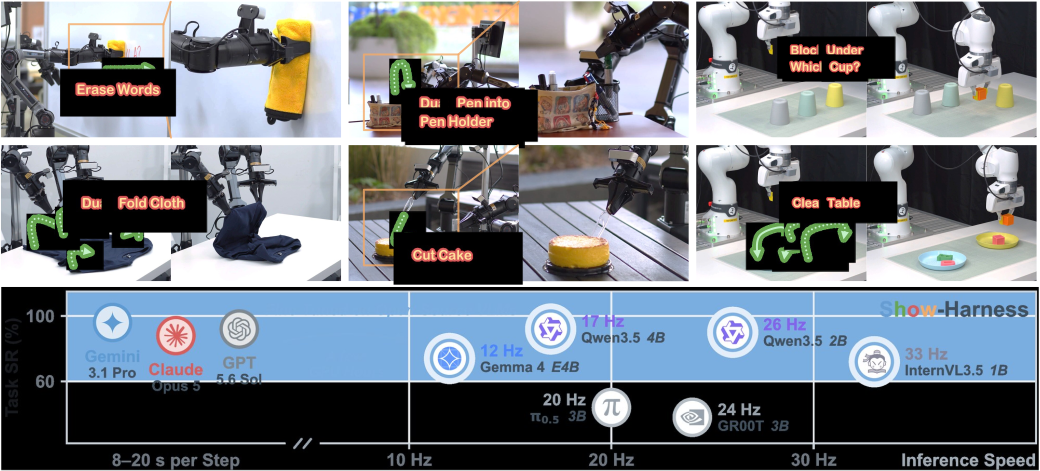
Show-Harness: Just a VLM Agent Can Play Robots là một paper và project open-source từ Show Lab, National University of Singapore. Điểm thú vị của nó không nằm ở việc thêm một backbone VLA khổng lồ, mà ở cách đặt lại câu hỏi: nếu một VLM hiện đại đã đủ giỏi để đọc ảnh, hiểu nhiệm vụ và suy luận theo từng bước, ta có thể cho nó điều khiển robot giống như đang chơi một giao diện game hay không?
Câu trả lời của Show-Harness là có, nhưng cần một lớp trung gian đủ kỷ luật. Thay vì bắt model xuất trực tiếp tọa độ liên tục, joint target, trajectory spline hay action vector theo từng robot, hệ thống dùng một bộ semantic action units nhỏ: MV_FWD, MV_BACK, MV_LEFT, MV_RIGHT, MV_UP, MV_DOWN, GRASP, RELEASE, DONE. Mỗi token là một quyết định vật lý nhỏ, dễ hiểu với người, dễ học với model, và được interpreter của từng embodiment chuyển thành chuyển động thật.
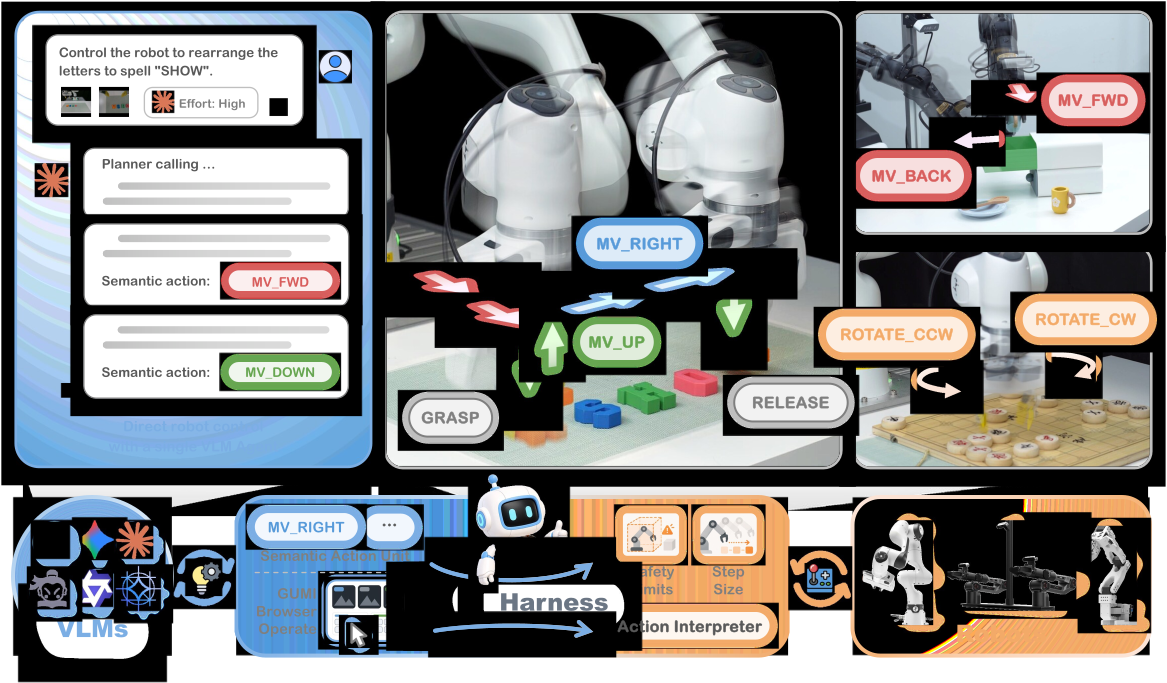
Điểm thứ hai là GUMI: GUI-based Manipulation Interface. Người vận hành có thể thu demonstration bằng bàn phím hoặc nút bấm trong browser, không cần thiết bị teleoperation chuyên dụng. Quan trọng hơn, dữ liệu thu được đã ở đúng format mà policy sẽ thấy khi inference: một observation gồm camera view, task text, history; một action token duy nhất. Vì vậy pipeline training giảm được rất nhiều “keo dán” thường thấy trong robotics.
Nếu bạn đã đọc LeRobot Framework Deep Dive, bạn có thể xem Show-Harness như một hướng bổ sung: LeRobot chuẩn hóa dataset, policy và robot interface; Show-Harness chuẩn hóa “ngôn ngữ thao tác” giữa VLM và robot. Nếu bạn quan tâm tới VLA mở như OpenVLA, xem thêm OpenVLA Deep Dive. Còn nếu muốn nhìn vào bài toán dual-arm, FineVLA dual-arm tutorial là mảnh ghép liên quan.
Ý tưởng paper
VLA truyền thống thường học mapping từ ảnh và lệnh ngôn ngữ sang action liên tục hoặc action chunk. Cách này mạnh khi có dữ liệu lớn, nhưng có hai vấn đề với lab nhỏ: dữ liệu robot thật đắt, và action space thường gắn chặt với từng embodiment. Khi đổi từ Franka sang AgileX Piper, hoặc từ simulation sang robot thật, policy có thể cần data mới, calibration mới, hoặc fine-tune lại đáng kể.
Show-Harness đi theo hướng khác: giữ VLM ở vị trí người ra quyết định, còn robot-specific controller chỉ làm interpreter deterministic. VLM nhìn camera, đọc task, nhớ vài bước gần nhất, rồi chọn một action unit. Interpreter chuyển action unit đó thành chuyển động nhỏ và an toàn: ví dụ một bước translation 2 cm theo hướng đã chuẩn hóa, hoặc đóng/mở gripper. Sau khi hành động chạy xong, camera cập nhật, VLM lại quyết định bước tiếp theo.
Vì action là semantic, người cũng hiểu ngay model đang làm gì. Nếu model lặp MV_LEFT và MV_RIGHT, ta biết nó đang dao động. Nếu nó GRASP khi chưa align, ta thấy lỗi ở cấp quyết định chứ không phải chỉ thấy một vector vô nghĩa. Đây là lợi thế lớn khi debug robot manipulation trong thế giới thật, nơi một rollout thất bại thường tốn thời gian setup lại cảnh.
Paper chia hệ thống thành hai chế độ. Zero-shot mode dùng frontier VLM như một agent: model lớn nhận prompt giàu ngữ cảnh, có plugin hỗ trợ perception, planning, memory, recovery, rồi xuất semantic action. Fine-tuned mode dùng VLM nhỏ open-source đã fine-tune LoRA trên demonstration GUMI: mỗi step trả đúng một token action, không cần planner phức tạp. Điều hay là cả hai mode dùng cùng interface, nên demonstration, prompt contract và runtime loop không bị tách thành hai thế giới.
Kiến trúc Show-Harness
Kiến trúc cốt lõi là vòng lặp perceive, reason, act. Ở bước perceive, hệ thống lấy ảnh từ hai camera chính: agentview để thấy workspace tổng quát và wrist view để căn chỉnh gần gripper. Tùy cấu hình, các plugin có thể thêm thông tin proprioception, đánh dấu wrist marker, chọn view, hoặc đưa ra hint về step size.
Ở bước reason, VLM nhận task text, ảnh, action history và các prompt injection từ plugin. Với zero-shot, model có thể sinh reasoning dài, lập subgoal, kiểm tra thất bại và chọn action. Với fine-tuned mode, prompt được tối giản để model chỉ cần xuất một token. Điều này làm inference rẻ và ổn định hơn: thay vì “nói chuyện” với robot bằng đoạn văn, model trả về một từ khóa hành động.
Ở bước act, action unit đi qua interpreter. Franka có thể track Cartesian setpoint bằng impedance control. AgileX Piper dùng inverse kinematics và streamed joint target. Simulator như ManiSkill hoặc RoboLab nhận operational-space command tương ứng. Nhìn từ phía VLM, MV_DOWN vẫn là MV_DOWN; nhìn từ phía robot, cách thực thi khác nhau theo hardware.
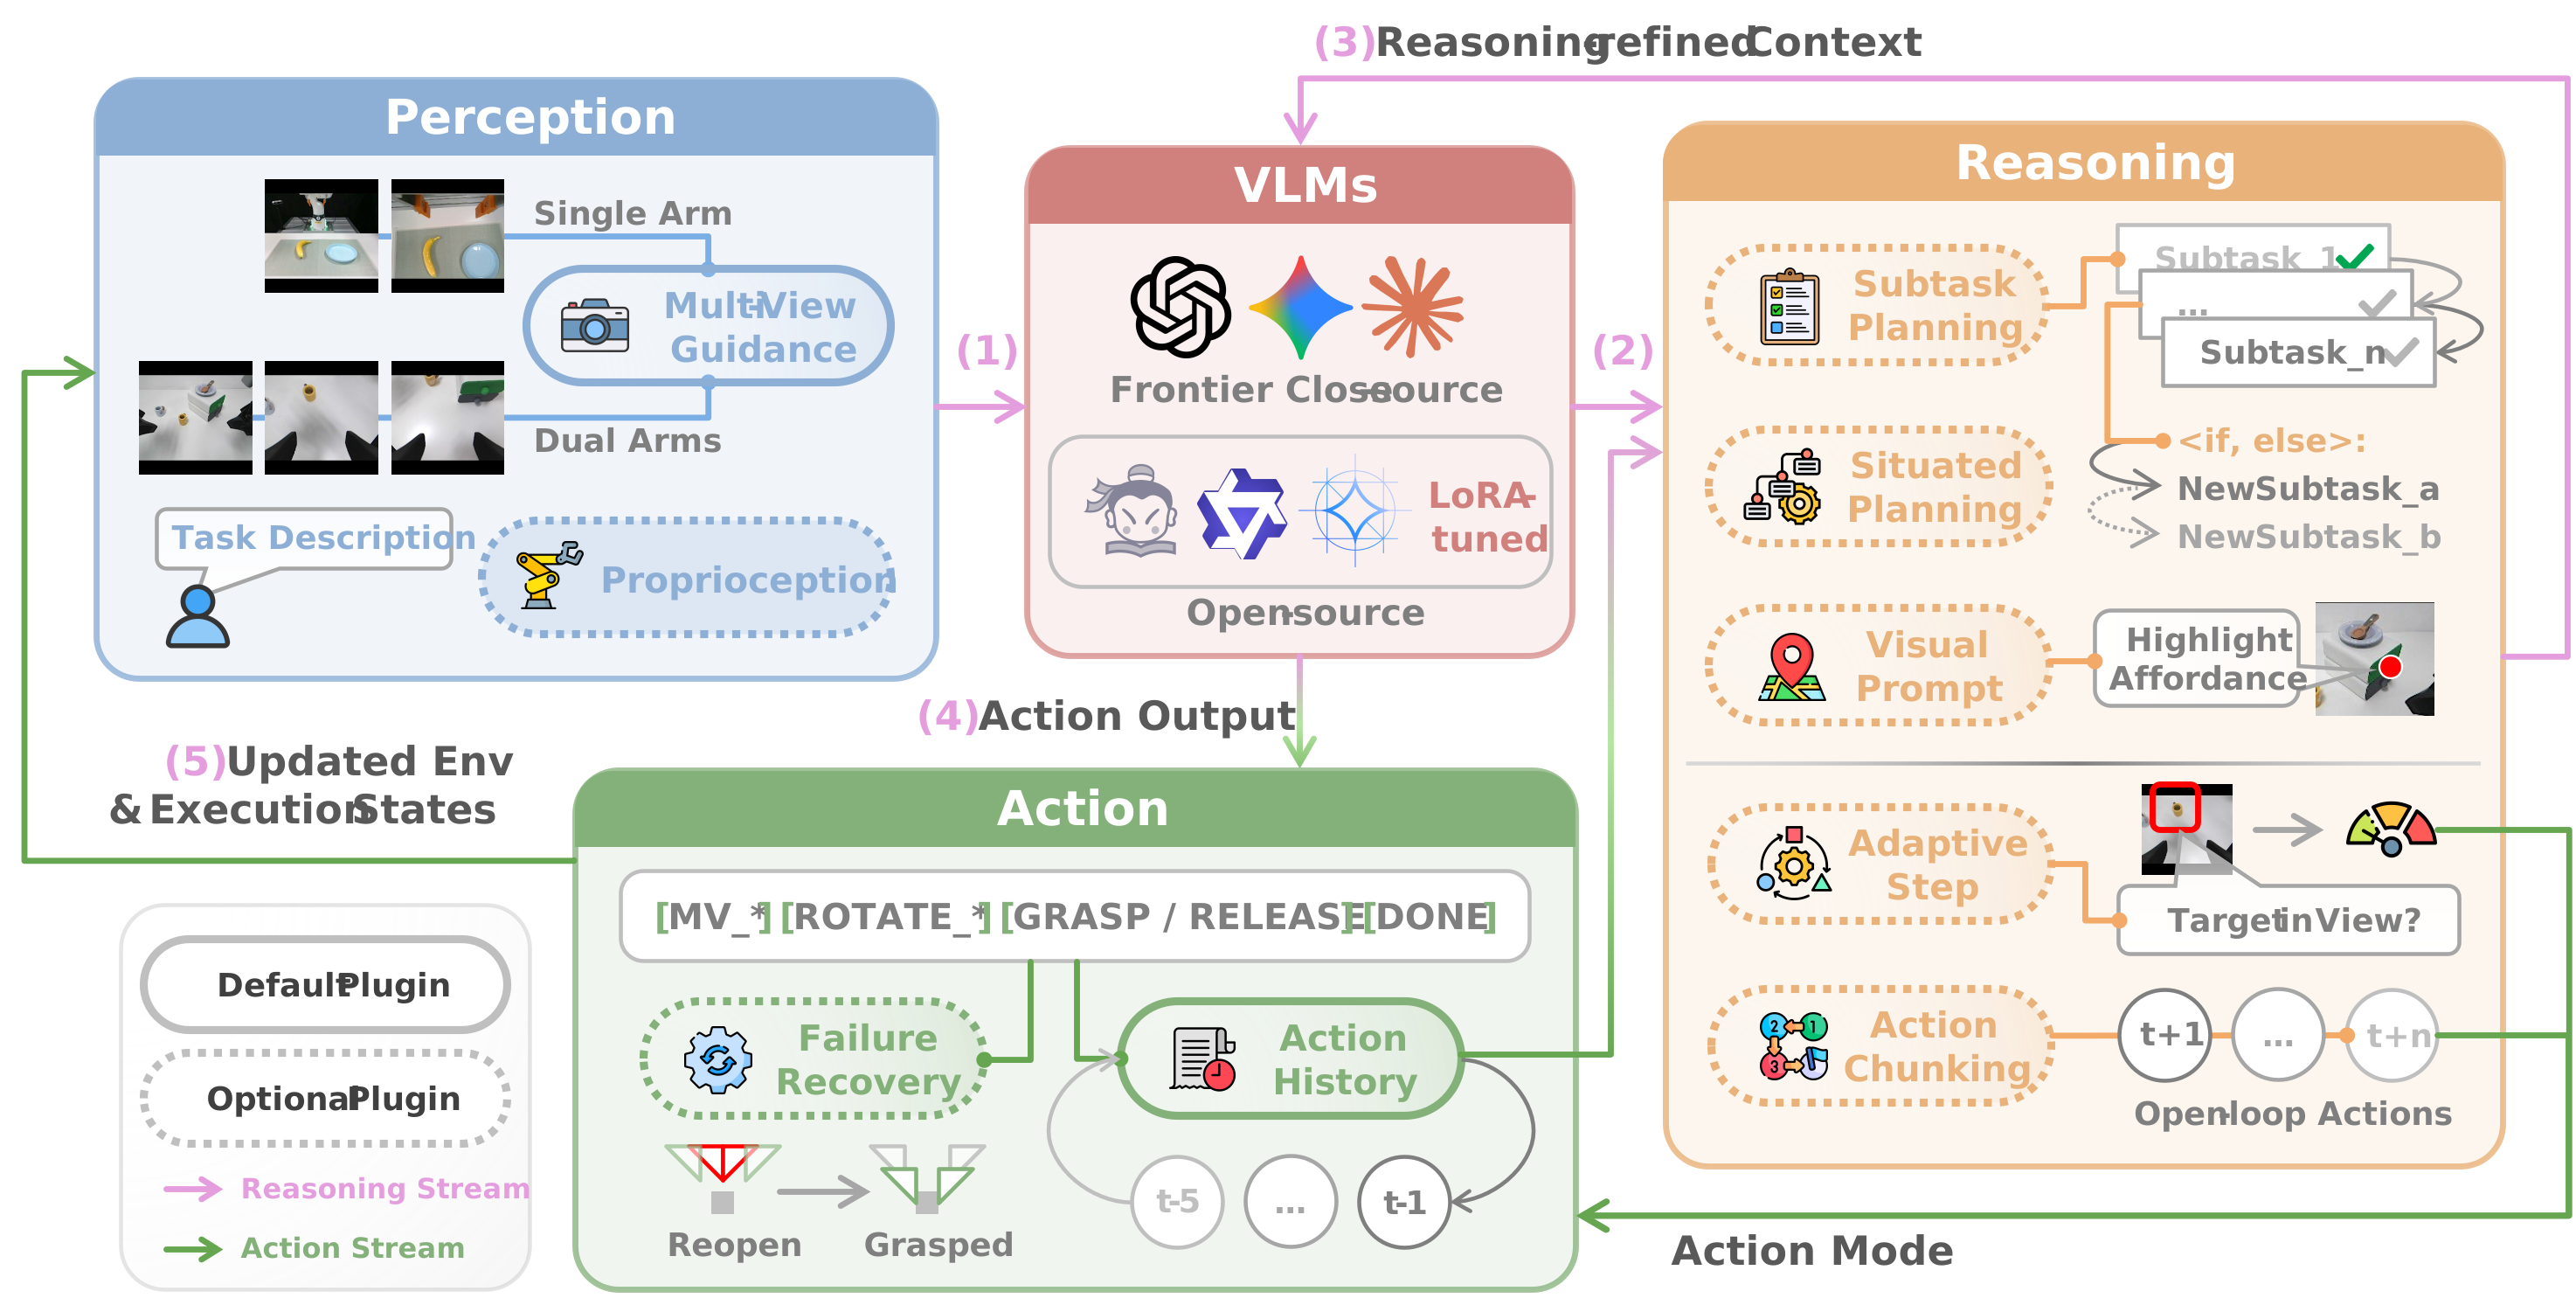
Repo cũng có hệ thống plugin khá thực dụng. Subtask Planning giúp chia task dài thành các mốc thị giác. Situated Planning thêm ngữ cảnh hiện trường. Action Chunking giảm số lần gọi model khi target còn xa, bằng cách cho model phát một chuỗi ngắn action semantic. Action History giúp tránh lặp vô nghĩa. Failure Recovery xử lý các tình huống như empty grasp, grasp chưa được xác nhận, hoặc mất vật sau khi nhấc. Điểm đáng chú ý là plugin được bật tắt bằng config và khi tắt thì loop trở lại baseline, thuận tiện cho ablation.
GUMI: thu dữ liệu như chơi robot trong browser
GUMI là phần làm Show-Harness dễ follow với beginner. Thay vì dựng VR teleop, haptic device hay custom controller, bạn chạy một web server cục bộ, mở UI trên browser, rồi dùng phím hoặc nút để điều khiển robot qua chính action vocabulary của Show-Harness. Single-arm collector mặc định chạy port 8600; dual-arm collector chạy port 8620; agent operator dashboard chạy port 8630.
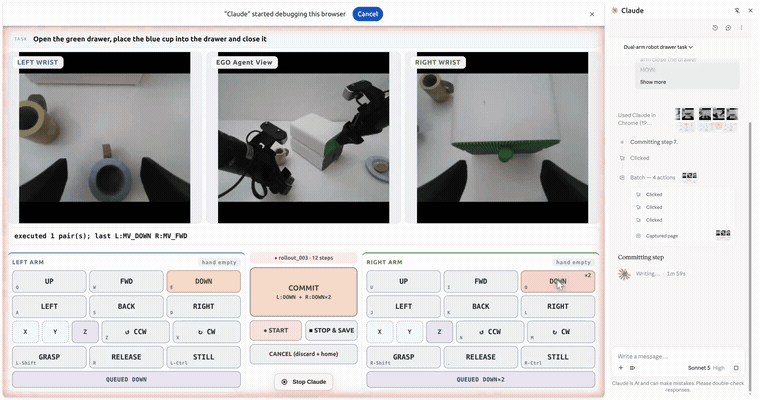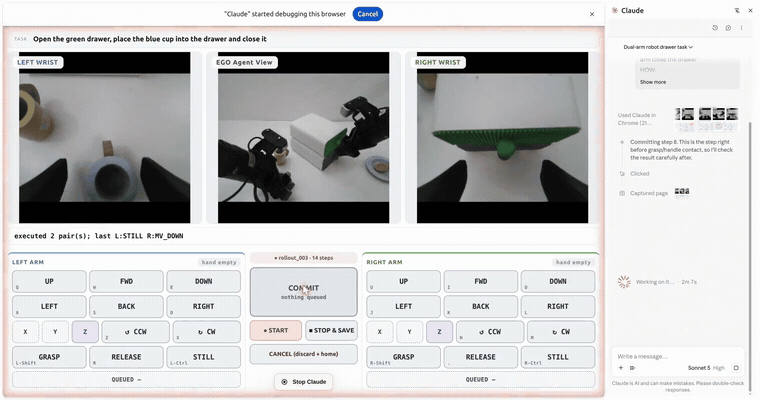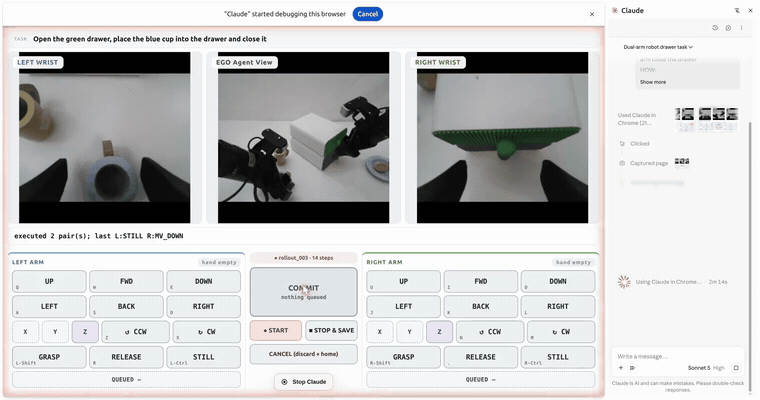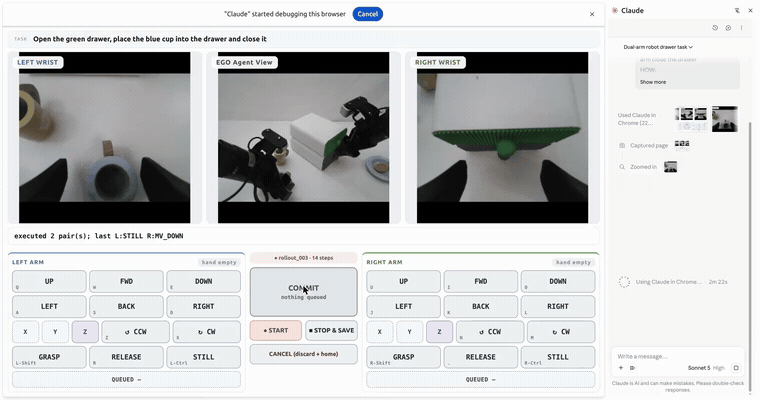
Mỗi lần bạn nhấn một action, hệ thống lưu cặp (observation, action). Observation gồm ảnh agentview, ảnh wrist, task text, history và metadata cần thiết. Action là một trong chín token. Đây là khác biệt quan trọng với teleop liên tục: dữ liệu không cần bước hậu xử lý lớn để rời rạc hóa trajectory. Nó đã là supervised sample cho fine-tuning.
GUMI cũng hỗ trợ agent operator: một VLM có thể đọc camera qua HTTP và post action token vào UI giống người vận hành. Vì vậy cùng một giao diện phục vụ ba vai trò: human teleop, VLM teleop và data collection. Với lab nhỏ, đây là thiết kế rất đáng học: giảm số lượng tool, giữ format dữ liệu thống nhất, và dễ kiểm tra bằng mắt.
Cài đặt và chạy thử
Repo chính là https://github.com/showlab/Show-Harness. Project page trỏ tới paper arXiv 2609.10522, model adapters trên Hugging Face showlab/Show-Harness-VLMs, và dataset showlab/Show-Harness-Data. Repo tách môi trường khá rõ vì serving VLM, robot hardware và training có dependency khác nhau.
Để chạy phần harness và thử GUMI simulation:
git clone https://github.com/showlab/Show-Harness
cd Show-Harness
bash scripts/setup.sh base
.venv/bin/python gumi/collect_rollouts_web.py data/rollouts_demo --sim
Sau đó mở http://localhost:8600, click vào page để nhận keyboard focus, rồi dùng các phím điều khiển. Chế độ --sim cho phép thử workflow mà chưa cần Franka, AgileX Piper, RealSense hay ROS layer. Khi chuyển sang robot thật, bạn bỏ --sim, tạo site config như configs/site/franka.yaml hoặc configs/site/piper_arms.yaml, điền robot address và camera serials, rồi chạy preflight.
Với Franka, repo dùng Polymetis layer ở NUC robot, hai RealSense camera gồm D435 third-person và D405 wrist-mounted. Trước khi chạy autonomous rollout, bạn cần capture Z floor và begin pose cho đúng bàn thật. Repo có script scripts/check_setup.py để kiểm tra env, config, calibration, VLM backend, robot và camera trước khi arm di chuyển.
Ví dụ zero-shot real robot:
cp configs/site/franka.yaml.example configs/site/franka.yaml
cp configs/secrets.env.example configs/secrets.env
python scripts/check_setup.py --robot-config configs/robot_franka.yaml
python scripts/run_real.py --robot-config configs/robot_franka.yaml
Ví dụ fine-tuned local policy:
ADAPTER=qwen3_5_2b WITH_BASE=1 bash scripts/model/download_vlm_model.sh
MODEL=Qwen/Qwen3.5-2B \
  LORA=qwen3_5_2b_showharness_ft=models/Show-Harness-VLMs/qwen3_5_2b \
  FAMILY=qwen3_5 bash scripts/serve_vlm.sh

python scripts/run_real_mvtoken.py \
  --robot-config configs/robot_franka_ft.yaml \
  --version v3 \
  --model qwen3_5_2b_showharness_ft
Điểm cần nhớ: prompt template là contract. Nếu adapter được train với prompt v3, inference cũng phải dùng --version v3. Nếu phục vụ Qwen bằng chat template gốc khác với template lúc training, model vẫn có thể trả token nhưng chất lượng giảm âm thầm.
Training: từ rollout GUMI tới LoRA
Training pipeline nằm trong thư mục train/ và dựa trên LLaMA-Factory. Cách làm cơ bản là: thu rollout bằng GUMI hoặc tải dataset released, convert rollout thành Alpaca multimodal samples, đăng ký dataset, rồi train LoRA adapter cho backbone như Qwen3.5, InternVL3.5 hoặc Gemma 4.
bash train/scripts/setup_llamafactory.sh
bash train/scripts/download_dataset.sh
cp train/configs/qwen3_5_2b_lora.yaml train/configs/my_run.yaml
CONFIG=train/configs/my_run.yaml GPU=0 bash train/scripts/train.sh
Dataset released có hai split chính. Split real gồm 164 episodes, 7.933 samples và 15.866 images từ Franka và AgileX, bao phủ 17 tasks. Split sim gồm 230 episodes, 13.753 samples và 27.046 images từ RoboLab và ManiSkill. Mỗi sample có hai ảnh, prompt đã render, và output là một action token. Bộ action gồm sáu hướng MV_*, GRASP, RELEASE, DONE.
Model card cho biết recipe của adapters released: LoRA rank 64, alpha 128, dropout 0.05, target all, vision tower frozen, learning rate 1e-4, cosine schedule, warmup ratio 0.1, bf16 và DeepSpeed ZeRO-2. Real adapters train 40 epochs; sim adapter train 30 epochs. Các adapter real gồm Qwen3.5-0.8B, Qwen3.5-2B, Qwen3.5-4B, Qwen3.5-9B và Gemma-4-E4B. Adapter sim là Qwen3.5-2B cho cả RoboLab và ManiSkill.
Một chi tiết dễ sai là convention hướng trên AgileX. Dataset chuẩn hóa hướng theo view exocentric của Franka. AgileX dùng first-person view nên khi deploy cần swap MV_FWD và MV_BACK. Repo xử lý bằng config execution_token_swap, nhưng nếu tự viết runner thì đây là lỗi rất dễ khiến robot đi ngược mà không báo exception.
Inference: vì sao one-token policy đáng giá?
Trong fine-tuned mode, mỗi step gửi camera frames và prompt cố định, model trả đúng một token. Nếu token là DONE, rollout kết thúc; nếu không, interpreter chạy motion tương ứng và vòng lặp tiếp tục tới max_steps. Thiết kế này làm latency dễ đo hơn: camera read, model decision, arm motion và logging đều tách bạch trong steps.jsonl.
Một policy như vậy không “thông minh toàn năng” theo nghĩa nó không tự viết program dài. Nhưng nó rất hữu dụng cho manipulation: khi vật chưa vào wrist view, dùng agentview để tiến gần; khi target đã gần gripper, dùng wrist view để fine-align; khi gripper ôm đúng vật, GRASP; khi vật đến đích, RELEASE; cuối cùng DONE. Vì action nhỏ và feedback đóng vòng, sai một bước không nhất thiết phá hỏng toàn bộ episode.
Nếu so với action chunk liên tục trong nhiều VLA, Show-Harness giống “manual transmission” hơn: model phải ra quyết định thường xuyên, nhưng mỗi quyết định dễ giải thích và dễ sửa. Với robot thật, trade-off này có lý, nhất là khi bạn cần safety floor, human takeover, hoặc debug từng rollout.
Kết quả và ý nghĩa
Paper báo cáo rằng Show-Harness cho phép frontier VLM điều khiển robot zero-shot qua cùng semantic interface, đồng thời biến VLM nhỏ thành controller sau vài GPU-hours fine-tuning. Theo model card, Qwen3.5-2B adapter chỉ là LoRA khoảng 135 MB nhưng có thể phục vụ như policy real-robot. Dataset cũng tương đối nhỏ so với chuẩn “foundation robotics”: 7.933 real samples và 13.753 sim samples, không phải hàng triệu trajectory.
Điều này không có nghĩa Show-Harness thay thế mọi VLA end-to-end. Nó phù hợp nhất với tabletop manipulation có action incremental rõ ràng, camera đủ tốt, và task có thể giải bằng chuỗi bước nhỏ. Với contact-rich manipulation phức tạp, deformable object, force control hoặc high-speed dynamic tasks, semantic token 2 cm có thể quá thô hoặc quá chậm. Nhưng với pick-place, sorting, moving objects, simple dual-arm coordination và sim-to-real experimentation, thiết kế này rất hấp dẫn.
Giá trị lớn nhất của Show-Harness là biến “robot controller” thành một interface chung. Người, VLM zero-shot và VLM fine-tuned đều dùng cùng vocabulary. Data collection và inference nhìn giống nhau. Interpreter giữ phần hardware-specific nhưng không che mất quyết định của model. Với các đội đang xây VLA stack thực dụng, đây là một mẫu kiến trúc đáng copy trước cả khi copy model.
Checklist cho lab nhỏ
Nếu muốn thử Show-Harness nghiêm túc, hãy bắt đầu từ simulation GUMI, không bắt đầu từ robot thật. Chạy --sim, thu vài rollout, mở rollouts.json để xem sample thực tế, rồi serve adapter released bằng vLLM. Sau đó mới chuẩn hóa camera placement, Z floor, begin pose và safety stop trên hardware.
Với dữ liệu riêng, giữ task text ngắn và nhất quán. Đừng thay prompt version giữa training và inference. Đừng mix camera transform tùy tiện. Kiểm tra token direction bằng dry run. Và luôn log video rollout, vì với semantic action policy, video là cách nhanh nhất để thấy model sai ở perception, decision hay interpreter.