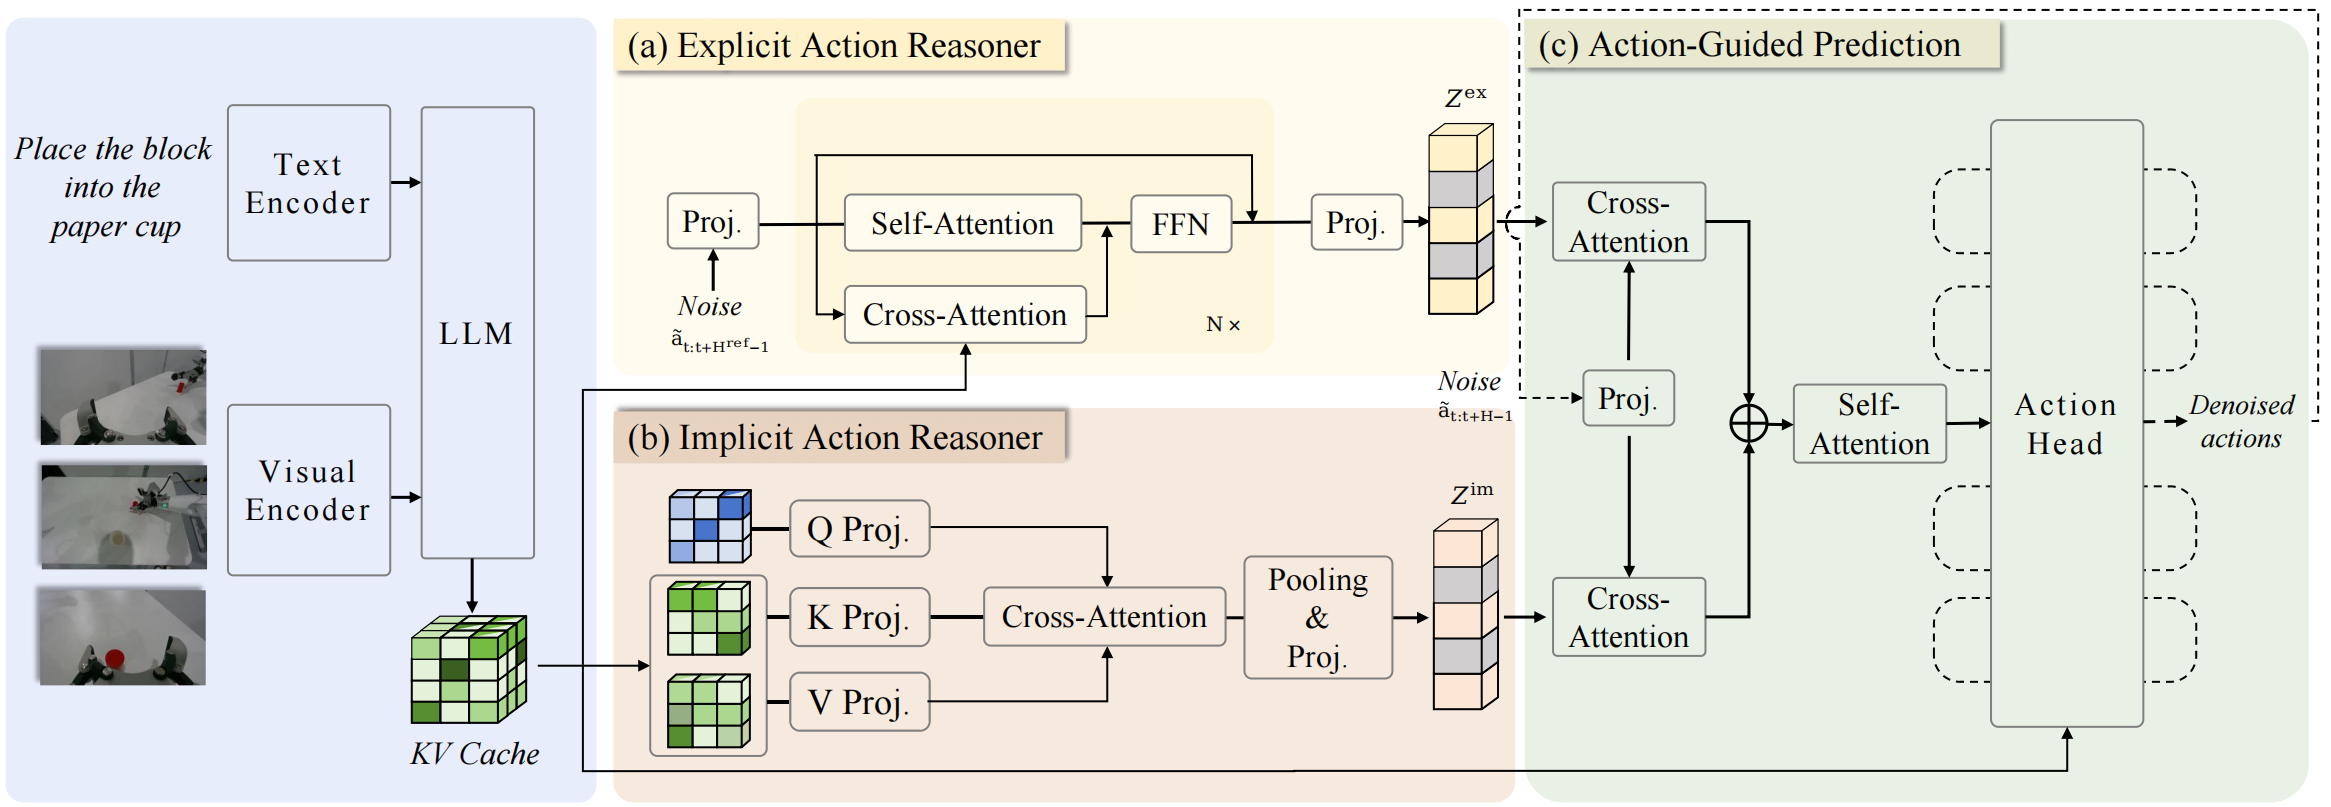
Vì sao FluxVLA Engine đáng chú ý?
Nếu bạn đã từng fine-tune một VLA model bằng LeRobot, chạy benchmark LIBERO, rồi muốn đem policy đó lên ALOHA, Franka, UR3, TRON 2 hoặc humanoid thật, bạn sẽ gặp một khoảng cách rất khó chịu: model thì có checkpoint, nhưng hệ thống robot cần nhiều thứ hơn checkpoint. Bạn phải thống nhất camera order, observation.state, action dimension, normalization statistics, action horizon, simulator wrapper, inference loop, remote GPU serving, safety stop, ROS/SDK bridge, và cách ghi lại rollout lỗi để train tiếp. FluxVLA Engine sinh ra để đóng đúng khoảng cách đó.
Paper FluxVLA Engine: A One-Stop VLA Engineering Platform for Embodied Intelligence được nộp lên arXiv ngày 15/09/2026 bởi LimX Dynamics và các cộng tác viên. Điểm quan trọng: FluxVLA không tự nhận là một VLA architecture mới. Nó là một engineering platform open-source, configuration-driven, giúp gom các policy family khác nhau như SmolVLA, OpenVLA, GR00T, Pi0, Pi0.5, DreamZero, FastWAM, DiT4DiT, Cosmos3 vào cùng một vòng lặp: data → train → eval → inference → deploy robot thật.
Nói theo cách thực dụng: nếu LeRobot hands-on là điểm khởi đầu để bạn lưu demonstration thành dataset, và OpenVLA deep dive giúp hiểu VLA model, thì FluxVLA là lớp “hạ tầng sản xuất” để biến nhiều VLA/WAM/offline policy thành thí nghiệm có thể lặp lại. Bài này đi từ ý tưởng paper, kiến trúc, cài đặt, training, eval, inference, đến checklist deploy trên robot thật.

Ý tưởng chính của paper
Vấn đề mà paper mô tả rất quen thuộc với robotics engineer: một model manipulation có thể chạy tốt trong notebook nhưng vẫn chưa phải robot system. Khi đem model ra khỏi repo gốc, những giả định ngầm bắt đầu lộ ra. Dataset A dùng wrist camera trước, dataset B dùng third-person camera trước. Model này cần action delta, model kia cần absolute joint target. Config training lưu normalize theo mean/std, còn deploy lại cần min/max hoặc quantile. Simulator đo success theo trial count khác nhau. Robot thật có latency, network jitter, gripper delay và control mode riêng.
FluxVLA giải quyết bằng cách coi toàn bộ experiment như một hợp đồng có version, không chỉ coi neural network là phần trung tâm. Một config duy nhất mô tả data processing, model construction, optimizer, evaluation protocol, inference runner và robot operator. Registry-based interface cho phép thêm dataset, model, action head, evaluator hoặc robot mới mà không copy cả training stack. Đây là tư duy giống các framework như MMDetection, nhưng áp dụng cho embodied policy nơi dữ liệu, control loop và hardware có ảnh hưởng trực tiếp đến kết quả.
Paper đặt bốn nguyên tắc nền:
- Unification: một experiment config nối data, model, train, eval, inference và deploy.
- Modularity: data layer, model layer, execution layer, serving layer và operator layer có boundary rõ.
- Deployability: cùng artifact có thể reconstruct policy cho evaluation hoặc physical robot inference.
- Reproducibility: config, checkpoint, transforms, statistics và evaluation artifacts không tách rời nhau.
Điểm rất đáng khen là paper cũng đặt ranh giới claim khá cẩn thận. FluxVLA không nói “model của tôi thắng tất cả”. Kết quả LIBERO/RoboCasa trong repo đến từ nhiều model với pretraining, budget và protocol khác nhau. Giá trị chính là khả năng đưa nhiều policy family vào cùng một đường chạy kỹ thuật có thể audit.
Kiến trúc: từ LeRobot sample đến robot command
FluxVLA tách hệ thống thành năm tầng.
Data layer đọc episode từ Parquet/LeRobot format, sau đó áp dụng transform theo config. Transform này chịu trách nhiệm map camera, state, language instruction, action horizon, action normalization và temporal sampling thành sample dictionary mà model hiểu. Với beginner, hãy nhớ một nguyên tắc: đừng sửa data bằng script rời nếu sửa được trong config. Khi preprocessing nằm trong config, training và inference có cơ hội dùng cùng semantics.
Model layer nhận sample dictionary và trả về loss khi training hoặc action chunk khi inference. FluxVLA hỗ trợ nhiều dạng action: autoregressive token như OpenVLA/FAST-style, continuous flow matching như Pi0/Pi0.5, diffusion hoặc world-action model như DreamZero/FastWAM/DiT4DiT. Nhờ đó, bạn có thể so sánh policy family mà không viết lại dataset loader cho từng model.
Execution layer quản lý distributed training, optimizer, scheduler, checkpoint, eval-after-train, resume và metric logging. Với cluster, bạn dùng scripts/train.sh; với local debug, có thể gọi trực tiếp torchrun scripts/train.py.
Serving layer tách policy inference khỏi robot side. Đây là phần quan trọng khi robot chạy Jetson/mini PC nhưng model cần GPU lớn. FluxVLA có remote inference qua ZMQ, nghĩa là robot gửi observation sang GPU server, nhận action chunk về, và vẫn giữ timeout/recovery rõ ràng.
Operator layer là nơi kết nối simulator hoặc robot SDK. Operator chịu trách nhiệm đọc sensor, đồng bộ timestamp, translate action thành joint/eepose/gripper command, và xử lý boundary với hardware. Paper nhấn mạnh runner không nên trộn lẫn với robot communication code, vì nếu trộn, mỗi model sẽ kéo theo một bộ deploy script riêng.
Chuẩn bị môi trường
Repo chính là https://github.com/FluxVLA/FluxVLA. Tại thời điểm viết bài, README khuyến nghị Python 3.10 và installer theo mode: sim-only, real-only, hoặc full. Nếu bạn mới bắt đầu, chọn sim-only trước để chạy LIBERO/RoboCasa, sau đó mới chuyển sang real-only hoặc full khi có robot.
conda create -n fluxvla python=3.10 -y
conda activate fluxvla

# Simulation / LIBERO / RoboCasa runtime
bash scripts/install_env.sh sim-only

# Khi cần cả simulation và real robot:
# bash scripts/install_env.sh full
FluxVLA tự xử lý nhiều dependency khó như PyTorch CUDA profile, FlashAttention wheel, FFmpeg/TorchCodec, MuJoCo EGL và RoboCasa source checkout. Nếu chạy real robot, bạn vẫn cần ROS/SDK của robot ở system level. Ví dụ với ROS Noetic:
source /opt/ros/noetic/setup.bash
Với Jetson Orin, repo có Docker runtime riêng:
docker pull fluxvla/fluxvla:fluxvla-orin-1.0.0
scripts/run_docker.sh
README báo FluxVLA đã hỗ trợ Jetson Orin deployment và GR00T-N1.5 đạt 7.4 Hz ở edge inference acceleration. Con số này không nên hiểu là “robot luôn điều khiển ở 7.4 Hz”, vì end-to-end control còn phụ thuộc camera, transport, post-processing và controller. Nhưng nó cho thấy hướng deploy không chỉ dành cho server GPU.
Dataset: bắt đầu từ LeRobot
FluxVLA dùng LeRobot format làm đường vào thực tế. Nếu bạn đã có dataset từ LeRobot, mục tiêu là bảo toàn cấu trúc episode:
dataset/
├── data/
│   └── chunk-000/
│       ├── episode_000000.parquet
│       └── episode_000001.parquet
├── meta/
│   ├── episodes.jsonl
│   ├── episodes_stats.jsonl
│   ├── info.json
│   └── tasks.jsonl
└── videos/
    └── chunk-000/
        └── camera_name/
            ├── episode_000000.mp4
            └── episode_000001.mp4
Nếu bạn chưa có data, dùng dataset đã chuẩn bị sẵn của FluxVLA để chạy trước. Ví dụ LIBERO-10:
huggingface-cli download limxdynamics/FluxVLAData \
  --repo-type dataset \
  --include "libero_10_no_noops_lerobotv2.1/*" \
  --local-dir ./datasets
Một beginner thường vấp ở normalization. FluxVLA có tool tính transformed statistics sau khi đã áp dụng coordinate transform và delta/absolute action profile. Đây là điểm quan trọng: statistics phải khớp với action semantics mà model train và robot deploy dùng.
python tools/compute_transformed_dataset_stats.py /path/to/ur3 \
  --profile ur3 \
  --action-horizon 50 \
  --variable-name _PI05_UR3_STATS \
  --output /tmp/ur3_stats.py
Với ALOHA/Pi0.5, README nhắc không tự regenerate official Trossen statistics nếu mục tiêu là giữ parity với OpenPI asset. Với private robot, bạn nên generate stats riêng và dùng cùng dictionary cho cả train_dataloader.dataset.dataset_statistics lẫn inference.denormalize_action.norm_stats.
Chọn model: SmolVLA, GR00T hay Pi0.5?
FluxVLA là engine, không bắt bạn dùng một model. Nếu GPU hạn chế, SmolVLA là baseline nhẹ và dễ debug. Nếu cần real-time manipulation mạnh hơn, Pi0.5 hoặc GR00T N1.5/N1.7 là lựa chọn thường gặp. Nếu muốn thử world-action model, FastWAM hoặc DiT4DiT cho kết quả LIBERO/RoboCasa cao hơn nhưng chi phí tính toán lớn hơn.
Checklist chọn model:
| Trường hợp | Model nên thử | Lý do |
|---|---|---|
| Debug pipeline, GPU nhỏ | SmolVLA | Nhẹ, ít rủi ro môi trường |
| Manipulation flow matching | Pi0/Pi0.5 | Action chunk mượt, nhiều config có sẵn |
| Humanoid/generalist control | GR00T N1.5/N1.7 | Hợp với deployment và acceleration path |
| World-action/dynamics | FastWAM, DiT4DiT | Mạnh trên benchmark nhưng nặng hơn |
| So sánh open-source baseline | OpenVLA | Baseline 7B phổ biến |
Bạn có thể đọc thêm SmolVLA training trên consumer GPU và Pi0-FAST training để hiểu trade-off giữa model nhỏ, action tokenizer và continuous control.

Training: chạy local trước, scale sau
Đừng bắt đầu bằng cluster. Hãy chạy smoke test 1 GPU hoặc 2 GPU để chắc chắn dataset path, checkpoint path, statistics và config đều đúng. Ví dụ Pi0.5 trên LIBERO-10:
export WANDB_MODE=disabled
torchrun --standalone --nnodes 1 --nproc-per-node 2 scripts/train.py \
  --config configs/pi05/pi05_paligemma_libero_10_full_finetune.py \
  --work-dir ./work_dirs/pi05_paligemma_libero_10_full_finetune \
  --cfg-options train_dataloader.per_device_batch_size=2
Với RoboCasa GR00T smoke training, repo có ví dụ chạy 2 step để kiểm tra end-to-end:
WANDB_MODE=disabled TOKENIZERS_PARALLELISM=false \
torchrun --standalone --nnodes 1 --nproc-per-node 1 scripts/train.py \
  --config configs/gr00tn15/gr00tn15_eagle_3b_robocasa_30_eps_full_finetune.py \
  --work-dir work_dirs/smoke_groot_robocasa_train \
  --cfg-options \
    runner.type=FSDPTrainRunner \
    runner.sharding_strategy=no-shard \
    train_dataloader.per_device_batch_size=1 \
    runner.enable_gradient_checkpointing=False \
    runner.max_steps=2 \
    runner.save_iter_interval=1 \
    runner.max_keep_ckpts=2 \
    "runner.metric.active_trackers=('jsonl',)"
Khi local ổn, chuyển sang script cluster:
export WANDB_MODE=disabled
bash scripts/train.sh [CONFIG] [WORK_DIR] \
  --cfg-options \
    train_dataloader.per_device_batch_size=[PER_DEVICE_BATCH_SIZE] \
    train_dataloader.batch_size=[GLOBAL_BATCH_SIZE] \
    runner.max_steps=[MAX_STEPS] \
    runner.save_interval=[SAVE_INTERVAL] \
    runner.max_keep_ckpts=[MAX_KEEP_CKPTS] \
  --eval-after-train
--eval-after-train là một điểm hay: checkpoint vừa train xong được đưa sang evaluator định nghĩa trong cùng config. Như vậy bạn giảm rủi ro dùng nhầm checkpoint, nhầm preprocessing hoặc nhầm evaluation protocol.
Nếu training bị dừng, resume:
bash scripts/train.sh [CONFIG] [WORK_DIR] \
  --resume-from [CHECKPOINT_PATH] \
  --cfg-options runner.max_steps=[MAX_STEPS]
Evaluation: đừng chỉ nhìn loss
VLA manipulation phải đo closed-loop success. Loss thấp không đảm bảo robot biết recovery khi cube bị lệch, camera bị occlude hoặc gripper chạm vật sớm hơn demonstration. FluxVLA hỗ trợ LIBERO và RoboCasa, đồng thời lưu rollout artifact để audit.
Local eval Pi0.5:
export WANDB_MODE=disabled
torchrun --standalone --nnodes 1 --nproc-per-node 2 scripts/eval.py \
  --config configs/pi05/pi05_paligemma_libero_10_full_finetune.py \
  --ckpt-path checkpoints/pi05_paligemma_libero_10_full_finetune_bs64/checkpoints/step-028548-epoch-18-loss=0.0111.safetensors
RoboCasa GR00T eval:
MUJOCO_GL=egl WANDB_MODE=disabled TOKENIZERS_PARALLELISM=false \
PYTHONHASHSEED=7 \
torchrun --standalone --nnodes 1 --nproc-per-node 1 scripts/eval.py \
  --config configs/gr00tn15/gr00tn15_eagle_3b_robocasa_30_eps_full_finetune.py \
  --ckpt-path work_dirs/gr00t_eagle_3b_robocasa_gr1_24x30_finetune_bs64/checkpoints/step-010000.safetensors \
  --cfg-options \
    eval.norm_stats_path=work_dirs/official_groot_gr1_dataset_statistics.json \
    eval.output_dir=work_dirs/gr00t_eagle_3b_robocasa_eval \
    eval.num_trials_per_task=50 \
    eval.seed=7
Theo paper, LIBERO report gồm nhiều integration: SmolVLA đạt average 84.70%, GR00T N1.5 đạt 95.30%, Pi0 đạt 96.85%, Pi0.5 đạt 97.95%, FastWAM-Joint đạt 98.35%, DiT4DiT đạt 98.65%. Với RoboCasa GR-1, kết quả khó hơn rõ rệt: Pi0.5 full data đạt 51.42%, DiT4DiT đạt 57.25%, trong khi SmolVLA chỉ 8.75%. Paper nhấn mạnh đây không phải controlled leaderboard vì budget, pretraining và protocol khác nhau. Khi dùng cho team của bạn, hãy freeze checkpoint, simulator version, random seed, action horizon và trial count trước khi so sánh.
Inference acceleration, RTC và trajectory post-processing
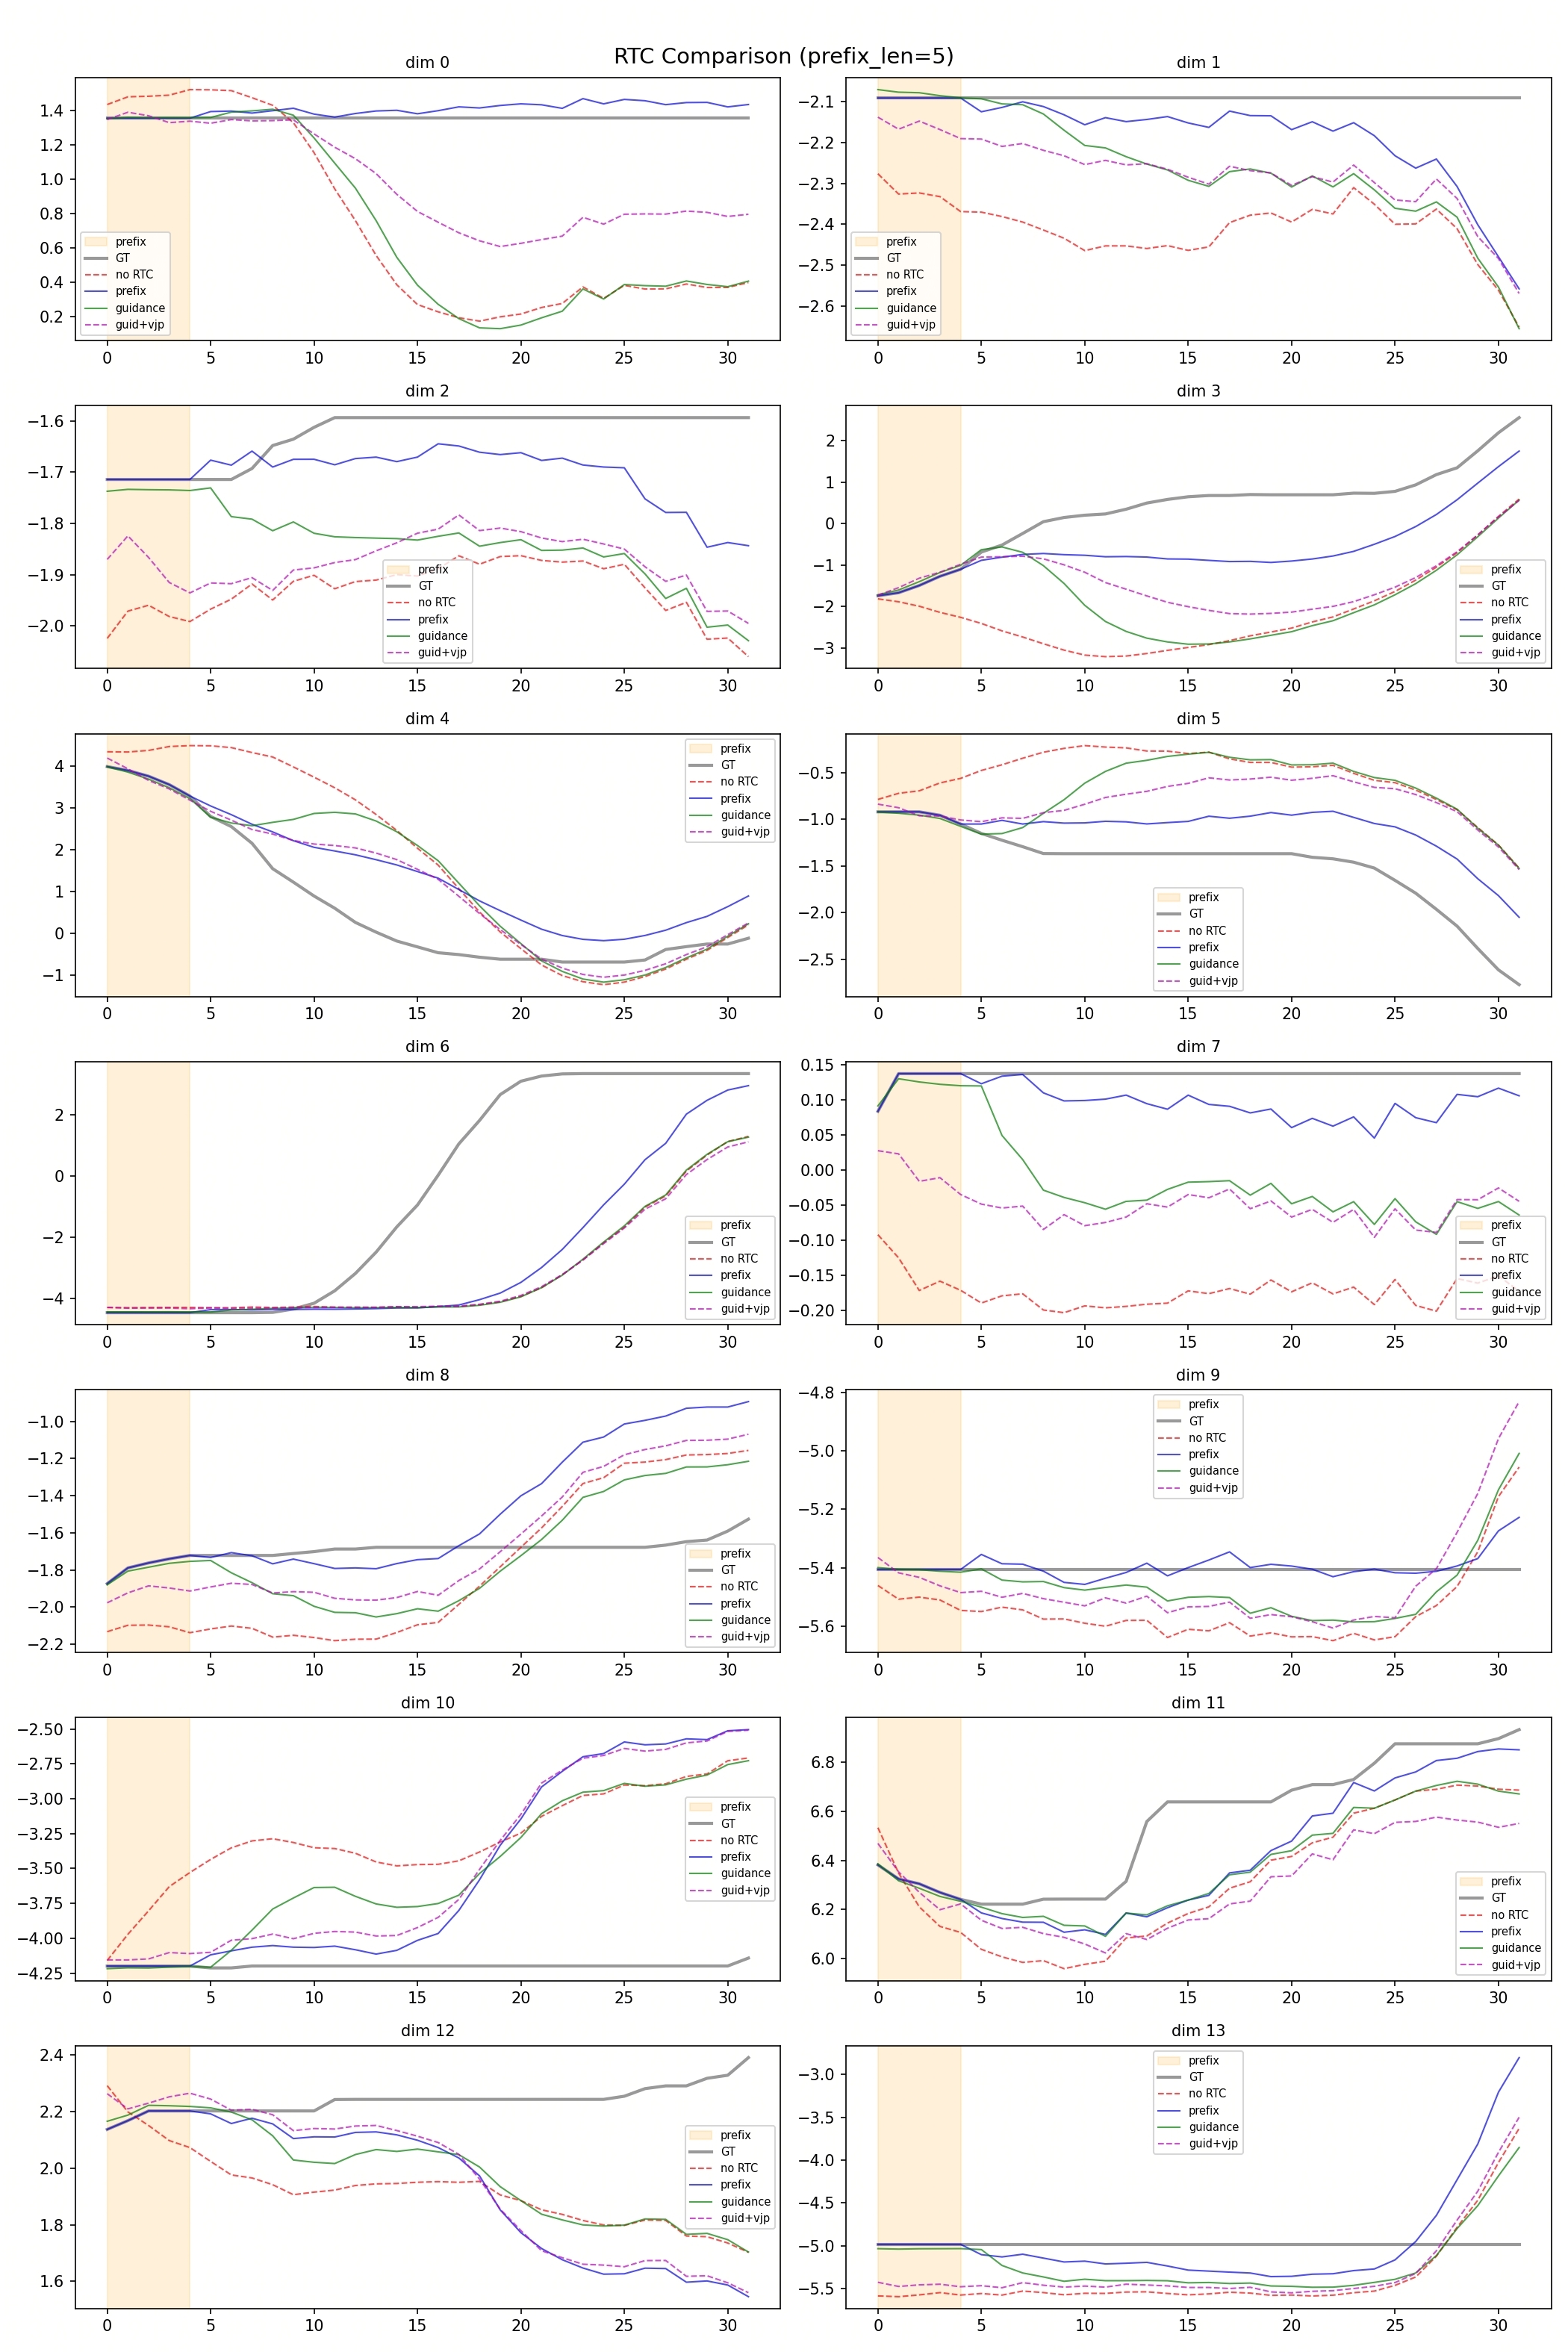
Điểm khiến FluxVLA khác một training framework thông thường là nó coi runtime là phần của platform. Với action-chunking policy, model thường sinh ra một chunk 16-50 bước. Robot vẫn đang chạy chunk cũ khi model predict chunk mới. Nếu hai chunk không khớp ở boundary, robot giật, gripper lệch, hoặc controller reject command.
FluxVLA tích hợp RTC (Real-Time Chunking) để giảm discontinuity giữa chunk đang execute và chunk sắp tới. Với policy hỗ trợ Training-time RTC, inference có thể condition trực tiếp trên action prefix đã commit. Sau đó trajectory post-processing như joint MPC hoặc Ruckig filter chỉnh command để mượt hơn và tôn trọng motion bounds.
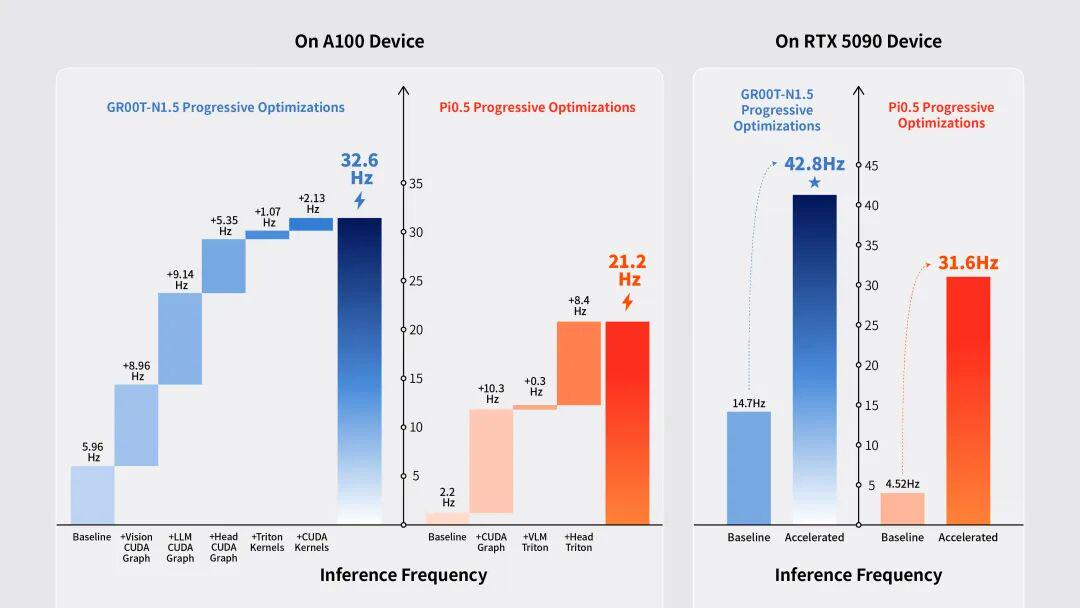
Paper báo inference acceleration dùng Triton fused kernels, CUDA Graph replay và custom CUDA operators. Một vài số đáng chú ý: trên A100, GR00T tăng từ 5.96 Hz lên 32.6 Hz; Pi0.5 tăng từ 2.20 Hz lên 21.2 Hz. Trên RTX 5090, GR00T + RTC tăng từ 15.0 Hz lên 47.6 Hz. Đây là model execution frequency, không phải end-to-end robot control rate, nhưng vẫn cực kỳ quan trọng vì nó quyết định robot có đủ action chunk mới trước khi chunk cũ hết hạn hay không.
Deploy lên robot thật
Đường deploy tối thiểu gồm bốn bước.
Bước 1: cài môi trường robot-side. Nếu robot chỉ có Jetson/mini PC, bạn có thể chạy model nhỏ local hoặc dùng remote GPU serving. Nếu dùng ROS Noetic, source ROS trước khi inference. Nếu dùng SDK riêng, bạn cần operator translate observation/action đúng config.
Bước 2: kiểm tra observation contract. Camera resolution, camera name, proprioception vector, gripper range và timestamp phải giống training. Một lỗi kinh điển là training dùng [front, wrist] nhưng deploy gửi [wrist, front].
Bước 3: chạy inference script.
python scripts/inference_real_robot.py \
  --config [CONFIG] \
  -- ckpt-path [CKPT_PATH]
Lưu ý README hiện ghi -- ckpt-path có dấu cách sau --. Nếu CLI trong version bạn dùng yêu cầu --ckpt-path, hãy theo python scripts/inference_real_robot.py --help. Quan trọng hơn syntax là config phải chứa đúng inference.denormalize_action, robot operator và action execution mode.
Bước 4: bật safety trước speed. Giới hạn workspace, velocity, acceleration, gripper force, e-stop và timeout. Với manipulation, đừng để policy command trực tiếp vào low-level torque controller nếu chưa có safety layer. Bắt đầu bằng joint position hoặc eepose command có clamp.
Real-robot results trong paper cho thấy deployment path đã được kiểm chứng trên ALOHA và Oli. Trên ALOHA benchmark 5 task, GR00T N1.5 đạt 36/110 trial thành công (32.73%), Pi0.5 đạt 70/110 (63.64%). Trên Oli, Pi0.5 tốt hơn ở candy picking và full box transport, còn GR00T N1.5 tốt hơn ở basket-and-toy picking. Điều này nhắc lại một bài học quan trọng: deployment engine giúp chuẩn hóa đường chạy, nhưng policy choice vẫn phụ thuộc task, embodiment và data.
Công thức triển khai cho lab nhỏ
Nếu bạn là team nhỏ muốn đi từ LeRobot đến robot thật, hãy đi theo lộ trình này:
- Dùng LeRobot collect 50-100 episode cho một task đơn giản, ví dụ pick cube vào khay.
- Convert/giữ dataset theo LeRobot v2.1 hoặc v3.x, kiểm tra video metadata.
- Chạy FluxVLA với SmolVLA hoặc Pi0.5 config gần nhất, batch nhỏ,
WANDB_MODE=disabled. - Eval trong LIBERO/RoboCasa nếu task tương ứng, hoặc tạo simulator wrapper tối thiểu.
- Chạy inference dry-run: policy nhận observation thật nhưng command bị chặn, chỉ log action.
- Bật robot với speed thấp, workspace clamp và e-stop vật lý.
- Lưu failure rollout, human correction và reward/progress annotation để train vòng tiếp theo.
Khi scale lên task dài hơn, cân nhắc ARM/SARM reward modeling hoặc DAgger-style correction. FluxVLA đã có đường ARM/SARM trên LeRobot v2.1/v3.x datasets, và paper báo companion ARM workflow nâng success towel-folding từ behavior cloning 62.1% lên AW-BC 99.4% trong một thiết lập AgileX ALOHA 8-stage. Con số này nên đọc theo đúng provenance của paper, nhưng nó cho thấy hệ thống không dừng ở supervised cloning.
Những lỗi beginner nên tránh
Đừng train bằng một action representation rồi deploy bằng representation khác. Delta joint, absolute joint, eepose và gripper normalized range không thay thế nhau được.
Đừng so sánh model bằng checkpoint lấy từ nhiều source nếu simulator seed, trial count và evaluation budget khác nhau. FluxVLA giúp chạy chung evaluator, nhưng bạn vẫn phải freeze protocol.
Đừng bỏ qua latency. Nếu model chạy 3 Hz nhưng robot cần command mượt ở 30 Hz, bạn cần action chunking, RTC, post-processing hoặc remote GPU tốt hơn.
Đừng coi image:, camera inline hoặc visualization là trang trí. Với robotics, media kỹ thuật giúp người đọc audit pipeline. Trong bài này, toàn bộ ảnh lấy từ paper/repo FluxVLA và đã verify HTTP 200 với Content-Type: image/png.
Nguồn tham khảo
- Paper: FluxVLA Engine: A One-Stop VLA Engineering Platform for Embodied Intelligence
- Repo: FluxVLA/FluxVLA
- Model hub: limxdynamics/FluxVLAEngine
- Product page: FluxVLA Engine by LimX Dynamics