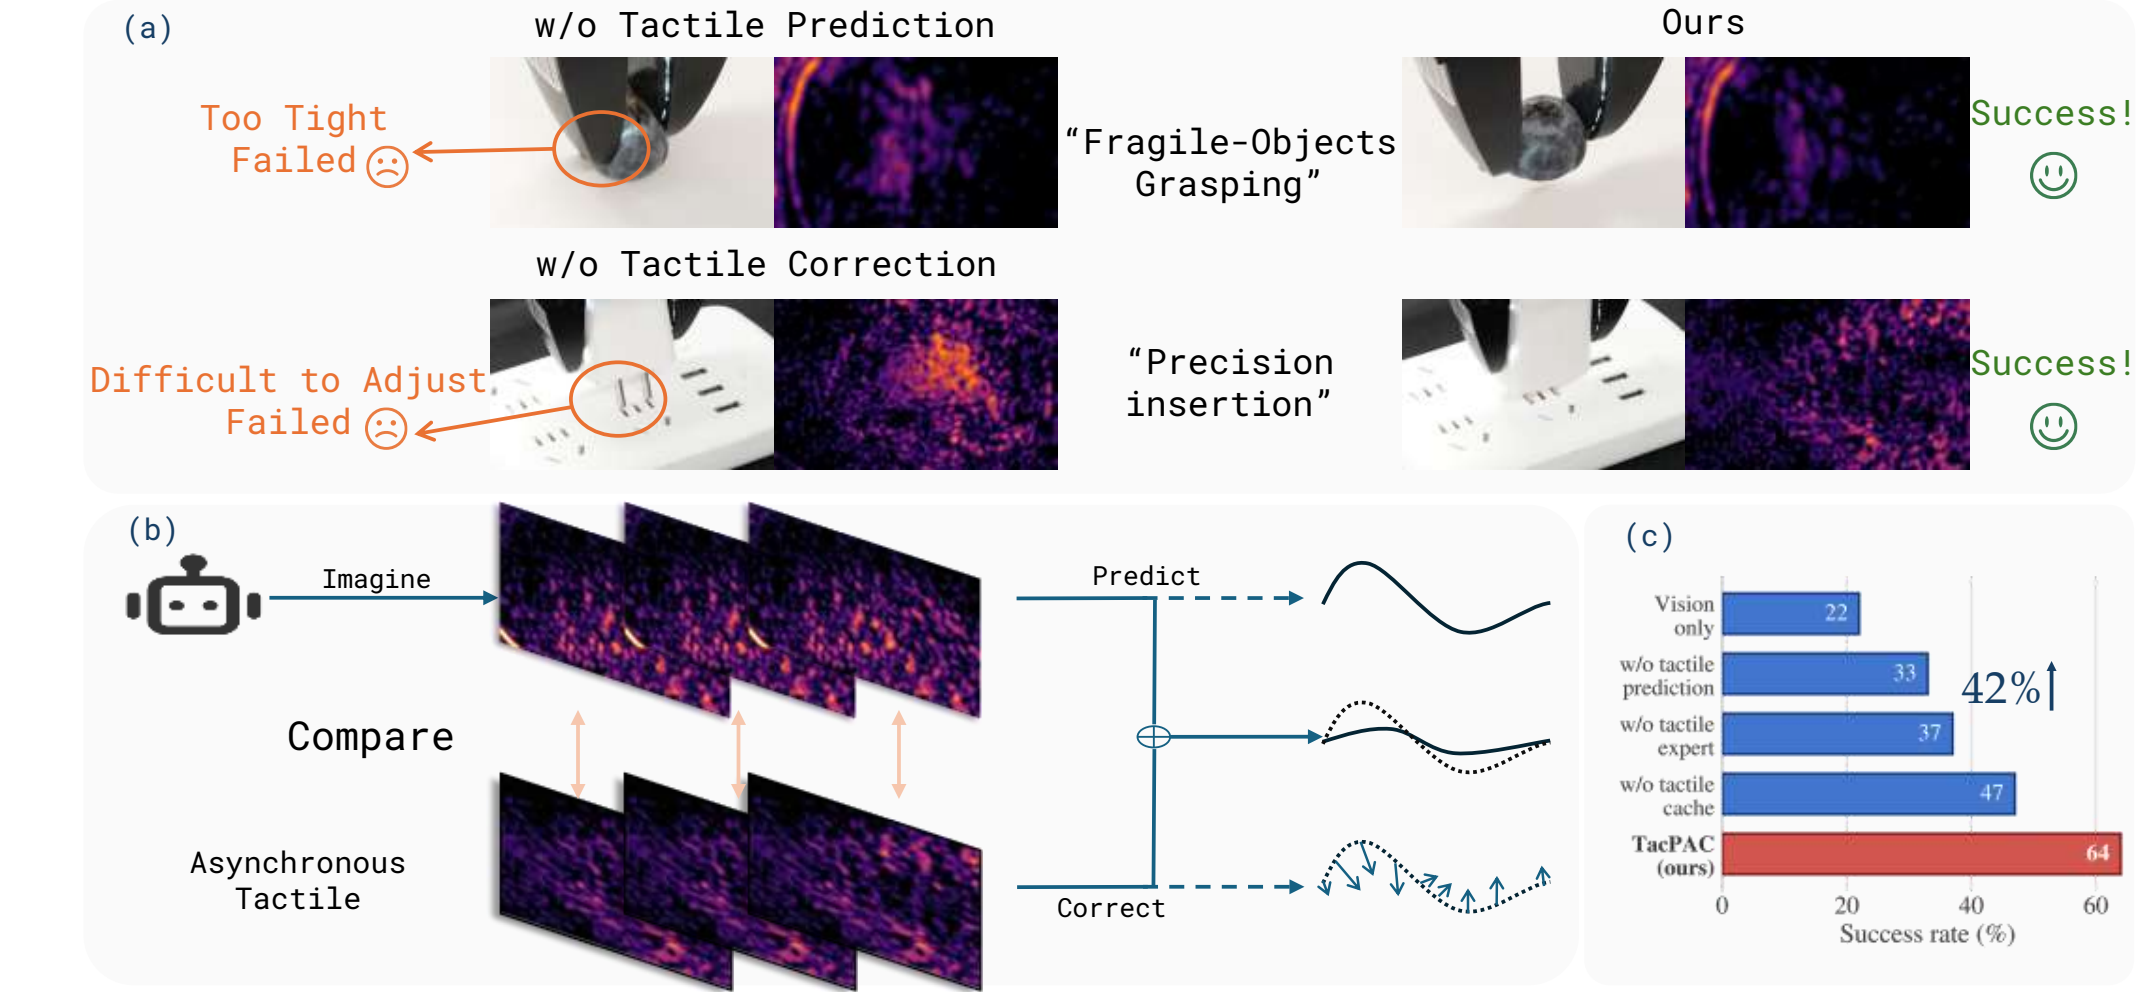
TacPAC là một paper rất đáng chú ý cho những ai đang train VLA hoặc action-chunking policy cho manipulation thật. Bài toán của nó nghe quen thuộc: robot nhìn thấy scene, model sinh một action chunk dài, rồi controller chạy chunk đó trên robot. Cách này giúp motion mượt hơn so với dự đoán từng step, nhưng lại có một nhược điểm lớn ở các task giàu tiếp xúc: khi robot đã chạm vật, thông tin quan trọng nhất không còn nằm trong ảnh RGB nữa mà nằm trong tactile feedback.
Paper gốc, TacPAC: Tactile Prediction and Real-Time Action Correction in World-Action Models for Contact-Rich Manipulation, do Zipei Ma, Xiaofei Wei, Junzhe Jiang, Shunlin Lu và Li Zhang công bố trên arXiv ngày 04/09/2026. Repo chính thức là LogosRoboticsGroup/TacPAC, MIT License, có code model, preprocessing, training, inference server và unit tests. Dữ liệu và checkpoint trong paper đang được nhóm tác giả chuẩn bị public, nên bài này sẽ hướng dẫn cách đọc kiến trúc, cài môi trường, chuẩn bị dataset LeRobot của bạn, train hai stage và chạy inference kiểu prepare/refine.
Nếu bạn mới bắt đầu với VLA, nên đọc trước VLA models trong robotics và Diffusion Policy action chunking. Nếu bạn đang quan tâm tactile manipulation, bài nền Tactile Sensing cho Manipulation sẽ giúp hiểu vì sao camera thường thua tactile ở pha đã tiếp xúc.
Vấn đề TacPAC giải quyết
Một VLA hoặc world-action model thường nhận observation hiện tại, language instruction và proprioception, rồi sinh một đoạn hành động a_t ... a_{t+H-1}. Với TacPAC, horizon H=48, lệnh phát ở 30 Hz, nghĩa là một chunk bao phủ khoảng 1.6 giây. Trong 1.6 giây đó, rất nhiều thứ có thể xảy ra: plug chạm mép ổ cắm, card lệch khe PCIe, vỏ chai trượt trong gripper, hoặc potato chip bắt đầu biến dạng.
Vision vẫn cần thiết để định vị scene và lập kế hoạch thô. Nhưng khi contact bắt đầu, ảnh RGB thường không thấy được áp lực, trượt vi mô, biến dạng bề mặt hoặc sai lệch vài millimeter bên trong khe cắm. Tactile sensor thì thấy những tín hiệu này rất rõ, nhưng nếu bạn chỉ đưa tactile hiện tại vào policy như một input phụ, model vẫn thiếu một câu hỏi quan trọng: contact hiện tại có đúng với contact mà plan đã kỳ vọng không?
TacPAC trả lời bằng một ý tưởng đơn giản nhưng mạnh: trong lúc model sinh action chunk, nó cũng dự đoán future tactile observations. Sau đó, khi robot thực thi, tactile expert đọc tactile image mới và so sánh nó với tactile prediction đã cache. Nếu tactile thật lệch khỏi tactile kỳ vọng, expert sinh delta action để sửa phần suffix của action chunk chưa được chạy. Đây là khác biệt lớn so với tactile prediction thuần túy: dự đoán xúc giác không chỉ là auxiliary loss, mà trở thành mốc tham chiếu cho closed-loop correction.
Ý tưởng paper trong một sơ đồ
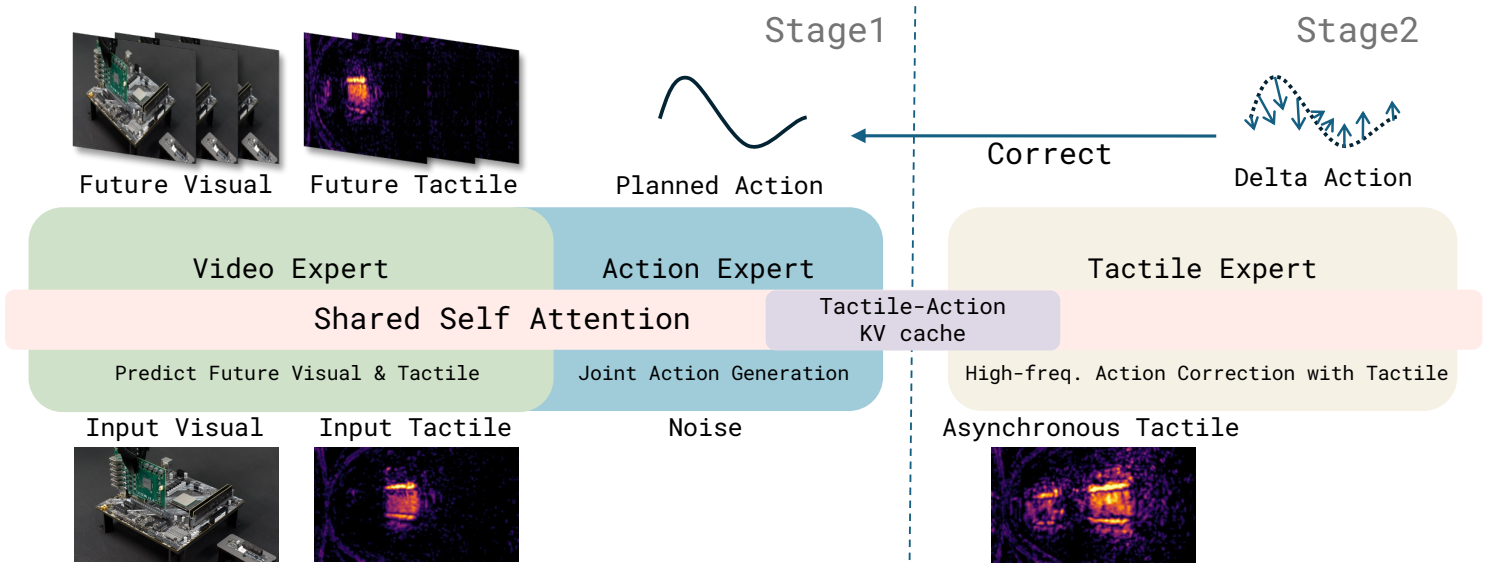
TacPAC gồm ba phần:
| Thành phần | Vai trò |
|---|---|
| Video expert | Dự đoán future visual và tactile observations trong latent space |
| Action expert | Sinh action chunk bằng flow matching, có attention tới prediction |
| Tactile expert | Nhận tactile image mới, đọc layer-wise cache và sửa action suffix |
Base model là một tactile-predictive world-action model. Thay vì chỉ dự đoán ảnh tương lai, nó dự đoán cả visual view và tactile view. Action expert không chạy độc lập; nó sinh action chunk trong khi attention tới future observations do video expert tạo. Vì vậy action chunk đã được condition bởi một "kỳ vọng tiếp xúc": nếu đi theo plan này thì tactile sẽ trông như thế nào.
Sau khi chunk được tạo, TacPAC chạy thêm một clean pass để tạo layer-wise tactile-action KV cache. Cache này chứa predicted tactile contact và representation của action plan. Khi robot đang chạy chunk, mỗi tactile frame mới được gửi vào tactile expert. Expert không phải regenerate toàn bộ chunk. Nó chỉ forward một lần qua cache, xuất ra Delta a cho những action chưa thực thi. Nếu robot đã chạy m step của chunk, correction chỉ được viết vào đoạn m ... H-1, tức phần tương lai còn lại.
Với người mới, bạn có thể hình dung TacPAC như một cơ chế "đọc lại lời hứa của plan". Base model nói: "khi tôi đẩy plug theo quỹ đạo này, cảm biến xúc giác sẽ thấy pattern A". Lúc chạy thật, tactile sensor thấy pattern B. Tactile expert hỏi: "B lệch A kiểu nào, và nên sửa những step tiếp theo ra sao?" Nhờ vậy feedback được hiểu trong ngữ cảnh của plan, không phải một tín hiệu rời rạc.
Vì sao tactile prediction alone chưa đủ?
Paper nhấn mạnh một điểm dễ bị hiểu sai: chỉ thêm future tactile prediction vào world-action model không đạt hết lợi ích. Trong ablation, model có tactile prediction nhưng không có tactile expert tăng trung bình từ 22% lên 37%. Tốt hơn vision-only, nhưng vẫn thấp hơn TacPAC đầy đủ ở 64%.
Lý do là timing mismatch. Future tactile prediction được tạo trước khi thực thi. Nhưng tactile feedback thật chỉ xuất hiện trong khi thực thi. Nếu prediction chỉ dùng để sinh chunk ban đầu, nó không thể phản ứng khi vật bị lệch, ma sát khác training data, hoặc contact đến sớm/muộn hơn dự kiến. TacPAC biến prediction thành reference cho runtime correction, nên tactile signal đến muộn vẫn có thể sửa kế hoạch.
Đây cũng là bài học quan trọng khi bạn tự thiết kế VLA stack. Auxiliary prediction rất hay cho representation learning, nhưng robot thật cần một đường runtime để prediction ảnh hưởng tới control. Nếu không có đường này, model có thể "biết" contact sắp xảy ra nhưng không có cơ chế cập nhật plan khi contact thật khác đi.
Kiến trúc chi tiết
TacPAC dựa trên Mixture-of-Transformers. Trong cấu hình paper, video, action và tactile experts cùng dùng 30 Transformer layers và attention geometry giống nhau, gồm 24 heads với head dimension 128. Video expert có hidden/feed-forward width 3072/14336, action expert và tactile expert là 1024/4096. Một linear bridge map output width 3072 của video frontend xuống width 1024 cho tactile expert.
Action mỗi step gồm 7-dimensional joint command cộng 1 gripper command. Joint command được biểu diễn relative so với joint configuration ở step đầu của chunk. Hệ dùng two RGB views và two tactile views trong setup Flexiv: observation.images.third_view, observation.images.left_wrist_view, observation.images.left_wrist_left_tactile, observation.images.left_wrist_right_tactile. Visual views được render ở 256x256, tactile views ở 128x128 trên shared canvas.
Tactile expert được initialize từ action expert. Điều này hợp lý vì cả hai đều xử lý action representation theo temporal layout giống nhau. Output head của tactile expert được zero-initialized, nên correction ban đầu là identity. Khi mới bắt đầu train Stage 2, model không phá plan của base model; nó học dần cách thêm residual correction.
Một chi tiết rất thực dụng là TacPAC dùng cache theo layer. Nếu không có cache, mỗi tactile update sẽ phải chạy lại action generation hoặc ít nhất reprocess nhiều token của plan. Với cache, tactile expert đọc lại các key/value đã có và chỉ tính phần correction. Paper đo được tactile correction 30.4 ms, tương đương 32.9 Hz, nhanh hơn 20.7 lần so với regenerate chunk 628.6 ms.
Cài đặt môi trường
Repo yêu cầu Python 3.10 trở lên và CUDA-capable PyTorch. Các package đáng chú ý gồm transformers==4.57.0, accelerate==1.12.0, deepspeed==0.16.9, lerobot==0.3.4, pyrealsense2, msgpack, pyzmq, websockets, diffusers, timm, opencv-python.
git clone [email protected]:LogosRoboticsGroup/TacPAC.git
cd TacPAC

conda create -n tacpac python=3.10 -y
conda activate tacpac

pip install -r requirements.txt
pip install flash-attn --no-build-isolation
pip install -e .
Sau đó bạn cần download Wan2.2 TI2V backbone và sửa path trong starVLA/config/training/vla/starvla_wam.yaml, đặc biệt là dit_path, vae_path, text_encoder_path và tokenizer_path. Nếu chỉ muốn đọc code hoặc chạy unit tests CPU, bạn có thể chưa cần đủ backbone/checkpoint. Nếu muốn train hoặc inference thật, thiếu backbone path sẽ lỗi ngay ở bước load model.
Vì dataset paper chưa nằm trong repo, bạn cần dùng dataset riêng theo LeRobot format. Đây không phải là điểm phụ; TacPAC phụ thuộc mạnh vào alignment giữa RGB, tactile, proprioception và action. Nếu timestamps lệch, tactile expert sẽ học correction sai pha.
Chuẩn bị data LeRobot
Một sample tối thiểu nên có:
observation.images.third_view
observation.images.left_wrist_view
observation.images.left_wrist_left_tactile
observation.images.left_wrist_right_tactile
observation.state
action
task
Trong starVLA/dataloader/vla/mixtures.py, bạn đăng ký local dataset path và video_keys. Repo tự xem những key chứa tactile là tactile views. Stage 2 cần sinh thêm tactile_now và tactile_offset; các offset này mô phỏng tình huống robot đã chạy một phần chunk rồi mới nhận tactile frame mới.
Trước khi train, hãy precompute text embeddings:
python scripts/vla/precompute_text_embeds.py \
  --config_yaml starVLA/config/training/vla/starvla_wam.yaml \
  --datasets.vla_data.data_mix flexiv_plug_4views \
  --datasets.vla_data.text_embedding_cache_dir data/text_embeds_cache/flexiv_plug_4views
Nếu bạn chưa có tactile sensor, đừng giả lập tactile bằng ảnh RGB crop và kỳ vọng model hoạt động như paper. TacPAC được thiết kế cho tactile images từ cảm biến như InTac S1 trong setup paper. Bạn vẫn có thể dùng simulator hoặc tactile sensor khác, nhưng cần đảm bảo representation consistent giữa train và inference. Repo có module preprocessing chung starVLA/dataloader/vla/tactile_stress.py để tránh một lỗi rất phổ biến: train dùng normalization kiểu này, server inference lại resize/normalize kiểu khác.
Training Stage 1: tactile-predictive WAM
Stage 1 train base model. Video expert dự đoán future visual/tactile observations, action expert denoise action chunk. Đây là phần tốn compute nhất vì model vừa học dynamics của scene vừa học mapping sang action. Script mặc định dùng 8 process:
NPROC_PER_NODE=8 bash scripts/vla/train_WanMoTJoint.sh \
  flexiv_plug_4views \
  stage1
Paper train cả hai stage trên một node 8 NVIDIA H100, global batch size 64, 10 epochs. Với lab nhỏ, bạn có thể bắt đầu bằng một task hẹp, ít camera hơn, batch nhỏ hơn và gradient accumulation. Điều quan trọng không phải đạt ngay con số paper, mà là chạy được một closed-loop pipeline ổn định: dataset đọc đúng, action shape đúng, tactile views đúng, loss giảm và rollout không bị lệch frame.
Khi debug Stage 1, hãy visualize ba thứ: future tactile prediction, action chunk và real tactile sau rollout. Nếu predicted tactile luôn mờ hoặc không đổi, model chưa học contact dynamics. Nếu action chunk mượt nhưng tactile prediction không ăn nhập với phase contact, Stage 2 sẽ thiếu reference tốt để sửa.
Training Stage 2: tactile expert
Stage 2 là phần làm TacPAC khác biệt. Base model, VAE, text encoder và proprioceptive encoder bị freeze. Chỉ tactile expert được train, learning rate cơ sở trong paper là 1e-4 với cosine schedule. Tactile expert nhận plan/cache từ Stage 1 và học residual correction cho suffix chưa chạy.
NPROC_PER_NODE=8 bash scripts/vla/train_WanMoTJoint-TacExpert.sh \
  flexiv_plug_4views \
  results/Checkpoints/vla/<stage1-run>/final_model/pytorch_model.pt
Mỗi frozen plan/prefill được dùng cho K=4 correction offsets. Nói đơn giản, từ một action chunk, training tạo nhiều câu hỏi: "nếu robot đã chạy tới offset này và tactile hiện tại như vậy, phần còn lại nên sửa thế nào?" Loss chỉ nên áp lên những action còn có thể sửa, không phạt các step đã thực thi.
Khi tự port TacPAC sang robot khác, bạn cần kiểm tra ba interface. Một là action dimension: paper dùng 7 joint command plus gripper, nhưng robot của bạn có thể là 6-DoF arm, dual-arm hoặc mobile manipulator. Hai là tactile geometry: sensor khác nhau sẽ có resolution, noise và contact pattern khác nhau. Ba là control frequency: nếu không chạy 30 Hz, horizon 48 sẽ không còn tương đương 1.6 giây, và offset/correction timing phải chỉnh lại.
Inference: prepare và refine
Inference server có protocol stateful:
CKPT=results/Checkpoints/vla/<tacpac-run>/final_model/pytorch_model.pt \
PORT=5556 \
bash deployment/local_infer-wan-tac.sh
Client gọi prepare để sinh action chunk mới và nhận plan_id. Server đồng thời build tactile-action cache cho plan đó. Trong lúc robot thực thi chunk, client liên tục gọi refine với tactile views mới, execution offset và executed action prefix. Server trả về action suffix đã được sửa.
Pseudo-flow:
plan = client.prepare(obs, instruction)
actions = plan["actions"]
plan_id = plan["plan_id"]

for m in range(len(actions)):
    execute(actions[m])

    if new_tactile_frame_ready():
        update = client.refine(
            plan_id=plan_id,
            tactile=read_tactile_views(),
            offset=m + 1,
            executed_prefix=actions[: m + 1],
        )
        actions[m + 1 :] = update["corrected_suffix"]
Điểm cần giữ trong production là correction không được ghi đè vào action đã đi qua deadline. Paper dùng cơ chế asynchronous: robot cứ chạy latest committed chunk, correction chỉ update unexecuted suffix. Vì tactile expert chỉ mất 30.4 ms, phần lớn correction quay lại trước step kế tiếp; paper báo chỉ 1.6% tactile-expert calls bị robot tiến thêm một hoặc nhiều control steps trong lúc tính.
Kết quả thực nghiệm
TacPAC được đánh giá trên năm task robot thật: charger-plug insertion, multi-object fruit transfer, fragile potato-chip transfer, empty-bottle uprighting và expansion-card insertion. Mỗi method-task có 20 trials. Setup dùng Flexiv Rizon 4, wrist-mounted Intel RealSense D405, third-person Intel RealSense D435i, gripper tích hợp hai InTac S1 tactile sensors.
| Variant | Plug | Fruit | Chip | Bottle | Card | Avg. |
|---|---|---|---|---|---|---|
| Vision only | 15 | 30 | 60 | 5 | 0 | 22 |
| Without tactile expert | 35 | 50 | 65 | 20 | 15 | 37 |
| Without tactile prediction | 40 | 25 | 45 | 30 | 25 | 33 |
| Without tactile cache | 40 | 50 | 75 | 40 | 30 | 47 |
| TacPAC | 80 | 65 | 90 | 40 | 45 | 64 |
Các baseline gồm pi0.5, ACT, VITaL, LingBot-VA, Dream-Tac và T-Rex. Paper báo TacPAC đứng đầu trên cả năm task, tăng average từ 22% của vision-only base model lên 64%, và hơn baseline mạnh nhất 16 điểm phần trăm. Hai task khó nhất là expansion-card insertion và empty-bottle uprighting; đây là nơi tactile correction có ý nghĩa rõ vì sai lệch nhỏ hoặc contact kín làm vision khó quan sát.
Checklist triển khai cho lab nhỏ
Nếu bạn muốn thử TacPAC trong lab, bắt đầu thật hẹp:
- Chọn một task có contact rõ, ví dụ cắm connector, đặt vật vào khe hoặc nhấc vật dễ trượt.
- Gắn tactile sensor ổn định trên gripper và log raw tactile image cùng timestamp.
- Thu LeRobot dataset với ít nhất hai RGB views, tactile left/right, proprioception và action.
- Verify alignment bằng cách replay: khi gripper chạm vật, tactile activity phải tăng đúng frame.
- Train Stage 1 trên một task trước, xem prediction có học contact phase không.
- Train Stage 2, kiểm tra correction suffix không tạo jerk và không sửa action đã execute.
- Chạy inference ở tốc độ thấp trước, rồi tăng dần lên control rate thật.
TacPAC không phải "thêm tactile vào VLA là xong". Giá trị của nó nằm ở contract rất rõ giữa plan, predicted contact, cache và runtime correction. Nếu contract này sai, model sẽ sửa sai. Nếu contract đúng, tactile trở thành feedback có ngữ cảnh, đủ nhanh để chỉnh action chunk trong lúc robot vẫn đang di chuyển.
Kết luận
TacPAC đưa tactile prediction từ vai trò phụ trợ sang vai trò điều khiển thật. Thay vì dự đoán future tactile rồi bỏ đó, nó cache tactile expectation của plan và dùng tactile expert để sửa phần action chunk chưa chạy. Với contact-rich manipulation, đây là hướng rất thực dụng: vision lập kế hoạch thô, world-action model tưởng tượng contact, tactile sensor kiểm chứng contact thật, và correction chạy nhanh hơn nhiều so với replanning.
Với các team đang train VLA trên LeRobot hoặc triển khai action chunk policy ngoài lab, TacPAC gợi ý một pattern quan trọng: đừng chỉ hỏi model "hành động tiếp theo là gì?", hãy hỏi thêm "contact mà plan kỳ vọng là gì, và tactile thật đang lệch khỏi kỳ vọng đó như thế nào?".