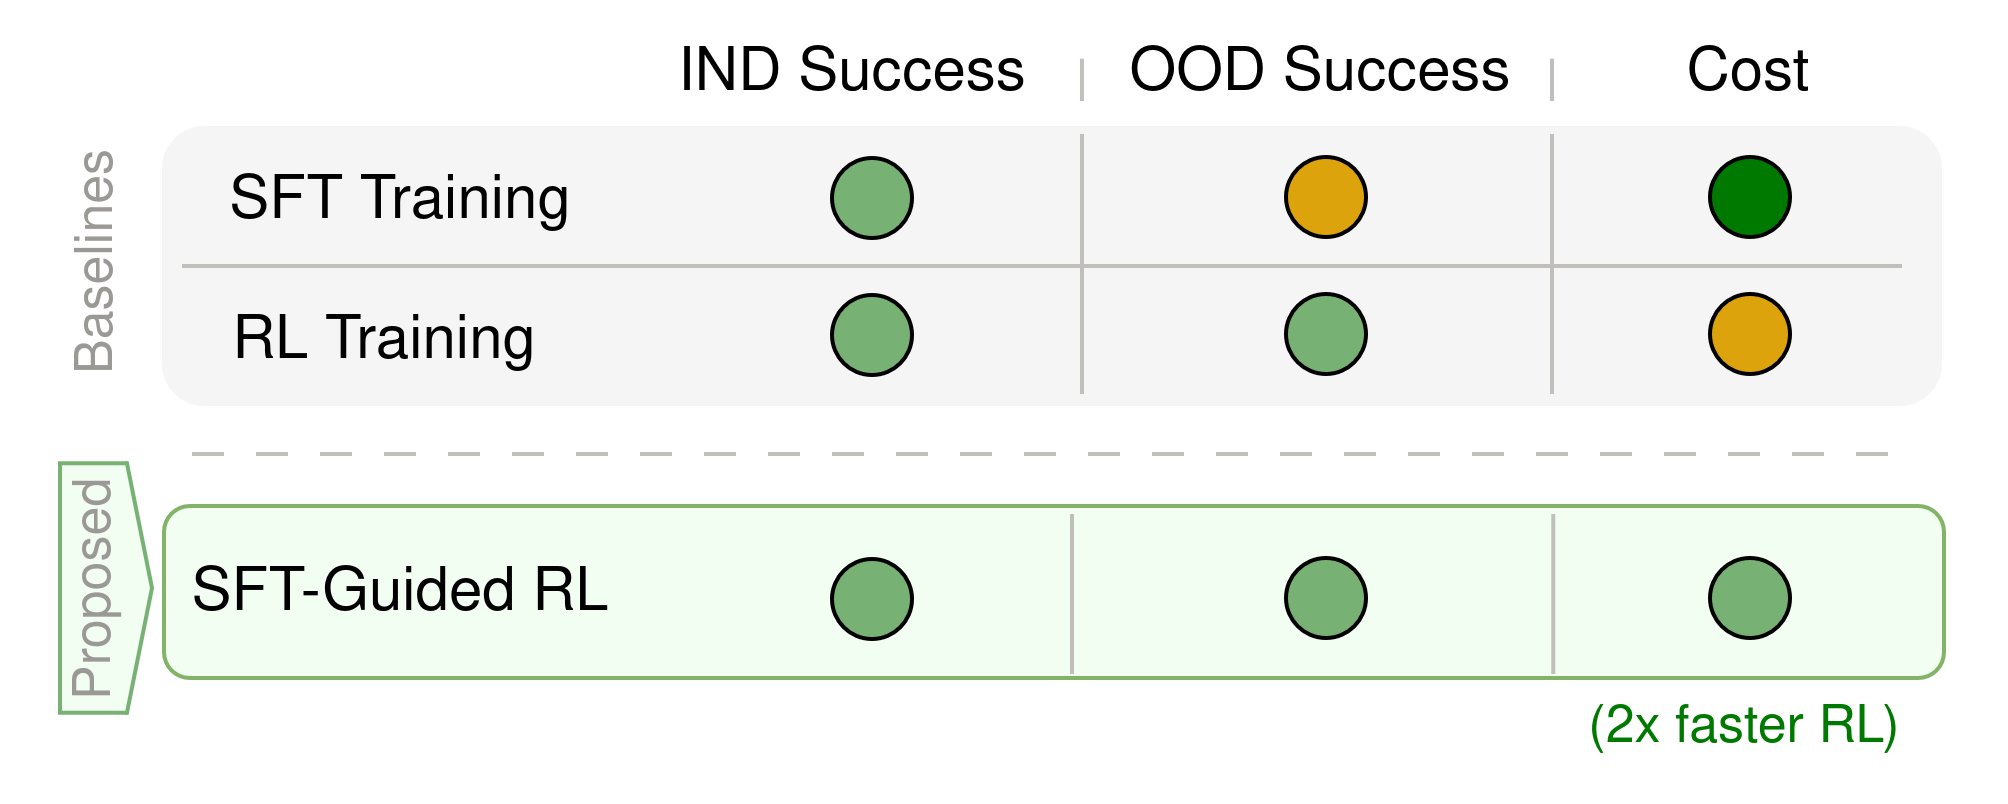
Offline Supervision VLA-RL: tận dụng demo offline để giảm 50% chi phí online RL
Online reinforcement learning là cách rất mạnh để cải thiện robot manipulation policy, nhưng cũng là phần đắt nhất trong toàn bộ pipeline VLA. Mỗi update PPO cần rollout trong môi trường, tính reward, reset episode, lưu trajectory, rồi mới cập nhật policy. Nếu bạn đang train trên simulation như ManiSkill/SimplerEnv, chi phí là GPU time và wall-clock time. Nếu bạn train trên robot thật, chi phí còn là hao mòn phần cứng, thời gian canh robot, rủi ro va chạm và số lần reset thủ công.
Paper "Leveraging Offline Supervision for Efficient and Generalizable Reinforcement Learning in Large-Scale Vision-Language-Action Models" của Dmitriy Poyarkov, Aleksei Staroverov và Aleksandr I. Panov, được nhận tại ICML 2026 workshop, đặt một câu hỏi rất thực dụng: nếu chúng ta đã có demonstration offline để supervised fine-tuning, liệu có thể tiếp tục dùng nó trong giai đoạn online RL để giảm số bước tương tác hay không?
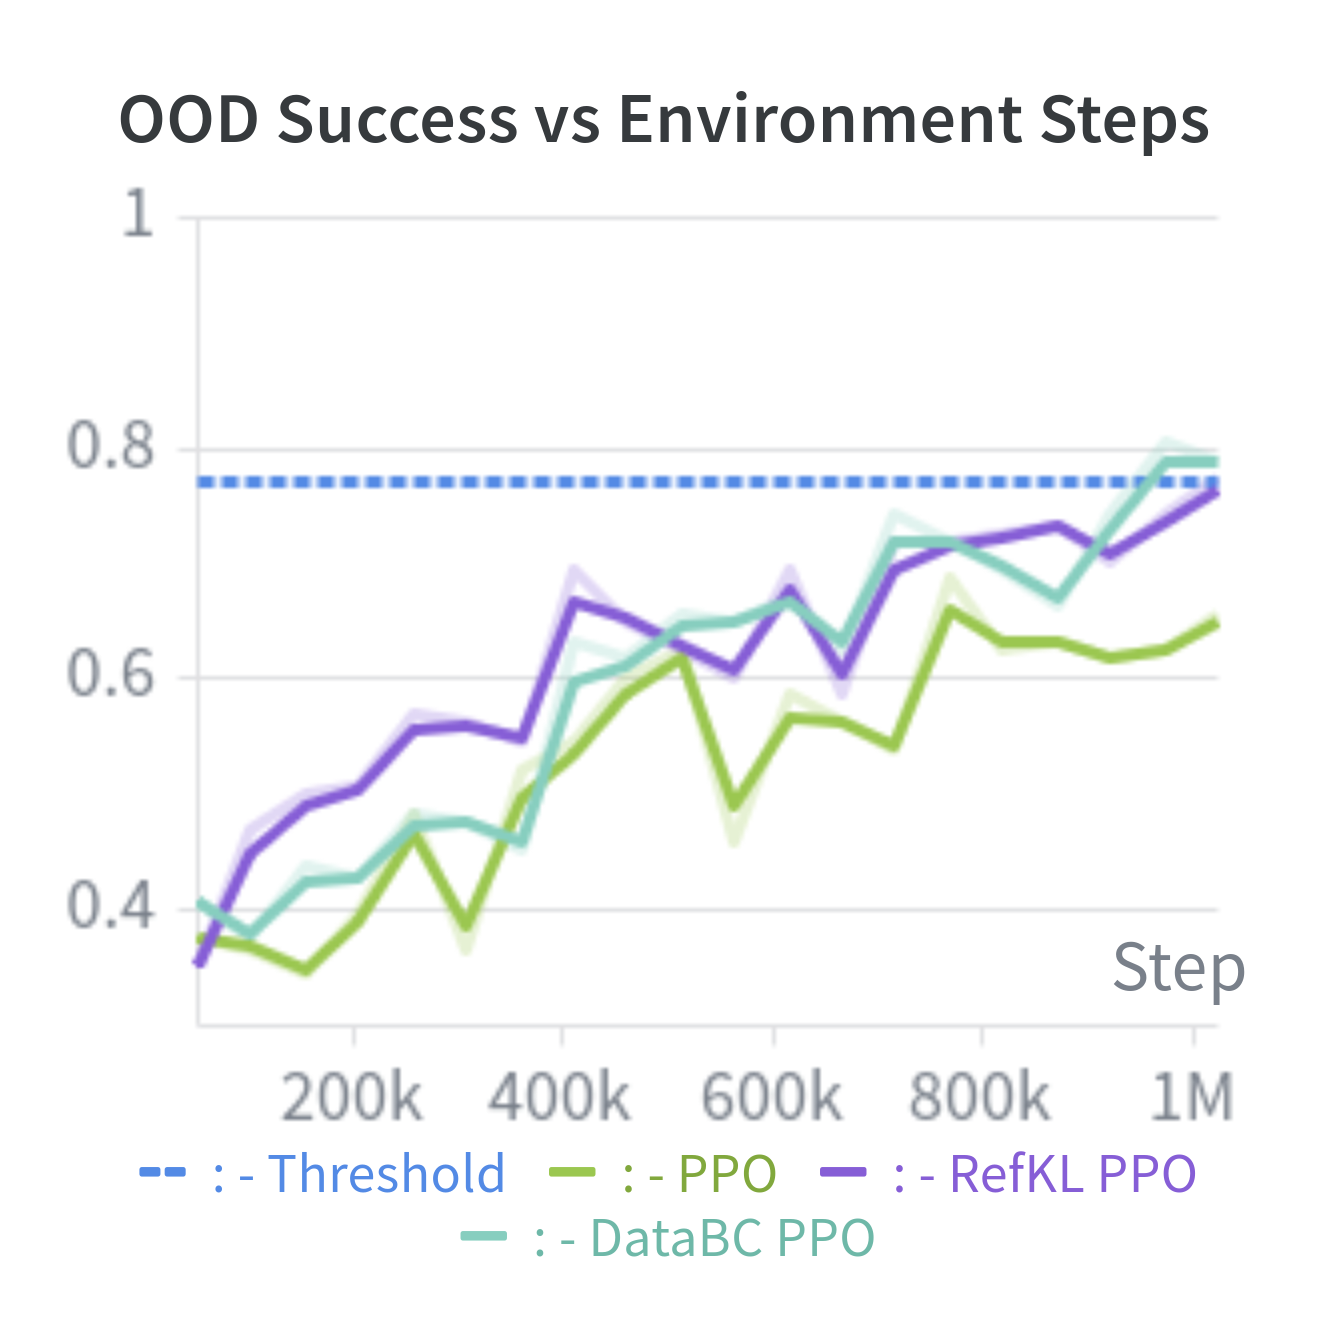
Câu trả lời của paper là có. Trên benchmark RL4VLA với OpenVLA LoRA, hai biến thể guided PPO là RefKL và DataBC đạt gần mức của PPO 2M environment steps chỉ với 1M steps. Nói cách khác, offline supervision không chỉ là "warm start"; nó là một optimization prior giúp PPO đi đúng hướng trong giai đoạn đầu, khi reward còn sparse và exploration còn yếu.
Nếu bạn đã đọc OpenVLA deep dive, VLA-RL scaling, hoặc SimpleVLA-RL training, bài này là lớp tiếp theo: không chỉ train policy bằng RL, mà còn tận dụng dữ liệu demo cũ để giảm online training budget.
Tóm tắt nhanh cho beginner
Hãy hình dung bạn dạy robot gắp vật đặt lên đĩa. Bạn có hai nguồn học:
| Nguồn tín hiệu | Điểm mạnh | Điểm yếu |
|---|---|---|
| Offline demonstrations | Rẻ, ổn định, dễ thu thập bằng teleop hoặc motion planner | Policy dễ kém khi gặp trạng thái lệch khỏi data |
| Online RL | Tự cải thiện nhờ reward và closed-loop feedback | Tốn interaction, dễ chậm lúc đầu |
Offline-only SFT giống như cho robot xem video mẫu và bắt chước. Online RL giống như cho robot tự luyện tập. Offline Supervision VLA-RL kết hợp cả hai: trong lúc robot tự luyện bằng PPO, ta vẫn giữ một "dây neo" từ dữ liệu offline hoặc từ SFT policy đã học dữ liệu đó.
Paper thử ba hướng:
- PPO SFT-init: train SFT trước, rồi dùng checkpoint SFT để khởi tạo PPO.
- RefKL: PPO nhưng thêm KL penalty để policy hiện tại không lệch quá nhanh khỏi frozen SFT reference policy.
- DataBC: PPO nhưng thêm behavior cloning loss trực tiếp trên offline demonstration batch.
Kết quả quan trọng: PPO SFT-init tốt hơn PPO thường ở cùng 1M steps, nhưng vẫn thua RefKL và DataBC. Điều này nói rằng initialization chưa đủ. Offline signal cần tồn tại trong objective RL, ít nhất ở giai đoạn đầu.
Paper gốc và repo
Nguồn chính bạn nên mở khi reproduce:
- Project page: alstar8.github.io/offline-supervision-vla-rl
- arXiv: arXiv:2607.19399
- GitHub repo: alstar8/offline-supervision-vla-rl
Repo triển khai hybrid offline-online RL fine-tuning cho OpenVLA LoRA trên RL4VLA benchmark. Nó chứa các thư mục ManiSkill, SimplerEnv, openvla, real2sim, sim2real và scripts. Nếu bạn từng chạy OpenVLA hoặc SimplerEnv, cấu trúc này khá quen: model nằm trong openvla, environment và RL loop nằm quanh ManiSkill/SimplerEnv, còn script launch experiment nằm trong scripts.
Bài toán: RL cho VLA manipulation
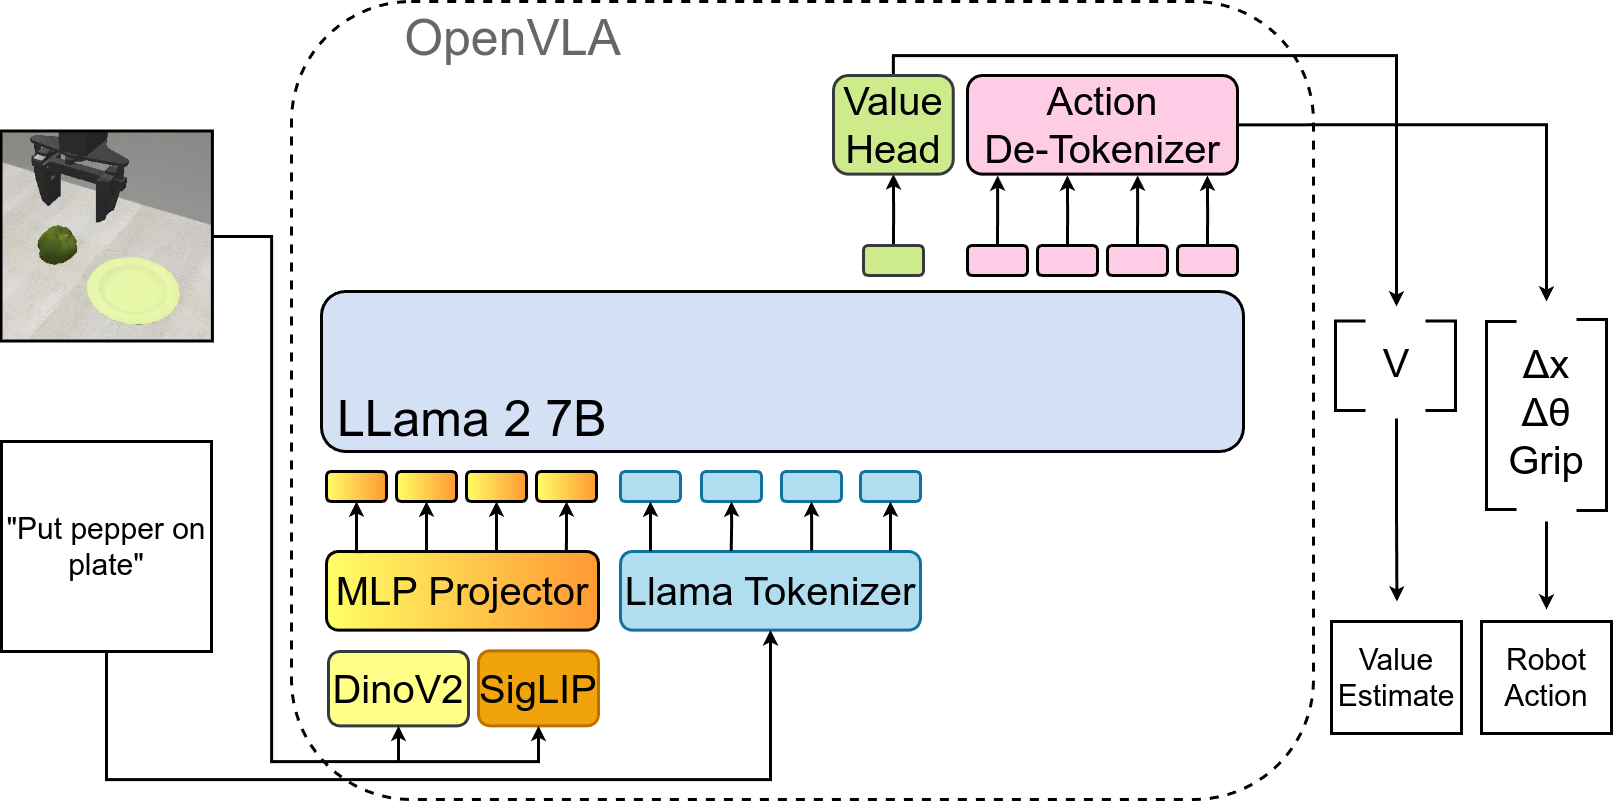
Paper mô hình hóa robot control như một partially observable Markov decision process. Ở mỗi timestep, policy nhận:
- ảnh RGB hiện tại
I_t; - instruction ngôn ngữ tự nhiên
l, ví dụ "put the carrot on the plate"; - trạng thái thật của môi trường không được quan sát trực tiếp.
Policy xuất ra tokenized actions u_t. Environment wrapper chuyển token đó thành robot command a_t. Episode có horizon cố định T = 80, reward là sparse difference-based reward dựa trên tiến triển task, chứ không phải dense reward dễ tối ưu.
Backbone là OpenVLA-warmup. Base model được giữ frozen, còn phần được train là LoRA adapter rank 32. Khi chạy RL, hệ thống thêm value head theo RL4VLA để PPO có thể ước lượng advantage. Task chính là PutOnPlateInScene25Main-v3: robot cần đặt vật lên đĩa trong scene mô phỏng.
Điểm cần nhớ cho beginner: VLA ở đây không được train full model 7B từ đầu. Paper đang nghiên cứu parameter-efficient adaptation. Điều này rất quan trọng vì nếu bạn train full backbone, chi phí, stability và catastrophic forgetting sẽ khác hẳn.
Ý tưởng chính: offline supervision là prior trong PPO
PPO tiêu chuẩn cập nhật policy dựa trên ratio giữa policy mới và policy cũ:
r_t(theta) = pi_theta(a_t | o_t) / pi_theta_old(a_t | o_t)
Rồi dùng clipped objective để tránh update quá lớn. Vấn đề là ở robot manipulation, reward thường sparse. Giai đoạn đầu của PPO có thể rất "mù": policy chưa biết hành động nào gần đúng, còn reward thành công hiếm. Nếu chỉ dựa vào on-policy rollout, robot mất nhiều bước để học action structure cơ bản.
Offline Supervision VLA-RL thêm một auxiliary loss vào PPO:
L(theta) = L_PPO(theta) + beta * L_aux(theta)
Trong đó L_aux có hai cách định nghĩa:
L_RefKL: ép policy hiện tại giữ phân phối hành động gần frozen SFT reference policy.L_DataBC: ép policy hiện tại vẫn bắt chước action trong offline demonstrations.
beta không cố định mãi. Paper dùng curriculum: giữ beta = beta_0 trong 100k steps đầu, linearly decay về 0 trong 200k steps tiếp theo, rồi sau 300k steps trở thành pure PPO. Nói nôm na: lúc đầu để demo dẫn đường, sau đó tháo bánh phụ ra để RL tự tối ưu.
RefKL hoạt động như thế nào?
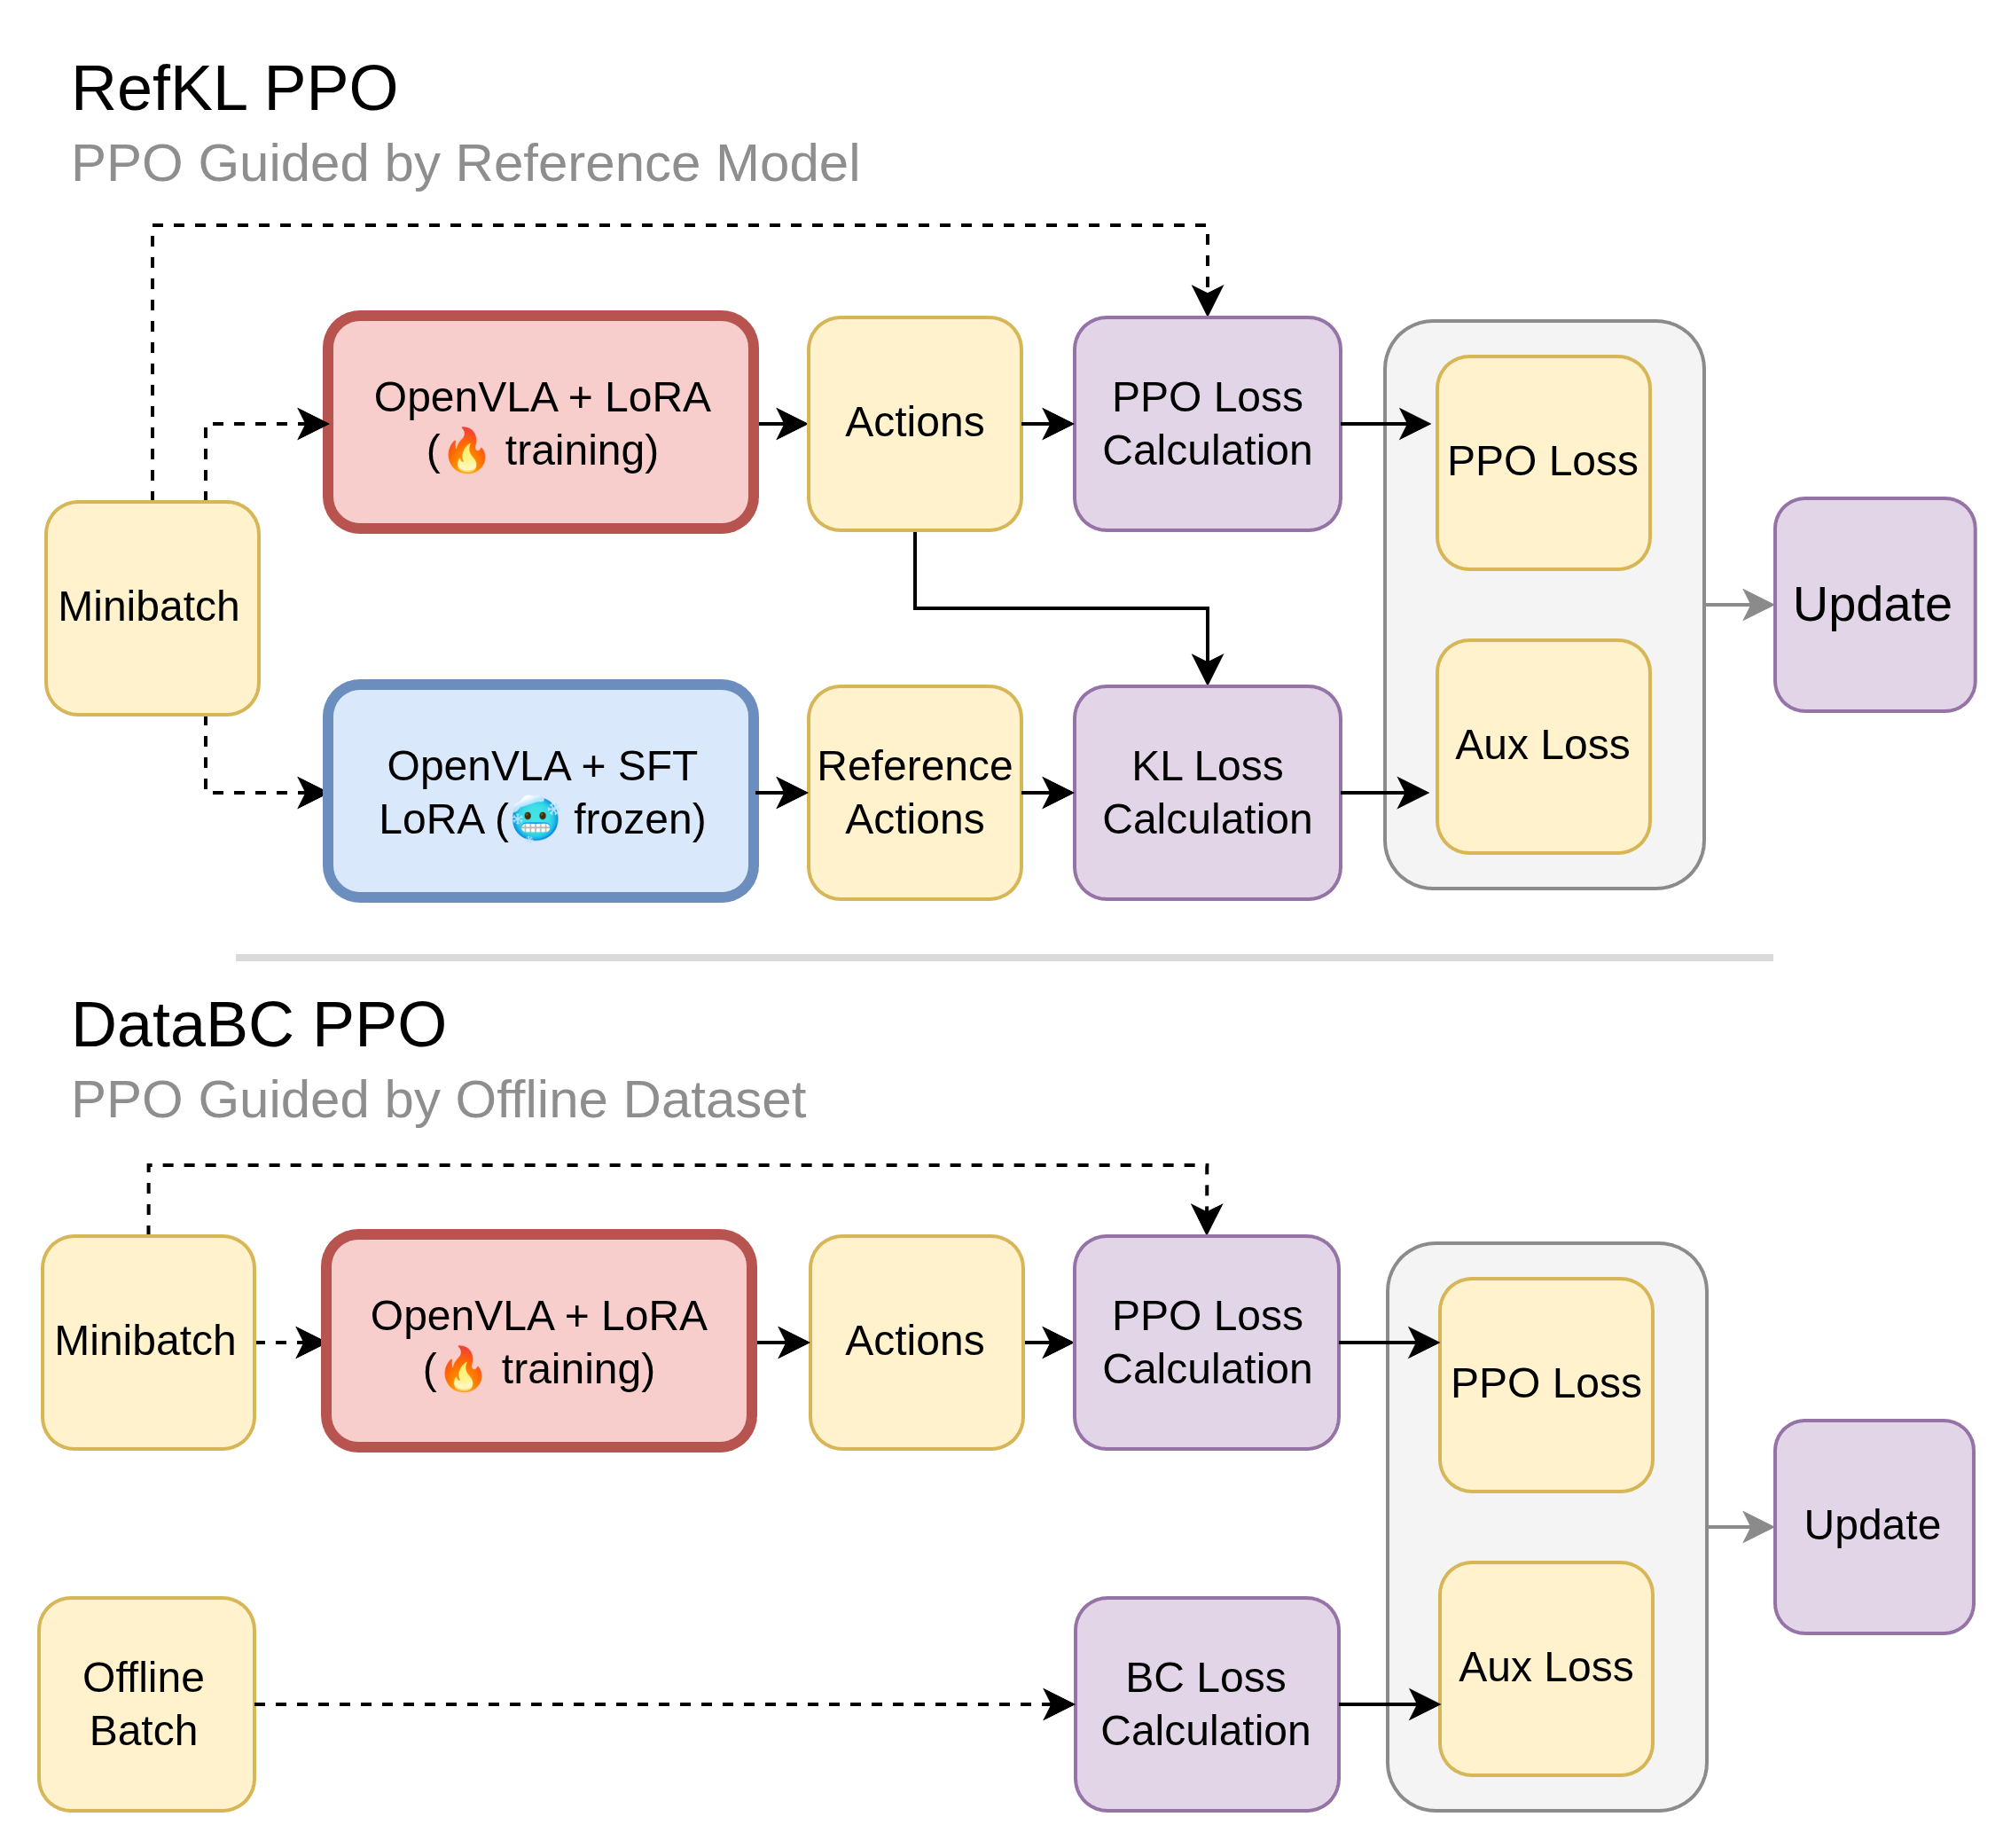
RefKL dùng một SFT policy đã train offline làm reference model. Reference này bị frozen trong lúc RL. Với mỗi minibatch PPO, ta tính KL divergence giữa phân phối action của reference policy và policy hiện tại:
L_RefKL = average KL(pi_ref(. | o) || pi_theta(. | o))
Nếu policy hiện tại bắt đầu drift quá xa khỏi behavior đã học từ demonstration, KL penalty kéo nó lại. Nhưng vì loss này chỉ là một term có trọng số beta, PPO vẫn có quyền cải thiện hành vi nếu reward online cho thấy hướng đi mới tốt hơn.
Ưu điểm của RefKL là nó dùng toàn bộ phân phối của reference model. Với VLA lớn, phân phối này chứa nhiều thông tin hơn một action label đơn lẻ. Ví dụ, reference có thể biết nhiều action gần đúng cho cùng một observation, trong khi behavior cloning chỉ thấy một demonstrated action.
Paper nhận xét RefKL là biến thể ổn định nhất. Nó consistently nằm trên PPO thường và thường tốt hơn DataBC trên learning curve. Điều này hợp lý: KL-to-reference là regularizer mềm, còn BC trên fixed dataset có thể khóa policy quá chặt vào distribution cũ.
DataBC khác gì RefKL?
DataBC không cần chạy reference policy cho offline batch. Nó thêm trực tiếp supervised behavior cloning loss:
L_DataBC = - E log pi_theta(a_star | o)
Trong đó (o, a_star) đến từ demonstration dataset. Cách này đơn giản, dễ hiểu và gần với SFT truyền thống. Nhưng nó có một nhược điểm: dataset chỉ chứa các state đã được demonstrator hoặc motion planner đi qua. Khi online RL đưa policy vào state mới, BC loss không nhất thiết giúp nhiều, và đôi khi còn kéo policy về behavior cũ.
Vì vậy, DataBC vẫn tốt hơn PPO ở 1M steps, nhưng không nhất quán bằng RefKL. Nếu bạn cần implement nhanh trên codebase có sẵn dataloader offline, DataBC là baseline đáng thử. Nếu bạn đã có SFT checkpoint mạnh và đủ GPU memory để forward reference, RefKL là lựa chọn paper khuyến nghị hơn.
Cài đặt repo
Phần dưới đây tóm tắt theo README chính thức. Repo giả định CUDA 12.1 và PyTorch 2.2. Bạn cần máy Linux có GPU NVIDIA đủ lớn cho OpenVLA 7B LoRA, hoặc cluster nhiều GPU nếu muốn chạy nhiều seed.
git clone https://github.com/alstar8/offline-supervision-vla-rl.git
cd offline-supervision-vla-rl

# Cách nhanh: script tạo env rlvla-guided
bash ./install_env.sh --flash-attn-wheel /path/to/flash_attn.whl
conda activate rlvla-guided
Nếu cài tay:
conda create -n rlvla-guided python=3.10 -y
conda activate rlvla-guided

pip install torch==2.2.0 torchvision==0.17.0 torchaudio==2.2.0 \
  --index-url https://download.pytorch.org/whl/cu121

cd openvla && pip install -e . && cd ..
pip install -U tyro datasets==3.3.2
cd ManiSkill && pip install -e . && cd ..
cd real2sim && pip install -e . && cd ..
cd SimplerEnv && pip install -e . && cd ..
Repo còn cần một environment riêng để build RLDS dataset:
cd openvla/rlds_dataset_builder
conda env create -f environment_ubuntu.yml
conda activate rlds_env
Với beginner, lỗi thường gặp sẽ nằm ở CUDA/PyTorch, flash-attn, và editable install giữa nhiều submodule. Cách debug gọn là kiểm tra từng lớp: import torch, import mani_skill, import simpler_env, rồi mới chạy training script.
Chuẩn bị dữ liệu demonstration
Experiments dùng task PutOnPlateInScene25Main-v3. Repo hướng dẫn collect demonstrations bằng ManiSkill motion planner:
conda activate rlvla-guided
cd ManiSkill

python -m mani_skill.examples.motionplanning.widowx.collect_simpler \
  -e "PutOnPlateInScene25Main-v3" \
  --save_video \
  --save_data \
  --num_procs 16 \
  --num_traj 16400 \
  --seed=100
Sau đó build SFT RLDS dataset:
conda activate rlds_env
cd openvla/rlds_dataset_builder/sft_dataset

tfds build --overwrite
mkdir -p ../../../datasets
mv -T ~/tensorflow_datasets/example_dataset ../../../datasets/sft
Paper dùng SFT reference checkpoint early-stopped: 2k demonstrations, 7.5k steps. Đây là chi tiết hay: reference không cần là SFT cực lớn. Một SFT checkpoint vừa đủ tốt vẫn có thể làm prior rất hiệu quả cho RL.
Training: SFT, PPO, RefKL, DataBC
Các script chính:
| Method | Script |
|---|---|
| SFT reference | scripts/train_sft.sh |
| PPO thường | scripts/train_ppo.sh |
| PPO SFT-init | scripts/train_ppo_sft_init.sh |
| RefKL | scripts/train_refkl.sh |
| DataBC | scripts/train_databc.sh |
Chạy SFT reference:
bash scripts/train_sft.sh
Chạy PPO baseline:
bash scripts/train_ppo.sh --seed 0
Chạy PPO từ SFT initialization:
bash scripts/train_ppo_sft_init.sh --seed 0
Chạy hai method chính của paper:
# RefKL: PPO + KL penalty tới frozen SFT reference
bash scripts/train_refkl.sh --seed 0

# DataBC: PPO + behavior cloning auxiliary loss trên offline demos
bash scripts/train_databc.sh --seed 0
Để giới hạn 1M environment steps:
bash scripts/train_refkl.sh --seed 0 --steps_max=1000000
Theo mapping trong README, RefKL tương ứng trainer train_ms3_ppo_bc_teacher.py với --bc_to_ref_enabled, DataBC tương ứng train_ms3_ppo_sft.py, còn curriculum beta dùng các tham số như --bc_to_ref_coef, --bc_to_ref_hold_steps=100000, --bc_to_ref_decay_steps=300000.
Inference và evaluation
Trong paper, "inference" chủ yếu là evaluate checkpoint trong RL4VLA/SimplerEnv, không phải deploy trực tiếp lên robot thật. Bạn set checkpoint path rồi chạy script eval:
CKPT_PATH="gen-robot/openvla-7b-rlvla-warmup" \
UNNORM_KEY="bridge_orig" \
VLA_LOAD_PATH="../SimplerEnv/wandb/<run>/glob/steps_XXXXXX" \
bash scripts/eval_policy.sh
Sau đó aggregate success rate:
cd SimplerEnv/scripts
python calc_statistics.py
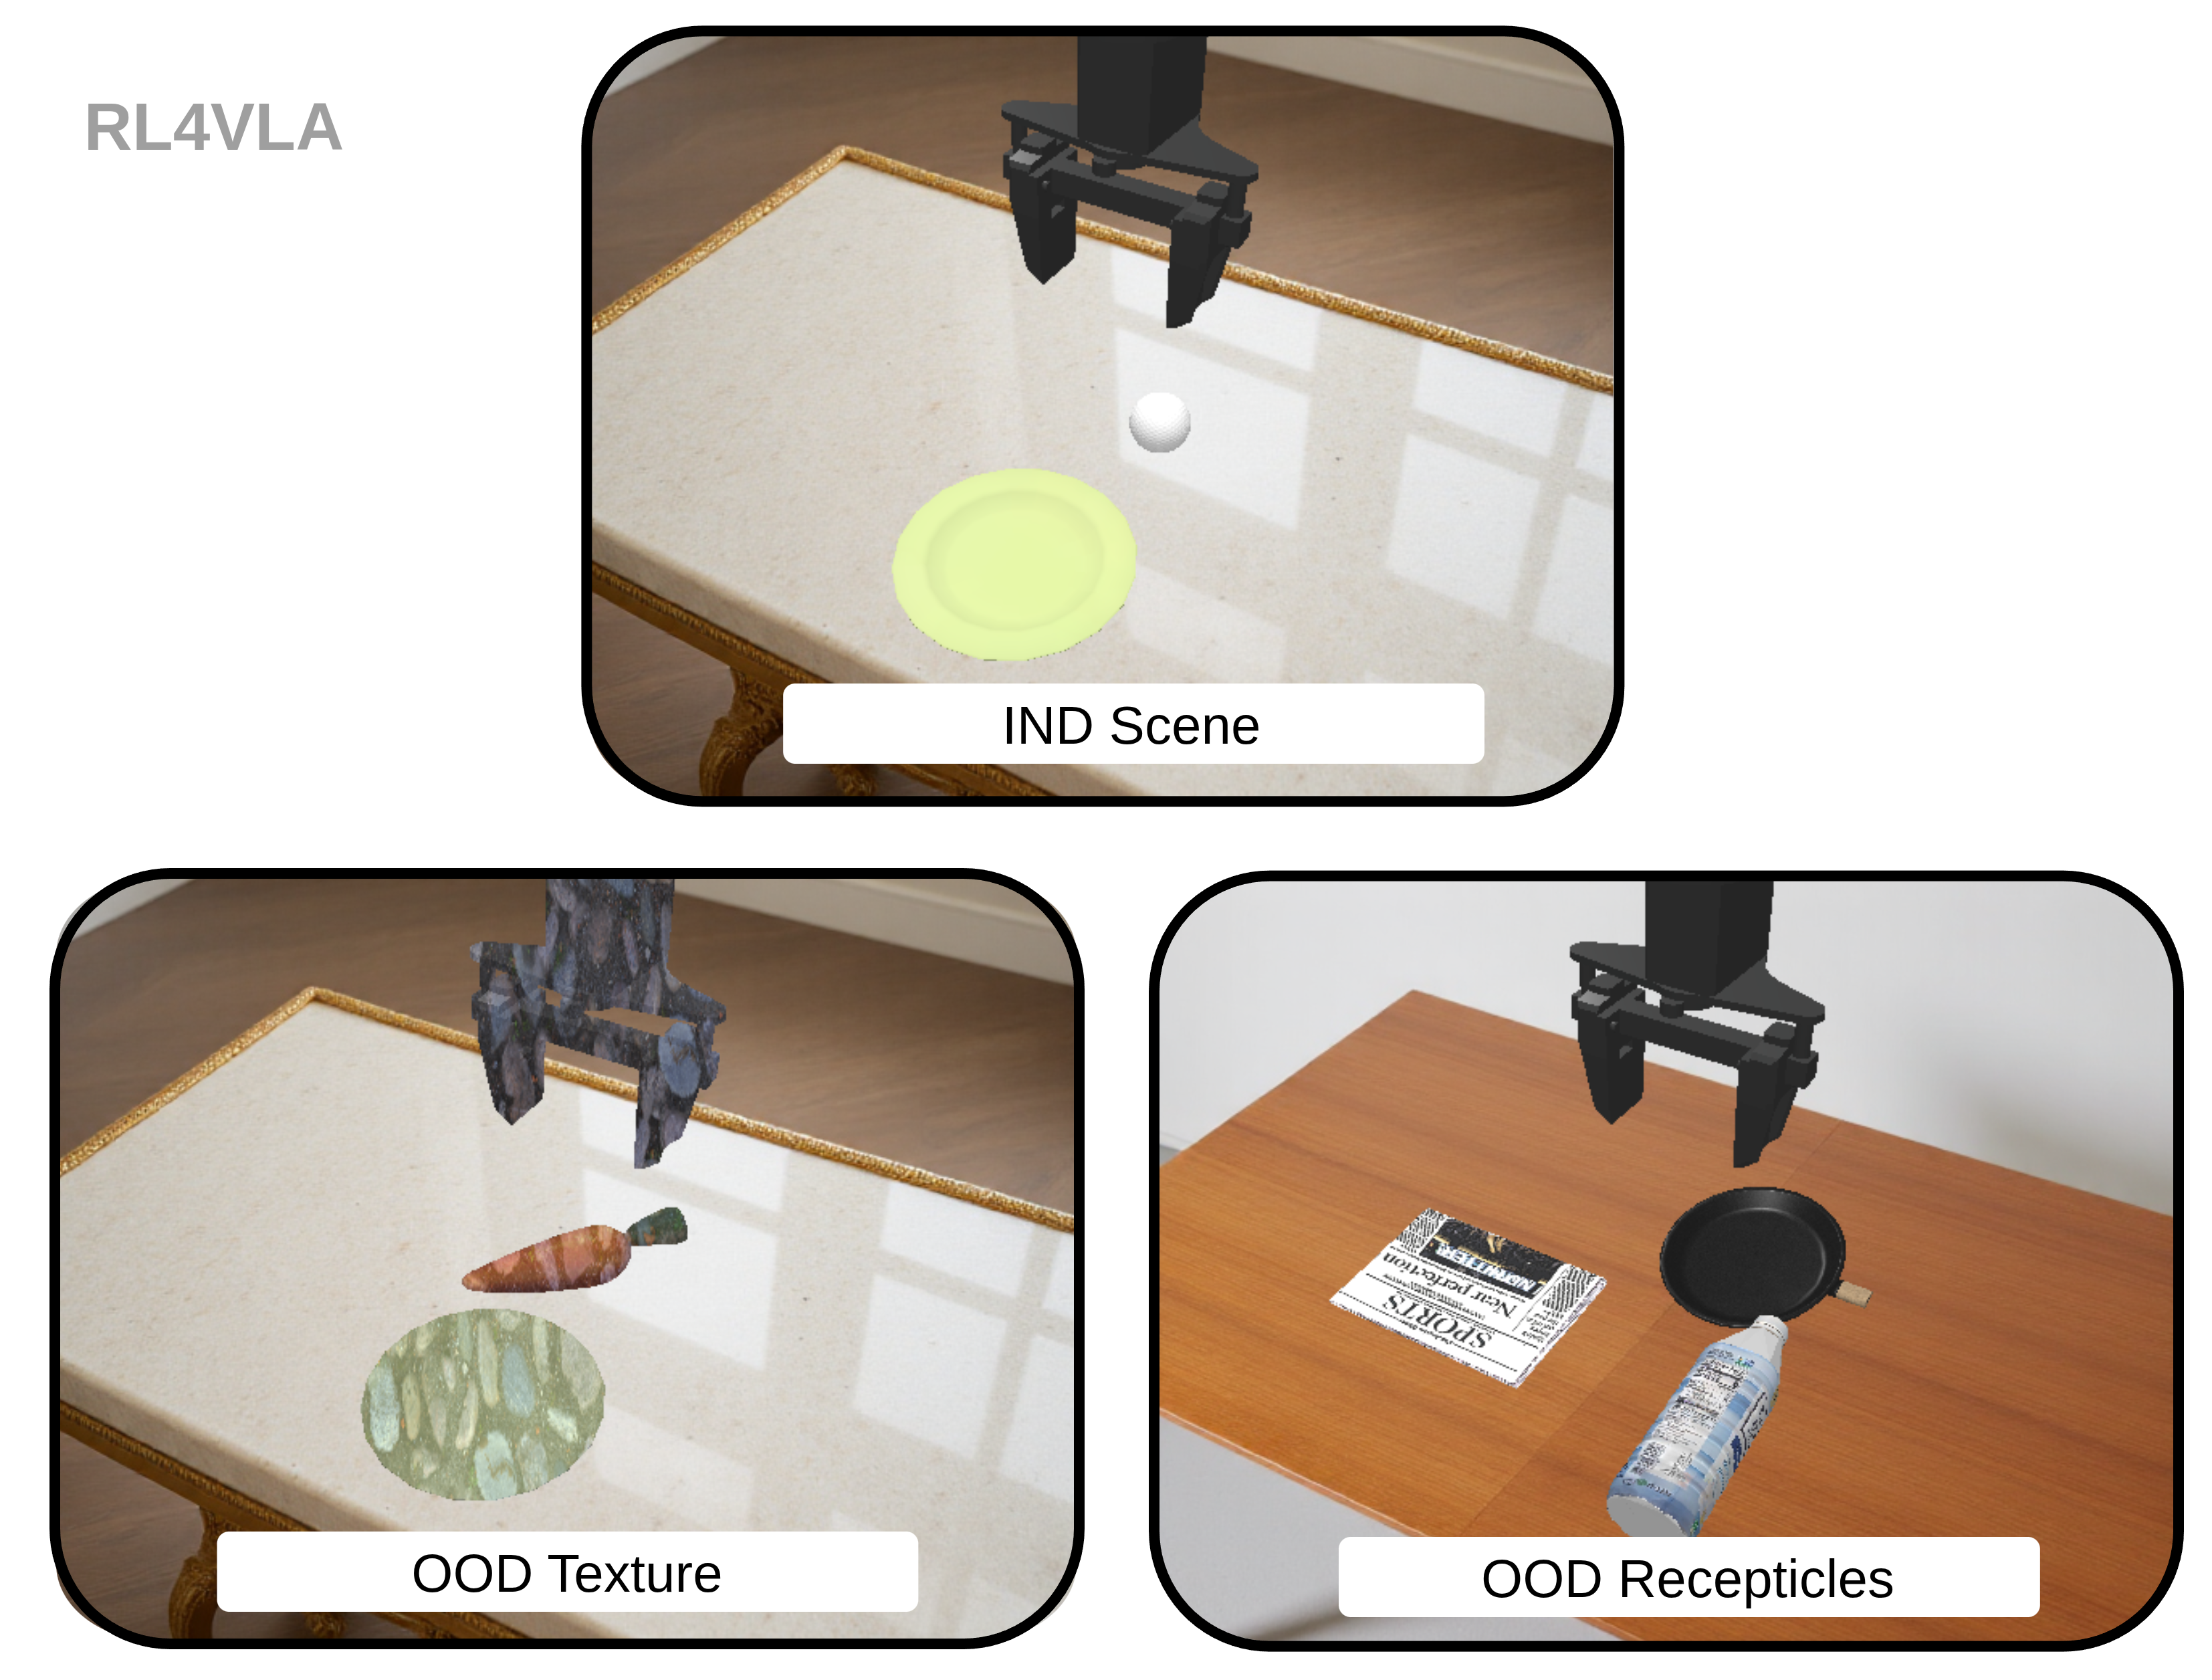
Evaluation protocol:
- 64 in-distribution episodes cho mỗi checkpoint.
- 960 out-of-distribution episodes tổng cộng.
- 15 OOD environments, mỗi môi trường 64 episodes.
- OOD được chia thành action shift, language shift và vision shift.
- Evaluation seeds là
{0, 1, 2}.
Kết quả quan trọng
Bảng chính của paper:
| Method | IND | OOD Act | OOD Lang | OOD Vis | OOD Avg |
|---|---|---|---|---|---|
| SFT | 0.82 | 0.46 | 0.60 | 0.74 | 0.62 |
| PPO SFT-init (1M) | 0.87 | 0.51 | 0.69 | 0.78 | 0.69 |
| PPO (2M) | 0.92 | 0.82 | 0.75 | 0.76 | 0.77 |
| PPO RefKL (1M) | 0.93 | 0.79 | 0.76 | 0.76 | 0.77 |
| PPO DataBC (1M) | 0.91 | 0.74 | 0.73 | 0.74 | 0.74 |
Điểm đáng chú ý nhất: PPO RefKL 1M đạt OOD Avg 0.77, ngang PPO 2M. IND của RefKL còn nhỉnh hơn: 0.93 so với 0.92. DataBC cũng tốt: OOD Avg 0.74 ở 1M steps, cao hơn PPO 1M.
Ở cùng 1M budget:
| Method | IND | OOD Avg |
|---|---|---|
| PPO (1M) | 0.75 | 0.64 |
| PPO SFT-init (1M) | 0.87 | 0.69 |
| PPO RefKL (1M) | 0.93 | 0.77 |
| PPO DataBC (1M) | 0.91 | 0.74 |
RefKL tăng OOD Avg thêm +0.13 so với PPO 1M. DataBC tăng +0.10. Với robotics, đây là mức tăng rất lớn vì mỗi điểm success rate thường phải trả bằng nhiều giờ rollout.
Tại sao không chỉ dùng SFT-init?
Trực giác ban đầu rất hợp lý: nếu SFT tốt, hãy initialize PPO từ SFT rồi tiếp tục RL. Paper cho thấy cách này giúp PPO 1M tốt hơn PPO thường, nhưng vẫn kém guided methods. Lý do có thể là khi LoRA adapter đã fit mạnh vào supervised distribution, RL update sau đó khó dịch chuyển action behavior hơn, đặc biệt ở action OOD.
RefKL khác ở chỗ nó không bắt policy bắt đầu từ SFT adapter rồi tự xoay sở. Nó giữ base/warmup setup và đưa supervised knowledge vào objective dưới dạng auxiliary regularizer. Vì beta decay về 0, policy vẫn có không gian để chuyển sang pure RL sau khi đã học cấu trúc hành động cơ bản.
Với team triển khai, takeaway là: SFT checkpoint không chỉ là checkpoint khởi tạo; nó còn là teacher/reference trong quá trình RL.
Khi nào nên dùng method này?
Bạn nên cân nhắc Offline Supervision VLA-RL nếu:
- bạn đã có demonstration dataset từ teleoperation hoặc motion planning;
- task có sparse reward, ví dụ pick-place, insert, open drawer, tool use;
- PPO hoặc GRPO online quá chậm trong 20-30% training đầu;
- bạn dùng LoRA/PEFT để adapt VLA lớn như OpenVLA;
- bạn cần giữ OOD generalization chứ không chỉ tối ưu một scene duy nhất.
Bạn cần cẩn trọng nếu:
- demonstration quá kém hoặc lệch hẳn task online;
- reward online sai hướng, khiến policy học shortcut;
- bạn không đủ memory để chạy reference policy cho RefKL;
- environment reset hoặc evaluation protocol khác quá nhiều so với RL4VLA.
Trong trường hợp memory hạn chế, thử DataBC trước. Trong trường hợp có GPU headroom, RefKL là lựa chọn đáng ưu tiên.
Checklist reproduce
Một checklist thực tế:
- Clone repo và cài
rlvla-guided. - Cài riêng
rlds_envcho dataset builder. - Collect demonstrations cho
PutOnPlateInScene25Main-v3. - Build RLDS SFT dataset.
- Train SFT reference hoặc dùng checkpoint theo README.
- Chạy PPO baseline 1M để có mốc so sánh.
- Chạy RefKL 1M với curriculum beta.
- Chạy DataBC 1M nếu muốn baseline rẻ hơn.
- Evaluate IND + 15 OOD envs bằng cùng seed.
- So sánh OOD Avg, không chỉ IND.
Với lab nhỏ, bạn có thể giảm số seed trong giai đoạn debug, nhưng khi báo cáo kết quả nên giữ evaluation protocol gần paper nhất có thể. Nếu chỉ nhìn một scene in-distribution, bạn rất dễ đánh giá nhầm method.
Liên hệ với LeRobot và real robot
Method này chưa phải recipe plug-and-play cho LeRobot, nhưng ý tưởng rất dễ chuyển hóa. Trong LeRobot-style pipeline, bạn thường có:
- dataset offline từ teleop;
- SFT hoặc behavior cloning policy;
- một simulator hoặc real-robot RL loop;
- reward từ task success, detector, human intervention hoặc scripted metric.
Thay vì bỏ dataset sau SFT, bạn dùng nó làm auxiliary loss trong giai đoạn online. Nếu có frozen SFT policy, dùng KL-to-reference giống RefKL. Nếu không, sample batch từ dataset và thêm BC loss giống DataBC. Bài HIL-SERL với LeRobot là một nền tốt để hiểu phần online RL/human intervention; Offline Supervision VLA-RL bổ sung góc "dữ liệu demo vẫn sống trong objective".
Kết luận
Offline Supervision VLA-RL rất đáng chú ý vì nó giải quyết đúng nỗi đau của robotics: online RL mạnh nhưng đắt. Paper cho thấy demo offline không nên chỉ dùng một lần để train SFT. Khi đưa offline supervision vào PPO bằng RefKL hoặc DataBC, policy học nhanh hơn, giữ OOD generalization tốt hơn, và RefKL có thể đạt OOD Avg của PPO 2M chỉ với 1M environment steps.
Với beginner, bài học lớn là: hãy nghĩ về demonstration dataset như một training prior liên tục, không phải một file dữ liệu dùng xong rồi bỏ. Với đội triển khai VLA manipulation, đây là hướng rất thực dụng để giảm chi phí compute và interaction trước khi bước sang real robot.


