GALA, viết tắt của Geometry-Aware Latent Action Modeling, là một paper rất đáng đọc nếu bạn đang quan tâm đến VLA cho robot thao tác đa embodiment. Điểm thú vị của GALA không nằm ở việc thêm một model VLM khổng lồ, mà ở câu hỏi nền tảng hơn: khi human hand, dexterous robot hand và parallel-jaw gripper có action space khác nhau hoàn toàn, ta có thể học một dạng latent action chung nào vẫn giữ được chuyển động ngón tay, cổ tay và end-effector hay không?
Paper gốc là GALA: Geometry-Aware Latent Action Modeling for Vision-Language-Action Model Pretraining across Embodiments, project page ở puzhenyuan.github.io/GALA-website, repo chính thức là PuzhenYuan/GALA, và checkpoint RoboCasa-GR1 được phát hành trên Hugging Face. Bài này đi theo hướng thực hành: hiểu ý tưởng paper, đọc kiến trúc, cài môi trường, chạy inference/evaluation trên RoboCasa-GR1, rồi hiểu training pipeline để bạn có thể tái hiện hoặc mở rộng khi code train đầy đủ được public.
Nếu bạn mới vào VLA, nên đọc trước bài VLA models là gì? để nắm observation, language instruction, action chunk và policy head. GALA nằm ở tầng sâu hơn: nó không chỉ hỏi policy output action gì, mà hỏi action nên được biểu diễn như thế nào để transfer giữa embodiment.
GALA giải quyết vấn đề gì?
Trong imitation learning truyền thống, action label thường là action thật của robot: joint position, delta pose, gripper command, finger joint, waist command, hoặc một vector control riêng của từng dataset. Cách này ổn khi train một robot duy nhất. Nhưng VLA hiện đại muốn scale data từ nhiều embodiment: video người thao tác, robot gripper đơn giản, robot hand nhiều ngón, robot humanoid như GR-1. Khi đó action space bị vỡ:
- Human video thường không có robot action thật.
- Parallel-jaw gripper có ít DoF hơn dexterous hand.
- Dexterous hand có finger articulation rất quan trọng nhưng khó align trực tiếp với human hand.
- Humanoid tabletop như GR-1 có hai tay, waist, camera và action timing khác dataset robot cố định.
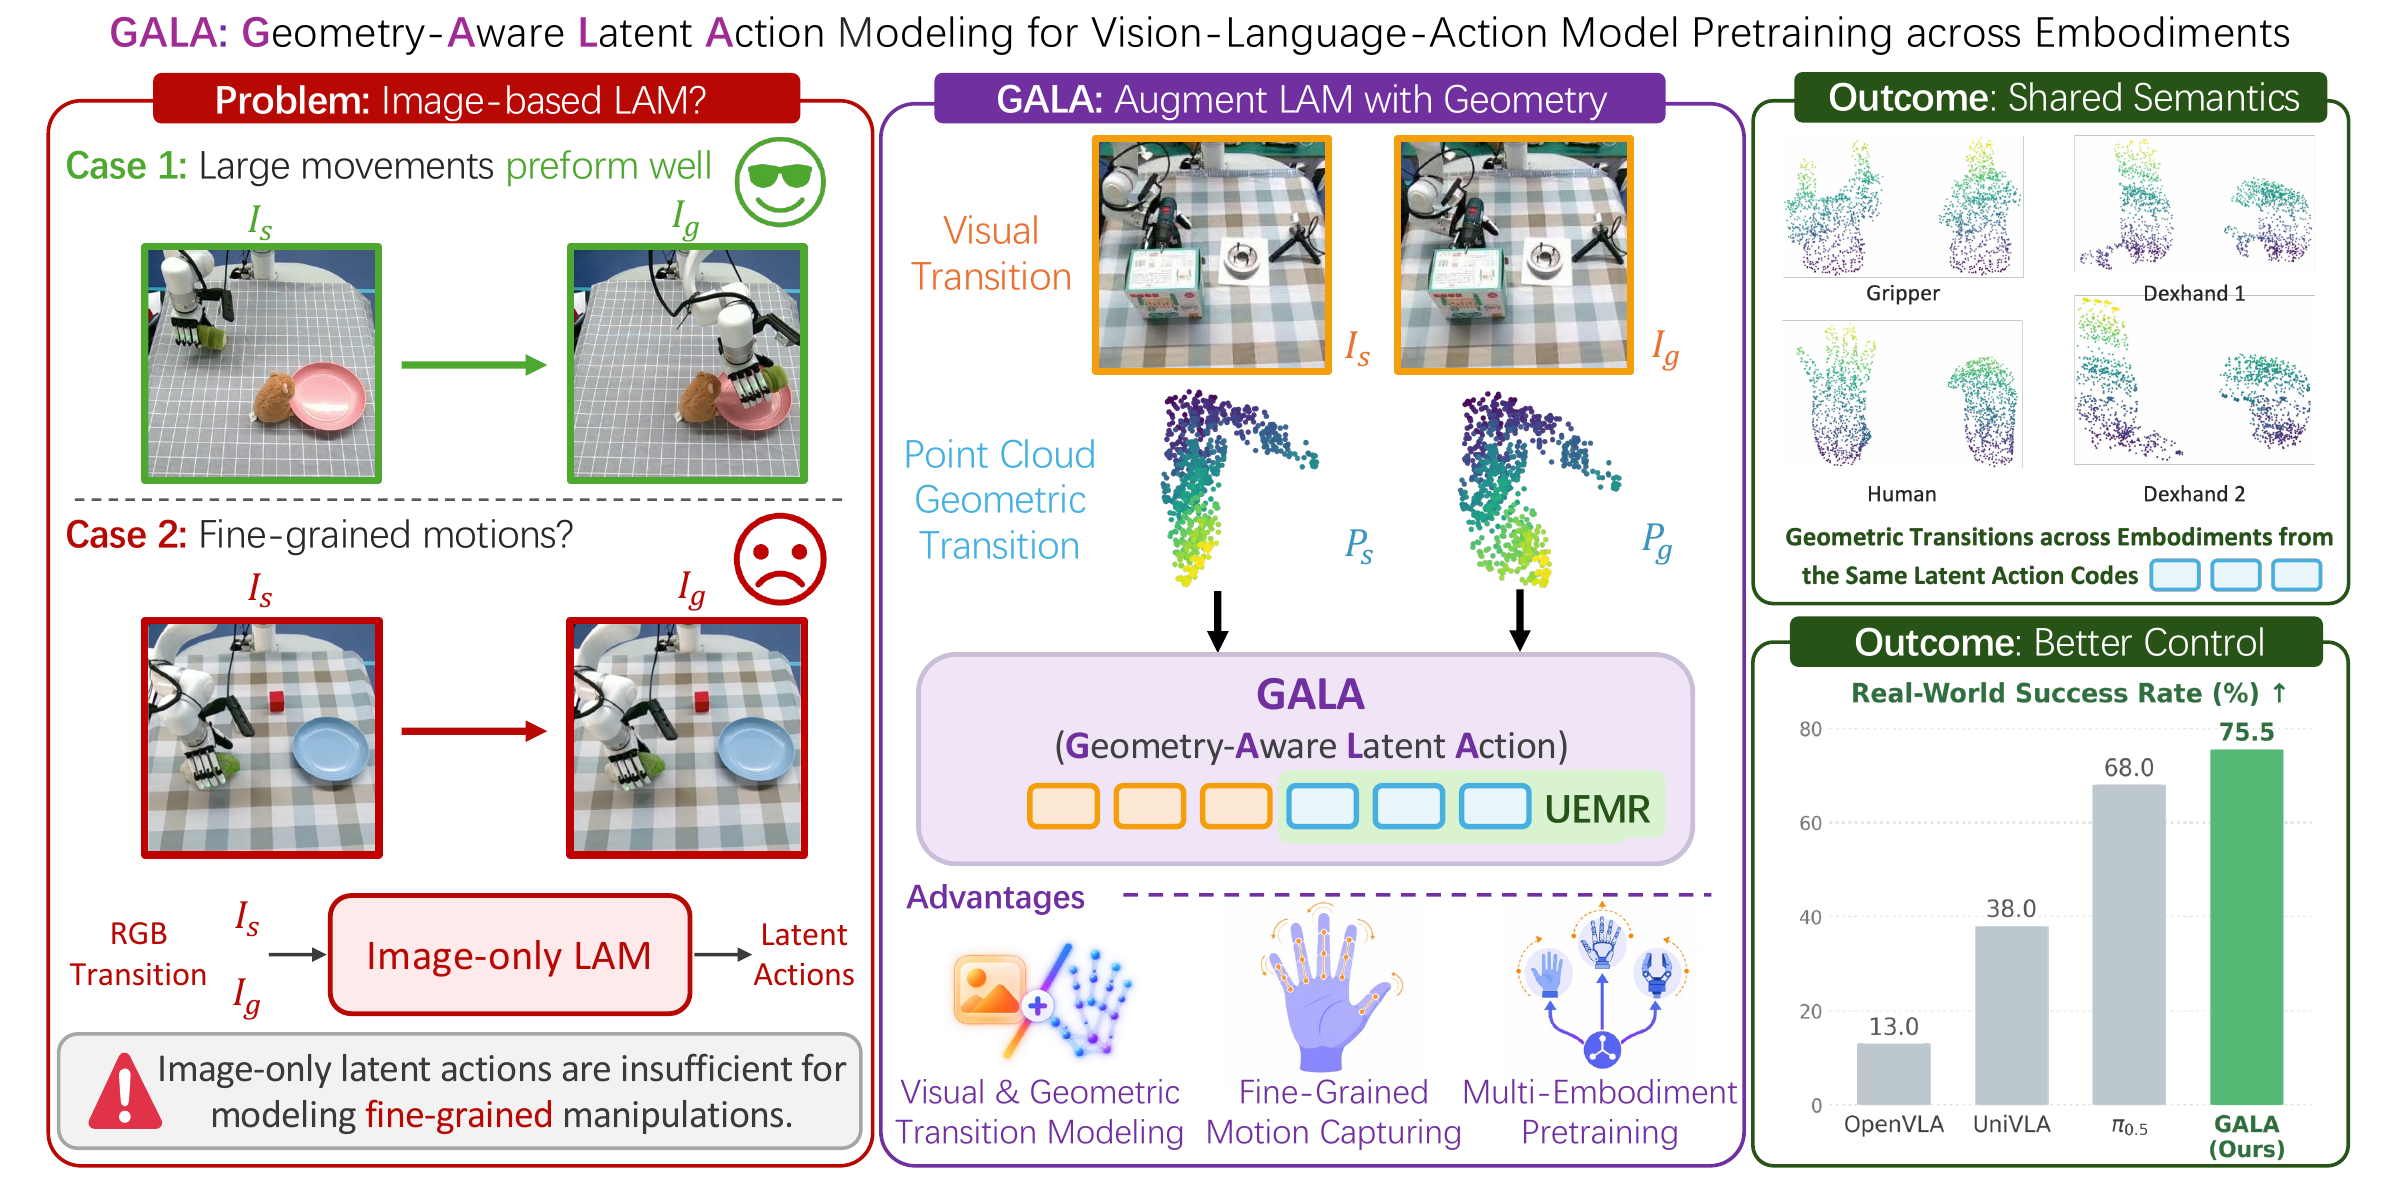
Latent Action Model, hay LAM, là một hướng giải quyết: thay vì dùng action thật, model học một token latent từ cặp ảnh trước-sau. Token này mô tả kiểu chuyển động đã xảy ra trong visual transition. Cách đó giúp dùng được cả video không có action label. Nhưng paper GALA chỉ ra một điểm yếu quan trọng: LAM chỉ dựa vào ảnh thường giỏi scene-level dynamics nhưng yếu ở fine-grained end-effector articulation. Ví dụ ảnh có thể cho thấy vật đã được nhấc lên, nhưng không đủ rõ ngón nào co lại, cổ tay xoay thế nào, hay hand geometry thay đổi ra sao.
GALA thêm một nhánh hình học: từ human hand hoặc robot end-effector, hệ thống dựng point cloud 3D cục bộ của tay/gripper tại thời điểm start và goal. Latent action vì vậy không chỉ học "vật dịch chuyển" mà còn học "end-effector đã biến dạng/chuyển động thế nào". Đây là lý do kết quả trên RoboCasa-GR1 tăng mạnh khi co-training đa embodiment: latent hình học mang theo semantics thao tác có thể chia sẻ giữa human hand, dexterous robot hand và gripper.
Ý tưởng chính của paper
Hãy tưởng tượng bạn có hai frame: lúc bắt đầu và lúc sau khi robot tương tác với vật. Một LAM ảnh thuần nhìn hai frame RGB, rồi nén sự khác biệt thành token rời rạc. GALA vẫn làm việc đó, nhưng thêm cặp point cloud của left/right end-effector ở hai thời điểm. Với human hand, paper dùng WiLoR để ước lượng MANO mesh và keypoints từ RGB. Với robot, point cloud được lấy từ URDF hoặc MJCF, rồi dùng forward kinematics để biến đổi surface samples theo joint state hiện tại.
Điểm quan trọng là point cloud được biểu diễn trong wrist- hoặc root-centered local frame với axis convention chung. Vì vậy GALA không cần point correspondence, joint correspondence hay mesh topology giống nhau giữa người và robot. Đây là quyết định rất thực dụng: nếu bắt human MANO hand, Fourier hand, XHand và Robotiq gripper phải có cùng index ngón tay hay cùng mesh topology, hệ sẽ rất dễ gãy.
Nhưng chỉ "thêm point cloud" chưa đủ. Nếu nén point cloud trực tiếp, model có thể học morphology riêng của từng embodiment thay vì motion semantics chung. Paper gọi đây là vấn đề: fine-grained representation có thể giàu chi tiết nhưng kém chia sẻ. GALA giải quyết bằng Unified End-effector Motion Representation, hay UEMR, gồm ba thiết kế:
- Unified bimanual motion latent: latent token biểu diễn chuyển động hai tay chung, không tách cứng token trái/phải. Với single-arm gripper, cùng point cloud có thể được đưa vào hai nhánh để giữ interface thống nhất.
- Pair-consistent geometric augmentation: cùng một random 3D transform được áp dụng cho cả start và goal point cloud. Absolute coordinate bị nhiễu, nhưng relative motion được giữ lại, buộc latent học chuyển động chứ không học shortcut tọa độ.
- Bidirectional transition learning: model học cả chiều forward và backward giữa hai thời điểm, dùng chung encoder, codebook và decoder. Việc này tăng supervision cho relative temporal dynamics.
Nói ngắn gọn, GALA cố dạy latent action trả lời câu: "end-effector đã làm gì trong không gian 3D?", thay vì "đây là tay robot loại nào?".
Kiến trúc hai stage
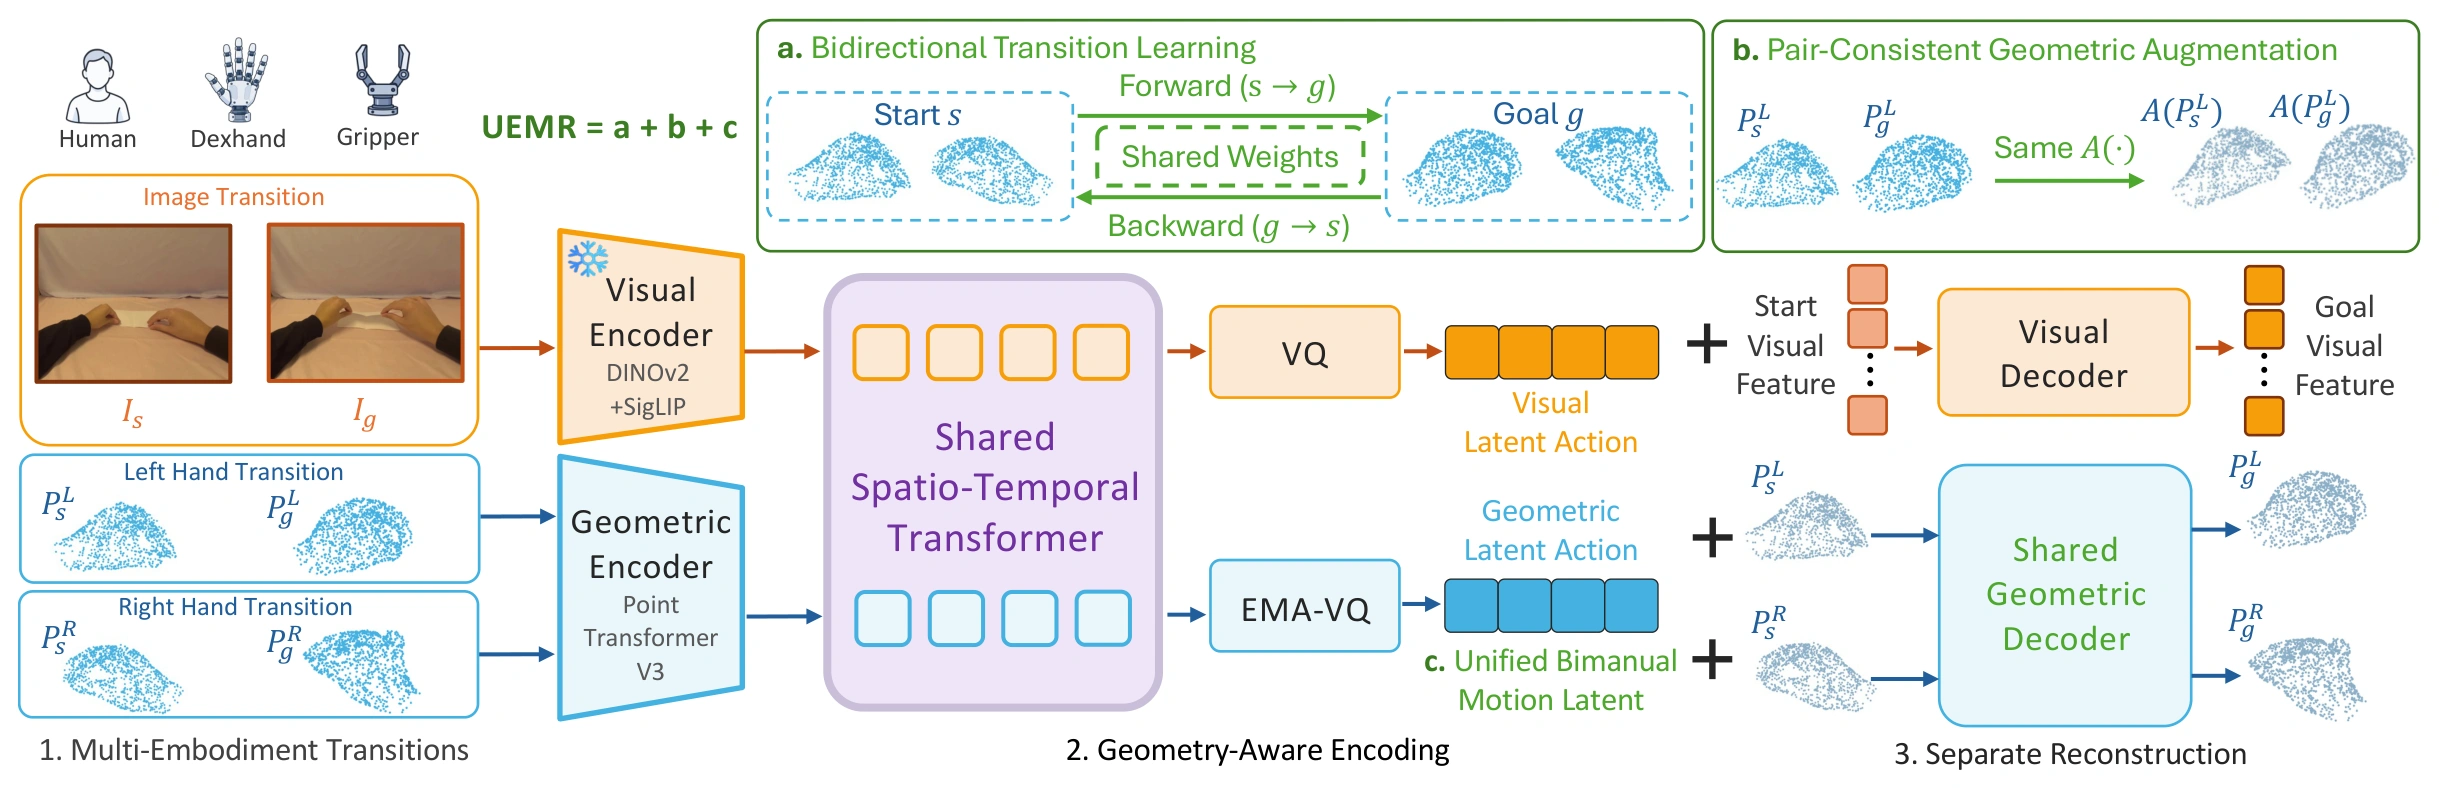
Stage 1: Geometry-Aware Latent Action Learning. Input là RGB observation start-goal, language instruction, và point-cloud pair cho tay trái/tay phải. RGB được encode bằng frozen DINOv2 và SigLIP. Point cloud được encode bằng frozen Point Transformer V3. Các feature này đi qua spatiotemporal Transformer có language condition. Output là hai nhóm token:
- Visual latent action tokens cho scene-level dynamics.
- Geometric latent action tokens cho bimanual 3D end-effector transition.
Geometric tokens được quantize bằng shared EMA-VQ codebook. Decoder nhận initial geometry và latent token để reconstruct goal point cloud, supervised bằng Chamfer Distance. Vì decoder được condition trên geometry ban đầu, latent không cần lưu morphology tĩnh; nó được khuyến khích lưu phần chuyển động.
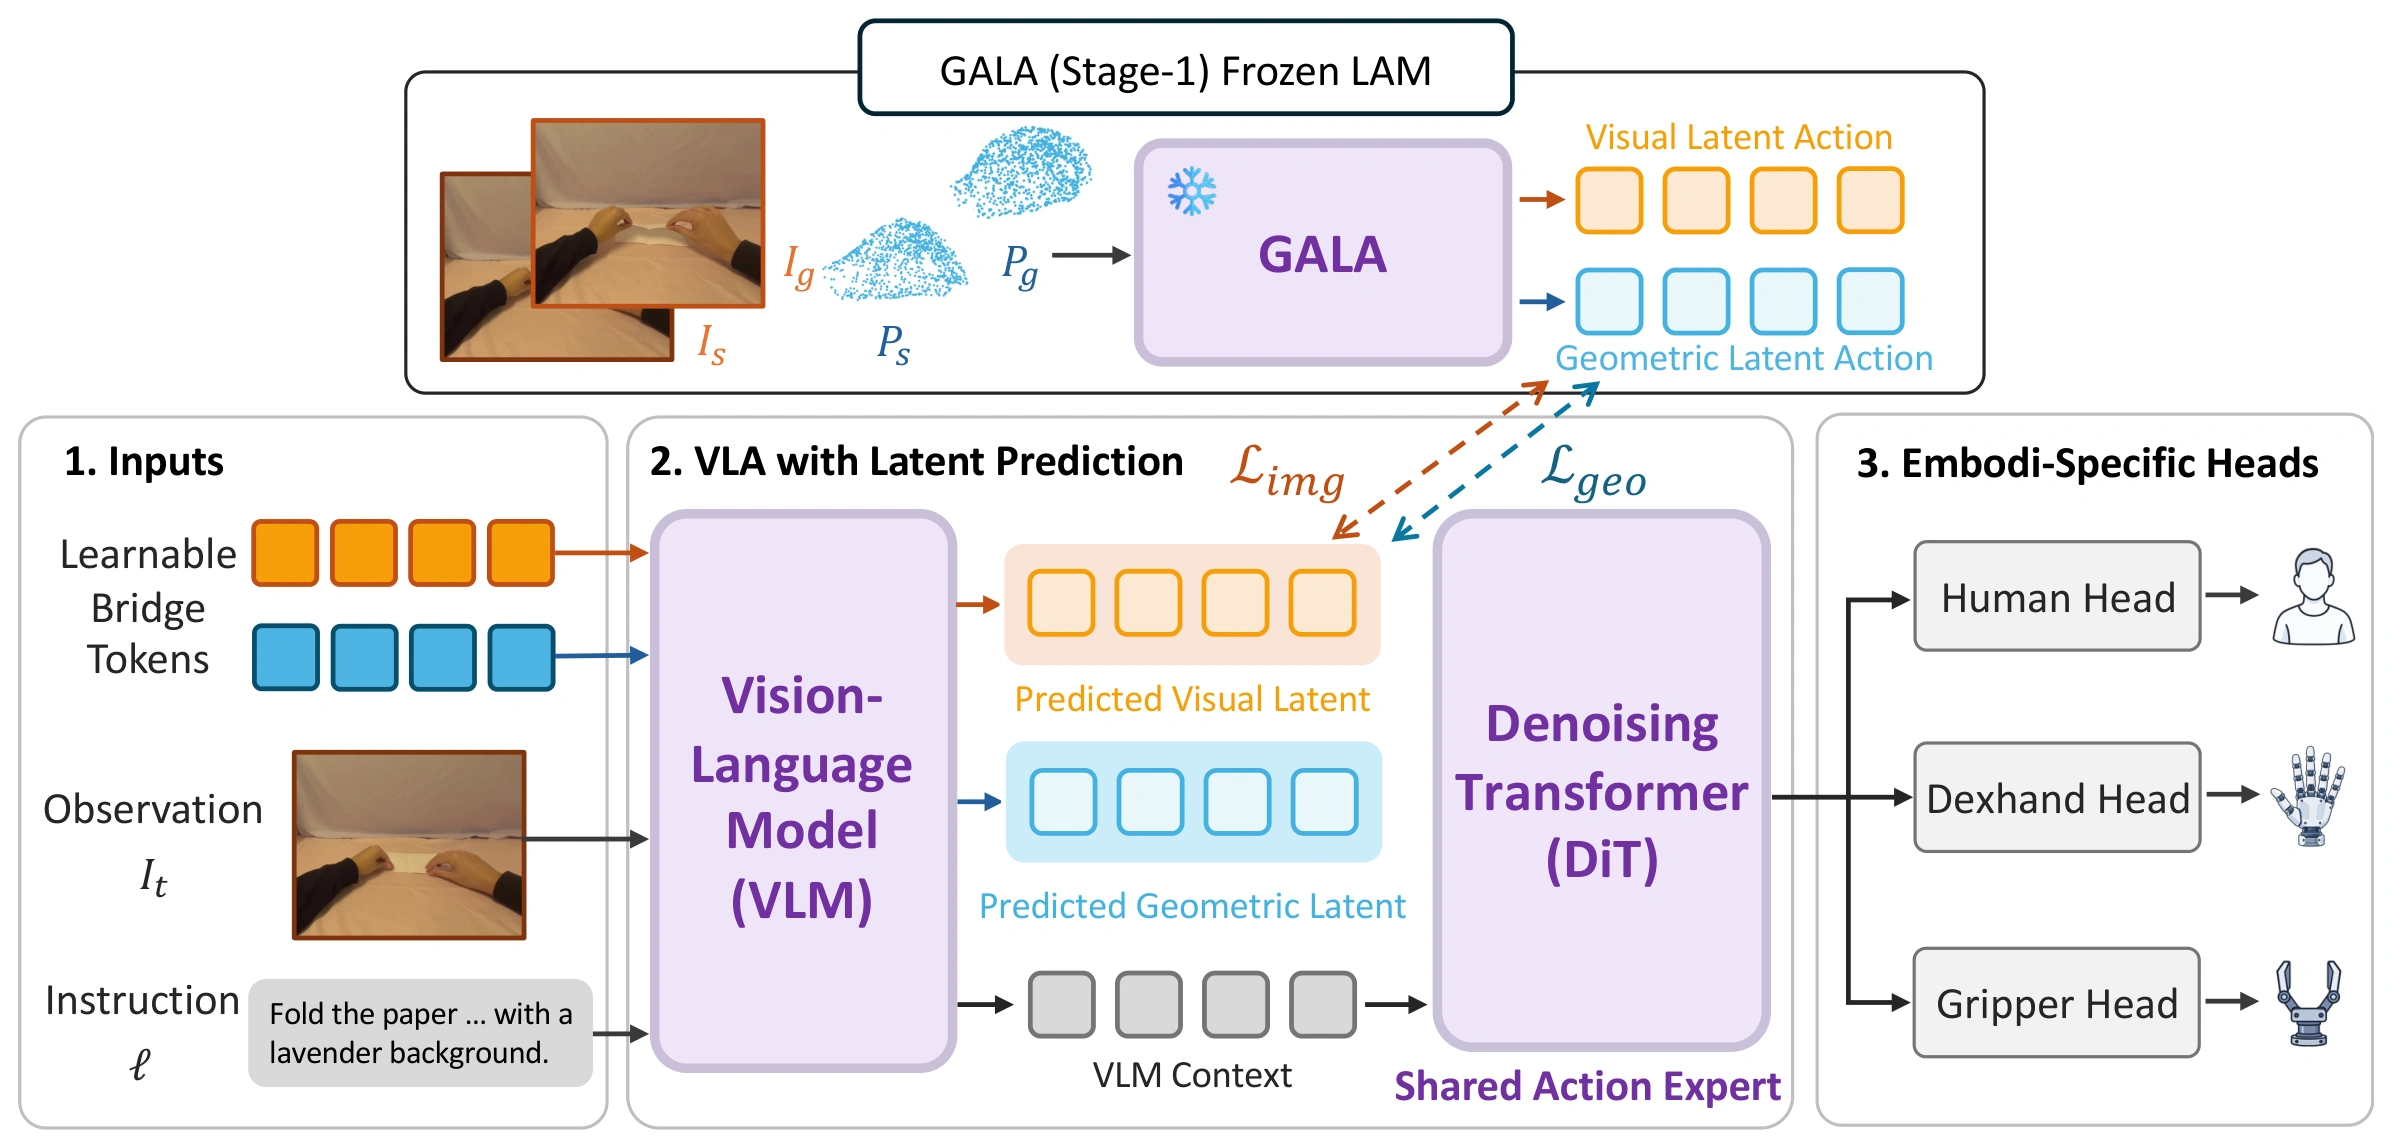
Stage 2: Geometry-Aware VLA Co-Training. Sau khi Stage 1 học latent, GALA freeze latent-action model. VLA backbone nhận observation và instruction, rồi append hai nhóm learnable bridge tokens: một nhóm dự đoán visual latent action, một nhóm dự đoán geometric latent action. Hai prediction target này dùng cross-entropy lên latent code rời rạc.
Phần action thật không bị ép về một unified action space nhân tạo. Với human demonstration, paper dùng wrist position/rotation trong camera frame cộng với finger keypoint position trong wrist frame. Với robot, GALA giữ native action space của từng dataset. Để làm việc này, action expert gồm shared diffusion transformer (DiT) và các embodiment-specific action heads. Shared DiT học visuomotor dynamics chung, còn head riêng map sang action dimension/control semantics của embodiment tương ứng. Objective cuối cùng kết hợp latent prediction và flow-matching continuous action generation.
Chuẩn bị máy chạy
Repo chính thức yêu cầu Linux, Python 3.10, NVIDIA GPU hỗ trợ CUDA 12.4, CUDA build toolchain và EGL để render headless. Với beginner, đừng bắt đầu bằng full evaluation 8 GPU. Hãy smoke test trước một task, một episode, một GPU. Sau khi pipeline chạy ổn, mới tăng số task và episode.
Một cấu hình hợp lý:
OS: Ubuntu 22.04 hoặc tương đương
GPU: NVIDIA GPU có CUDA 12.4, VRAM càng nhiều càng tốt
Python: 3.10
Renderer: MUJOCO_GL=egl
Disk: đủ cho checkpoint, Qwen2.5-VL-3B và RoboCasa assets
Repo README hướng dẫn:
git clone [email protected]:PuzhenYuan/GALA.git
cd GALA
conda create -n gala python=3.10 -y
conda activate gala
bash examples/environment_setup.sh
Script environment_setup.sh làm khá nhiều việc: cài PyTorch 2.5.1/CUDA 12.4, cài requirements, cài flash-attn==2.7.1.post4, clone đúng revision của robosuite và robocasa-gr1-tabletop-tasks, apply patch basket, cài editable packages, tải tabletop assets, rồi chạy pip check. Nếu lỗi ở flash-attn, thường là do CUDA toolkit/build toolchain không khớp. Nếu lỗi render MuJoCo, kiểm tra MUJOCO_GL=egl, driver NVIDIA và thư viện EGL trong container/máy host.
Tải checkpoint
Checkpoint public cho hướng dẫn này là ypz21/GALA_robocasa_gr1. README ghi repository model đang yêu cầu tài khoản có quyền truy cập, vì vậy bạn cần login Hugging Face trước:
hf auth login
hf download ypz21/GALA_robocasa_gr1 --local-dir checkpoints/checkpoint_robocasa_gr1
hf download Qwen/Qwen2.5-VL-3B-Instruct --local-dir checkpoints/Qwen2.5-VL-3B-Instruct
Điểm cần nhớ: checkpoint RoboCasa-GR1 này dùng backbone Qwen2.5-VL-3B-Instruct. Khi chạy eval, biến GALA_BACKBONE_PATH nên trỏ đến local dir của backbone để tránh vừa chạy vừa tải model qua mạng.
Smoke test inference
Trước khi chạy 24 task x 50 episodes, hãy dùng cấu hình nhỏ nhất:
mkdir -p outputs

PYTHON_BIN="$(command -v python)" \
GALA_BACKBONE_PATH="$PWD/checkpoints/Qwen2.5-VL-3B-Instruct" \
GPU_IDS=0 \
PROCS_PER_GPU=1 \
PORT_BASE=5810 \
N_ENVS=1 \
N_EPISODES=1 \
EVAL_MAX_TASKS=1 \
EVAL_TAG=_smoke \
DATA_CONFIG=fourier_gr1_arms_waist_gausNorm_crop_cam_ego_joints_only \
bash examples/run_eval_parallel.sh checkpoints/checkpoint_robocasa_gr1 id
Smoke test này chỉ kiểm tra toàn bộ đường đi: load checkpoint, start inference service, tạo RoboCasa environment, render headless, gọi policy, ghi result và video. Nếu smoke test fail, đừng tăng GPU. Hãy đọc log server/client trong outputs/evaluation_sim_id_1envs_smoke/. Các lỗi phổ biến là thiếu asset RoboCasa, checkpoint path sai, port đụng service cũ, hoặc EGL không hoạt động.
Khi smoke test ổn, chạy full evaluation theo README:
mkdir -p outputs
set -o pipefail

PYTHON_BIN="$(command -v python)" \
GALA_BACKBONE_PATH="$PWD/checkpoints/Qwen2.5-VL-3B-Instruct" \
GPU_IDS=0,1,2,3,4,5,6,7 \
PROCS_PER_GPU=3 \
PORT_BASE=5810 \
N_ENVS=1 \
N_EPISODES=50 \
EVAL_TAG=_gala_parallel \
DATA_CONFIG=fourier_gr1_arms_waist_gausNorm_crop_cam_ego_joints_only \
bash examples/run_eval_parallel.sh checkpoints/checkpoint_robocasa_gr1 id \
2>&1 | tee outputs/eval_gala_robocasa_gr1_id.log
Script chạy 24 ID tasks, mỗi task 50 episodes, dùng 8 GPU và 3 worker mỗi GPU. Output nằm dưới outputs/evaluation_sim_id_1envs_gala_parallel/, gồm results.json, log client/server và video rollout.
Training: tái hiện pipeline như paper
Hiện repo public chủ yếu cung cấp setup và evaluation checkpoint. Vì vậy phần này không nên hiểu là "copy lệnh là train được full GALA ngay"; nó là blueprint trung thành với paper để bạn biết cần chuẩn bị gì nếu muốn train lại.
Pipeline training có ba lớp:
Lớp 1: dựng geometry input. Với human videos, chạy hand estimator như WiLoR để lấy MANO mesh/keypoints cho từng frame, chuẩn hóa về palm/wrist local frame, rồi sample point cloud trên surface. Với robot datasets, dùng URDF/MJCF và recorded joint state để forward kinematics các end-effector links, aggregate surface samples, rồi resample về số điểm cố định. Missing hand được xử lý bằng validity mask.
Lớp 2: train geometry-aware LAM. Lấy start-goal interval, encode RGB bằng frozen DINOv2/SigLIP, encode point cloud bằng frozen PTv3, fuse với language qua spatiotemporal Transformer, quantize geometric latent bằng EMA-VQ, reconstruct goal geometry bằng decoder. Loss gồm visual VQ objective, Chamfer Distance cho UEMR reconstruction, EMA-VQ regularization, và tổng loss forward/backward.
Lớp 3: co-train VLA. Freeze GALA latent encoder. Với mỗi sample, tạo visual latent code và geometric latent code làm target cho bridge tokens của VLM. Đồng thời train shared DiT action expert bằng flow matching trên native action của từng embodiment. Với sample embodiment nào thì chỉ head action của embodiment đó được activate/optimize.
Pseudo checklist:
1. Chuẩn hóa dataset thành episodes có RGB, instruction, state/action nếu có.
2. Tạo point cloud end-effector cho từng timestep.
3. Chọn start-goal interval và mask tay/gripper bị thiếu.
4. Train Stage 1 LAM với visual branch + UEMR geometry branch.
5. Freeze LAM, encode latent code cho training samples.
6. Train Stage 2 VLA: bridge token CE loss + flow-matching action loss.
7. Evaluate bằng RoboCasa-GR1 ID tasks và real-world tasks nếu có robot.
Nếu bạn đã quen LeRobot hoặc OpenVLA, điểm khác lớn nhất là GALA không cố convert mọi action thành một vector chung. Nó chấp nhận native action space khác nhau, rồi chia sẻ phần reasoning qua VLM + DiT. Đây cũng là chỗ GALA có ý nghĩa với whole-body/humanoid VLA: khi robot nhiều DoF hơn, ép tất cả về một action schema chung thường làm mất semantics điều khiển.
Kết quả quan trọng
Paper đánh giá GALA ở ba tầng: probing latent motion, retrieval cross-embodiment, và downstream VLA.
Ở fine-grained motion probing, encoder bị freeze, sau đó một MLP nhẹ dự đoán translation, wrist rotation và finger/gripper articulation trên held-out XHand. GALA đạt lỗi tốt nhất: position 5.359 cm, rotation 7.898 độ, finger 7.585 độ. Điều này ủng hộ claim rằng geometric latent giữ được thông tin end-effector chi tiết hơn image-only latent.
Ở cross-embodiment retrieval, benchmark annotate các transition grasp, hold, release trên human hand, parallel-jaw gripper và hai dexterous robot hands. Retrieval chỉ được thực hiện cross embodiment. GALA đạt R@1 45.67 trên human-robot track và 46.91 trên robot-only track, cao hơn METIS, native kinematics, OPFA và ablation không UEMR. Đây là test rất hay vì nó hỏi latent có nhóm được "kiểu chuyển động" qua embodiment khác nhau hay không.
Ở RoboCasa-GR1, có hai setting. Khi chỉ dùng GR-1 data, GALA đạt 55.7% success, cao hơn UniVLA 48.0, METIS 43.8, native kinematics 51.8 và OPFA 53.5. Khi co-training đa embodiment trên Fourier-hand, XHand, human-hand và Robotiq gripper data, GALA đạt 68.3% trung bình trên 24 task, cao hơn UniT 66.8 và JoyAI-RA 63.2 trong bảng paper. Ablation bỏ UEMR chỉ đạt 58.6, cho thấy UEMR không phải chi tiết phụ.
| Setting | Method | Success |
|---|---|---|
| GR-1 only | UniVLA | 48.0% |
| GR-1 only | OPFA | 53.5% |
| GR-1 only | GALA | 55.7% |
| Multi-embodiment | UniVLA | 53.6% |
| Multi-embodiment | GALA w/o UEMR | 58.6% |
| Multi-embodiment | GALA | 68.3% |
Trong real-world XHand, GALA đạt average 75.5% trên Pick, Push, Press và Flip, cao hơn HARP-VLA 71.5 và ablation w/o UEMR 68.5. Đặc biệt các task Press Button và Flip Cup cần contact/finger precision, nên kết quả này hợp logic với thiết kế geometry-aware latent.
Khi nào nên dùng GALA?
GALA phù hợp khi bạn có một trong ba nhu cầu:
- Bạn muốn evaluate policy trên RoboCasa-GR1 bằng checkpoint public.
- Bạn đang nghiên cứu cross-embodiment VLA và cần một cách biểu diễn action không phụ thuộc action space gốc.
- Bạn muốn tận dụng human videos hoặc dataset robot dị biệt nhưng vẫn giữ fine-grained hand motion.
Ngược lại, nếu bạn chỉ train một robot gripper đơn giản trên vài task pick-and-place, GALA có thể là quá nặng. Một behavior cloning baseline hoặc diffusion policy 3D có thể nhanh hơn để debug. Nhưng khi bước sang humanoid manipulation, dual-hand dexterity hoặc multi-embodiment pretraining, ý tưởng UEMR rất đáng đưa vào stack.
Checklist debug cho beginner
Nếu chạy GALA lần đầu, hãy debug theo thứ tự này:
1. python --version đúng 3.10
2. torch thấy CUDA
3. flash-attn import được
4. RoboCasa assets tải xong
5. MUJOCO_GL=egl render được
6. checkpoint và Qwen backbone nằm đúng path
7. run_eval smoke test với N_EPISODES=1, EVAL_MAX_TASKS=1
8. xem results.json và video output trước khi chạy full 24 tasks
Đừng bỏ qua video rollout. Success rate chỉ nói cuối episode có đạt condition hay không; video cho bạn biết lỗi thật là perception, timing, collision, gripper closure, hay action chunk quá dài.
Kết luận
GALA là một ví dụ đẹp của hướng VLA mới: không chỉ scale model, mà scale biểu diễn hành động. Bằng cách kết hợp visual latent action với geometric latent action, rồi dùng UEMR để giữ motion semantics qua human hand, robot hand và gripper, GALA làm cho multi-embodiment pretraining bớt phụ thuộc vào action schema thủ công. Trên RoboCasa-GR1, kết quả 68.3% cho thấy latent hình học không chỉ là ý tưởng đẹp trên paper; nó cải thiện downstream policy rõ ràng.
Nếu bạn đang xây VLA stack cho humanoid hoặc robot dexterous, hãy xem GALA như một pattern: giữ native action để deploy, nhưng học một latent action chung để pretrain và transfer.