Proxy Policy Steering, viết tắt PPS, là một ý tưởng rất đáng chú ý cho người đang triển khai VLA trên robot thật: thay vì fine-tune trực tiếp base model như π0.5, ta giữ nguyên toàn bộ base VLA, huấn luyện hai policy nhỏ làm "proxy", rồi dùng chênh lệch giữa chúng để bẻ hướng quá trình sampling ở inference time. Paper gốc Proxy Policy Steering của Chuanruo Ning, Tianrui Wang, Wei-Chiu Ma và Kuan Fang được công bố tại CoRL 2026, có project page tại ppsteering.github.io, arXiv 2609.09148, và repo chính thức TritiumR/pps.
Nếu bạn từng fine-tune VLA bằng LoRA hoặc supervised imitation learning, vấn đề paper này nhắm tới sẽ rất quen. Base model như π0.5 có prior manipulation rất rộng: biết grasp, biết recover, biết phản ứng với nhiều object và nhiều trạng thái lạ. Nhưng khi đưa vào một task cụ thể như mở nắp nồi rồi bỏ trứng vào, rót trà vào cốc, đặt trái cây lên cân, hay nhét utensil vào holder, base policy thường chỉ "gần đúng". Fine-tune trực tiếp có thể kéo policy vào task mới, nhưng cũng dễ làm mất recovery behavior và những prior mà demonstration nhỏ không bao phủ. PPS chọn một đường khác: không sửa base, chỉ thêm một vector steering trong velocity space của flow-matching sampler.
Trực giác: tại sao cần hai proxy policy?
Một proxy policy duy nhất nghe có vẻ đủ: train một policy nhỏ trên demonstration, rồi dùng nó để kéo base policy theo task. Nhưng policy nhỏ học từ 50 demo không chỉ chứa "tín hiệu task". Nó còn chứa lỗi xấp xỉ do model nhỏ hơn, dataset ít hơn, visual encoder khác hơn, và distribution training hẹp hơn base VLA. Nếu lấy thẳng velocity của policy nhỏ trừ vào base, ta có nguy cơ steering cả những bias không liên quan.
PPS xử lý điểm này bằng hai proxy:
| Proxy | Cách train | Vai trò |
|---|---|---|
π_ref reference proxy |
Distill từ frozen base trên observation của task | Học hành vi base trong vùng trạng thái liên quan đến task |
π_task task proxy |
Khởi tạo từ π_ref, rồi train trên demonstration task |
Học phần thay đổi do task supervision tạo ra |
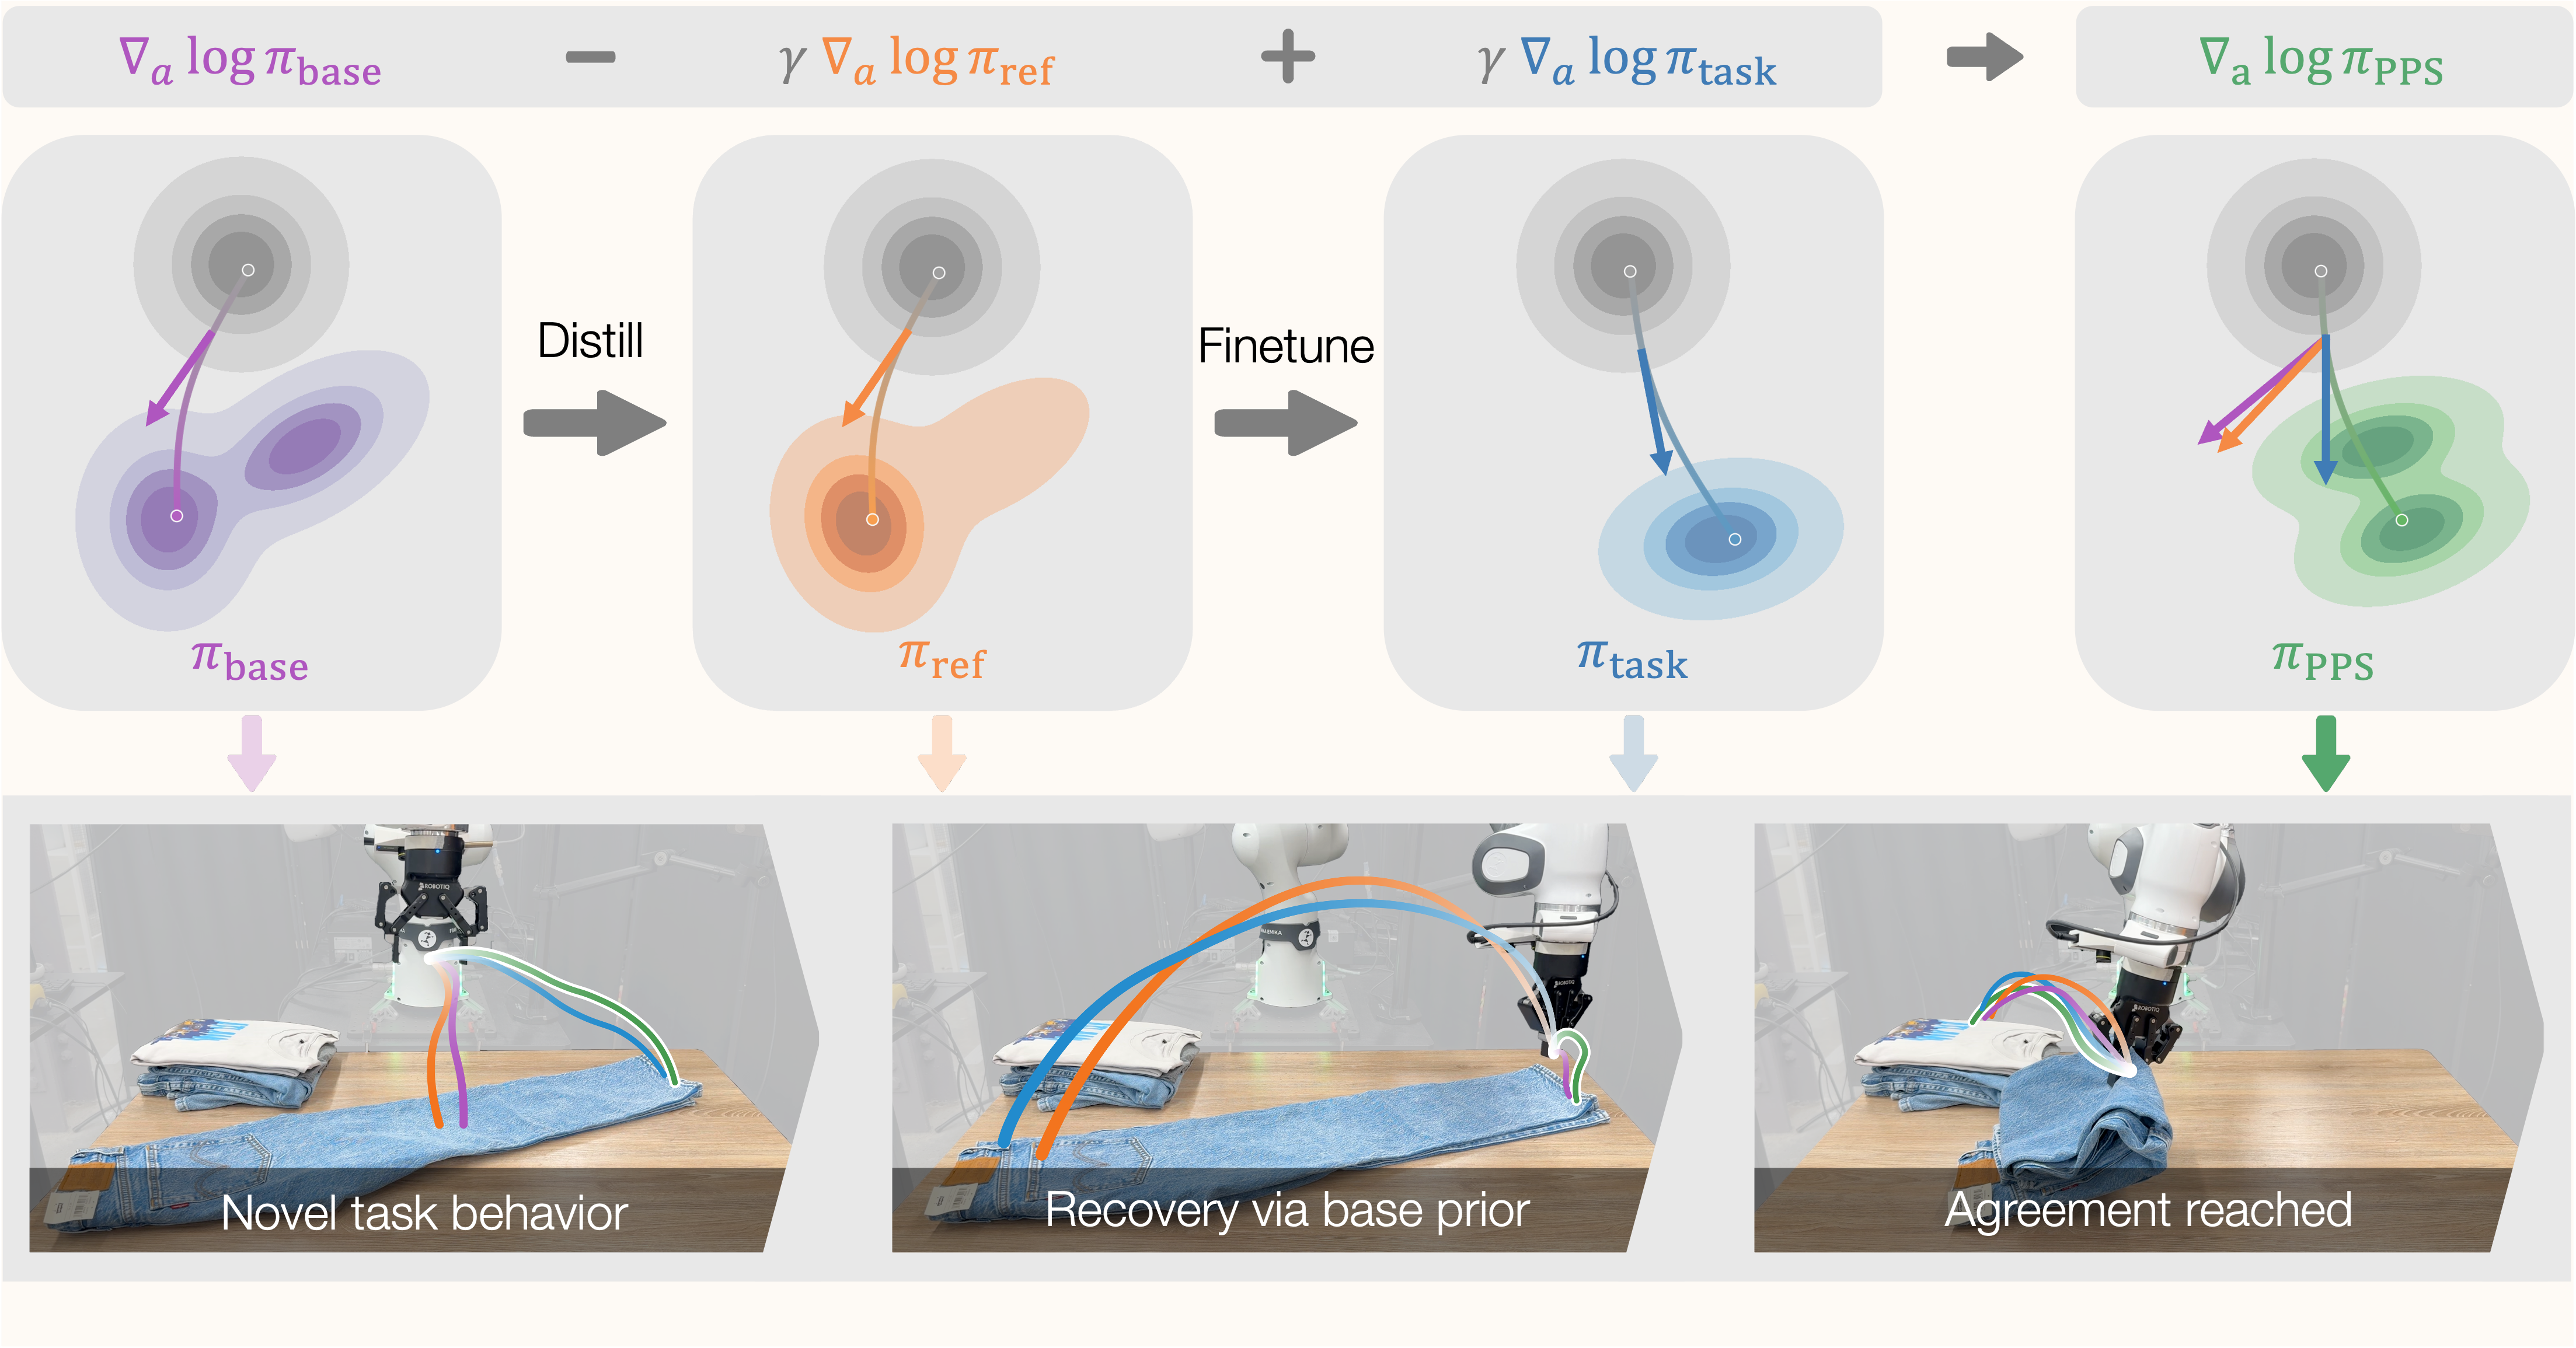
Điểm mấu chốt là π_task và π_ref có cùng kiến trúc, cùng action representation, cùng flow-matching schedule, và π_task bắt đầu từ checkpoint của π_ref. Vì vậy, nếu lấy velocity residual v_task - v_ref, phần lỗi chung của proxy có xu hướng triệt tiêu, còn phần còn lại biểu diễn "task supervision muốn thay đổi base theo hướng nào".
Công thức inference của PPS rất gọn:
v_PPS(x, k, o, l) = v_base(x, k, o, l) + γ * (v_task(x, k, o) - v_ref(x, k, o))
Trong đó x là noisy action chunk ở noise level k, o là observation, l là language instruction, và γ là steering strength. Repo chính thức triển khai đúng tinh thần này bằng dòng:
v_t[:, :, :proxy_action_dim] += steer_scale * (task_v_t - ref_v_t)
Khi base đang đi sai mode nhưng task proxy đã học mode thành công, residual kéo denoising trajectory sang hướng task. Khi trạng thái nằm ngoài demo hoặc hai proxy đồng ý với nhau, residual nhỏ đi và base prior tiếp tục điều khiển. Đây là lý do PPS có thể recover sau perturbation dù demonstration không chứa recovery trajectory.
Kiến trúc trong paper
PPS được thiết kế cho VLA kiểu flow matching, nơi policy không trả ra xác suất action rõ ràng mà trả ra velocity field để biến noise thành action. π0 và π0.5 thuộc nhóm này: model lấy ảnh, robot state và language instruction, rồi sinh action chunk bằng nhiều bước denoising/flow integration.
Trong paper, base policy là frozen π0.5 khoảng 3B parameter. Hai proxy là policy nhỏ hơn nhiều: dùng DINOv3 ViT-S/16 làm visual encoder và một action expert transformer nhỏ theo phong cách Gemma, hồi quy flow-matching velocity trên cùng action space. Appendix mô tả proxy policy chỉ ở cỡ vài chục triệu parameter, nhỏ hơn rất nhiều so với base VLA. Điều quan trọng là proxy không cần truy cập gradient hay weight của base; nó chỉ cần gọi base để lấy forward velocity prediction trong stage distillation.
Pipeline inference có thể hình dung như sau:
Observation + instruction
        |
        v
Frozen π0.5 base predicts v_base
        |
        +-----------------------------+
        |                             |
        v                             v
Reference proxy predicts v_ref   Task proxy predicts v_task
        |                             |
        +-------------+---------------+
                      v
          residual = v_task - v_ref
                      |
                      v
guided velocity = v_base + γ * residual
                      |
                      v
flow sampler outputs action chunk
                      |
                      v
robot executes first actions, then replans
Paper chạy policy ở 15 Hz. Mỗi lần model sinh action chunk dài 15 bước và thực thi 8 bước đầu trước khi replan. PPS áp dụng guided velocity ở từng denoising step, chứ không phải chỉ sửa action cuối cùng sau khi sample xong. Đây là khác biệt lớn so với residual controller thông thường: PPS can thiệp vào đường đi của sampler, nên có thể đổi action mode từ sớm.
Cài đặt repo chính thức
Repo TritiumR/pps gồm bốn phần chính:
eval_steering.py       rollout với base + task proxy + reference proxy
eval_pi.py             rollout π0 / π0.5 không steering
run_eval_chain.sh      chạy nhiều task liên tiếp
task_prompts.json      task id, prompt và checkpoint path

openpi/                fork OpenPI: model, config, train, distill, serve
IsaacLab/              IsaacLab code + manipulation tasks
droid/                 real-robot stack
media/teaser.gif       teaser GIF trong README
Để đánh giá simulation, bạn cần GPU có NVIDIA Isaac Sim/IsaacLab dependency. Repo đã bundle IsaacLab/, nên không cần checkout IsaacLab riêng. Trước hết cài helper để tải asset/checkpoint:
pip install huggingface_hub
Từ root repo, tải scene/object assets và proxy checkpoints:
python IsaacLab/fetch_assets.py
python openpi/fetch_checkpoints.py
Asset simulation khoảng 2.7 GB, proxy checkpoints khoảng 0.8 GB. Repo cũng cho phép tải subset:
python openpi/fetch_checkpoints.py --task pot weight
Một chi tiết dễ vấp: checkpoint phải nằm dưới thư mục tên đúng là checkpoints. Script eval_steering.py suy ra training config bằng cách tìm segment checkpoints trong path rồi đọc segment kế tiếp. Nếu bạn giải nén sang path tùy ý, script có thể báo lỗi không derive được config.
Layout mong đợi:
openpi/checkpoints/
├── pytorch/pi05_droid_jointpos/                    # base policy, tự cung cấp
├── proxy_isaaclab_droid_pot_pi05_jointpos/
│   ├── reference/20000/
│   └── task/24000/
├── proxy_isaaclab_droid_tea_pi05_jointpos/
│   ├── reference/20000/
│   └── task/32000/
└── proxy_isaaclab_droid_weight_pi05_jointpos/
    ├── reference/20000/
    └── task/24000/
Lưu ý quan trọng: repo không phát hành base checkpoint pi05_droid_jointpos. Bạn phải tự đặt checkpoint π0.5 đã train vào openpi/checkpoints/pytorch/pi05_droid_jointpos trước khi chạy evaluation.
Training: distill reference rồi train task proxy
Training PPS có hai stage. Cả hai chạy từ thư mục openpi/, và tên <train-config> phải khớp config trong openpi/src/openpi/training/config.py, ví dụ proxy_isaaclab_droid_pot_pi05_jointpos.
Stage 1 là on-policy reference distillation. Ta cho base π0.5 sinh trajectory/noisy states trên observation task, rồi train π_ref bắt chước velocity của base trên chính vùng mà sampler sẽ đi qua:
cd openpi

uv run scripts/distill_pytorch.py proxy_isaaclab_droid_pot_pi05_jointpos \
  --exp_name reference \
  --teacher_checkpoint_dir checkpoints/pytorch/pi05_droid_jointpos
Kết quả điển hình:
checkpoints/proxy_isaaclab_droid_pot_pi05_jointpos/reference/20000
Stage 2 là task specialization. Ta khởi tạo π_task từ checkpoint reference, rồi train bằng demonstration của task:
uv run scripts/train_pytorch.py proxy_isaaclab_droid_pot_pi05_jointpos \
  --exp_name task \
  --pytorch_weight_path checkpoints/proxy_isaaclab_droid_pot_pi05_jointpos/reference/20000
Kết quả thường có nhiều checkpoint:
checkpoints/proxy_isaaclab_droid_pot_pi05_jointpos/task/8000
checkpoints/proxy_isaaclab_droid_pot_pi05_jointpos/task/16000
checkpoints/proxy_isaaclab_droid_pot_pi05_jointpos/task/24000
Paper dùng 50 demonstration cho mỗi task real-world. Với simulation, demonstration được sinh bằng MimicGen từ 5 source teleoperation demonstrations. Đây là setup khá thân thiện với lab nhỏ: bạn không cần hàng nghìn trajectory, nhưng cần demonstration sạch, đúng action space, và reset/evaluation protocol nghiêm túc.
Inference và evaluation
Để chạy một task steered trong simulation, ví dụ task mở nắp nồi và bỏ trứng vào:
CFG=openpi/checkpoints/proxy_isaaclab_droid_pot_pi05_jointpos

python eval_steering.py \
  --task "Isaac-Pot-Droid-Visuomotor-v0" \
  --exp_name eval_pps \
  --base_checkpoint_dir openpi/checkpoints/pytorch/pi05_droid_jointpos \
  --task_checkpoint_dir "$CFG/task/24000" \
  --ref_checkpoint_dir  "$CFG/reference/20000" \
  --prompt "remove the lid of the pot and put egg in it" \
  --steer_scale 0.4 \
  --task_num_steps 1200
Nếu muốn chạy base π0.5 không steering để so sánh, dùng eval_pi.py:
python eval_pi.py \
  --task "Isaac-Pot-Droid-Visuomotor-v0" \
  --model_name pi05_droid_jointpos \
  --checkpoint_dir openpi/checkpoints/pytorch/pi05_droid_jointpos \
  --prompt "remove the lid of the pot and put egg in it" \
  --name eval_pi05 \
  --max_steps 1200
Repo có run_eval_chain.sh để chạy lần lượt các task đã release:
./run_eval_chain.sh
./run_eval_chain.sh pot weight
./run_eval_chain.sh --list
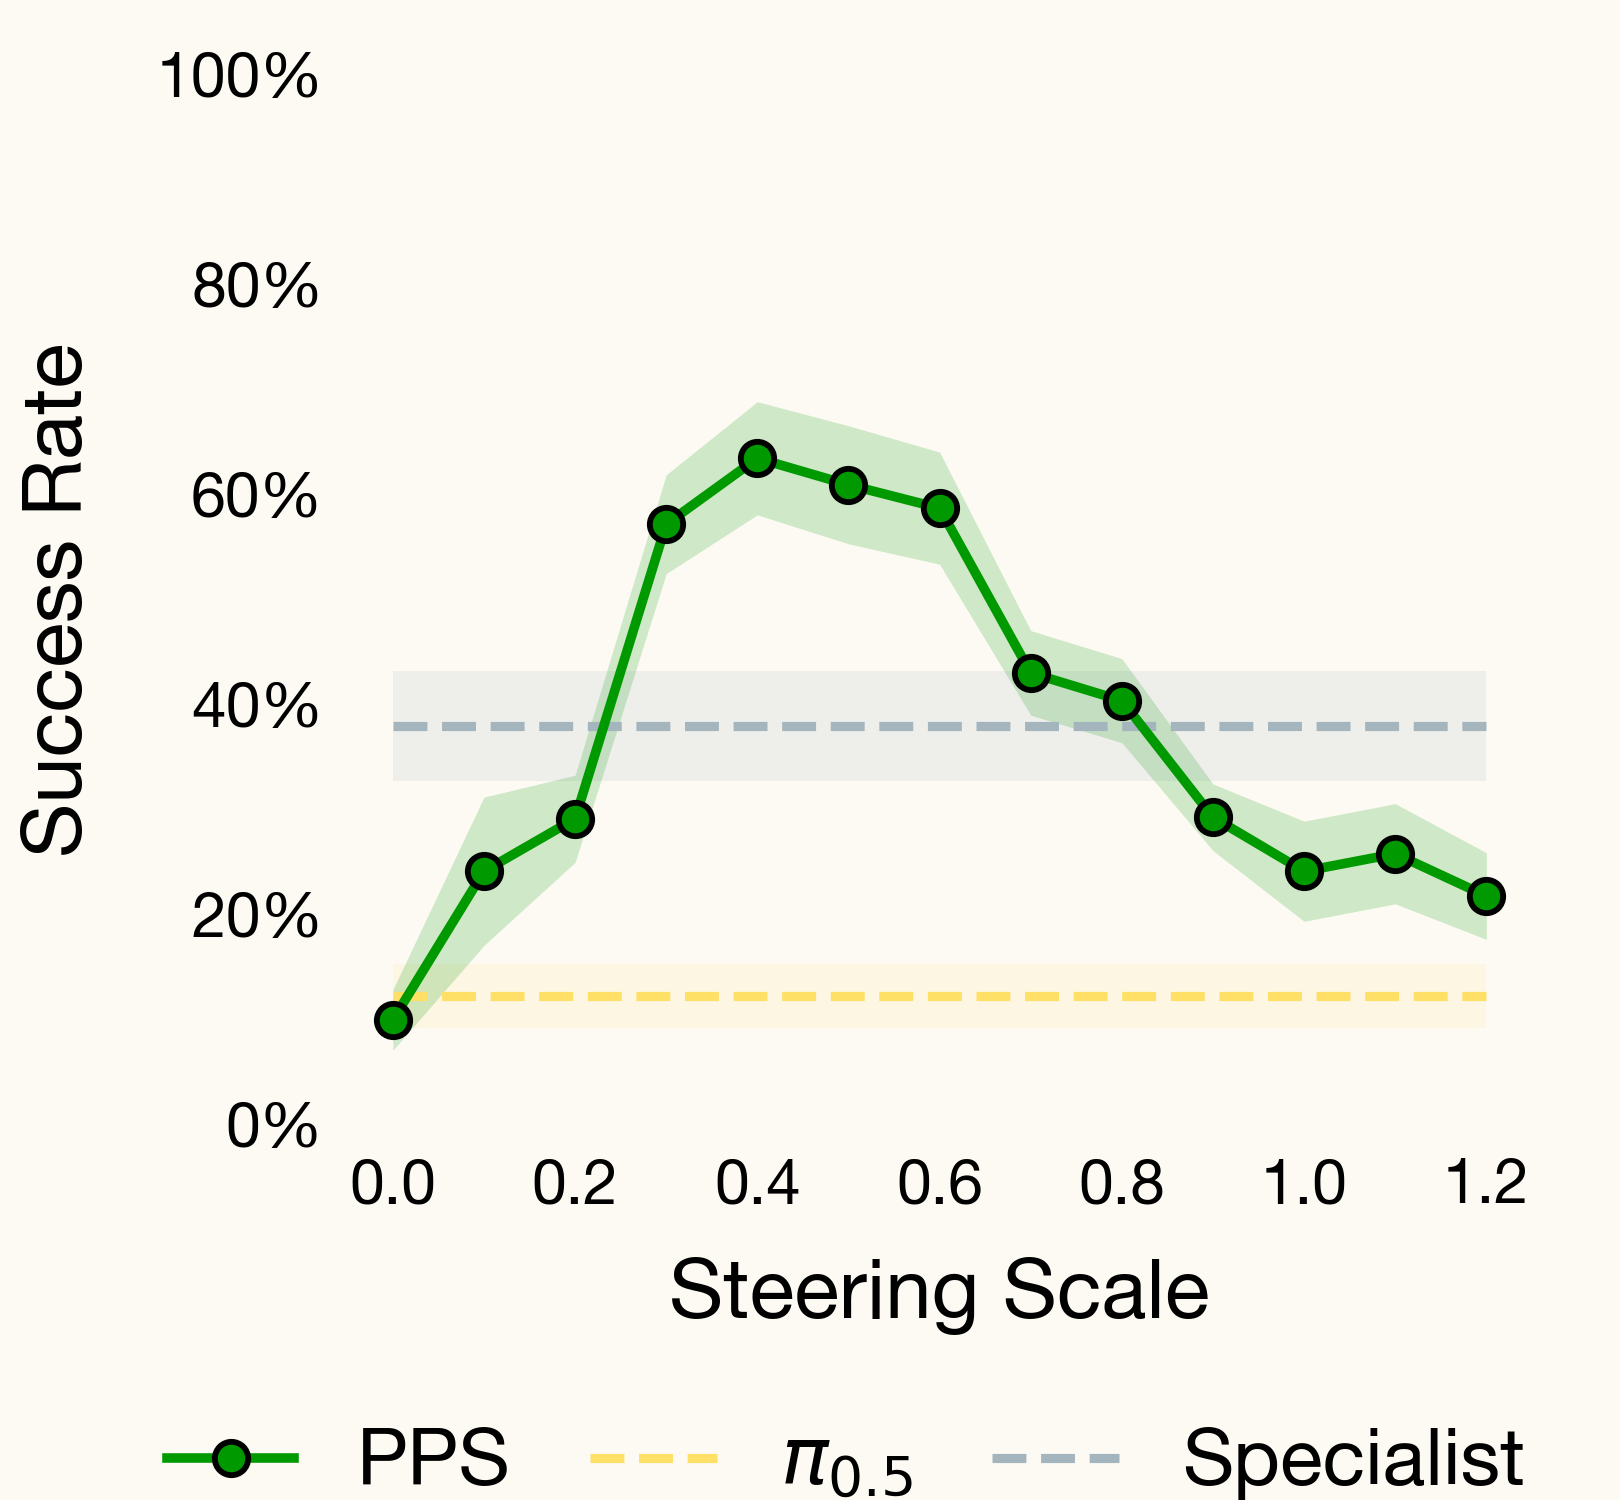
STEER_SCALE mặc định là 0.4. Paper sweep γ và thấy vùng tốt nhất thường nằm khoảng 0.4-0.6 trong regime 50 demonstration. Nếu γ quá thấp, PPS gần như base policy. Nếu quá cao, task proxy lấn át base prior và dễ mất khả năng recover.
Kết quả chính
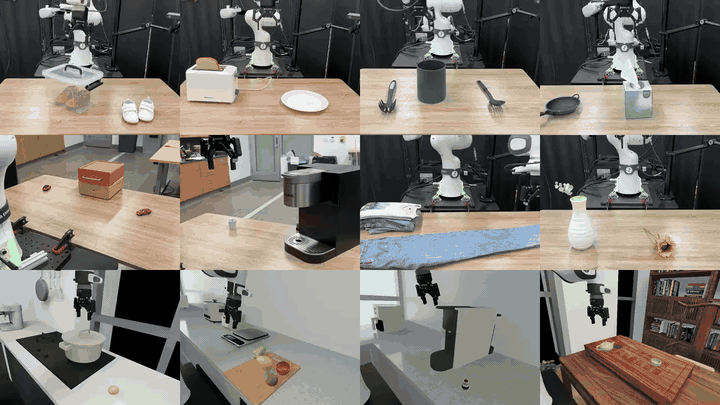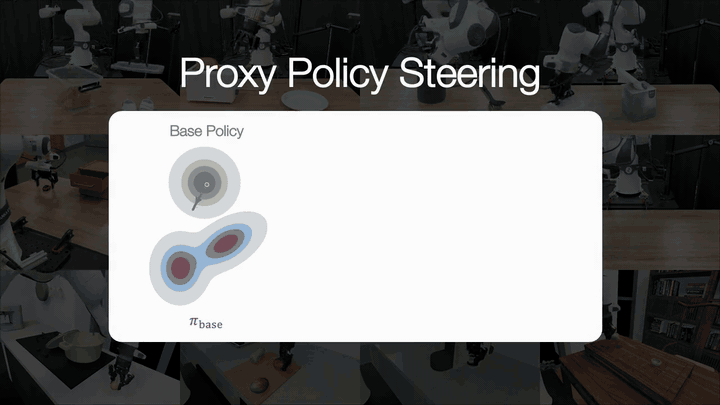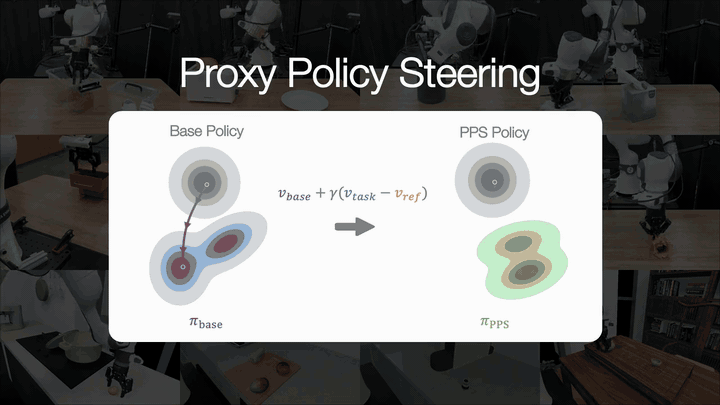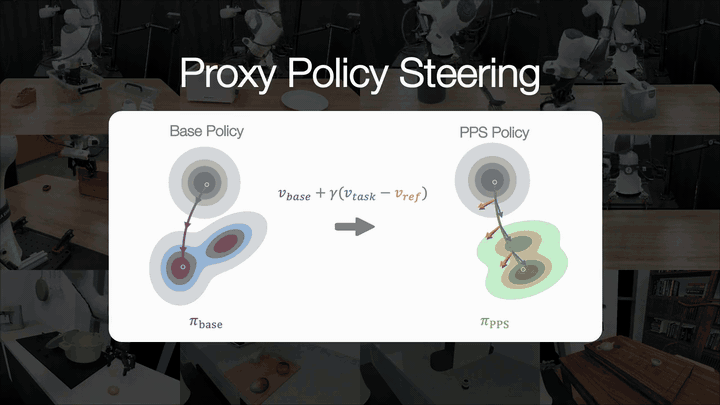
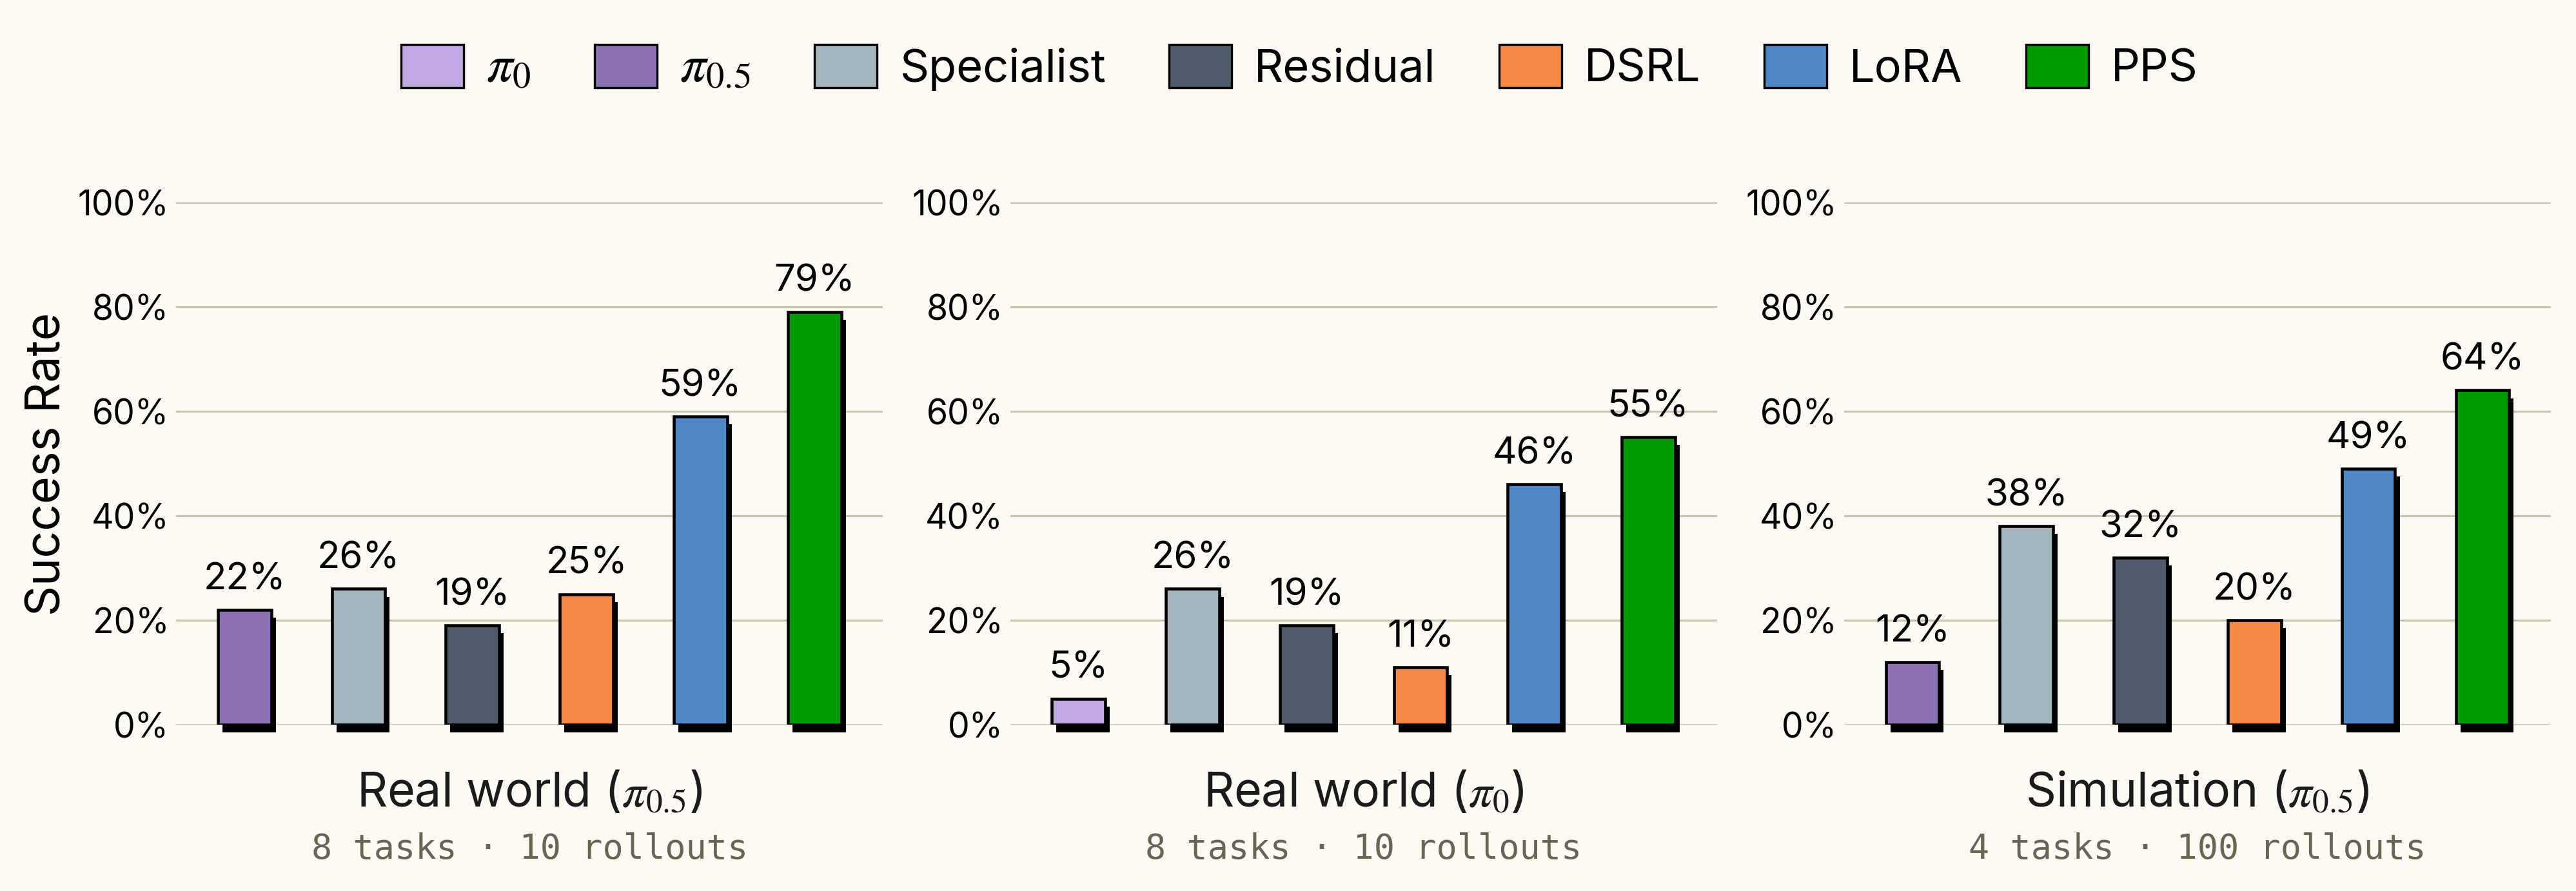
PPS được đánh giá trên 8 task real-world và 4 task simulation, gồm long-horizon manipulation, articulated object, deformable object và những task nằm ngoài distribution base policy. Real-world setup theo DROID, có một third-person camera và một wrist camera. Mỗi method chạy 10 rollout/task trong real world; simulation chạy 100 rollout/task với initial configuration randomized.
Kết quả headline từ project page và paper:
| Nhóm đánh giá | Base | PPS | Ý nghĩa |
|---|---|---|---|
| π0.5 real-world average | 22% | 79% | Tăng 57 điểm trên 8 task |
| π0.5 simulation average | 12% | 64% | Tăng 52 điểm trên 4 task |
| π0 real-world transfer | 5% | 55% | Công thức không phụ thuộc riêng π0.5 |
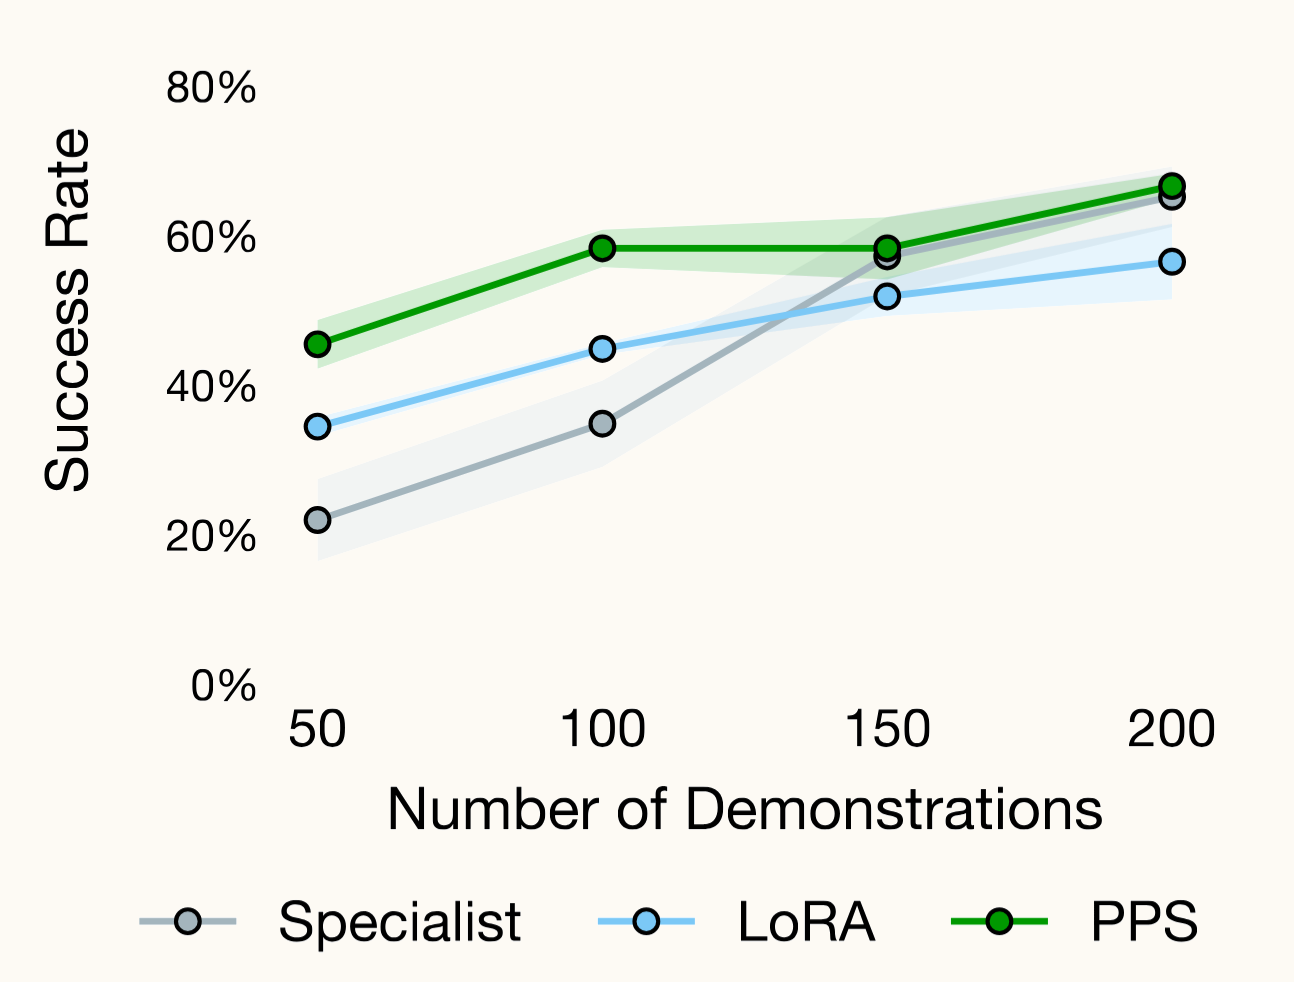
Paper tóm tắt mức tăng trung bình là khoảng 55% absolute success rate cho π0.5, với zero-to-one gain trên nhiều task mà base chưa từng solve. PPS cũng vượt LoRA fine-tuning, specialist train-from-scratch, residual policies và các inference-time steering baseline trước đó.
Điểm quan trọng không chỉ là success rate cuối cùng. PPS giữ được base capability vì base model không bị sửa. Trong thí nghiệm perturbation giữa rollout, PPS chỉ mất 7.8 điểm success rate, trong khi LoRA mất 15.8 điểm; biến thể PPS bỏ reference proxy mất tới 26.1 điểm. Điều này khớp với trực giác: nếu không có reference proxy, residual trộn lẫn task signal với proxy bias, làm policy kém ổn định hơn khi trạng thái lệch khỏi demonstration.
Những ablation đáng nhớ
Paper có ba ablation rất hữu ích nếu bạn muốn tự tái lập PPS.
Thứ nhất, w/o ref thay v_ref bằng base velocity hoặc bỏ reference proxy. Success simulation giảm rõ rệt vì residual không còn là "task change" sạch nữa. Reference proxy không chỉ là một baseline phụ; nó là phần giúp task proxy và base nói chung một ngôn ngữ xấp xỉ.
Thứ hai, w/o vel distill reference theo clean action thay vì velocity. Vì inference steering diễn ra trong velocity space ở nhiều noise level, supervision sai không gian làm v_ref kém alignment với base sampler.
Thứ ba, w/o tune train task proxy từ scratch thay vì initialize từ reference. Khi đó π_task và π_ref khác nhau vì cả random initialization, optimizer path và task supervision, khiến v_task - v_ref không còn cô lập được task signal.
Khi nào nên dùng PPS?
PPS hợp với tình huống bạn có một base flow-matching VLA mạnh, muốn chuyên biệt hóa cho task manipulation mới, nhưng không muốn đụng vào weight của base. Ví dụ: lab có checkpoint π0.5 đã chạy tốt nhiều task, nhưng task deployment cần thêm một skill chính xác; bạn có 50-200 demonstration chất lượng; bạn muốn giữ recovery behavior; và bạn có thể chịu thêm chi phí inference của hai proxy nhỏ.
PPS không phải cây đũa thần. Paper cũng nêu giới hạn: nghiên cứu chủ yếu ở single-task regime; base và proxy cần dùng chung action representation/schedule; nếu base quá yếu hoặc không có prior hữu ích cho task, train specialist từ scratch có thể hợp lý hơn. Ngoài ra, repo hiện release checkpoint cho một số task simulation như pot, tea, weight; task capsule xuất hiện trong JSON nhưng checkpoint không nằm trong release, nên bạn phải tự train nếu muốn dùng.
Với beginner, cách học tốt nhất là chạy baseline eval_pi.py trước, sau đó chạy eval_steering.py với steer_scale=0.4, rồi sweep nhẹ 0.2, 0.4, 0.6, 0.8. Khi đọc rollout video, hãy nhìn ba loại lỗi: base chọn sai mode, task proxy overfit demonstration, và PPS có recover khi object bị lệch hay không. Nếu PPS chỉ cải thiện khi scene giống hệt demo, dữ liệu của bạn có thể quá hẹp hoặc reference distillation chưa bám base đủ tốt.
Checklist triển khai nhanh
1. Chuẩn bị base π0.5 checkpoint cùng action representation với proxy.
2. Thu 50+ demonstration sạch cho task.
3. Đăng ký dataset và train config trong OpenPI fork.
4. Distill reference proxy từ frozen base trên observation task.
5. Train task proxy từ checkpoint reference.
6. Chạy eval_pi.py để có baseline không steering.
7. Chạy eval_steering.py với γ = 0.4.
8. Sweep γ và kiểm tra recovery behavior, không chỉ success rate.
9. Nếu deploy robot thật, đo latency vì PPS thêm hai forward pass proxy mỗi denoising step.
Thông điệp lớn của PPS là: adaptation cho VLA không nhất thiết phải là fine-tune base. Nếu base policy đã chứa prior rộng, đôi khi cách tốt hơn là giữ nó nguyên vẹn, học một "hướng sửa" nhỏ nhưng được hiệu chuẩn, rồi steering sampler ở đúng không gian mà model dùng để sinh action. Với manipulation cần độ tin cậy cao và dữ liệu task ít, đây là một hướng rất đáng đưa vào toolbox.