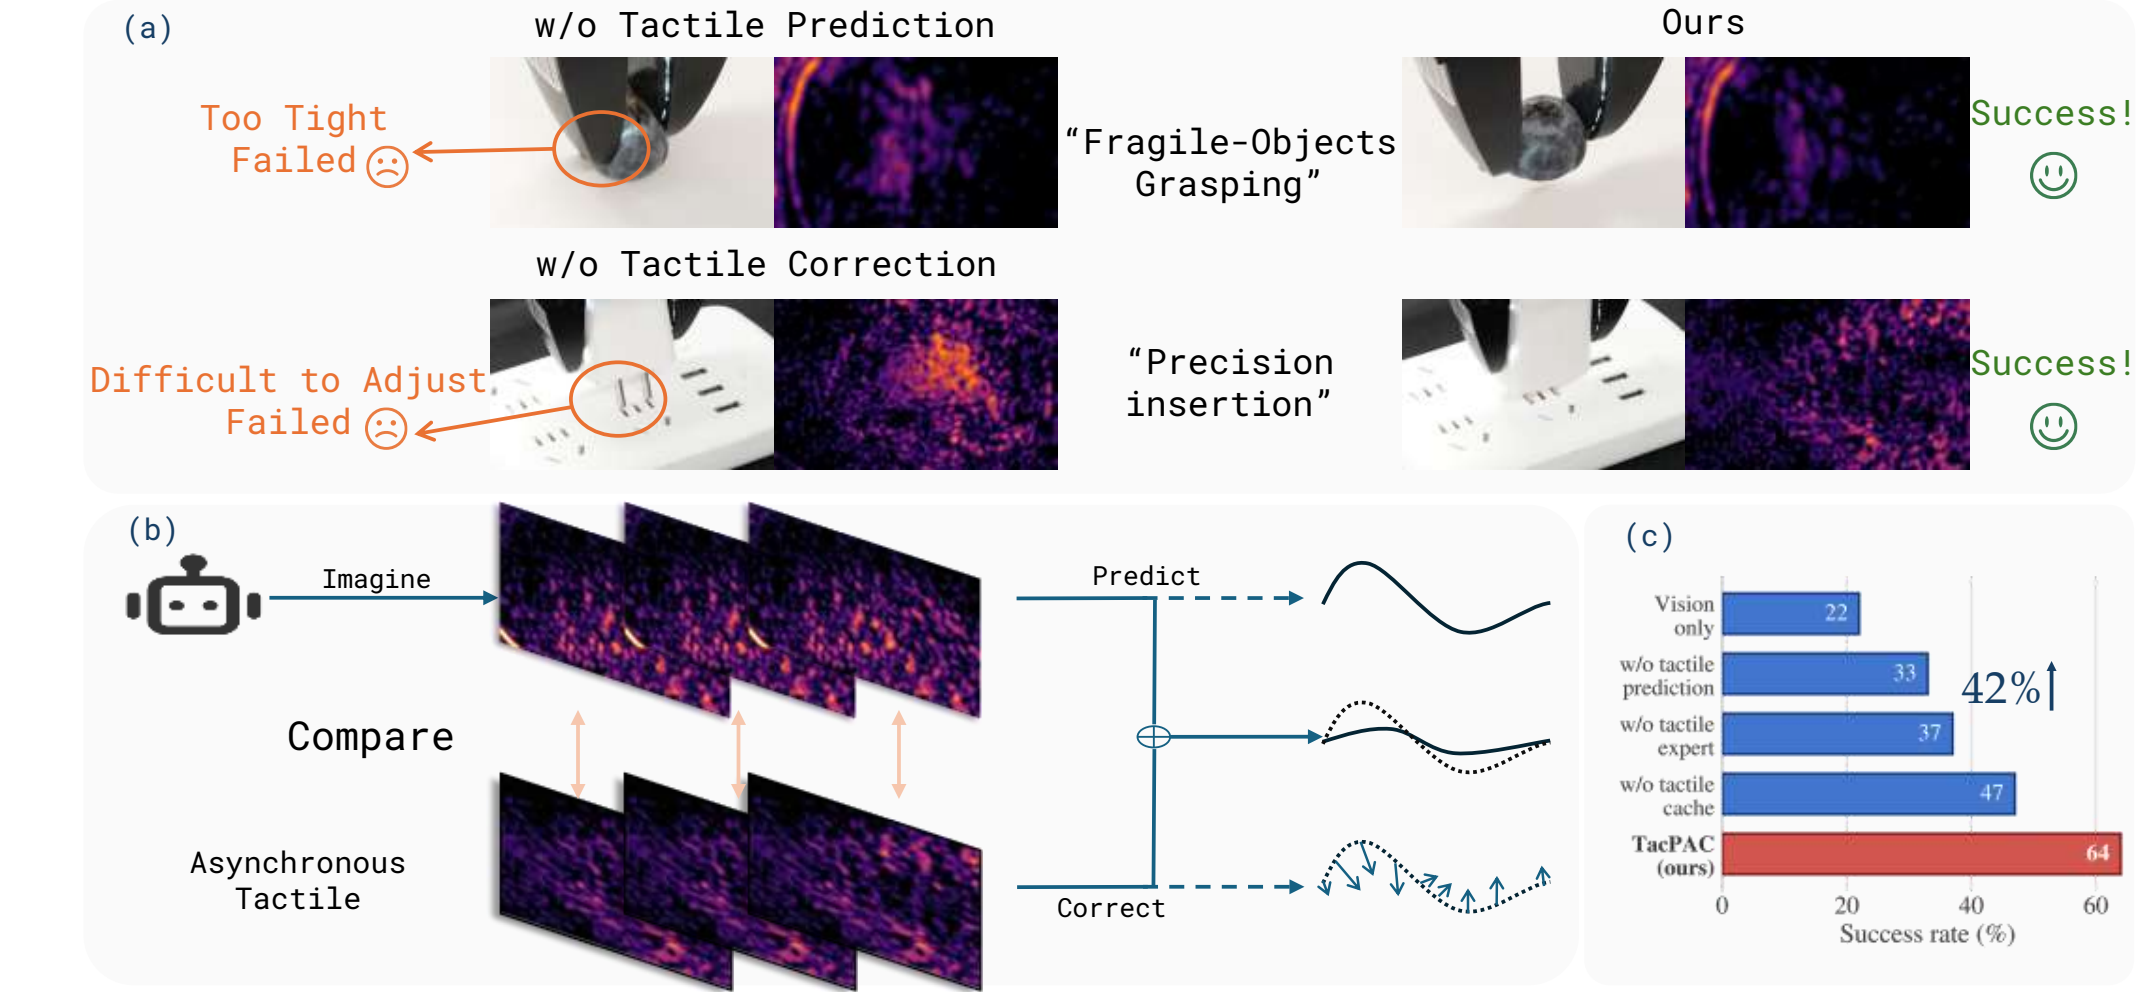
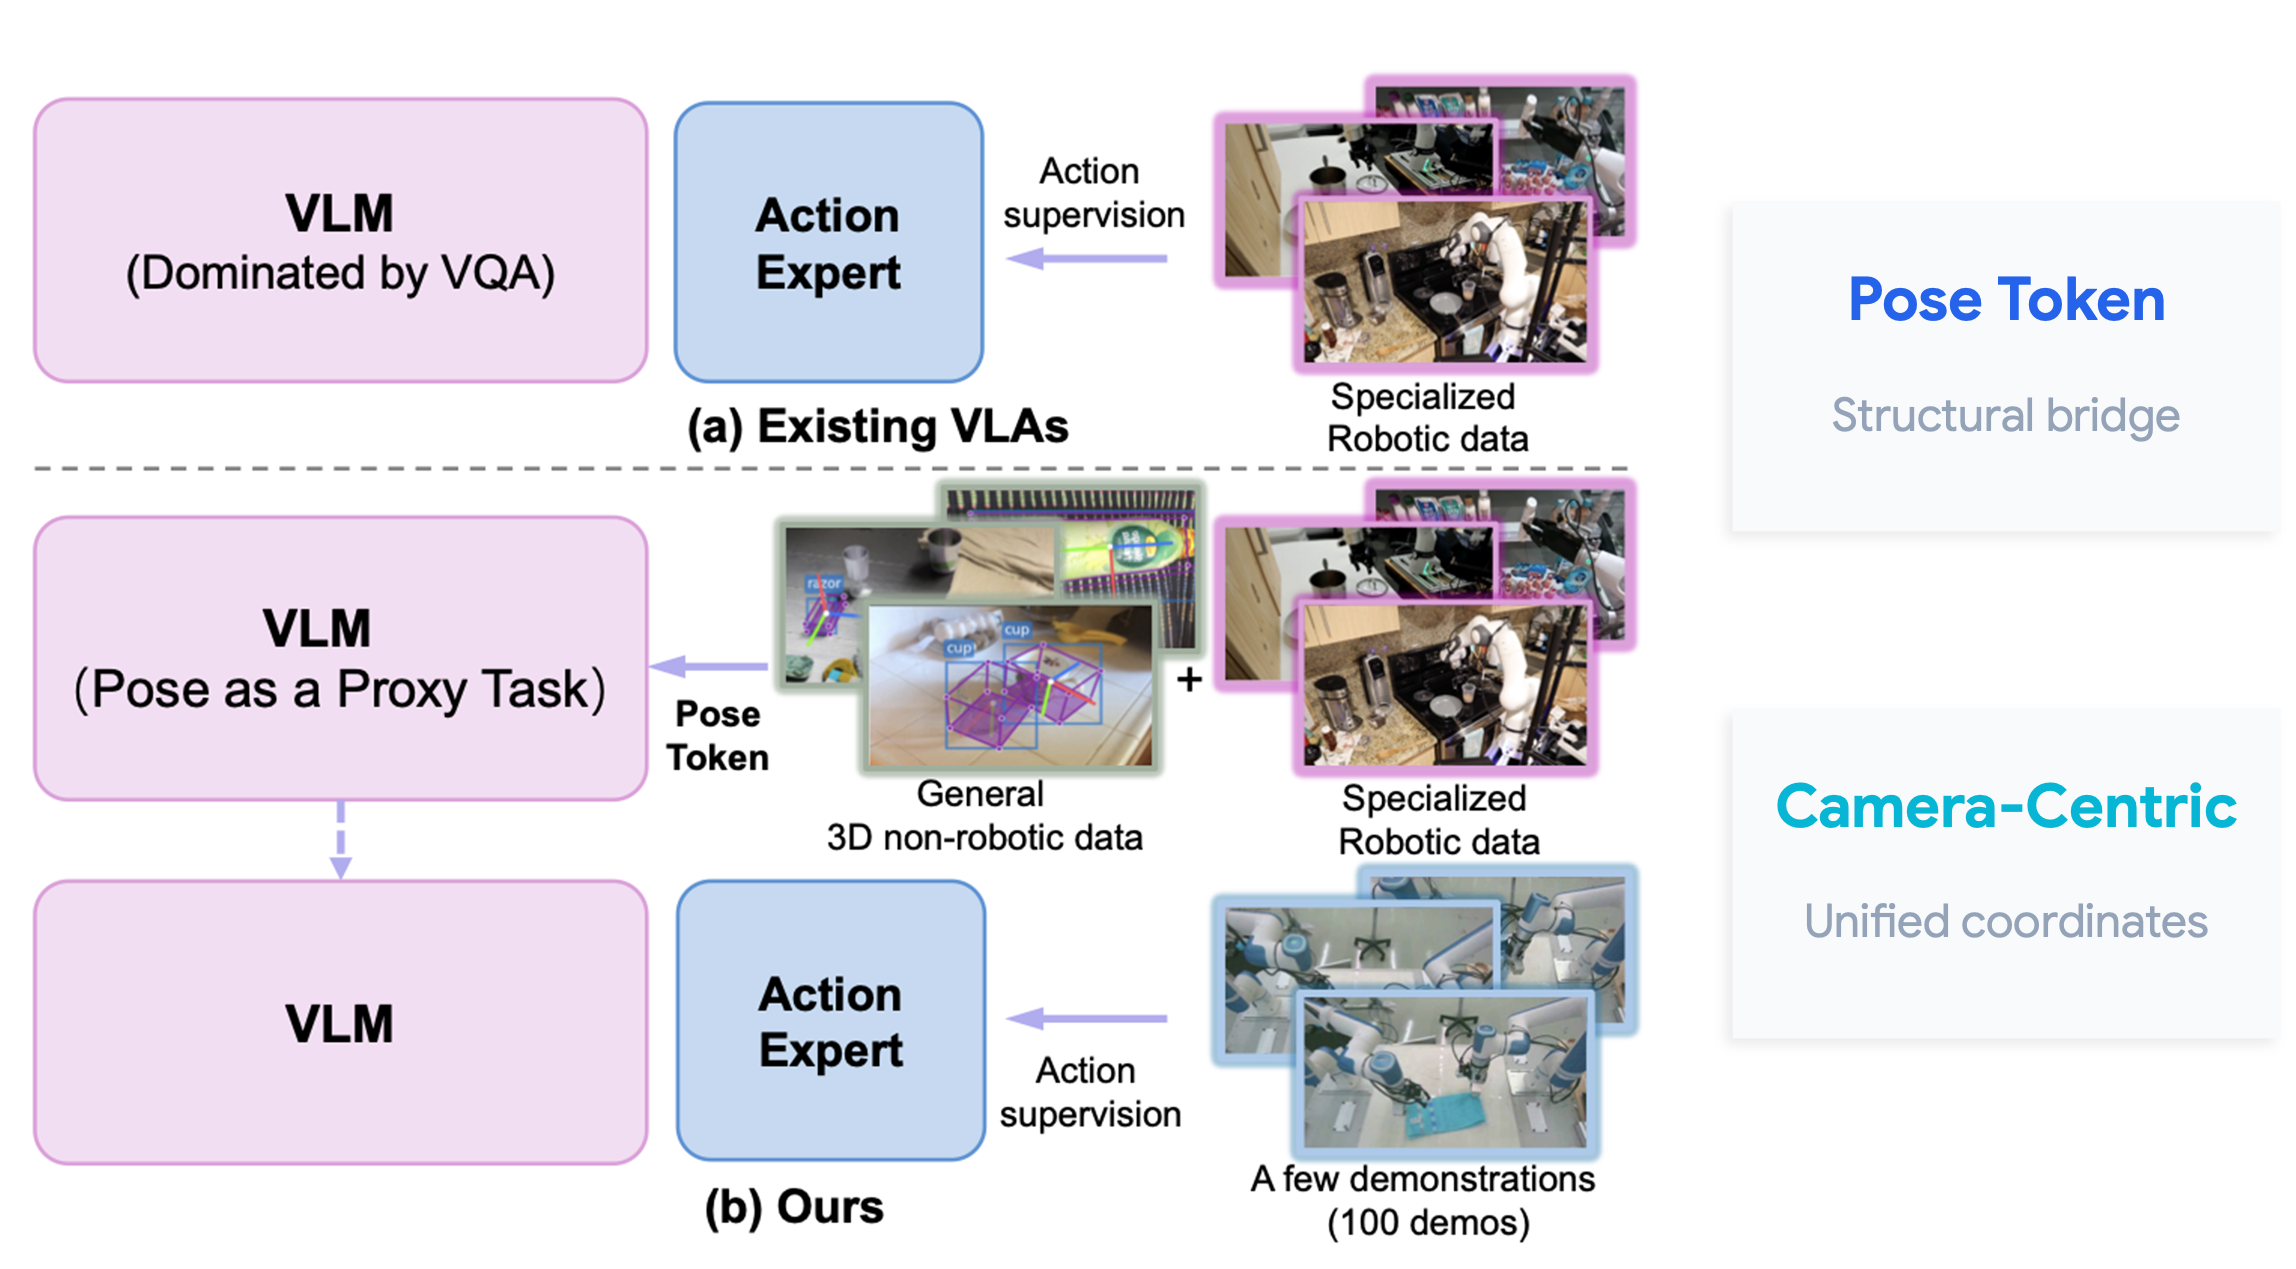
Trong robot manipulation, một policy chạy đẹp trong video demo thường vẫn thất bại vì những lỗi rất nhỏ: gripper đóng lệch vài centimet, vật bị xoay ngoài dự kiến, một chiếc giày bị đặt chéo, hoặc hai tay robot không còn đồng bộ sau một va chạm nhẹ. Với Vision-Language-Action (VLA), lỗi này còn khó chịu hơn vì policy thường được train chủ yếu trên expert demonstrations thành công. Khi trạng thái hiện tại lệch khỏi quỹ đạo "đẹp" trong data, model có thể không biết phải tự quay lại thế nào. Paper CARE: Experience-Guided Atomic Corrective Execution for Vision-Language-Action Policies đề xuất một câu trả lời thực dụng: đừng chỉ né failure, hãy biến failure rollout thành dữ liệu huấn luyện recovery.
Bài này là hướng dẫn đọc paper và repo CARE cho beginner đã biết Python/PyTorch cơ bản, từng nghe về VLA như π0 hoặc π0-FAST, và muốn hiểu cách làm failure recovery trên RoboTwin 2.0. Ta sẽ đi qua ý tưởng paper, kiến trúc, cách cài môi trường, cách thu failure distribution, tạo corrective demonstrations, train policy, inference với monitor 3D, rồi đọc kết quả. Repo gốc nằm ở xiaojunlan/care, paper ở arXiv:2609.24118, và môi trường simulation dựa trên RoboTwin 2.0.
Vấn đề CARE giải quyết
Nhiều VLA hiện nay làm tốt khi bắt đầu từ clean initial state. Người dùng đưa instruction như "place the bread in the skillet", robot nhìn scene, policy sinh action, và benchmark tính success/failure ở cuối episode. Nhưng deployment thật hiếm khi sạch như vậy. Object có thể trượt sau khi gripper chạm vào, vật bị nghiêng khi nâng, target bị che bởi một vật khác, hoặc robot release hơi sớm. Một lỗi nhỏ trong atomic stage đầu có thể làm hỏng toàn bộ long-horizon task.
Các hướng recovery cũ thường rơi vào ba nhóm. Nhóm thứ nhất phát hiện lỗi rồi rollback hoặc replan từ một trạng thái trước đó. Nhóm này hữu ích nhưng hay xem failure như ngoại lệ cần xóa, không phải dữ liệu để học. Nhóm thứ hai tạo perturbation ngẫu nhiên quanh expert state rồi thu corrective demonstrations. Cách này có data recovery, nhưng perturbation ngẫu nhiên không chắc giống lỗi thật mà policy tạo ra. Nhóm thứ ba dùng VLM judge hoặc world model để phán đoán lỗi, nhưng có rủi ro hallucination, latency hoặc thiếu grounding vật lý.
CARE đặt câu hỏi khác: policy thường thất bại theo kiểu nào ở từng atomic stage, và ta có thể train VLA phục hồi đúng từ những kiểu lệch đó không? Thay vì giả định lỗi là nhiễu uniform quanh expert trajectory, CARE chạy nominal policy, thu failed rollouts, đo lệch hình học tại thời điểm quan trọng, fit phân phối failure theo stage, rồi dùng phân phối đó để sinh failure state mới. Sau đó hệ thống thu short corrective demonstrations để VLA học cách tự sửa.
Với reader của vnrobo, điểm đáng học nhất không chỉ là CARE tăng success rate. Điểm quan trọng là methodology: failure recovery nên là một capability riêng trong stack VLA, có dữ liệu riêng, benchmark riêng và cơ chế inference riêng. Nếu bạn đang build pipeline LeRobot/RoboTwin cho dual-arm hoặc humanoid upper-body manipulation, CARE cho một blueprint khá rõ.
Ý tưởng paper trong một hình
CARE có hai nửa ghép lại với nhau.
Nửa offline là Experience-Guided Corrective Data Synthesis. Hệ thống chạy nominal VLA chưa có recovery trong simulation hoặc real robot. Khi một atomic stage thất bại, CARE ghi lại độ lệch tại event quan trọng. Với grasping, đó có thể là lệch giữa object và gripper lúc đóng gripper. Với placement, đó có thể là lệch giữa object và target lúc release. Paper biểu diễn deviation bằng translation Δx, Δy, Δz và yaw offset Δr, rồi fit phân phối p(d | k) cho từng stage k. Họ thử các candidate distribution như Gaussian, Beta, Gamma, Weibull, Log-Normal và Uniform, chọn bằng AIC và KS test.
Sau khi có phân phối failure, CARE sample deviation mới, inject vào relative pose của stage, rồi roll forward dưới physics. Đây là chi tiết rất đáng chú ý: failure state không chỉ là replay của lỗi cũ. Nó là trạng thái mới được tạo bằng dynamics, nên object contact, gravity và tương tác với robot vẫn được mô phỏng. Trong simulation, một IK/motion-planning oracle tạo corrective demonstration ngắn. Trong real world, corrective data được thu qua teleoperation.
Nửa online là Atomic Corrective Execution. Task dài được chia thành các atomic stages. Một VLM planner, trong paper dùng GPT-4.1 ở temperature 0, phân rã instruction lớn thành stage plan. Mỗi stage có nominal instruction, geometric cues cần monitor, termination predicate, và danh sách candidate correction instruction. Sau đó, trong lúc robot chạy, một 3D geometric monitor kiểm tra trạng thái vật lý ở các thời điểm quan trọng. Nếu mọi thứ ổn, VLA tiếp tục instruction nominal. Nếu lệch nhẹ, monitor chọn intra-execution adjustment. Nếu stage đã fail, monitor chọn post-stage re-operation. Điểm hay là low-level action vẫn do cùng một VLA executor sinh ra; CARE không cần đổi sang một recovery policy riêng.
Kiến trúc chi tiết
Bạn có thể hình dung CARE như một wrapper recovery quanh VLA backbone.
| Thành phần | Vai trò | Output |
|---|---|---|
| VLM planner | Chia task thành atomic stages, định nghĩa cue và predicate | Π_k = (u_k, γ_k, ψ_k, U_k) |
| Failure distribution model | Fit lỗi thật từ failed rollouts theo từng stage | `p(d |
| Corrective data generator | Sample failure state và thu corrective segment | Recovery trajectories |
| 3D geometric monitor | Kiểm tra point cloud object, gripper, target tại event quan trọng | Nominal, adjustment hoặc re-operation |
| VLA executor | Sinh action từ observation và selected instruction | Robot actions |
Ở runtime, VLA executor nhận observation gồm robot state, global RGB và wrist RGB, cùng với atomic instruction đang active. Nếu monitor chọn instruction sửa lỗi, input ngôn ngữ cho policy đổi từ "place the object into the cabinet" sang một instruction atomic cụ thể hơn như "re-grasp the object with the right gripper" hoặc "adjust the left shoe toward the target region". Vì corrective behavior đã được train trong data, cùng policy có thể chạy cả nominal action lẫn corrective action.
Monitor 3D không phải một classifier học sâu. Paper mô tả nó như một predicate checker dựa trên point cloud. Tại các transition như gripper closure, object release, hoặc ngay trước transition khi cần adjustment, hệ thống dùng SAM 3 để segment gripper, manipulated object và target region, dùng Depth Anything 3 để ước lượng depth, rồi fuse thành point clouds. Từ đó monitor tính các quan hệ như gripper-object alignment, object-target displacement và post-contact stability.

Với beginner, hãy nhớ một công thức đơn giản: CARE không hỏi "ảnh này trông có fail không?" mà hỏi "quan hệ hình học cần cho stage này có còn đúng không?" Ví dụ, với placement, monitor project grasp center và target position lên support plane rồi đo khoảng cách. Với global envelope grasping, monitor so TCP với object principal axis. Với local edge grasping, monitor kiểm tra fingertip có straddle đúng edge và giữ clearance an toàn không. Cách này ít lấp lửng hơn VLM judge thuần ảnh.
FSR-Bench là gì?
CARE cũng giới thiệu Failure State Recovery Benchmark (FSR-Bench) để đánh giá recovery trực tiếp. Benchmark thông thường bắt đầu từ clean initial state và đo task success. FSR-Bench bắt đầu từ intermediate failure state và hỏi: policy có đưa task quay lại trạng thái khả thi được không?

FSR-Bench có 36 recovery scenarios trên 5 task. Nhóm Easy gồm 21 local failures thường có thể sửa bằng một operation, như grasp failure, placement offset và pose misalignment. Nhóm Hard gồm 15 structural failures cần nhiều bước hoặc coordination hai tay, như tipping, accidental drop và target occupation. Mỗi method được chạy 100 randomized trials cho từng task-regime pair, metric là Recovery Success Rate (RSR).
Điểm thiết kế hay là evaluation distribution tách khỏi training distribution. Training corrective data cho FSR-Bench được lấy bằng uniform perturbation trong range đã định, nhưng evaluation failure state được sinh từ empirical failure distribution của mixture nominal policies. Như vậy benchmark không chỉ đo "policy có học perturbation uniform không", mà đo recovery trong lỗi gần với lỗi thật do policy tạo ra.
Cài đặt CARE và RoboTwin 2.0
Repo CARE hiện ghi rõ đây là code-only snapshot trên RoboTwin 2.0: không kèm large datasets, assets, checkpoints, videos hoặc virtual environments. Vì vậy bạn không nên kỳ vọng clone repo là chạy được đầy đủ như paper ngay. Cách đúng là cài RoboTwin 2.0 trước, chuẩn bị assets riêng, rồi dùng CARE như layer cho failure modeling, corrective data và evaluation.
Theo document RoboTwin 2.0, môi trường được support tốt nhất là Linux với NVIDIA GPU. Python khuyến nghị là 3.10, CUDA khuyến nghị là 12.1, cần Vulkan/rendering support nếu chạy visual simulation. Nếu dùng Docker, biến NVIDIA_DRIVER_CAPABILITIES cần có compute,utility,graphics, vì thiếu graphics có thể gây lỗi Vulkan. Luồng cơ bản:
conda create -n RoboTwin python=3.10 -y
conda activate RoboTwin
git clone --recurse-submodules https://github.com/RoboTwin-Platform/RoboTwin.git
cd RoboTwin
bash scripts/_install.sh
bash scripts/_download_assets.sh
Sau khi RoboTwin chạy được, clone CARE vào workspace riêng:
git clone https://github.com/xiaojunlan/care.git
cd care
conda activate care
Trong README CARE, các command phải chạy từ root repo care/. Bạn cần cấu hình RoboTwin assets dưới assets/, đặc biệt embodiment path như ./assets/embodiments/aloha-agilex/. Bạn cũng cần một HTTP inference service tương thích với π0, vì evaluator của CARE dùng GET /health và các endpoint POST /set_instruction, /predict, /reset. README nhấn mạnh policy/pi0/scripts/serve_policy.py là WebSocket server và không implement HTTP interface này, nên bạn phải có service HTTP tương thích riêng.
Kiểm tra service:
curl http://127.0.0.1:5000/health
Bước 1: chạy nominal policy và đo failure
Bước đầu của CARE là chạy policy chưa có correction để thu failure. Ví dụ với task put_object_cabinet:
bash policy/pi0/eval_put_object_cabinet_no_atom.sh \
  put_object_cabinet demo_randomized 0 http://127.0.0.1:5000 100
Script này gọi policy/pi0/eval_put_object_cabinet_no_atom.py, nhận năm tham số: task, task config, seed, server URL và số trial. Kết quả success rate được ghi vào eval_result/<task>/pi0/<config>/<label>/<timestamp>/_result.txt.
Nhưng beginner cần để ý một cảnh báo trong README: evaluator hiện ghi success/failure, nhưng chưa tự export đầy đủ dx, dy, dz, yaw ở event quan trọng để fit phân phối paper. Nếu muốn reproduce đúng CARE, bạn phải thêm logging ở grasp closure hoặc object release, group theo task/stage/arm, rồi fit distribution từ nominal-policy failures. Đừng trộn corrective demonstrations vào thống kê này, vì như vậy distribution không còn phản ánh lỗi của nominal policy nữa.
Một schema logging tối thiểu có thể như sau:
{
  "task": "place_dual_shoes",
  "stage": "right_shoe_place",
  "arm": "right",
  "event": "release",
  "dx": 0.031,
  "dy": -0.018,
  "dz": 0.006,
  "yaw": 0.21,
  "success": false
}
Sau đó bạn fit từng scalar component theo stage. Paper dùng AIC và KS test để chọn distribution. Thực tế nội bộ team nhỏ có thể bắt đầu bằng Gaussian hoặc empirical histogram để debug pipeline trước, rồi mới chuẩn hóa selection giống paper.
Bước 2: tạo corrective demonstrations
Sau khi có failure distribution, CARE tạo failure state mới bằng cách sample deviation và perturb relative pose. Với task put_object_cabinet_regrasp, README chỉ ví dụ:
bash collect_data.sh put_object_cabinet_regrasp demo_randomized 0
Script này gọi script/collect_data.py và ghi trajectories vào data/put_object_cabinet_regrasp/demo_randomized/. Trước khi chạy, bạn cần set episode_num, collect_data và save_path trong task_config/demo_randomized.yml. Bạn cũng cần update sampler trong Python environment tương ứng với fitted distribution của bạn. Đây là nơi CARE khác random perturbation: sampler phải phản ánh lỗi thật đã đo, không phải range tùy ý.
Sau khi có HDF5 episodes, CARE cần process dữ liệu, gán stage labels, attach instruction theo frame, rồi convert sang LeRobot format:
python dealdata/process_task_data.py place_bread_skillet --config demo_randomized
bash policy/pi0/process_data_pi0.sh place_bread_skillet demo_randomized 50
bash policy/pi0/generate.sh \
  policy/pi0/processed_data/place_bread_skillet-demo_randomized-50 \
  lerobot_data/place_bread_skillet
Số 50 là số episode đã collect. Argument cuối là local LeRobot dataset đã tồn tại để append. Nếu bạn thêm phase mới, hãy kiểm tra policy/pi0/scripts/process_data.py để map instruction đúng. Đây là bước dễ lỗi nhất trong pipeline: nếu phase label sai, VLA sẽ học correction bằng instruction không khớp trạng thái.
Bước 3: train CARE policy
Paper train các policy simulation với 150 nominal expert demonstrations và 50 additional trajectories cho mỗi error type. Với CARE, additional data là experience-guided corrective trajectories; baseline dùng cùng budget nhưng là nominal atomic-stage trajectories. Failure distribution được ước lượng từ 100 preliminary rollouts. Training chính trong paper dùng 40,000 gradient steps, batch size 32, action horizon 50, trên hai NVIDIA A800 SXM4 80GB GPU. Với FSR-Bench, mỗi recovery type dùng 50 corrective trajectories, train 20,000 steps cùng batch size và horizon.
Repo CARE hướng dẫn train data đã convert bằng Future Robots. Với release này, README yêu cầu disable MA-VLA agent-order shuffling và image masking trong transform DroidMultiInputs_atom:
shuffle_prob = 0
image_mask_prob = 0
Sau đó compute normalization statistics và train:
uv run scripts/compute_norm_stats.py --config-name YOUR_CARE_CONFIG
XLA_PYTHON_CLIENT_MEM_FRACTION=1 uv run scripts/train.py YOUR_CARE_CONFIG --exp-name=care_run
Với lab nhỏ, hãy bắt đầu bằng một task và một failure type. Ví dụ chỉ làm place_dual_shoes stage 1, chỉ log placement offset, chỉ collect 50 corrective segments, rồi đánh giá RSR trước khi mở rộng. CARE là framework mạnh nhưng nhiều mảnh: RoboTwin assets, HTTP policy service, data conversion, Future Robots config, monitor predicates và evaluation scripts. Debug tuần tự sẽ tiết kiệm rất nhiều thời gian.
Bước 4: inference với monitor 3D
Sau khi train, inference không chỉ là gọi policy liên tục. Bạn cần chạy stage-wise plan và monitor. Ví dụ evaluator point-cloud cho handover_block:
python policy/pi0/eval_vla_handover_block_pointcloud.py \
  --config policy/pi0/deploy_policy.yml \
  --server_url http://127.0.0.1:5000 \
  --overrides \
  --task_name handover_block \
  --task_config demo_randomized \
  --ckpt_setting handover_block \
  --seed 0 --policy_name pi0 --test_num 100
--ckpt_setting chỉ là label thư mục kết quả; checkpoint thật được load bởi HTTP model service. Kết quả nằm trong eval_result/handover_block/pi0/demo_randomized/. Nếu bật point-cloud/debug output, hãy chuẩn bị storage riêng vì video, point cloud và logs có thể lớn.
Luồng inference nên được hiểu như vòng lặp:
observe scene
planner gives fixed atomic stages
run selected instruction with VLA
monitor event: grasp close / release / predicted transition
if predicate passes: advance stage
if local deviation: run adjustment instruction
if stage failed: run re-operation instruction
stop when task succeeds or retry budget expires
Điểm mạnh là VLM planner chỉ query một lần ở đầu task. CARE không gọi VLM ở tần số cao. Monitor hình học chạy theo event, còn VLA executor sinh action như bình thường. Kiến trúc này thực dụng hơn việc để một LLM/VLM liên tục "nghĩ" trong control loop.
Kết quả chính
Trên bảy hard bimanual tasks của RoboTwin 2.0, CARE cải thiện cả hai backbone VLA được thử. Với π0, average success tăng từ 39.6% lên 60.7%, tức +21.1 điểm. Với π0-FAST, average success tăng từ 17.4% lên 33.1%, tức +15.7 điểm. Các task gồm Lift Pot, Stamp Seal, Place Bread Skillet, Place Dual Shoes, Put Object Cabinet, Handover Block và Dump Bin Bigbin.
Trên RoboFactory multi-arm collaboration, CARE cũng tăng hiệu năng: π0-FAST tăng trung bình +9.3 điểm và π0 tăng +12.0 điểm trên các task hai, ba và bốn tay. Điều này cho thấy idea không bị khóa vào một task dual-arm cụ thể.
Trên FSR-Bench, CARE cải thiện recovery ở cả RDT-1B, π0-FAST và π0. Average RSR của π0 trong Easy regime tăng từ 38.8% lên 57.2%, còn Hard regime tăng từ 15.8% lên 21.2%. Hard vẫn khó, nhất là khi failure cần multi-step recovery hoặc coordination hai tay. Đây là kết quả quan trọng: CARE không biến recovery thành bài toán đã giải xong, nhưng nó tạo ra cách đo và cải thiện rõ ràng.
Trên real world, paper dùng dual-arm LeRobot SO-101 với 12 DoF, một global RGB camera và một wrist RGB camera cho mỗi tay, chạy 30 Hz. Mỗi task có 50 nominal demonstrations và 20 additional trajectories cho mỗi error type; 100 preliminary executions dùng để ước lượng failure distribution. Policy inference chạy từ A800 server, còn SAM 3 và Depth Anything 3 chạy local trên RTX 4090. Paper báo cáo average task-success gain 15.9 điểm trong real world.

Checklist triển khai cho lab nhỏ
Nếu bạn muốn áp dụng CARE vào pipeline riêng, hãy bắt đầu bằng checklist sau:
- Chọn một task RoboTwin 2.0 có failure lặp lại, ví dụ placement offset hoặc re-grasp.
- Chạy nominal VLA đủ nhiều, tối thiểu 100 rollouts nếu muốn gần paper.
- Log deviation đúng event: grasp closure, object release hoặc handover contact.
- Fit distribution theo stage, không fit chung toàn task.
- Generate corrective states bằng physics rollout, không chỉ teleport state rồi save.
- Collect corrective segments ngắn, instruction rõ ràng, termination condition cụ thể.
- Convert data sang LeRobot và inspect vài episode bằng viewer trước khi train.
- Train một backbone với cùng budget giữa baseline và CARE.
- Viết predicate monitor đơn giản trước, sau đó mới thêm nhiều cue.
- Đánh giá bằng cả task success và recovery success, vì hai metric trả lời hai câu hỏi khác nhau.
Một lỗi phổ biến là thêm quá nhiều correction instruction ngay từ đầu. Beginner nên bắt đầu với hai loại: adjust khi lệch còn nhỏ và re-operate khi stage cần làm lại. Khi pipeline ổn, bạn mới thêm instruction chi tiết hơn theo object hoặc arm.
CARE khác gì một mẹo prompt?
CARE không chỉ prompt VLA "hãy cẩn thận hơn". Nó thay đổi cả data distribution và execution protocol. Data được bổ sung bằng failures xuất phát từ chính policy; execution được điều khiển bằng stage predicates; benchmark đánh giá recovery từ intermediate failure states. Đây là lý do CARE đáng đọc cho bất kỳ ai làm VLA manipulation nghiêm túc.
Tuy vậy, repo hiện chưa phải turnkey reproduction. Một số mảnh như distribution-fitting command, fixed FSR-Bench initialization manifest đầy đủ, dataset lớn và checkpoint không nằm trong snapshot. Nếu bạn làm research, đây không phải vấn đề lớn: paper và repo đủ để rebuild methodology. Nếu bạn làm product prototype, hãy xem CARE như design pattern rồi implement phần logging, data generation và monitoring phù hợp robot của mình.