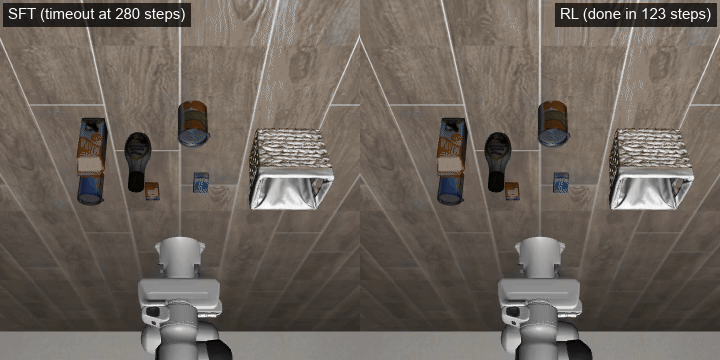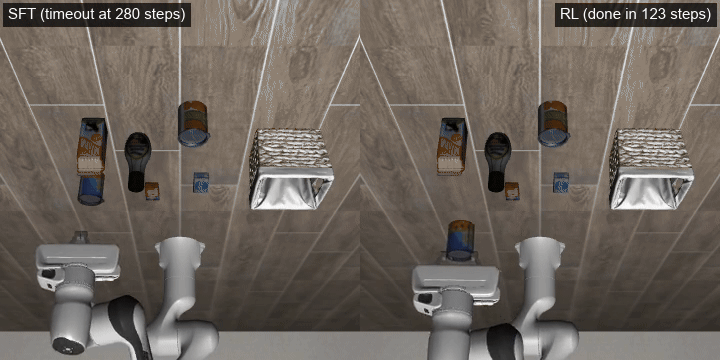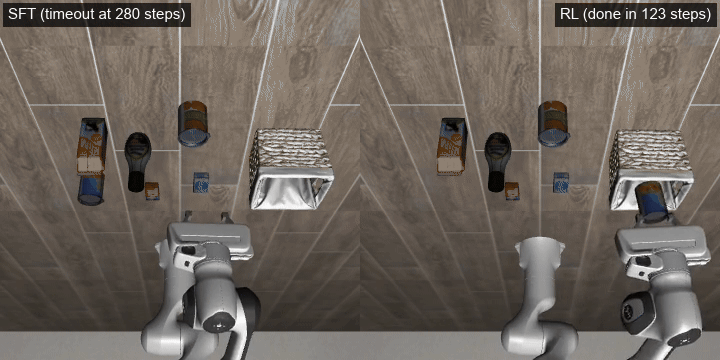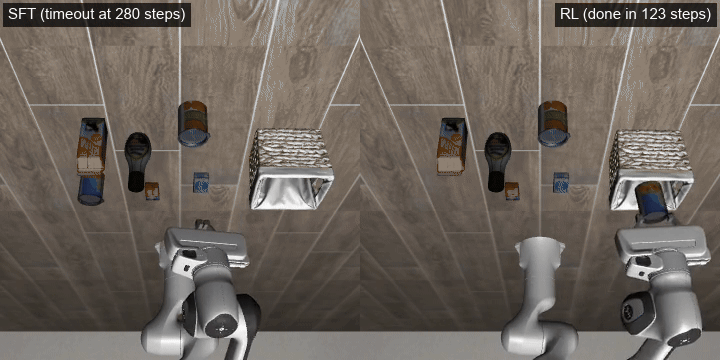
FlowVLA-RL là một project rất đáng đọc nếu bạn muốn hiểu cách fine-tune một Vision-Language-Action model nhỏ bằng online reinforcement learning mà không cần cụm H100. Demo nổi bật của repo khá thẳng: cùng task, cùng initial scene trong LIBERO-Object, policy SFT đứng bên trái timeout ở mốc 280 bước, còn policy sau GRPO bên phải hoàn thành trong 123 bước. Điểm hay không chỉ là video đẹp. Điểm hay là tác giả chỉ ra vấn đề toán học cốt lõi của SmolVLA: action expert dùng flow matching deterministic, nên bình thường không có log pi, không có likelihood, và policy gradient kiểu PPO/GRPO không có chỗ bám.
Project gốc là BlackMirean/FlowVLA-RL, kèm technical report FlowVLA-RL: Online GRPO for a Flow-Matching VLA on LIBERO. Checkpoint SFT và GRPO được public tại MorpheusTzz/smolvla-grpo-libero-object. Đây chưa phải một paper peer-reviewed riêng; cách đọc đúng là một validation study có code, report, checkpoint, locked evaluation protocol và các video rollout đối chiếu. Repo dựa trên SmolVLA của LeRobot, LIBERO, ý tưởng Flow-GRPO cho ODE-to-SDE, và bài toán online RL cho flow-based VLA như piRL.
Nếu bạn mới đọc VLA, hãy xem trước SmolVLA: Train VLA 450M trên Consumer GPU. Nếu đã quen LIBERO + GRPO, bài NS-VLA v2: Fine-tune VLA trên LIBERO là điểm so sánh tốt. Bài này tập trung vào FlowVLA-RL: cài đặt, training, inference, kết quả, và các bẫy khiến số đo bị sai.
FlowVLA-RL giải quyết vấn đề gì?
SmolVLA là một VLA 450M parameters. Nó đọc ảnh, instruction và robot state, rồi sinh action chunk liên tục. Phần quan trọng là action expert: thay vì sinh token rời rạc, nó bắt đầu từ noise và tích phân một velocity field trong khoảng 10 denoising steps để ra một chunk 50 bước. Cách này nhanh và hợp với continuous control, nhưng inference mặc định là deterministic ODE.
Với behavior cloning, deterministic không sao. Bạn có demonstration (observation, action) và tối ưu loss flow matching. Nhưng online RL cần xác suất hành động. PPO/GRPO cần so sánh pi_theta(a|s) với policy cũ hoặc policy tham chiếu. Nếu sampler chỉ là một đường tích phân deterministic từ noise đến action, bạn không có log-prob cho từng transition. FlowVLA-RL vì vậy làm một bước retrofit: giữ marginal distribution của flow, nhưng biến mỗi denoising step thành Gaussian transition có log-density đóng.
Nói gọn:
SmolVLA gốc:
noise -> deterministic ODE -> action chunk

FlowVLA-RL:
noise -> stochastic SDE transitions -> action chunk + log-prob
Khi có log-prob, ta có thể chạy GRPO critic-free. Một group gồm 4 rollout từ cùng initial scene. Reward là success/fail nhị phân từ official LIBERO checker. Advantage của một rollout là reward - mean_reward_trong_group. Nếu group có 2 success và 2 fail, hai rollout tốt được advantage dương, hai rollout xấu advantage âm. Nếu cả 4 cùng success hoặc cùng fail, advantage bằng 0 và group đó không dạy được gì.
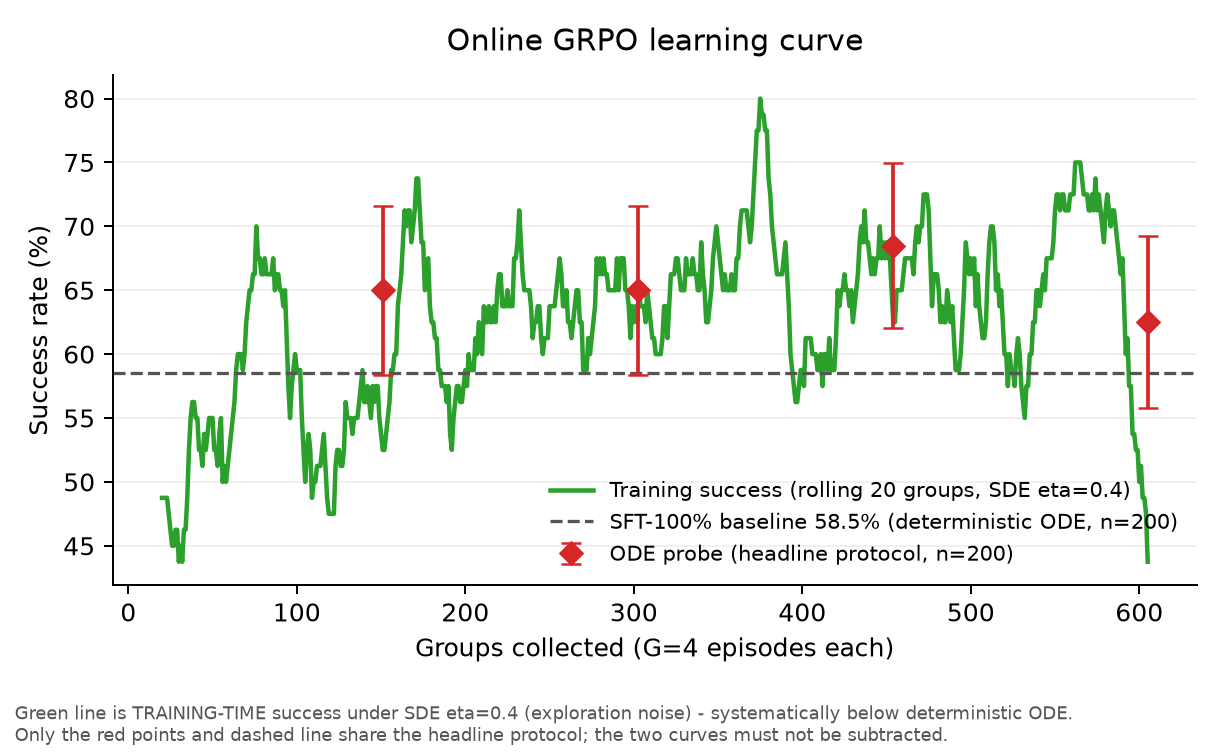
Hình trên là lý do bài này thú vị với beginner: improvement không phẳng, không sạch như benchmark marketing. Training-side SDE success dao động mạnh, còn ODE eval mới là số chính. Repo khóa protocol trước khi report: deterministic ODE sampling, 20 episodes mỗi task, n=200 cho mỗi suite, eval seed 1000, và step cap 280/280/300 cho Object/Spatial/Goal.
Kiến trúc: SmolVLA cộng Flow-SDE GRPO
Để hiểu code, hãy tách thành ba lớp.
1. SmolVLA backbone. SmolVLA dùng VLM nhỏ gồm SigLIP vision encoder và SmolVLM2/SmolLM-style language stack, rồi thêm action expert khoảng 100M parameters. Action expert nhận feature từ VLM, robot state và noise level, sau đó dự đoán velocity để denoise action chunk. Trong FlowVLA-RL, VLM và vision encoder được freeze. Phần trainable chủ yếu là action expert cùng state/action projection, khoảng 99.9M parameters.
2. ODE-to-SDE retrofit. SmolVLA sinh chunk bằng ODE. FlowVLA-RL lấy velocity v_theta(x, tau) và suy ra score theo công thức report:
score = grad log p_tau(x) = -(x + (1 - tau) * v_theta(x, tau)) / tau
reverse drift = v_theta - 0.5 * g_tau^2 * score
x_{tau - dt} ~ Normal(x - dt * reverse_drift, g_tau^2 * dt)
Bạn không cần thuộc công thức để chạy repo, nhưng cần hiểu ý nghĩa: mỗi step bây giờ là Gaussian có mean và variance rõ ràng, nên log-prob có thể cộng lại qua 10 denoising steps, các action dims thật, và các vị trí action chunk thật sự được execute. LIBERO chỉ cần action 7 chiều, còn tensor SmolVLA có 32 chiều, nên repo mask 25 padding dims ra khỏi log-prob.
3. GRPO trên episode. GRPO ở đây không dùng critic. Với mỗi initial scene, rollout 4 lần bằng stochastic SDE sampler. Reward cuối episode là 1 nếu LIBERO checker báo success, 0 nếu fail. Advantage là reward trừ mean group, không chia standard deviation theo tinh thần Dr. GRPO. Loss là PPO clipped surrogate trên log-density ratio, cộng KL k3 về frozen SFT reference với beta = 0.01. Repo đặt invariant rất quan trọng: với epochs = 1, lần rescore đầu tiên phải cho ratio gần 1. Nếu không, rollout log-prob và training log-prob đang lệch nhau.
Cài đặt môi trường
FlowVLA-RL pin môi trường khá cụ thể. Report dùng lerobot v0.6.0, Python 3.12.3, PyTorch 2.11 CUDA 12.8, hf-libero 0.1.4, MuJoCo 3.8.1 và robosuite 1.4.0. Tác giả chạy experiment trên RTX 5090 32GB, nhưng đo peak VRAM SFT là 20.4 GiB, nên một GPU 24GB được xem là đủ để reproduce. Rollout lại CPU-bound: khoảng 9.7 giây mỗi episode và GPU utilization chỉ 8%.
Một setup tối thiểu theo README:
curl -LsSf https://astral.sh/uv/install.sh | sh
uv venv --python 3.12 .venv
source .venv/bin/activate

uv pip install torch torchvision --index-url https://download.pytorch.org/whl/cu128
git clone https://github.com/huggingface/lerobot.git
cd lerobot
git checkout v0.6.0
uv pip install -e ".[libero,smolvla]"
cd ..

git clone https://github.com/BlackMirean/FlowVLA-RL.git
cd FlowVLA-RL
uv pip install -e .
export MUJOCO_GL=egl
Nếu chạy trên server headless, MUJOCO_GL=egl rất quan trọng. Nếu thiếu EGL hoặc driver không khớp, LIBERO có thể lỗi render hoặc chậm bất thường. Trước khi train dài, chạy unit test và smoke test:
python -m pytest tests/

python scripts/train_grpo_libero.py \
  --suite libero_object \
  --task-ids 0,1,2 \
  --groups 3 \
  --group-size 4 \
  --checkpoint <SFT_CKPT>
Smoke test này không nhằm tạo kết quả tốt. Nó chỉ kiểm tra đường đầy đủ: load checkpoint, tạo LIBERO env, collect group, tính log-prob, rescore, update, save.
Bước 1: tạo hoặc tải SFT baseline
FlowVLA-RL không bắt đầu từ lerobot/smolvla_base rồi RL ngay. Nó tạo SFT baseline trên LIBERO trước. Report dùng full LIBERO dataset revision a1aaacb7..., train 25,000 steps, batch size 64, seed 1000. Command trong report:
lerobot-train \
  --policy.path=lerobot/smolvla_base \
  --policy.device=cuda \
  --policy.push_to_hub=false \
  --policy.empty_cameras=1 \
  --rename_map='{"observation.images.image": "observation.images.camera1", "observation.images.image2": "observation.images.camera2"}' \
  --dataset.repo_id=lerobot/libero \
  --dataset.revision=a1aaacb7f6cd6ee5fb43120f673cebb0cfea7dd4 \
  --steps=25000 \
  --batch_size=64 \
  --save_freq=5000 \
  --seed=1000 \
  --output_dir=artifacts/sft_100pct \
  --job_name=sft_100pct
Beginner thường vấp ở rename_map. LIBERO trong LeRobot có tên camera khác với config SmolVLA mong đợi. Nếu mapping camera sai, model vẫn chạy nhưng input visual đi vào slot sai. policy.empty_cameras=1 cũng không phải trang trí: checkpoint FlowVLA-RL ở format SmolVLA ba camera slots, còn LIBERO cung cấp hai camera, slot thứ ba để trống.
Nếu không muốn SFT lại, tải checkpoint từ Hugging Face:
hf download MorpheusTzz/smolvla-grpo-libero-object \
  --local-dir ckpts
Trong repo model có sft-100pct-baseline/ và grpo-seed11-update300/. Baseline SFT đạt 58.5% trên LIBERO-Object theo locked protocol của FlowVLA-RL, còn checkpoint GRPO seed 11 update 300 đạt 68.5% ở cùng protocol.
Bước 2: online GRPO trên LIBERO-Object
Training headline của repo là LIBERO-Object từ SFT 100%. Command:
python scripts/train_grpo_libero.py \
  --checkpoint artifacts/sft_100pct/checkpoints/last/pretrained_model \
  --suite libero_object \
  --task-ids 0,1,2,3,4,5,6,7,8,9 \
  --group-size 4 \
  --groups 300 \
  --save-every 50 \
  --eta 0.4 \
  --lr 1e-6 \
  --kl-beta 0.01 \
  --seed 11
Các tham số nên đọc kỹ:
| Tham số | Vai trò | Giá trị trong report |
|---|---|---|
group-size |
Số rollout cùng initial scene để tính group advantage | 4 |
groups |
Số update GRPO hữu dụng cần thu | 300 cho headline |
eta |
Mức noise trong SDE sampler | 0.4 |
lr |
Learning rate của action expert | 1e-6 |
kl-beta |
KL penalty về frozen SFT reference | 0.01 |
seed |
Seed training, ảnh hưởng thời điểm curve tăng | 11, 31, 32... |
Repo discard các collapsed groups. Điều này làm số episode thực tế lớn hơn groups * group_size. Trong run 400 updates seed 11, report ghi 605 group attempts để có 400 usable groups, tổng 2,420 episodes. Lý do là 33.9% groups all-success hoặc all-fail nên advantage bằng 0.
Bạn nên log ba nhóm metric. Một là success training dưới SDE sampler, nhưng đừng so trực tiếp với ODE eval. Hai là ratio/clip fraction/KL, để bắt lỗi PPO objective. Ba là collapsed group rate. Nếu collapsed rate quá cao, GRPO không có tín hiệu học, dù rollout vẫn chạy rất lâu.
Bước 3: inference và evaluation
Evaluation dùng deterministic ODE, không dùng SDE training sampler. Đây là điểm quan trọng nhất khi đọc kết quả. Nếu bạn train bằng SDE rồi eval bằng SDE, số có thể trông cao hơn hoặc khác đi, nhưng không so được với baseline deterministic ODE. FlowVLA-RL dùng:
python scripts/run_baseline_eval.py \
  --checkpoint ckpts/grpo-seed11-update300 \
  --suite libero_object \
  --episodes 20 \
  --batch-size 5 \
  --seed 1000
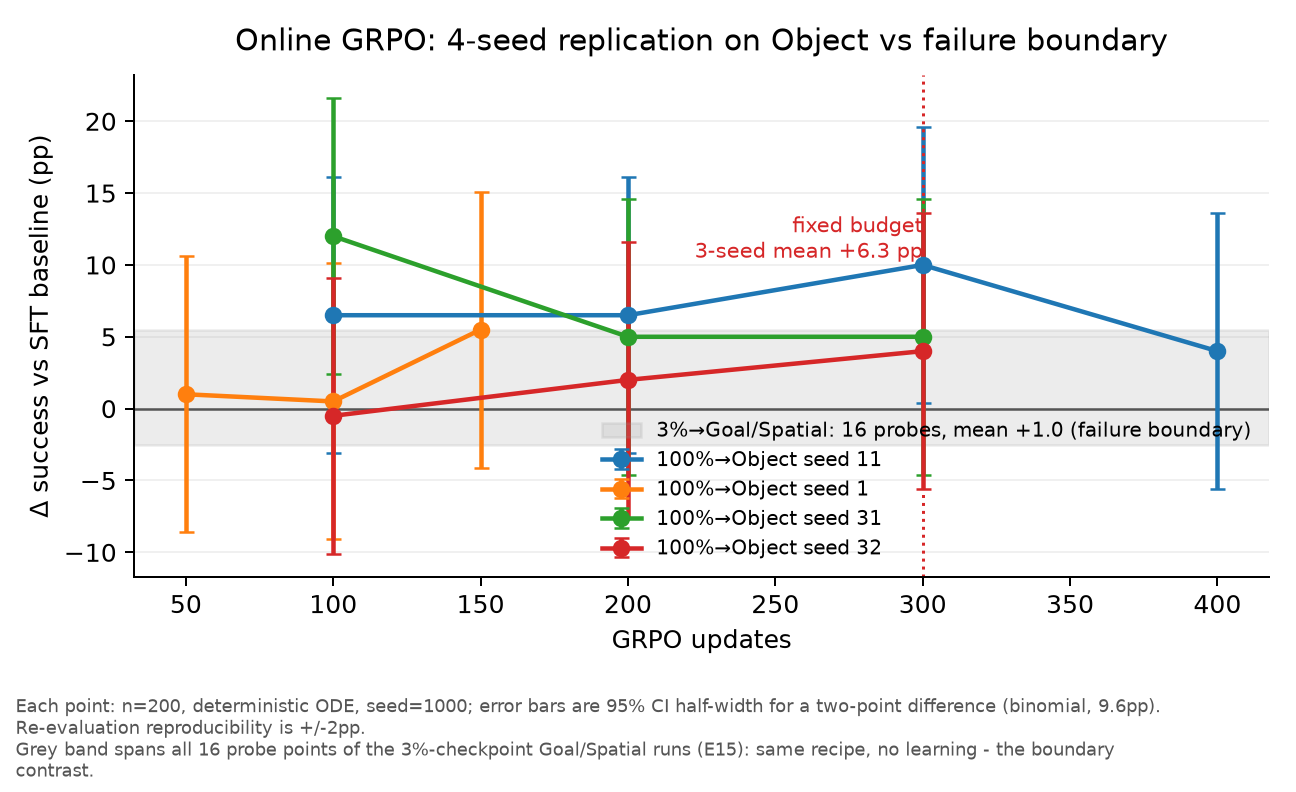
Mỗi suite có 10 tasks, 20 episodes/task, nên n=200. Với n=200, nhiễu thống kê không nhỏ: repo nói re-evaluate cùng checkpoint có thể dao động khoảng ±2 percentage points, còn so sánh một điểm đơn lẻ dưới ±4.9 pp rất dễ bị noise. Vì vậy số headline dùng mean nhiều seed và nói rõ caveat.
Một bẫy lớn: lerobot v0.6.0 tính _max_episode_steps cho LIBERO nhưng env loop không tự enforce truncate như bạn nghĩ. Nếu custom evaluator tin env tự stop, rollout có thể chạy quá cap nội bộ và inflate success. FlowVLA-RL enforce step caps ở caller: 280 cho Object, 280 cho Spatial, 300 cho Goal.
Kết quả chính
Kết quả headline là GRPO trên LIBERO-Object: SFT 58.5% lên fixed-budget mean 64.8%, tức +6.3 percentage points ở 300 updates, trung bình 3 seed. Tất cả 4 seed được probe đều cải thiện, nhưng timing khác nhau. Seed 11 đạt 68.5% ở update 300, tức +10.0 pp so với baseline, rồi giảm xuống 62.5% ở update 400. Đây là dấu hiệu overfitting hoặc drift, nên không nên báo peak một cách vô tư.
| Checkpoint | LIBERO-Object success | Ghi chú |
|---|---|---|
| SFT 100% baseline | 58.5% | n=200, deterministic ODE |
| GRPO seed 11 update 300 | 68.5% | checkpoint trên Hugging Face |
| Fixed-budget 3-seed mean | 64.8% | +6.3 pp so với baseline |
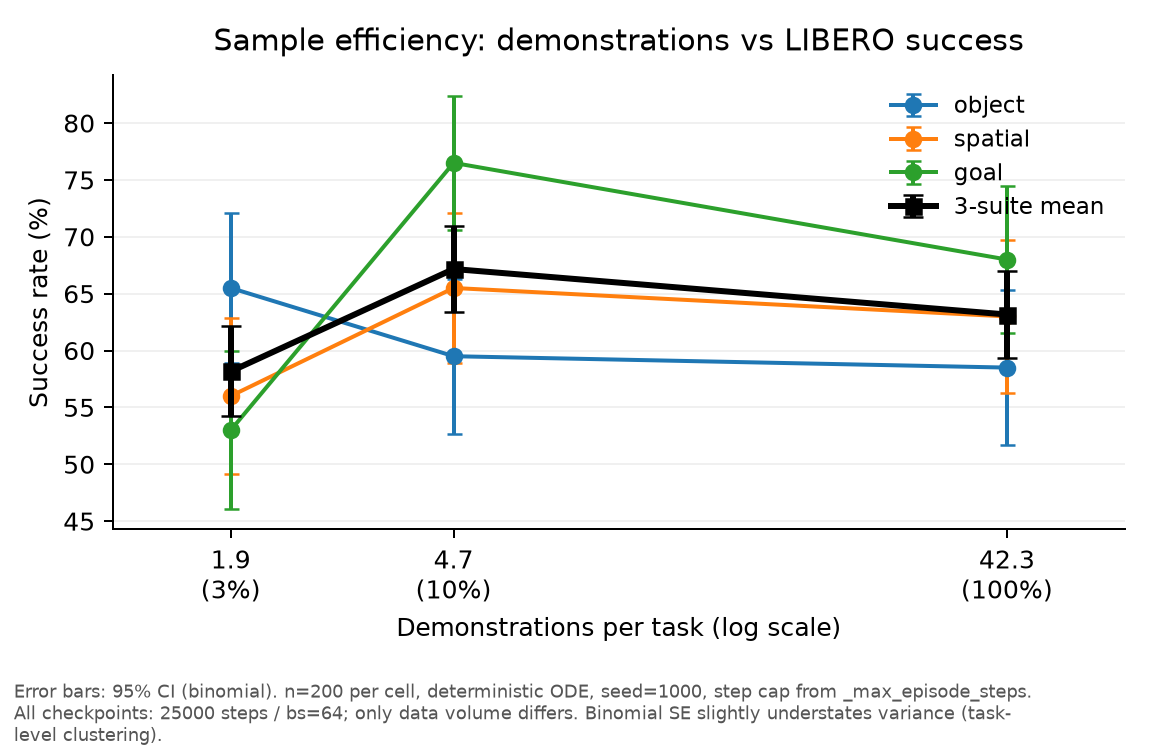
Repo cũng kiểm tra sample efficiency của SFT. Kết luận khá bất ngờ: giảm từ 42.3 demos/task xuống 4.7 demos/task không làm xấu đi rõ ràng trên 3-suite mean, nhưng giảm tiếp xuống 1.9 demos/task làm mất 9.0 pp. Tác giả diễn giải SmolVLA bão hòa quanh 5 demos/task trên LIBERO trong setup này.
Quan trọng hơn, FlowVLA-RL không thành công ở mọi nơi. Cùng recipe khi bắt đầu từ checkpoint 3% dữ liệu trên Goal/Spatial gần như flat: 16 probe points chỉ có mean +1.0 pp. Lý do được report nêu khá rõ: Goal/Spatial bị scene layout chi phối mạnh. Khi 4 rollout trong group chia sẻ một scene, 72-78% groups all-success hoặc all-fail, advantage bằng 0. Online GRPO với reward nhị phân cuối episode hữu ích khi task behavior-limited, không hữu ích lắm khi outcome chủ yếu do scene layout hoặc policy đã memorized quá cứng.
Debugging: hai lỗi làm RL hỏng mà nhìn ngoài vẫn bình thường
Lỗi đầu tiên là mismatch bf16/fp32. Rollout được collect dưới bf16 autocast, nhưng rescore trong fp32. Vì log-prob cộng hàng nghìn Gaussian terms, sai số nhỏ mỗi term tích lũy thành delta logp cỡ 1. Report ghi ratio có thể rơi về khoảng 0.34, nằm ngoài clip range, khiến objective PPO gần như không còn advantage signal. Fix là dùng chung autocast context cho collection và rescoring, cộng runtime invariant: với epoch đầu, ratio phải gần 1.
Lỗi thứ hai là reset scene của LIBERO. Trên Spatial/Goal, hard reset có thể resample object placement qua private RandomState của robosuite, làm các rollout trong cùng GRPO group không thật sự cùng initial scene. Khi group identity sai, advantage không còn ý nghĩa. FlowVLA-RL sửa bằng snapshot-based soft reset: capture sim.get_state() sau khi scene settle, rồi restore trong group. Acceptance là observation sau reset phải khớp tuyệt đối trong group.
Hai case này là bài học lớn cho robotics RL: policy gradient không chỉ là thuật toán. Nó là một hệ đo lường. Nếu log-prob collection/rescoring lệch hoặc environment reset không giữ invariant, training có thể chạy hàng giờ mà mọi dashboard vẫn trông "có vẻ đúng".
Khi nào nên dùng FlowVLA-RL?
Dùng FlowVLA-RL nếu bạn có một SmolVLA SFT checkpoint đã làm được task ở mức vừa phải, reward thành công/thất bại đáng tin, và muốn cải thiện behavior trong một suite có nhiều headroom. LIBERO-Object là ví dụ tốt: reward không quá dense, nhưng policy có đủ rollout khác biệt trong cùng scene để GRPO tạo advantage.
Chưa nên dùng nếu policy của bạn gần như random, scene quá quyết định outcome, hoặc bạn không enforce được reset group identity. Với robot thật, yêu cầu còn cao hơn: cần safety layer, reset automation, logging video/action/state, và kill switch. Bạn cũng không nên lấy number 68.5% seed 11 như bảo đảm cho mọi setup. Nó là một checkpoint cụ thể, protocol cụ thể, suite cụ thể.
Điều đáng học nhất từ FlowVLA-RL là công thức engineering: đóng băng VLM, train action expert nhỏ, biến flow sampler thành stochastic sampler có log-prob, dùng GRPO nhóm rollout cùng scene, và đo bằng protocol khóa trước. Đây là cách rất thực tế để đưa VLA nhỏ từ imitation sang online improvement mà vẫn nằm trong ngân sách một GPU consumer-class.
Checklist chạy lại cho người mới
- Cài đúng
lerobot v0.6.0, Python 3.12, PyTorch CUDA phù hợp vàMUJOCO_GL=egl. - Chạy
python -m pytest tests/để kiểm tra SDE math, GRPO invariants và rollout utilities. - Tải
sft-100pct-baseline/từ Hugging Face hoặc train SFT 25k steps. - Eval baseline bằng deterministic ODE,
n=200, seed 1000, step cap đúng. - Chạy GRPO smoke test 3 groups trước khi chạy 300 groups.
- Theo dõi first-pass ratio, KL, clip fraction, collapsed group rate và video rollout.
- Eval checkpoint update 50/100/200/300 bằng cùng locked protocol.
- Chỉ so số cùng sampler, cùng suite, cùng cap, cùng seed eval.


